


Python遍历字典值时怎么进行条件筛选
在Python中遍历字典值并进行条件筛选的实用方案指南:详解直接for循环、列表推导式、基于items()的字典推导式与生成器表达式,并分析常见遍历修改报错与避坑实践。
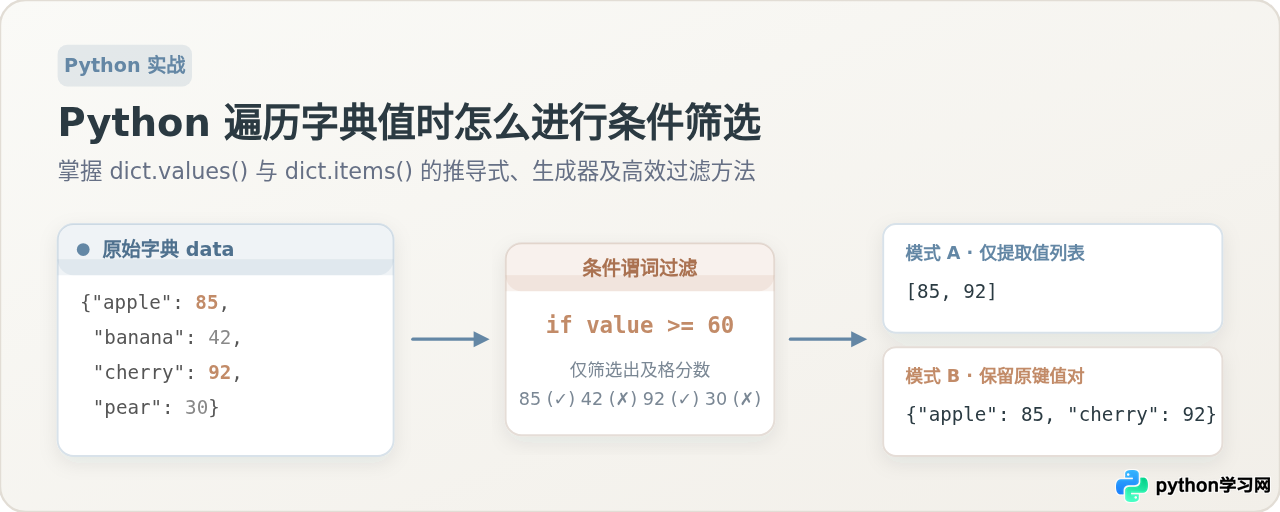
for 循环搭配 dict.values() 与 if 条件判断;若要将筛选后的数据收集为独立结构,最常用的标准写法是推导式——仅需提取数值列表时使用列表推导式 [v for v in d.values() if 条件],若需保留原字典的键值结构则使用基于 dict.items() 的字典推导式 {k: v for k, v in d.items() if 条件}。
一、先明确目标:只取筛选后的值,还是保留原键名?
在开始编写代码前,首先需要明确业务场景对输出数据的要求。很多初学者在遇到“遍历字典值进行条件筛选”的问题时,容易混淆 dict.values() 与 dict.items() 的使用边界。
字典是由“键-值”映射组成的容器。如果直接调用 dict.values(),Python 会提供一个只包含值的动态视图。在这个视图中,数值已经与原本的键剥离。因此,如果后续流程只需要这些数值(例如统计及格分数、计算符合条件数值的总和或均值),直接遍历 dict.values() 是最轻量、最快捷的做法;但如果业务需要知道“到底是谁达到了这个数值”,就必须在迭代中保留键名,此时应当遍历 dict.items()。
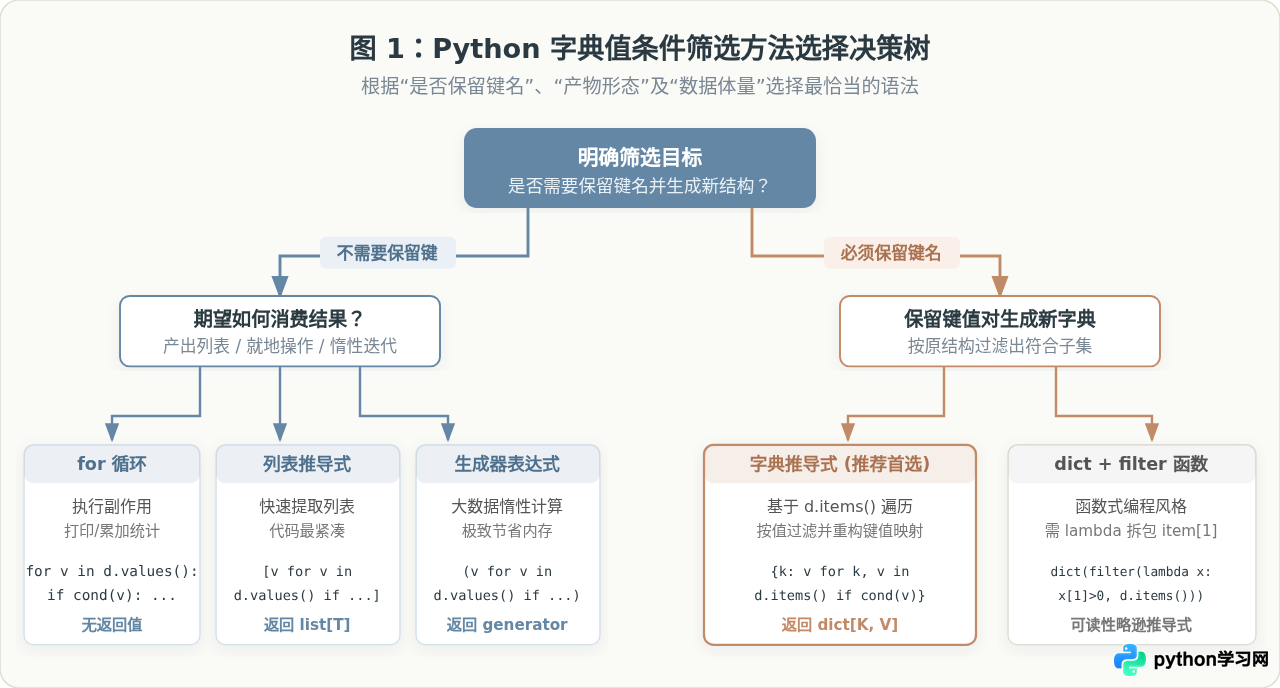
二、仅提取或处理值:基于 dict.values() 的遍历与筛选
当输出目标不需要保留键时,我们可以完全聚焦于字典的值集合。常见的使用场景包括两类:就地执行操作与生成过滤后的值列表。
1. 使用常规 for 循环进行即时处理
如果筛选出满足条件的值后,目的是执行打印、计数器累加、调用外部接口或触发分支逻辑,标准的 for ... in d.values() 循环最为清晰直观:
# 示例字典:记录员工销售额
sales = {"Alice": 120, "Bob": 45, "Charlie": 88, "Diana": 30}

# 遍历字典值,筛选出销售额大于等于 80 的记录并即时处理
high_sales_count = 0
for value in sales.values():
    if value >= 80:
        high_sales_count += 1
        print(f"发现达标销售额: {value}")

print(f"总计达标单数: {high_sales_count}")这种写法的优势在于结构平铺直叙,适合在条件满足时插入复杂的业务判断或多行执行代码,不会产生不必要的中间容器。
2. 使用列表推导式提取满足条件的值
如果目标是将所有符合条件的值汇聚为一个新的列表,列表推导式(List Comprehension)是 Python 社区中最推荐的惯用法。语法形式紧凑,而且由于在底层进行了优化,运行效率通常高于循环中的 list.append()。
# 提取所有大于等于 80 的销售额到一个新列表中
high_sales = [v for v in sales.values() if v >= 80]
print("筛选出的数值列表:", high_sales)三、根据值筛选并保留键:基于 dict.items() 的字典推导式
实际开发中更为高频的需求是:判断条件在值上,但最终产物依然是一个包含对应键值对的新字典。例如,筛选出所有成绩及格的学生及其分数、过滤出库存大于零的商品及其数量等。
因为 dict.values() 无法反查键名,此时的核心方案是改用 dict.items()。dict.items() 每次迭代会解包产出 (key, value) 元组,我们在推导式的 if 子句中对 value 进行校验,一旦为真,便将 key: value 写入新字典。
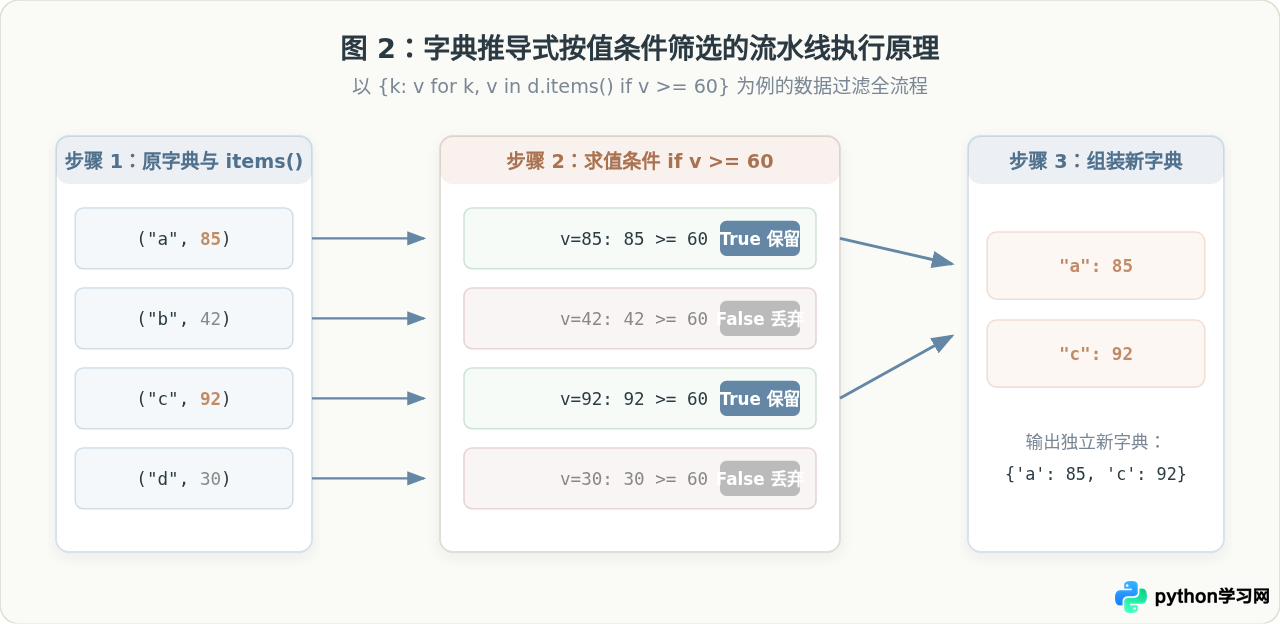
语法模板非常标准:
scores = {"语文": 85, "数学": 52, "英语": 91, "物理": 58, "化学": 76}

# 根据分数(值)筛选及格科目,保留科目名称(键)
passing_subjects = {k: v for k, v in scores.items() if v >= 60}
print("及格科目及分数:", passing_subjects)使用
dict(filter(lambda item: item[1] >= 60, scores.items())) 也能实现相同目的。但字典推导式无需通过下标 item[1] 访问值,直接通过 for k, v 命名解包,语义更加自解释,执行性能也略高于引入 lambda 函数的额外调用开销。
四、深入底层:dict.values() 与 dict.items() 的迭代机制
在 Python 2 中,d.values() 会在内存中立即拷贝生成一个完整的列表。但在 Python 3 中,d.values() 和 d.items() 返回的都是字典视图对象(dict_values 与 dict_items)。
视图对象具有惰性求值特性,它们不会预先复制字典中的元素,而是直接挂钩底层字典的散列表存储结构。这意味着无论原始字典拥有 10 个键值对还是 1000 万个键值对,获取 d.values() 这一步的内存开销始终是 \(O(1)\) 的恒定开销。
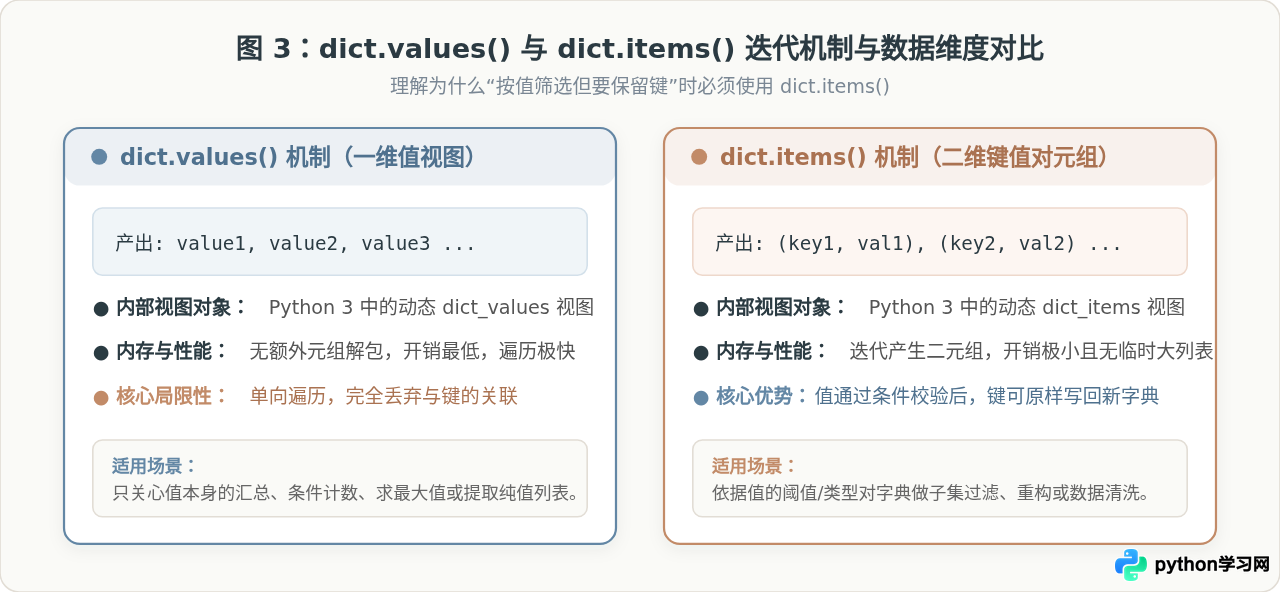
在性能细节上,dict.values() 在底层每次迭代只取值指针,不构造元组;而 dict.items() 会在每次迭代生成一个暂时的二元元组。因此,如果确实不需要键,直接遍历 dict.values() 会略微减少元组解包的 CPU 指令,微观性能更优;但一旦涉及键,就必须果断选用 dict.items()。
五、大数据量与流式过滤:生成器表达式
当原始字典包含数百万条记录,或者筛选后的数据只需要被后续逻辑逐条消费(如逐步写入磁盘、发送网络请求或送入 sum()、any() 计算)时,直接使用列表或字典推导式会在内存中一次性分配全部匹配项。
此时将推导式的方括号 [] 换成圆括号 (),即可得到生成器表达式(Generator Expression):
# 模拟大量数据
large_data = {f"id_{i}": i for i in range(1000000)}

# 仅需计算所有偶数值的总和:使用生成器避免构建百万长度的临时列表
even_sum = sum(v for v in large_data.values() if v % 2 == 0)
print("偶数值求和结果:", even_sum)

# 仅需检查是否存在大于 999990 的值:找到首个满足条件即短路停止
has_target = any(v > 999990 for v in large_data.values())
print("是否存在超大值:", has_target)配合 any() 或 next() 时,生成器表达式在发现第一个匹配值后就会停止迭代,具备高效的短路特性,无需遍历整个字典。
六、高频陷阱提醒:切忌在遍历中就地删除字典元素
很多开发者在需要“剔除不符合条件的值”时,会很自然地写出如下代码:
# 错误示范!请勿在实际项目中使用
data = {"a": 10, "b": 25, "c": 30}
for k, v in data.items():
    if v < 20:
del data[k] # 运行时报错!Python 的字典迭代器为了保证散列表遍历的一致性与指针安全,在内部维护了一个状态计数器。如果在遍历期间直接修改了原字典的长度(新增或删除键),迭代器会立刻检测到并抛出
RuntimeError: dictionary changed size during iteration。
如果业务确实需要“在原字典对象上完成清理”(例如该字典被其他模块引用,必须保持内存引用地址不变),正确的做法是先收集待删除的键,或者遍历键的列表快照:
data = {"a": 10, "b": 25, "c": 30, "d": 15}

# 正确解法 1:先找出所有不符合条件的键,再统一删除
keys_to_remove = [k for k, v in data.items() if v < 20]
for k in keys_to_remove:
    del data[k]

print("就地清理后的字典:", data)如果不需要保持原对象引用,更简洁的做法始终是推导出一个满足条件的新字典直接覆盖原变量:data = {k: v for k, v in data.items() if v >= 20}。
七、方法特性与选型对比
为了便于在日常开发中迅速做出合理选择,我们将几种主流的字典值筛选方法整理如下:
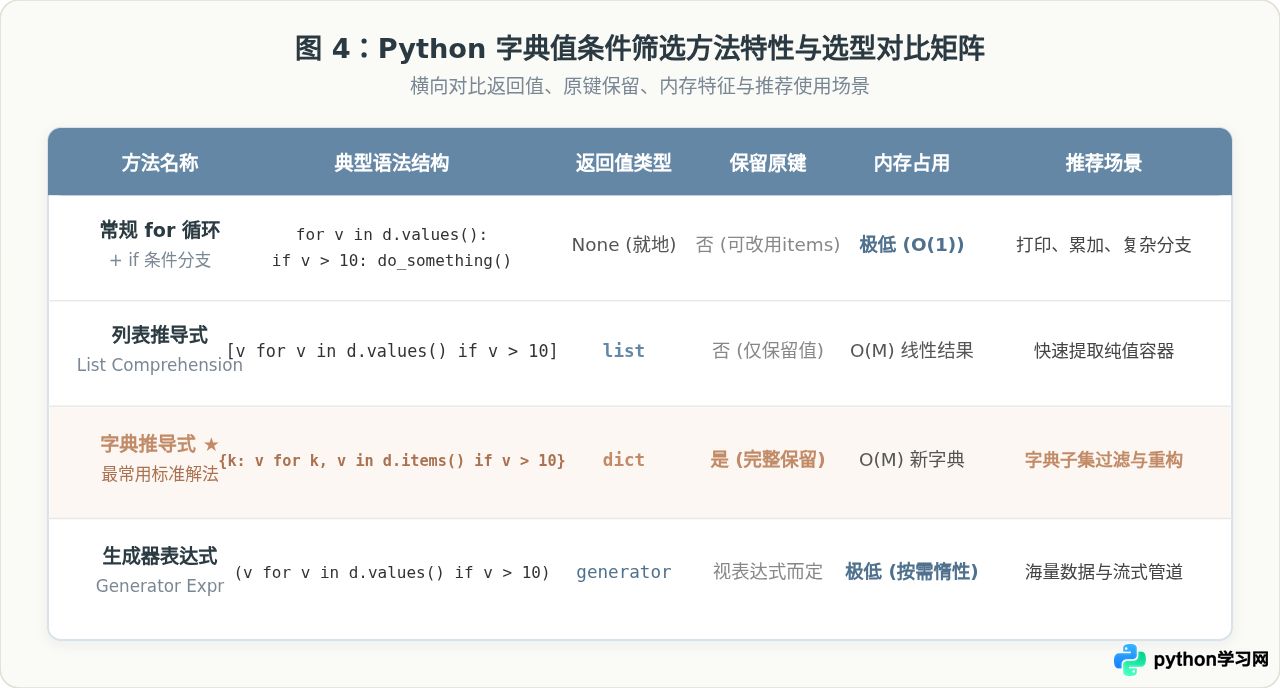
在实际编码中,选型策略通常遵循以下简单的三条准则:
- 若要得到子字典:无脑选用字典推导式
{k: v for k, v in d.items() if ...},代码意图最清晰,兼具良好性能。 - 若仅需数值列表:选用列表推导式
[v for v in d.values() if ...],表达直接且无键解包开销。 - 若为流式聚合或大体量单次消费:选用生成器表达式
(v for v in d.values() if ...),将内存占用严格控制在最低水平。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















