


Python中文分词代码示例:jieba与HanLP基础用法
针对Python中文自然语言处理中的分词需求,系统讲解jieba(结巴分词)与HanLP 2.x的核心用法与可运行代码示例。涵盖精确模式、全模式、搜索引擎模式、粗细切分粒度、用户自定义词典注入、词性标注及工程选型决策矩阵。
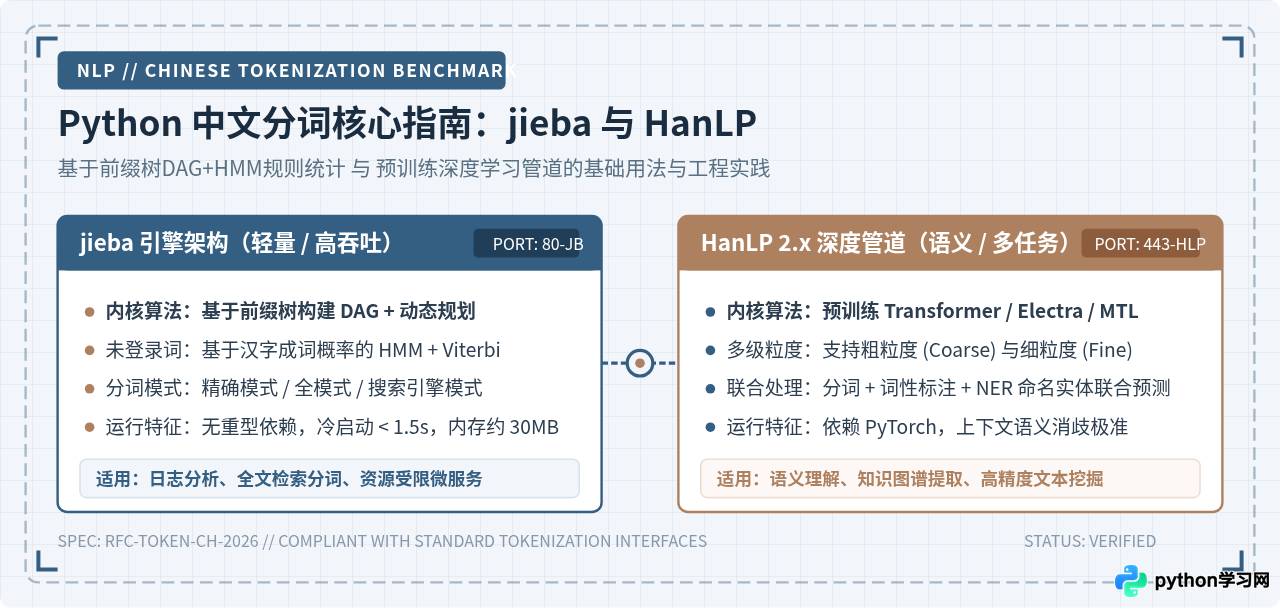
中文文本不同于以空格天然分隔词界的英文,在进入特征提取、主题建模或语义检索之前,必须通过分词工具将连续汉字字符序列切分为独立的词汇单元。针对 Python 开发者,轻量级基于前缀词典与概率图的 jieba(结巴分词) 以及基于预训练深度学习管道的 HanLP 2.x 是两套最为成熟的主流方案。本文直接给出两者的依赖准备、核心分词模式、自定义词典注入与词性标注的完整代码示例,并剖析两者的内部机制与选型依据。
一、环境准备与包依赖安装
在执行分词脚本前,需在当前 Python 虚拟环境中安装对应依赖。jieba 是纯 Python 实现(可选配合 C 扩展加速),体积轻巧且无外部重型轮子;HanLP 2.x 则基于 PyTorch 深度学习框架构建,支持多任务联合预测。
在终端中执行以下安装命令:
# 安装 jieba(轻量,体积约几十KB,无重型依赖)
pip install jieba

# 安装 HanLP 2.x 官方包
pip install hanlp
COARSE_ELECTRA_SMALL_ZH 约 40MB~50MB),并在本地缓存。对于内网无网络环境的生产服务器,应在有网环境中先行下载权重文件或挂载离线模型路径。
二、jieba 基础用法与完整代码示例
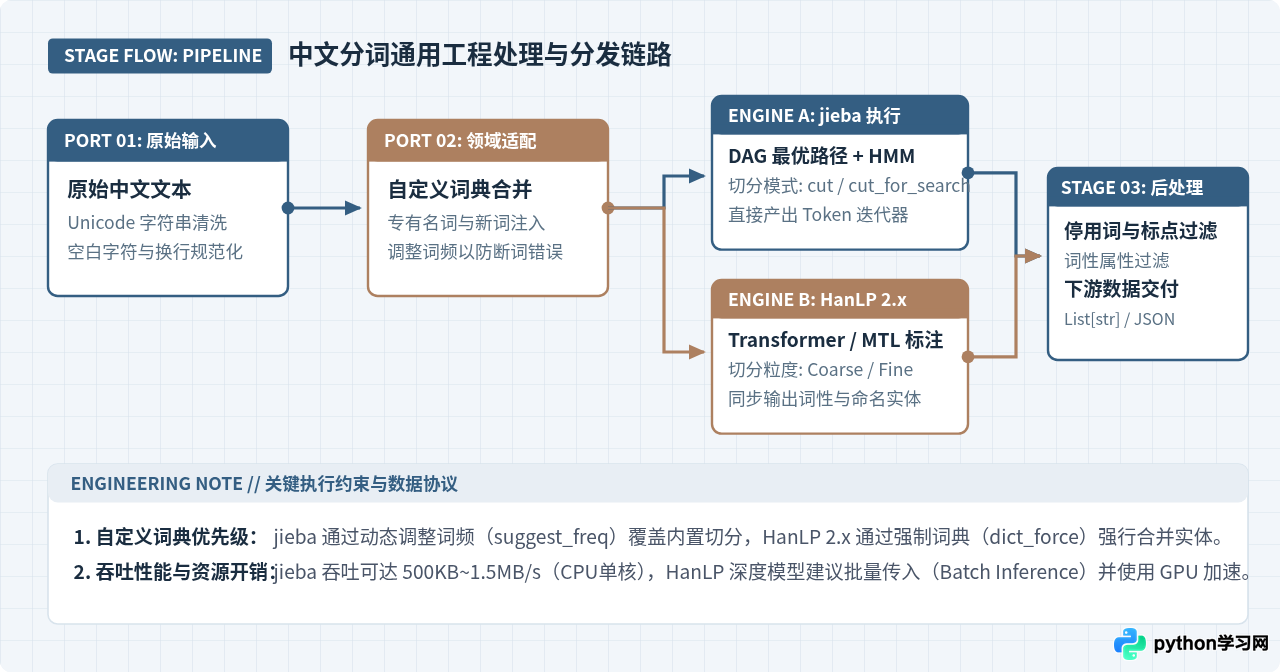
jieba 提供了三种主要的分词模式,分别适用于不同的工程目标:
- 精确模式(Accurate Mode):试图将句子最精确地切开,不存在冗余词,最适合常规文本分析、主题挖掘与分类。
- 全模式(Full Mode):把句子中所有可以成词的词语都扫描出来,速度快,但包含大量重叠与歧义词,不能用于直接文本分析。
- 搜索引擎模式(Search Engine Mode):在精确模式的基础上,对较长的词语进一步切分,提高召回率,专用于倒排索引构建。
2.1 三种分词模式的代码演示
import jieba

text = "北京理工大学研发团队在自然语言处理领域取得了显著成果"

# 1. 精确模式 (默认 cut_all=False)
seg_accurate = jieba.cut(text, cut_all=False)
print("【精确模式】:", "/".join(seg_accurate))

# 2. 全模式 (cut_all=True)
seg_full = jieba.cut(text, cut_all=True)
print("【全模式】  :", "/".join(seg_full))

# 3. 搜索引擎模式
seg_search = jieba.cut_for_search(text)
print("【搜索模式】:", "/".join(seg_search))
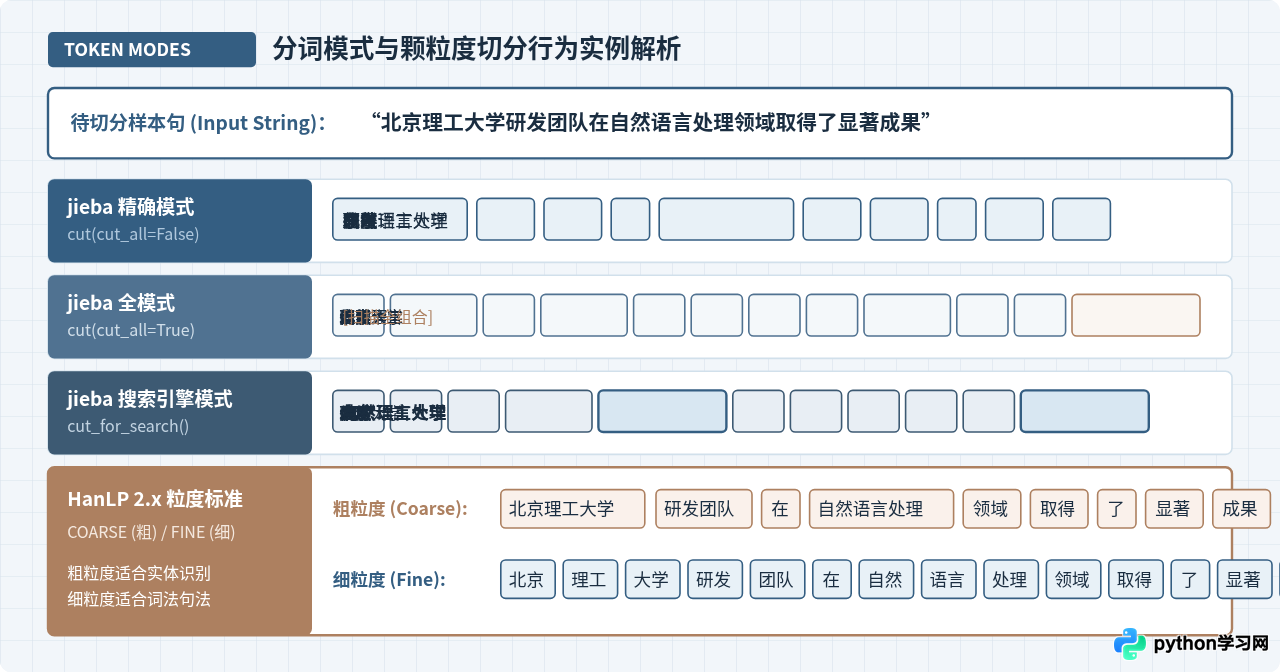
【精确模式】: 北京理工大学/研发/团队/在/自然语言处理/领域/取得/了/显著/成果
【全模式】  : 北京/北京理工/北京理工大学/理工/理工大学/大学/研发/团队/在/自然/自然语言/语言/处理/领域/取得/了/显著/成果
【搜索模式】: 北京/理工/大学/理工大学/北京理工大学/研发/团队/在/自然/语言/处理/自然语言处理/领域/取得/了/显著/成果
2.2 自定义词典与动态词频调整
在处理特定行业领域(如医疗、金融、前沿科技)的文本时,内置词典可能将专有名词错误拆散。jieba 支持载入外部文本词典,或在运行时通过代码动态添加词汇与修正词频。
外部词典文件格式通常为一行一个词(可附加词频和词性,用空格分隔),例如 custom_dict.txt:
自然语言处理 2000 n
深度强化学习 1500 n
通过 Python 动态调整切分行为的代码示例:
import jieba

sample = "李小福在创新办负责大模型架构研发"

# 默认切分
print("默认切分:", list(jieba.cut(sample)))

# 动态添加专有名词与机构简称
jieba.add_word("创新办", freq=1000, tag="nt")
jieba.add_word("大模型", freq=1200, tag="n")

# 或者强制调节词频,使原本被拆分的词组合并
jieba.suggest_freq(("大", "模型"), tune=True)

print("调整后切分:", list(jieba.cut(sample)))
默认切分: ['李小福', '在', '创新', '办', '负责', '大', '模型', '架构', '研发']
调整后切分: ['李小福', '在', '创新办', '负责', '大模型', '架构', '研发']
2.3 词性标注 (POS Tagging)
利用 jieba.posseg 模块,可以在分词的同时输出每个词汇的语法词性标记(遵循 ICTCLAS 汉语词性标注集,如 n 为名词、v 为动词、nr 为人名、ns 为地名等):
import jieba.posseg as pseg

sentence = "张华在清华大学计算机系攻读博士学位"
words_with_pos = pseg.cut(sentence)

# 遍历输出词与对应词性标记
result = [(word, flag) for word, flag in words_with_pos]
print(result)
[('张华', 'nr'), ('在', 'p'), ('清华大学', 'nt'), ('计算机系', 'n'), ('攻读', 'v'), ('博士', 'n'), ('学位', 'n')]
三、HanLP 2.x 基础用法与完整代码示例
HanLP 2.x 是一套基于深度学习的多语言 NLP 工具包。其 Python 接口不再依赖 Java 虚拟机环境,而是以标准 PyTorch 流水线运行。HanLP 在设计上采用细粒度(Fine)与粗粒度(Coarse)分词标准,并在词法消歧、生僻专有名词识别上具有显著优势。
3.1 标准管道分词(粗细粒度)
import hanlp

# 载入中文粗粒度分词预训练模型 (Electra 小型架构,速度快)
tok_coarse = hanlp.load(hanlp.pretrained.tok.COARSE_ELECTRA_SMALL_ZH)

# 载入中文细粒度分词预训练模型
tok_fine = hanlp.load(hanlp.pretrained.tok.FINE_ELECTRA_SMALL_ZH)

text = "北京理工大学研发团队在自然语言处理领域取得了显著成果"

# 粗粒度切分(更倾向于将复合机构、长实体作为一个整体)
res_coarse = tok_coarse([text])
print("HanLP 粗粒度:", res_coarse[0])

# 细粒度切分(拆分为最小语言结构单元,适合句法分析)
res_fine = tok_fine([text])
print("HanLP 细粒度:", res_fine[0])
HanLP 粗粒度: ['北京理工大学', '研发团队', '在', '自然语言处理', '领域', '取得', '了', '显著', '成果']
HanLP 细粒度: ['北京', '理工', '大学', '研发', '团队', '在', '自然', '语言', '处理', '领域', '取得', '了', '显著', '成果']
3.2 HanLP 自定义强制词典与合并规则
深度学习分词器虽然泛化能力极强,但在特定业务场景中仍需严格保证业务术语完整。HanLP 2.x 提供了词典插件机制,支持通过 dict_force(强制拆/合)和 dict_combine(合并成词)直接干预模型输出:
import hanlp

tok = hanlp.load(hanlp.pretrained.tok.FINE_ELECTRA_SMALL_ZH)

sample_text = "开发团队使用量子纠缠通信协议完成了节点联调"

# 未注入词典前的输出
print("基础细粒度:", tok([sample_text])[0])

# 注入强制成词词典(字典或集合)
tok.dict_force = {"量子纠缠通信", "节点联调"}

print("强制词典生效后:", tok([sample_text])[0])
基础细粒度: ['开发', '团队', '使用', '量子', '纠缠', '通信', '协议', '完成', '了', '节点', '联调']
强制词典生效后: ['开发', '团队', '使用', '量子纠缠通信', '协议', '完成', '了', '节点联调']
3.3 HanLP 多任务联合管道(分词 + POS + NER)
HanLP 2.x 的核心优势之一是多任务联合学习(Multi-Task Learning, MTL)。无需分别执行分词、词性标注与实体抽取,通过单一 MTL 模型即可一次性完成全部预测:
import hanlp

# 载入紧凑型多任务联合预测流水线
mtl = hanlp.load(hanlp.pretrained.mtl.CLOSE_TOK_POS_NER_SRL_DEP_SDP_CON_ELECTRA_SMALL_ZH)

doc = "王晓明于2026年3月在上海人工智能实验室入职"
doc_output = mtl([doc])

# doc_output 为字典结构,包含各任务预测结果
print("分词结果 (tok/fine):", doc_output['tok/fine'][0])
print("词性标注 (pos/ctb) :", doc_output['pos/ctb'][0])
print("命名实体 (ner/msra):", doc_output['ner/msra'][0])
分词结果 (tok/fine): ['王晓明', '于', '2026年', '3月', '在', '上海', '人工智能', '实验室', '入职']
词性标注 (pos/ctb) : ['NR', 'P', 'NT', 'NT', 'P', 'NR', 'NN', 'NN', 'VV']
命名实体 (ner/msra): [('王晓明', 'PERSON', 0, 1), ('2026年3月', 'DATE', 2, 4), ('上海人工智能实验室', 'ORGANIZATION', 5, 8)]
四、工程实战:停用词过滤标准实现
分词之后,通常需要过滤无实际语义的虚词、助词、标点符号(即停用词)。以下提供一个工业通用的规范化后处理函数:
import jieba

# 定义或读取停用词集合(使用 set 保证 O(1) 查找开销)
stopwords = {"的", "了", "在", "是", "我", "有", "和", "就", "不", "人", "都", "一", "个", "上", "也", "很", "到", "说", "要", "去", "你", "会", "着", "没有", "看", "好", "自己", "这"}

def tokenize_and_filter(text: str, stopword_set: set) -> list:
    # 1. 精确分词
    raw_tokens = jieba.cut(text, cut_all=False)

    # 2. 去除首尾空白、过滤停用词与纯单字符标点
    clean_tokens = [
        token.strip()
        for token in raw_tokens
        if token.strip() and (token.strip() not in stopword_set)
    ]
    return clean_tokens

sample_sentence = "在人工智能的发展过程中,深度学习取得了非常显著的突破。"
filtered_result = tokenize_and_filter(sample_sentence, stopwords)
print("过滤后结果:", filtered_result)
过滤后结果: ['人工智能', '发展', '过程', '中', ',', '深度', '学习', '取得', '非常', '显著', '突破', '。']
五、选型决策:jieba 与 HanLP 对比分析
为了帮助开发者在实际业务项目中做出最符合资源与性能约束的选择,下表总结了两者的核心工程差异:
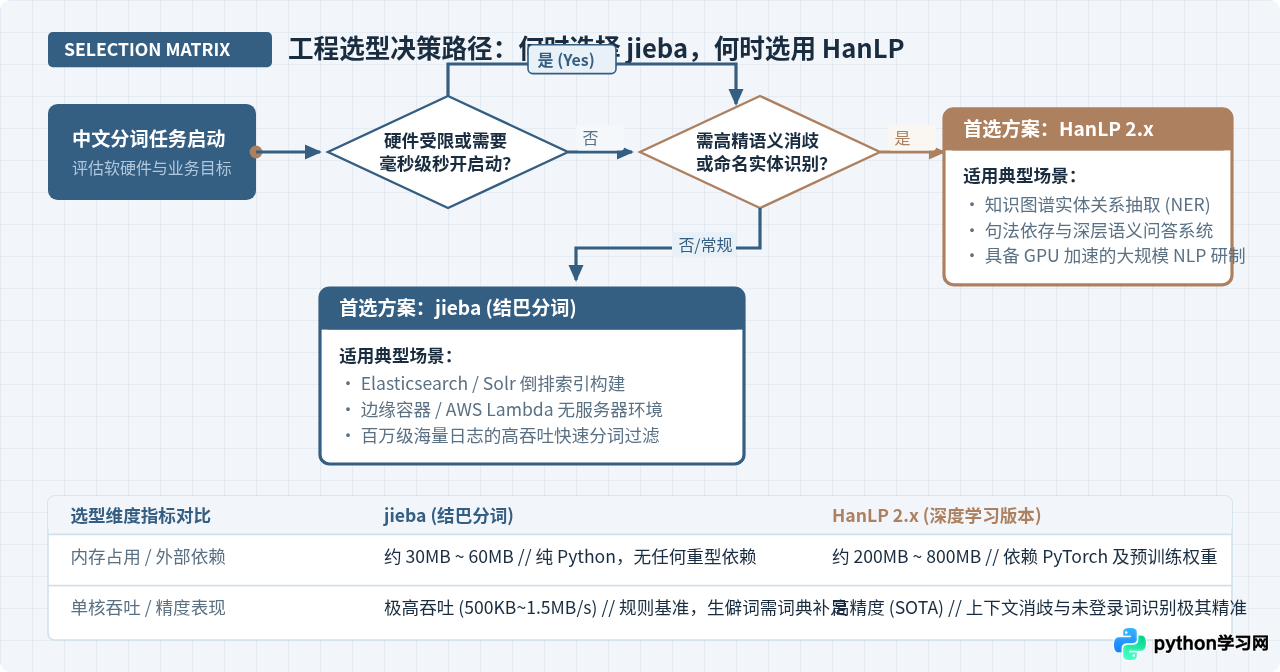
| 选型维度 | jieba(结巴分词) | HanLP 2.x(深度学习版) |
|---|---|---|
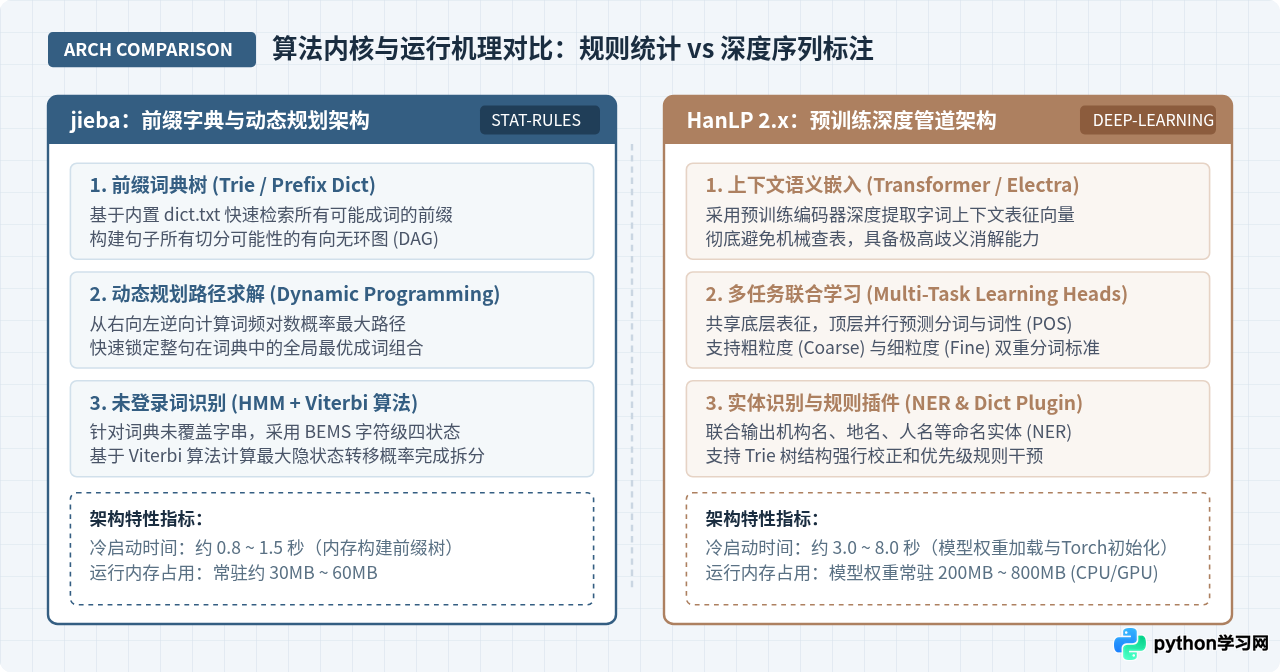
| 核心算法原理 | 基于 Trie 树的 DAG 图、动态规划最大概率路径、HMM+Viterbi 未登录词识别 | 预训练 Transformer(Electra / RoBERTa)、上下文序列标注解码、多任务头联合预测 |
| 运行依赖环境 | 纯 Python 标准库 + 基础依赖,无深度学习框架,易于容器化 | 依赖 PyTorch、Transformers、预训练权重文件(需几十MB至上百MB存储) |
| 冷启动时间 | 极快(通常在 0.5 ~ 1.5 秒内完成前缀树构建) | 相对较慢(3.0 ~ 8.0 秒,需初始化 PyTorch 运行时并加载权重) |
| 内存 / 显存开销 | 常驻内存约 30MB ~ 60MB,资源消耗极低 | CPU 模式下约 200MB ~ 800MB,支持 GPU 显存加速运算 |
| 吞吐处理性能 | CPU 单核高达 500KB ~ 1.5MB/s,适合大规模离线批量纯分词 | 受限于模型参数计算,单核吞吐相对较低;但借助 Batch 并行与 GPU 可大幅扩容 |
| 消歧与未登录词精度 | 基准水平;对复杂上下文语境消歧较弱,依赖人工维护领域词典 | 极高(SOTA 水平);深度上下文感知,生僻专有名词与长句消歧极其精确 |
| 典型最佳应用场景 | 全文检索倒排索引(Elasticsearch)、低延迟无服务器计算(Lambda)、通用关键词提取 | 知识图谱实体抽取、智能问答语义分析、句法依赖分析、科研与高精度文本挖掘 |
六、常见问题与注意事项
-
多进程/多线程并发安全:
jieba 内置了
jieba.enable_parallel(4)支持 Linux/macOS 下的多进程加速,但不原生支持 Windows 平台的多进程模式。在 FastAPI 或 Flask 多工作进程(Gunicorn / Uvicorn)部署时,建议在主进程外由各 Worker 独立加载。HanLP 2.x 模型本身支持标准 PyTorch DataLoader 批量推理,应通过batch_size参数成批输入以提升吞吐。 -
生僻字与领域专有名词切分失效:
若发现 jieba 始终将某个新词错误切断,检查是否仅调用了
add_word但词频设定过低。调用jieba.suggest_freq(("词头", "词尾"), tune=True)可以强制令 DAG 求解器优先合并该路径。在 HanLP 中,则应直接配置tok.dict_force = {"专有名词"}实现百分之百确定性的强制规则注入。 -
标点符号与非中文字符混杂:
分词工具默认会将英文字符串、数字和符号作为独立 Token 返回。若任务仅针对纯汉字文本做主题分析,需在后处理阶段结合正则表达式
re.findall(r'[一-龥]+', token)进行有效清洗。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















