


Python中何时使用@property替代普通方法或直接公开属性
深入解析在Python类设计中,何时使用@property替代普通方法或直接公开属性。通过核心决策树、描述符底层机制、经典代码重构场景及性能反模式,帮助开发者掌握Pythonic的属性设计之道。
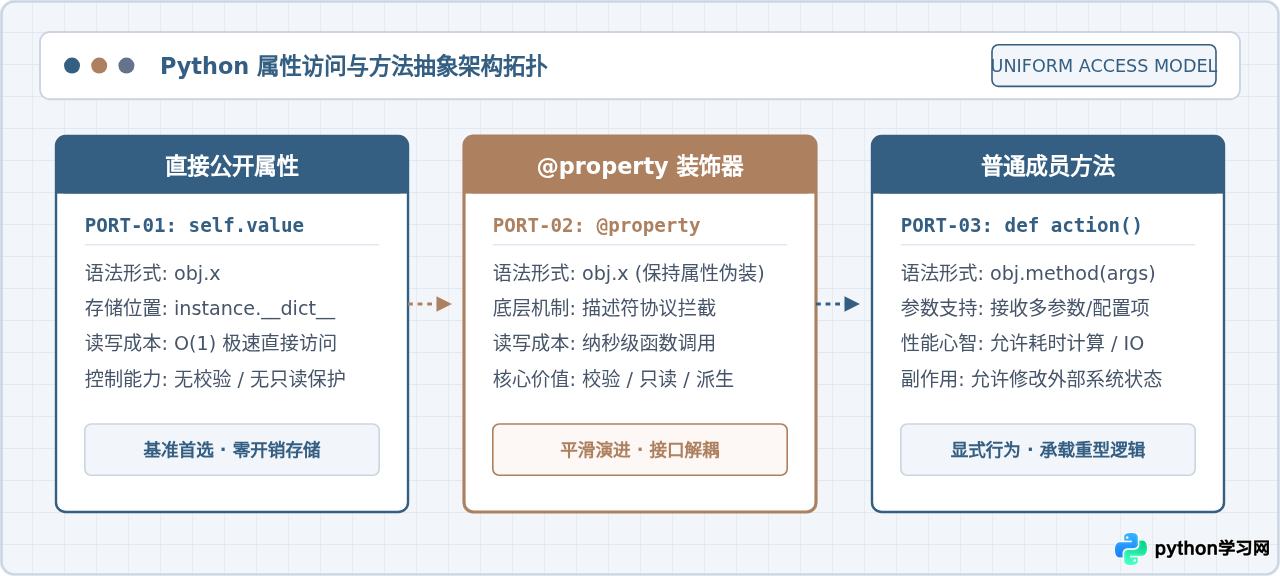
在 Python 面向对象设计中,选择直接公开属性、使用 @property 装饰器还是定义普通方法,核心取决于调用语义、数据一致性维护成本与性能心智预期。最直接的结论是:默认优先直接使用公开属性;当且仅当需要数据校验、动态只读保护或轻量派生计算,且希望无缝兼容已有的 obj.attr 调用语法时,使用 @property;而一旦操作涉及耗时计算、网络/磁盘 I/O、显式副作用或需要传入额外参数时,必须坚决使用普通方法。
一、始于极简:直接公开属性的设计基准
许多初学 Python 的开发者受 Java 或 C++ 等强类型语言习惯的影响,习惯在定义类之初便不假思索地为每一个内部变量编写 get_value() 和 set_value() 防御性样板代码。然而在 Python 中,这种做法不仅显得冗余繁琐,更违背了 Python 的核心设计哲学。
Python 具备统一访问原则(Uniform Access Principle)支持。在类设计的初始阶段,只要某个状态属于纯粹的轻量数据存取,没有任何额外的校验逻辑或衍生计算,直接将其暴露为公开属性(Public Attribute)是最高效且最符合 Pythonic 风格的做法:
# 推荐的初始设计:直接使用公开属性
class Rectangle:
    def __init__(self, width: float, height: float):
        self.width = width
        self.height = height

# 调用端直接读写
rect = Rectangle(10.0, 20.0)
rect.width = 15.0
print(f"矩形宽度: {rect.width}")
示例输出:
矩形宽度: 15.0在这个阶段,属性的读写直接作用于实例底层的属性字典 rect.__dict__,时间复杂度为纯粹的字典查表 $O(1)$,没有任何中间函数调用的开销。更重要的是,直接公开属性保持了 API 的纯粹与简洁。调用方无需在每个属性后追加括号,代码更具可读性。
二、选型核心:属性演进与方法决策路径
随着业务逻辑的演进,最初直接公开的属性往往会遇到新的需求挑战:某些数值需要限定有效区间(例如温度不能低于绝对零度、尺寸不能为负数)、某些字段需要只读防篡改,或者需要由几个基础属性动态计算得出。面对这些变化,我们应该如何精准选择封装方式?
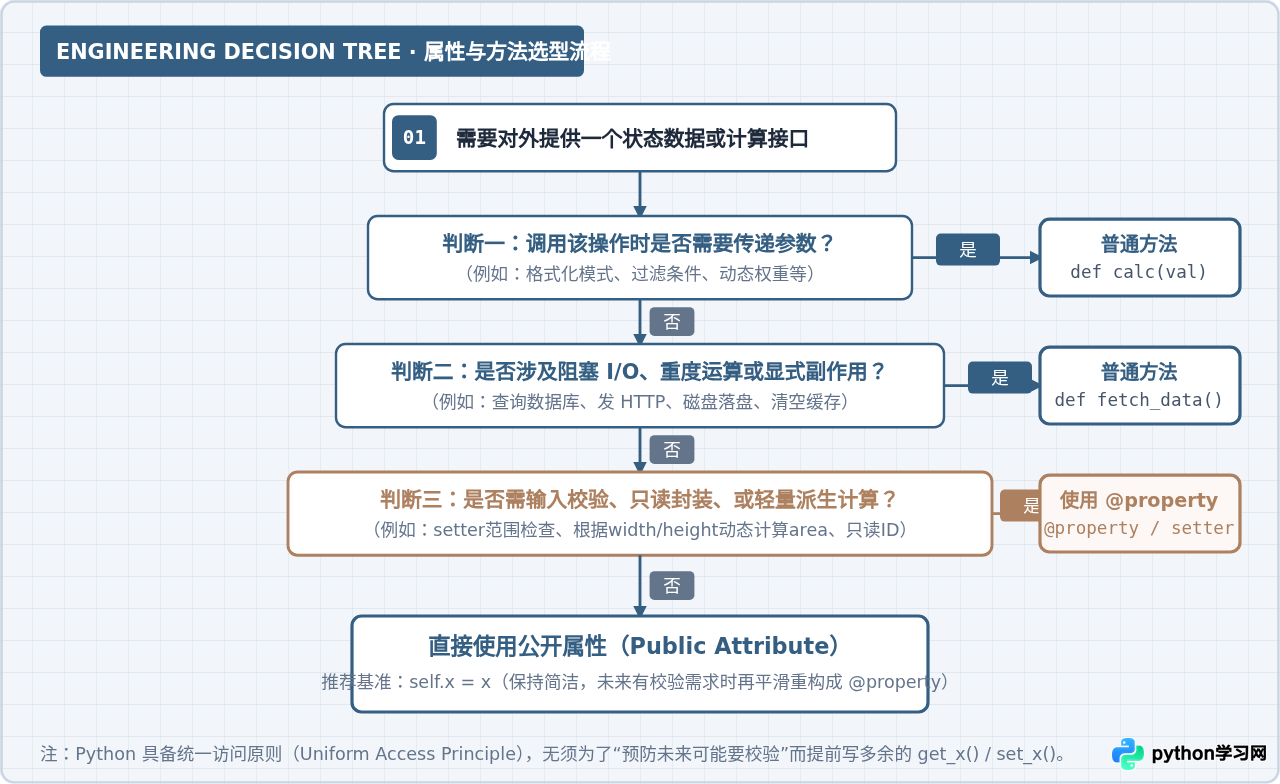
按照图 1 的工程决策路径,开发者在面对接口设计时只需依次回答三个核心问题:
- 操作是否需要额外参数? 若需要根据外部传入的格式串、计算策略或倍率动态计算,
@property无法接收除self之外的参数,必须采用普通方法。 - 操作是否涉及高耗时、阻塞 I/O 或显式副作用? 属性访问(点操作符
obj.attr)在开发者的直觉心智中应当是廉价且安全的。若操作需要发起 HTTP 请求、查询数据库、写入磁盘,或者执行 $O(N^2)$ 的算法,将其伪装成属性会诱导调用者在循环中频繁调用,造成严重性能灾难。这类重型操作必须定义为普通方法(如fetch_remote_data()、sync_to_disk())。 - 是否需要校验、保护或轻量派生? 如果操作属于轻量逻辑,且希望外部调用代码保持属性语法不变,则应当果断使用
@property替代原有的直接属性暴露。
三、何时使用 @property 替代直接公开属性
@property 最强大的价值在于实现无感知重构(Smooth Refactoring)。当内部逻辑发生变更时,外部使用该类的上游调用代码完全不需要做任何语法修改。具体有以下四大典型场景:
场景一:动态数据校验与边界拦截
假设系统最初公开了温度属性 celsius,后续业务要求严禁传入低于绝对零度(-273.15 ℃)的非法数值。利用 @property 配合 setter,可以在不改变调用方 temp.celsius = 25 语法的前提下,无缝嵌入类型与范围校验:
class TemperatureSensor:
    def __init__(self, celsius: float):
        # 初始化时同样会触发 @celsius.setter 校验
        self.celsius = celsius

    @property
    def celsius(self) -> float:
        """只读获取摄氏度"""
        return self._celsius

    @celsius.setter
    def celsius(self, value: float) -> None:
        """赋值拦截与合法性校验"""
        if not isinstance(value, (int, float)):
            raise TypeError(f"温度必须是数值类型,传入了: {type(value).__name__}")
        if value < -273.15:
            raise ValueError(f"温度不能低于绝对零度 (-273.15℃),传入了: {value}")
        self._celsius = float(value)

# 正常调用验证
sensor = TemperatureSensor(25.0)
sensor.celsius = 36.5
print(f"当前温度: {sensor.celsius}℃")

# 异常拦截验证(示例输出说明)
try:
    sensor.celsius = -300
except ValueError as e:
    print(f"拦截成功: {e}")
示例输出:
当前温度: 36.5℃
拦截成功: 温度不能低于绝对零度 (-273.15℃),传入了: -300.0
场景二:轻量派生属性与状态自动同步
当一个属性的值可以通过其他基础属性实时推导得出时,如果采用直接公开属性并在构造函数中一次性赋值,一旦基础属性被修改,派生属性就会出现数据不一致的严重 bug。利用 @property 动态求值,可以彻底杜绝状态滞后:
class Circle:
    def __init__(self, radius: float):
        self.radius = radius

    @property
    def diameter(self) -> float:
        """根据半径动态计算直径"""
        return self.radius * 2

    @diameter.setter
    def diameter(self, value: float) -> None:
        """修改直径时,反向自适应更新半径"""
        if value <= 0:
            raise ValueError("直径必须为正数")
        self.radius = value / 2

c = Circle(5.0)
print(f"半径: {c.radius}, 直径: {c.diameter}")
# 修改直径,半径自动联动
c.diameter = 20.0
print(f"更新后半径: {c.radius}, 直径: {c.diameter}")
示例输出:
半径: 5.0, 直径: 10.0
更新后半径: 10.0, 直径: 20.0
场景三:构建只读属性与对外安全封装
在企业级开发中,某些对象的关键标识(如数据库主键 ID、账户唯一 UUID、创建时间戳)在实例化后严禁被外界意外重写。若仅定义 @property 的 getter 而不实现对应的 setter,该属性即成为只读属性。任何尝试赋值的操作都会被 Python 解释器在运行时抛出 AttributeError:
from datetime import datetime

class AuditLog:
    def __init__(self, record_id: str, operator: str):
        self._record_id = record_id
        self._operator = operator
        self._created_at = datetime.now()

    @property
    def record_id(self) -> str:
        return self._record_id

    @property
    def created_at(self) -> datetime:
        return self._created_at

log = AuditLog("REC-9821", "admin")
print(f"日志记录号: {log.record_id}")

try:
    log.record_id = "REC-9999"  # 尝试恶意或意外篡改
except AttributeError as e:
    print(f"篡改被拒绝: {e}")
示例输出:
日志记录号: REC-9821
篡改被拒绝: property 'record_id' of 'AuditLog' object has no setter
四、底层透视:@property 的描述符运行机制
为了理解为什么 @property 能够拦截对普通属性的访问,我们需要透视 Python 的底层协议。@property 本质上是 Python 内置的数据描述符(Data Descriptor)类,它实现了描述符协议中的 __get__、__set__ 与 __delete__ 特殊方法。
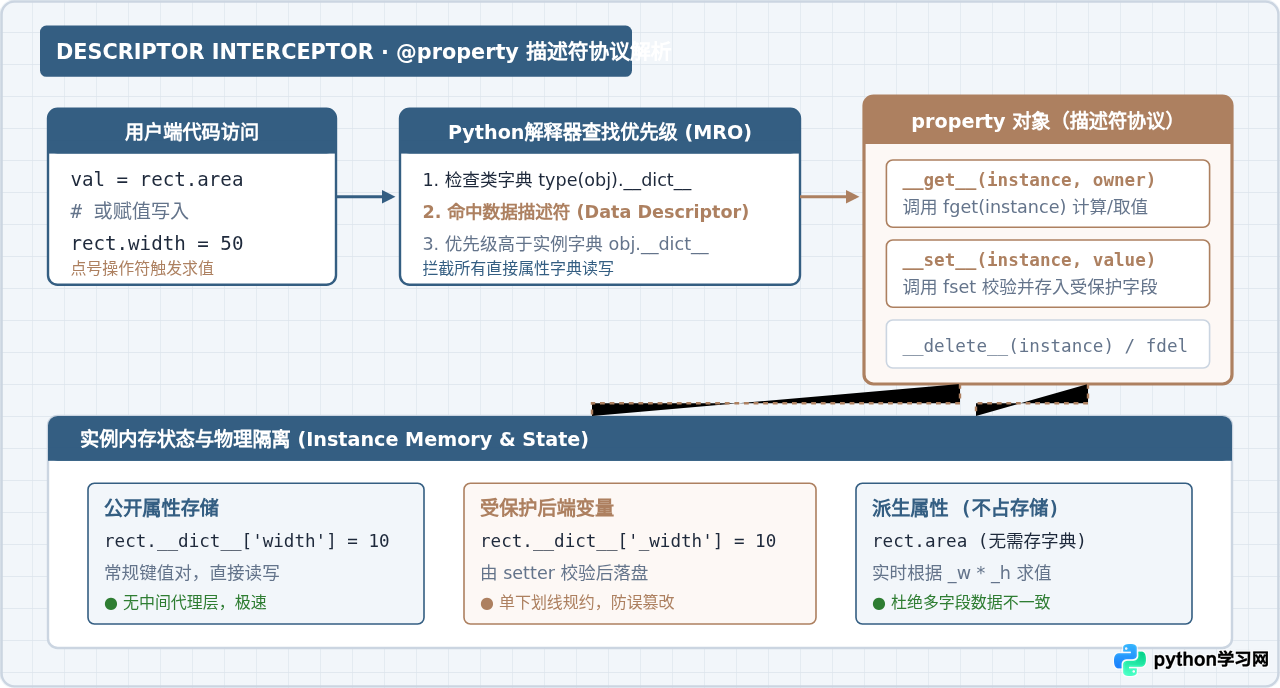
当执行 obj.x 或 obj.x = val 时,Python 解释器的底层查找顺序如下:
- 首先检查对象所属类
type(obj)及其方法解析顺序(MRO)中的类字典。 - 如果在类上找到了同名对象,并且该对象定义了
__set__(即数据描述符,@property实例正属于此类),则优先触发数据描述符的__get__或__set__方法,直接跳过并屏蔽实例自身的obj.__dict__。 - 只有当类上不存在同名属性,或者类属性只是非数据描述符(仅定义
__get__),解释器才会去读取实例本身的字典obj.__dict__['x']。
正因为数据描述符的优先级高于实例字典,我们在类中定义的 @property 才能牢牢锁住属性的访问入口。通常,开发者会使用一个加单下划线前缀的保护变量(如 self._celsius)作为底层后端存储,避免在 getter/setter 内部形成无限递归。
五、严守边界:何时坚决不能用 @property
@property 虽好,但绝不能过度使用。若把不适宜的逻辑硬生生包装成属性,不仅破坏了代码的可维护性,还会导致隐蔽的性能与架构缺陷。
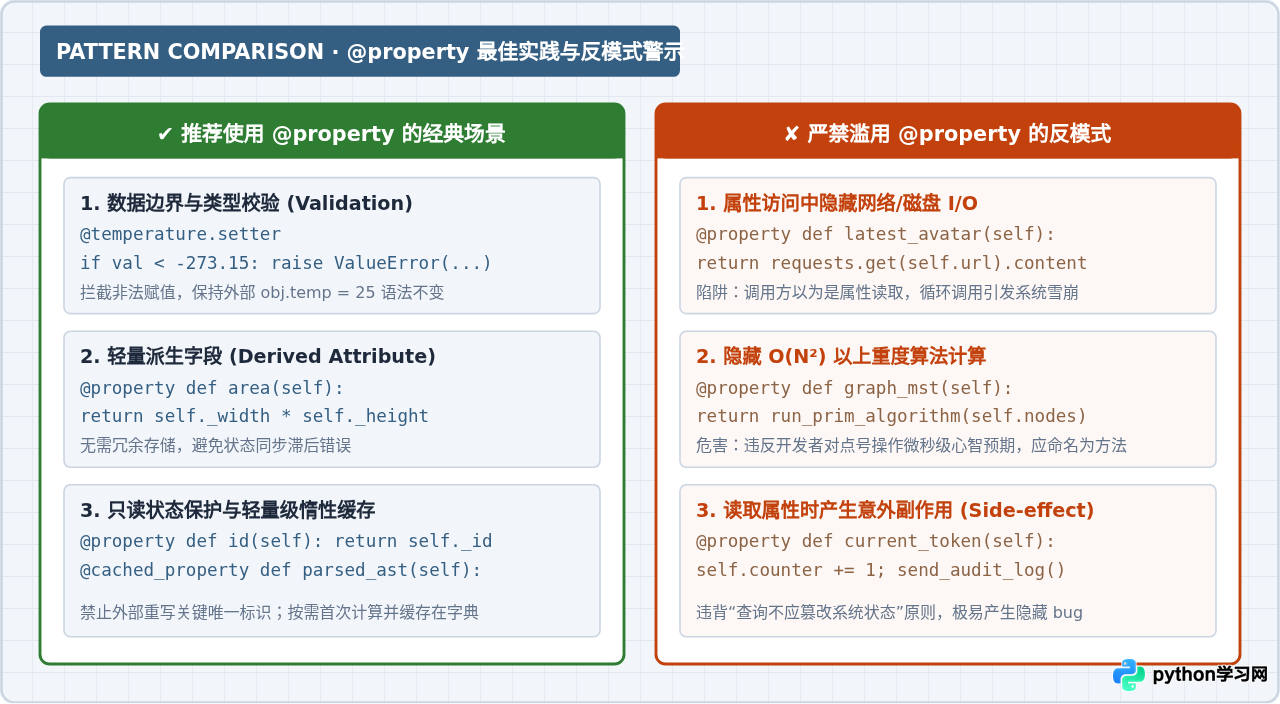
边界一:严禁在属性中隐藏阻塞 I/O 或网络通信
当调用者写下 user.avatar 或 status = device.is_online 时,心理预期是纳秒级别的内存寻址。如果内部执行了 requests.get() 或复杂的 SQL 查询,调用者便可能在列表遍历中随意调用,瞬间导致应用被外部 I/O 拖垮:
# ✘ 反模式:将网络 I/O 伪装成属性
class UserProfile:
    def __init__(self, avatar_url: str):
        self.avatar_url = avatar_url

    @property
    def avatar_bytes(self) -> bytes:
        # 严重反模式!每次访问属性都在进行耗时的网络请求
        import urllib.request
        return urllib.request.urlopen(self.avatar_url).read()

# ✔ 正确做法:使用带动作含义的动词方法
class UserProfile:
    def __init__(self, avatar_url: str):
        self.avatar_url = avatar_url

    def fetch_avatar(self, timeout_sec: int = 5) -> bytes:
        """显式方法:提醒调用方该操作具有延迟和网络异常风险"""
        import urllib.request
        with urllib.request.urlopen(self.avatar_url, timeout=timeout_sec) as resp:
            return resp.read()
边界二:严禁在属性读取中引入显式副作用
在面向对象设计中,属性读取(Getter)在语义上必须具备幂等性(Idempotence),即连续多次读取 obj.x 应该返回相同的结果,且不应当改变对象的内部业务状态。如果访问一个属性会导致清空缓存、递增计数器、写入数据库事务或触发审计事件,必须使用普通方法(如 pop_buffer()、record_access())来承载。
边界三:操作需要接收额外参数
@property 规范限制了它只能接收 self。当获取某个值需要附加过滤条件、格式化样式或时区参数时,必须使用普通方法。例如:date.format(pattern="%Y-%m-%d") 不能也不应该被改写成属性。
六、选型全景矩阵与落地速查
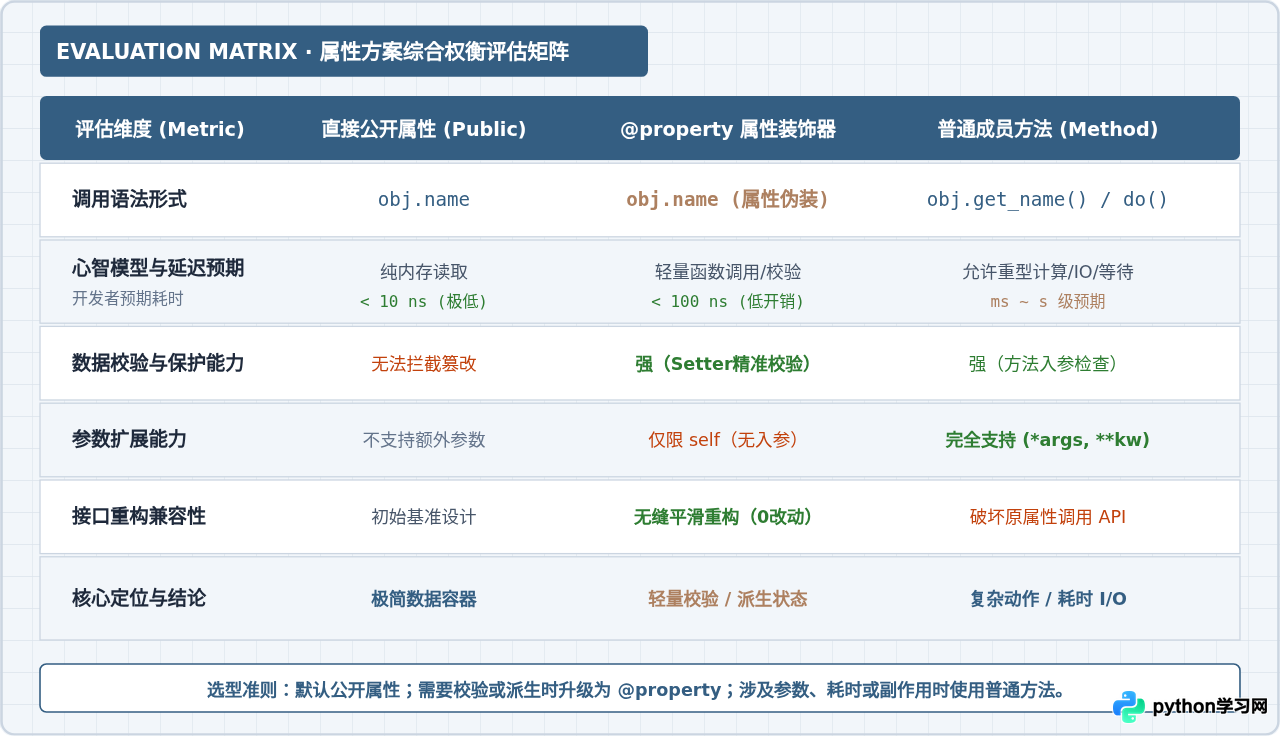
为了帮助开发团队建立统一的代码规范与设计直觉,下表总结了三种属性处理方式在各个技术维度上的横向对比:
| 技术维度 | 直接公开属性 (Public Attribute) | @property 装饰器 | 普通成员方法 (Method) |
|---|---|---|---|
| 调用语法 | obj.field |
obj.field(保持属性外观) |
obj.action(*args)(显式括号调用) |
| 调用延迟预期 | < 10 ns(极低,纯字典查找) | < 100 ns(极低,轻量函数调用) | 微秒至秒级(允许重度计算与 I/O) |
| 数据校验能力 | 无(无法拦截非法值赋值) | 强(通过 setter 精准拦截校验) | 强(通过方法入参进行完整检查) |
| 参数支持能力 | 仅赋值右值 | 仅限 self(无额外参数) |
支持完整参数列表与关键字参数 |
| 重构兼容性 | 初始基准,未来可平滑升为 property | 在原有属性调用处零改动平滑重构 | 改变 API 语法(需加括号及可能传参) |
| 业务意图 | 纯数据载体、状态容器 | 带保护/派生计算的受控状态 | 动作、流程、复杂运算、外部交互 |
七、工程实践常见问题解答
在普通业务逻辑、Web 应用或数据处理管道中,@property 带来的纳秒级函数调用开销几乎可以忽略不计。但在高频密集数学计算(例如在迭代数千万次的内层循环中)读取属性时,可以将其临时缓存为循环内的局部变量:
# 高频密集循环优化技巧
width = rect.width  # 将 property 解析并提升到循环外
for _ in range(10_000_000):
val = width * 2如果某个派生属性的计算开销略大(例如解析一段复杂的 JSON 结构或计算正则匹配),但希望只在首次访问时执行一次,后续均直接复用结果,可以使用 Python 3.8+ 标准库提供的 functools.cached_property:
from functools import cached_property

class DataSet:
    def __init__(self, raw_data: list):
        self._raw_data = raw_data

    @cached_property
    def variance(self) -> float:
        """只在首次访问时计算,随后直接存入实例 __dict__ 变成本地属性"""
        print("计算方差中...")
        mean = sum(self._raw_data) / len(self._raw_data)
        return sum((x - mean) ** 2 for x in self._raw_data) / len(self._raw_data)
总结
在 Python 中,选择属性抽象方式的黄金法则是:以“直接公开属性”为起点,以“@property”为轻量演进阶梯,以“普通方法”承载重型逻辑与显式行为。不提前编写无意义的样板 Getter/Setter,不将耗时 I/O 隐藏在属性背后,始终让调用的语法形式忠实反映底层操作的成本与行为,是写出优雅、高效、易维护 Python 代码的核心基石。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















