


《利用Python进行数据分析》英文原版PDF与中文译本对照阅读指南
针对《利用Python进行数据分析》(Python for Data Analysis)英文原版与中文译本的对照阅读指南,涵盖版本对应、分屏环境搭建、术语对照规律、双语同步推进步骤与常见混淆点解析。
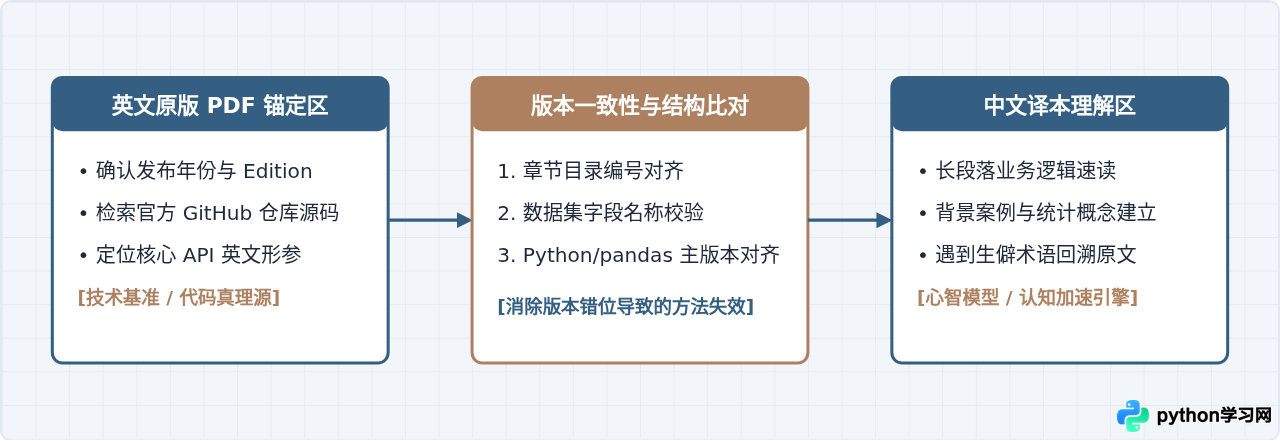
对照阅读《利用Python进行数据分析》(Python for Data Analysis)的核心目标,是用中文译本的高阅读流利度快速掌握业务概念,同时用英文原版锁定精确的方法签名、数据结构术语与报错根源。通过建立版本对齐机制、双屏阅读流与术语交叉映射表,读者可以规避翻译滞后与语义偏差,建立扎实的数据分析编程心智模型。
一、版本核对与文献基准对齐
在开展对照阅读前,最关键的第一步是确认手头英文原版 PDF 与中文译本的版本号(Edition)。作者 Wes McKinney(pandas 项目创始人)在书籍改版中对底层代码体系进行了颠覆性重写。若版本发生错配,代码语法与章节编排将完全无法一一对应。
| 版本标识 | 英文原版关键技术栈 | 对应中文译本特征 | 对照阅读主要风险点 |
|---|---|---|---|
| 第 1 版 (1st Edition) | Python 2.7, pandas 早期版本 | 机械工业出版社(封面为绿褐色带皮水果) | 已废弃。语法包含 print "x",不可与第 2/3 版对照。 |
| 第 2 版 (2nd Edition) | Python 3.6, pandas 0.20+ | 机械工业出版社(封面为树胶提取或狐猴插图) | 部分绘图与索引 API 在 pandas 1.4+ 中发出弃用警告。 |
| 第 3 版 (3rd Edition) | Python 3.10, pandas 2.0+, NumPy 1.23+ | 机械工业出版社第三版(标明“基于 Python 3.10 与 pandas 2.x”) | 全面采用最新 API,弃用了 append 等方法,推荐严格同版对照。 |
版本判定方法:翻开英文 PDF 与中文书的前言(Preface)或第一章,核对 pandas 导入说明与 Python 解释器版本要求。必须确保双方处于同一版次(强烈建议统一选择第 3 版,或同为第 2 版)。
二、双语对照阅读的操作流程与执行步骤
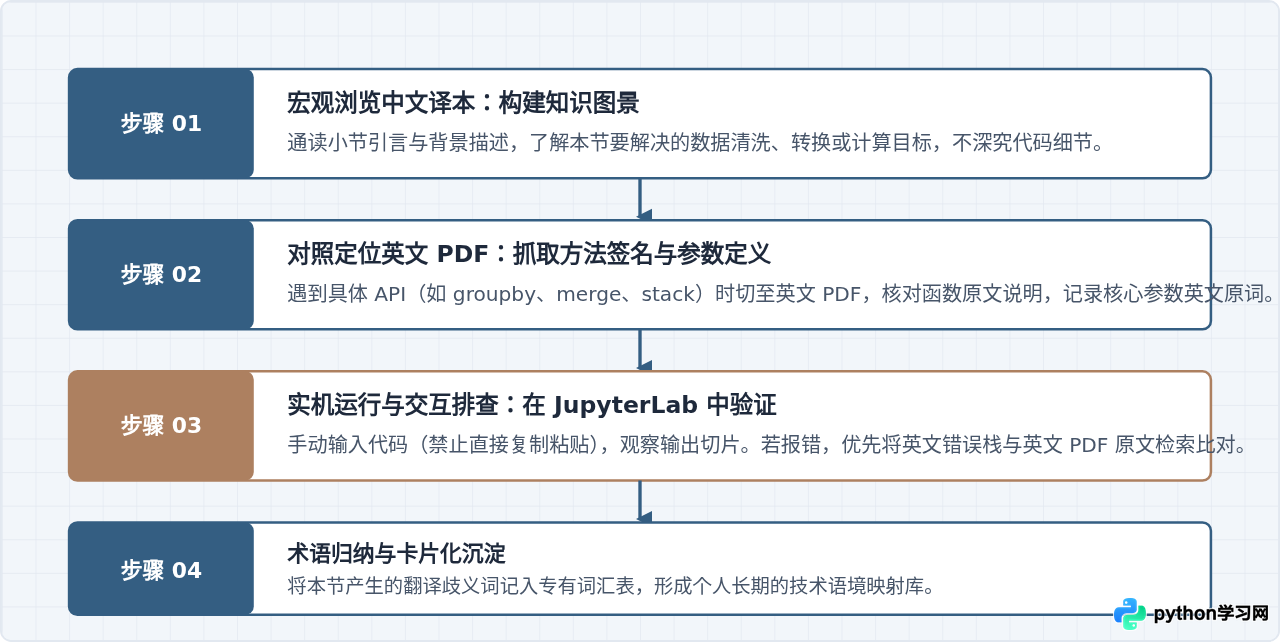
对照阅读绝非逐字逐句的机械比对,那样会导致阅读负担翻倍。科学的对照法采用“以中文主导语流、以英文锚定代码与术语、在终端即时验证”的三步闭环。
双屏分屏工作区配置建议
为了保证上述流程平滑运作,建议在单显示器(或双显示器)环境下组织视窗布局:
- 左侧屏幕(占比 40%):放置中文译本(实体书或电子版),承担“语流加速”功能,用于大段理解背景、业务分析目的和章节总结。
- 中间屏幕(占比 35%):放置英文原版 PDF 阅读器(推荐支持全文字符检索与书签跳转的工具,如 SumatraPDF、Acrobat),随时使用
Ctrl + F检索函数名。 - 右侧屏幕(占比 25%):激活 Jupyter Notebook 或 VS Code 终端,作为实时沙盒。
三、核心术语对照规律与歧义解析
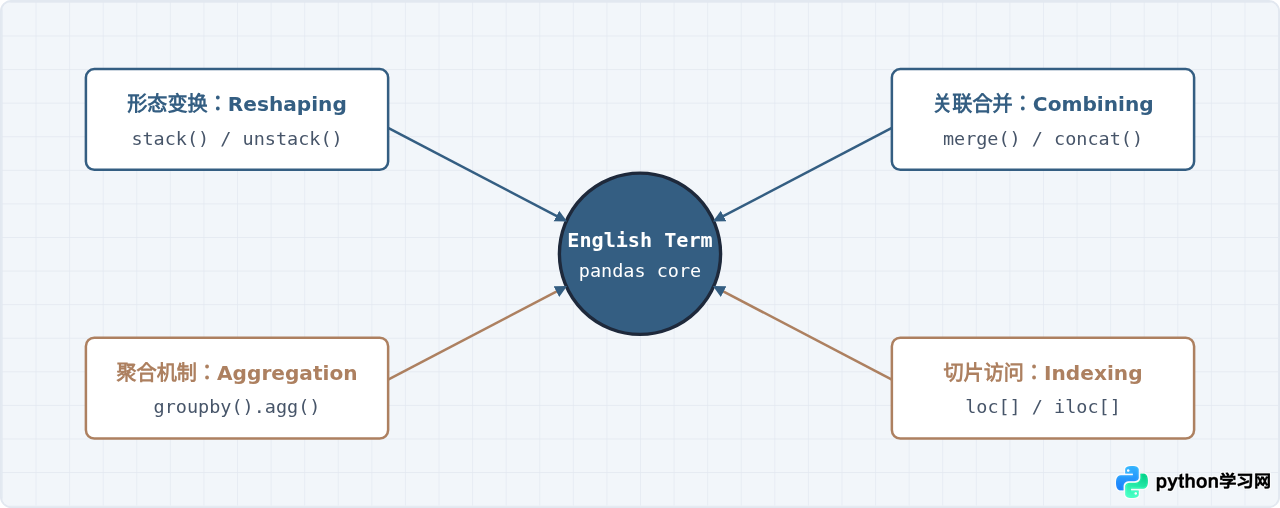
在中文翻译过程中,由于汉语在表达计算机特定概念时的灵活性,常常出现“一词多译”或“多词同译”的现象。这种现象极易给初学者造成混淆。熟练掌握以下核心术语的原词,是阅读原版 PDF 的重要收益。
| 英文原词 (PDF) | 中文译本常见表述 | 在 pandas / NumPy 中的实际物理含义 | 典型易混淆点 |
|---|---|---|---|
| Broadcasting | 广播 / 传播 | 不同形状(shape)的数组之间进行算术运算的底层内存广播规则。 | 不能理解为“广播通知”,它是矢量化计算的核心扩展机制。 |
| Reshape / Melt / Pivot | 重塑 / 融合 / 透视 | pivot 为长表变宽表,melt 为宽表变长表,reshape 改变多维结构。 |
中文常统称为“数据形态重塑”,导致分不清数据流转方向。 |
| Align / Alignment | 对齐 / 数据对齐 | Series 或 DataFrame 进行二元计算时,依据 Index 自动对齐标签。 | 非排版对齐,而是基于键(Key)的值匹配计算。 |
| Groupby Split-Apply-Combine | 拆分-应用-合并 | 分组聚合的标准模式:按键分割、施加计算、拼合结果。 | 有些译本漏译或将 Apply 译为“赋值”,混淆了函数映射本质。 |
| Hierarchical Indexing | 层次化索引 / 分层索引 | MultiIndex 数据结构,允许单个轴上存在多个索引层级。 | 有时与 Database 的外键层级混为一谈。 |
| Imputation | 填补 / 插补 / 缺失值填充 | 利用统计值(均值、中位数或插值)填充缺失数据(NaN)。 | 常与 drop(丢弃)相关的清理逻辑混在一节中描述。 |
当在中文书中看到一个令人费解的词汇时,直接通过书末的索引(Index)或英文原版 PDF 的搜索功能查找对应英文,90% 的理解困惑都会迎刃而解。
四、代码实战场景中的对照排错
在阅读到进阶章节(如“数据规整:合并、重塑与转换”或“时间序列分析”)时,读者最常遇到的问题是:中文书的代码在本地运行报错,或者输出与书本截图不一致。此时切忌盲目调试,应当遵照原版进行对比。
groupby 时 observed 参数在不同类型分类数据中的默认值变迁。
以下是一段标准的验证脚本。在实际对照时,应在本地环境执行下列代码以检验 pandas 版本特性:
import numpy as np
import pandas as pd

# 验证环境版本是否与对照书籍一致
print(f"Current pandas version: {pd.__version__}")

# 构建书籍第 8 章常见的层级索引 DataFrame
data = pd.DataFrame(
    np.arange(6).reshape((2, 3)),
    index=pd.Index(["Ohio", "Colorado"], name="state"),
    columns=pd.Index(["one", "two", "three"], name="number")
)

# 观察 stack 与 unstack 的过程
# 原版将其解释为:Pivot a column level to an index level (stack)
result = data.stack()
print("--- Stack Output (Narrow format) ---")
print(result)
运行输出示例:
Current pandas version: 2.2.0
--- Stack Output (Narrow format) ---
state     number
Ohio      one       0
          two       1
          three     2
Colorado  one       3
          two       4
          three     5
dtype: int64
当阅读中文译本关于“堆叠(stack)”的描述感到抽象时,英文原版的表述 "pivoting a level of the column labels to the row labels" 能够精准揭示其底层物理本质:把列标签层级旋转为行标签层级。
五、对照阅读常见问题与注意事项
- 不要把时间浪费在非代码文字的机械对译上:案例中的背景故事、历史由来,阅读中文即可;一旦涉及函数定义、参数默认值(如
inplace=False)、算法复杂度说明,必须核对英文。 - 注意中文排版中代码字符的印刷错误:在部分纸质译本中,破折号与连字符、下划线
_缺失或英文字符全半角错误偶尔发生。如果代码报SyntaxError,直接查看英文原版对应代码块是最高效的验证手段。 - 利用官方随书 Notebook 规避手误:Wes McKinney 在 GitHub 上公开了完整的全书源码(仓库名为
wesm/pydata-book)。如果对照两者后仍存疑,克隆该官方仓库并执行对应的.ipynb文件,这是最为客观的代码验证标准。
按照本指南搭建好版本基准与分屏视窗后,即可从第 4 章(NumPy 基础)或第 5 章(pandas 入门)开始对照实践。以实机输出验证认知,以原语建立直觉,是在数据分析领域稳步提升代码效能的最佳路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















