


Python中怎么用切片提取字符串的奇数位或偶数位字符?
详细解析在Python中使用切片语法提取字符串奇数位或偶数位字符的具体方法,厘清自然序数与0基索引的对应关系,并提供完整的代码示例、执行机制拆解与避坑指南。
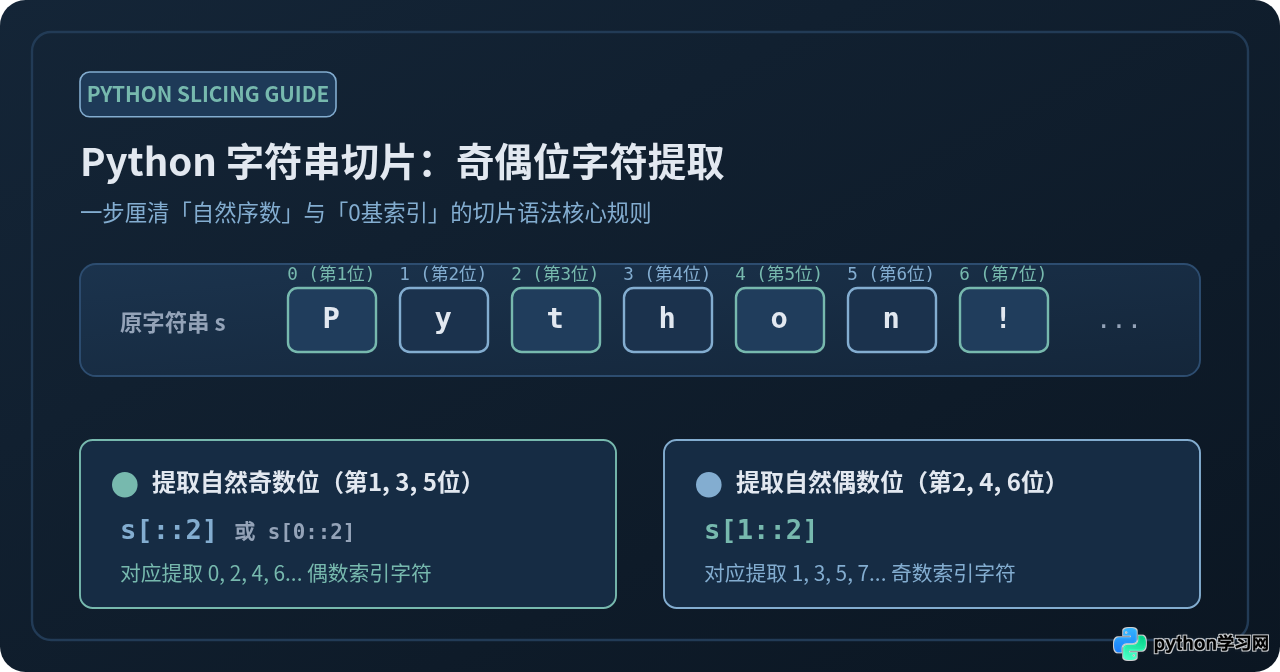
s[start:stop:step],将步长参数 step 设置为 2 即可实现隔位跳步提取:
- 提取日常自然习惯的奇数位(第 1、3、5 位):使用
s[::2](或s[0::2])。 - 提取日常自然习惯的偶数位(第 2、4、6 位):使用
s[1::2]。 - 若需求指程序底层奇数索引(索引下标为 1、3、5):对应使用
s[1::2];偶数索引则对应s[::2]。
在实际数据处理或文本解析场景中,我们经常会遇到交替混排的信息。例如硬件通信协议中返回的十六进制交叉码、数据校验时的奇偶校验位分离,或者从类似 "A1B2C3D4" 的编码串中分别抽取出纯字母(奇数位)与纯数字(偶数位)。使用常规的 for 循环配合条件判断虽然也能完成,但代码冗长且执行效率较低。而在 Python 中,内置的切片语法提供了极为简洁高效的原生解决方案。
一、先厘清核心前提:自然序号还是 Python 索引?
很多开发者在编写代码时偶尔会把奇数位和偶数位提取反,根本原因并不在于切片语法本身难以掌握,而在于人类日常表达习惯与计算机 0 基索引(0-based indexing)之间的位移差:
- 人类语言视角(从 1 开始计数):人们常说的“第 1 个字符”对应奇数位,但其在 Python 内部的索引下标恰好是
0;“第 2 个字符”对应偶数位,其索引下标恰好是1。 - 程序索引视角(从 0 开始计数):若需求直接规定“提取所有奇数下标的字符”,则指向的是索引
1, 3, 5, 7...。
为了直观理清这种交错对应关系,请观察下方的映射结构:
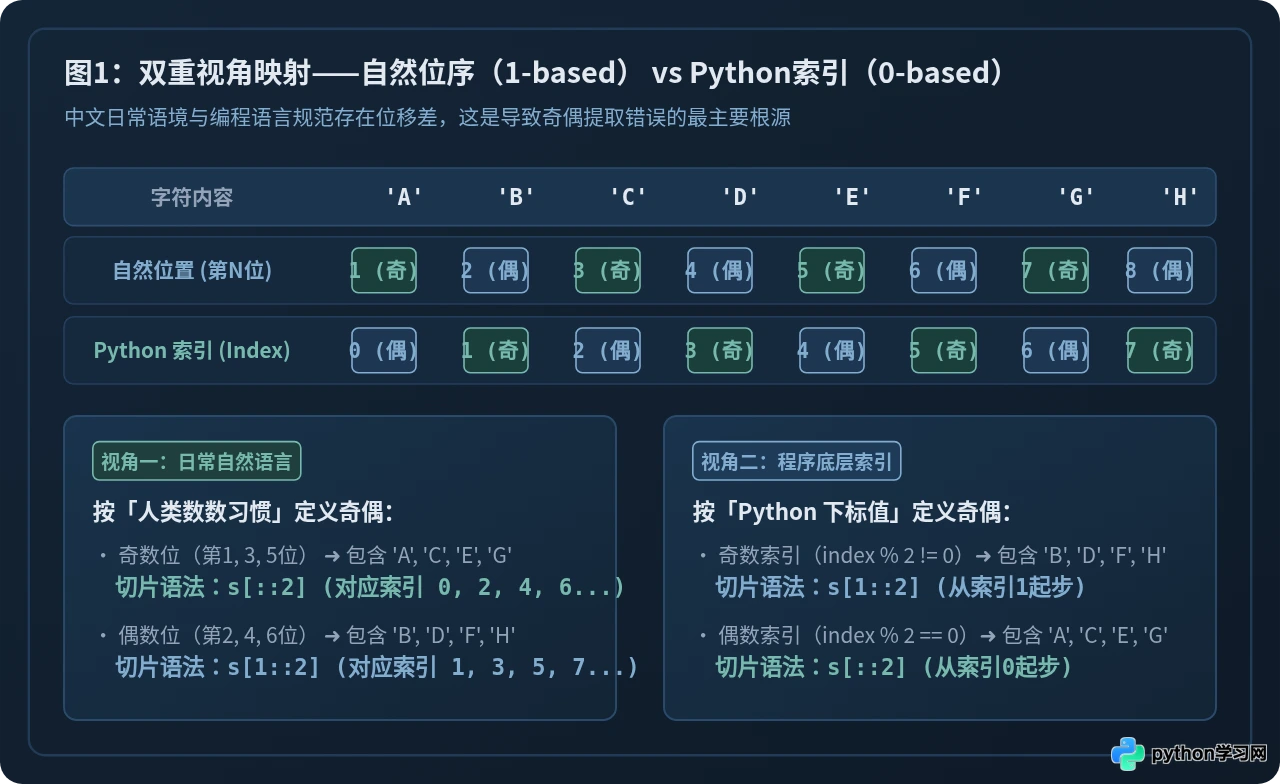
由此可见:
| 业务需求语义 | 对应提取的字符(以 "ABCDEFGH" 为例) | 对应的 Python 索引下标 | 推荐切片语法 |
|---|---|---|---|
| 自然奇数位(第 1, 3, 5, 7 位) | 'A', 'C', 'E', 'G' | 0, 2, 4, 6 | s[::2] 或 s[0::2] |
| 自然偶数位(第 2, 4, 6, 8 位) | 'B', 'D', 'F', 'H' | 1, 3, 5, 7 | s[1::2] |
| 偶数索引位(Index 为 0, 2, 4...) | 'A', 'C', 'E', 'G' | 0, 2, 4, 6 | s[::2] |
| 奇数索引位(Index 为 1, 3, 5...) | 'B', 'D', 'F', 'H' | 1, 3, 5, 7 | s[1::2] |
二、切片语法基础:s[start:stop:step] 是如何跳步执行的?
Python 字符串切片的完整形式为 string[start:stop:step],它包含三个冒号隔开的可选参数:
start(起始索引):切片开始取值的下标位置。若未指定且步长为正数,则默认从头部0开始;若步长为负数,则默认从尾部-1开始。stop(结束索引):切片终止的位置(遵循左闭右开区间规则,即取到stop - 1为止)。若留空,则默认一直截取到字符串的终点边界。step(步长):每次提取字符后,指针向前(或向后)递增的步数。默认值为1。
当我们将 step 赋值为 2 时,Python 内部的截取机制会发生变化:指针每次移动 2 个字符位置,从而精准略过相邻的字符。
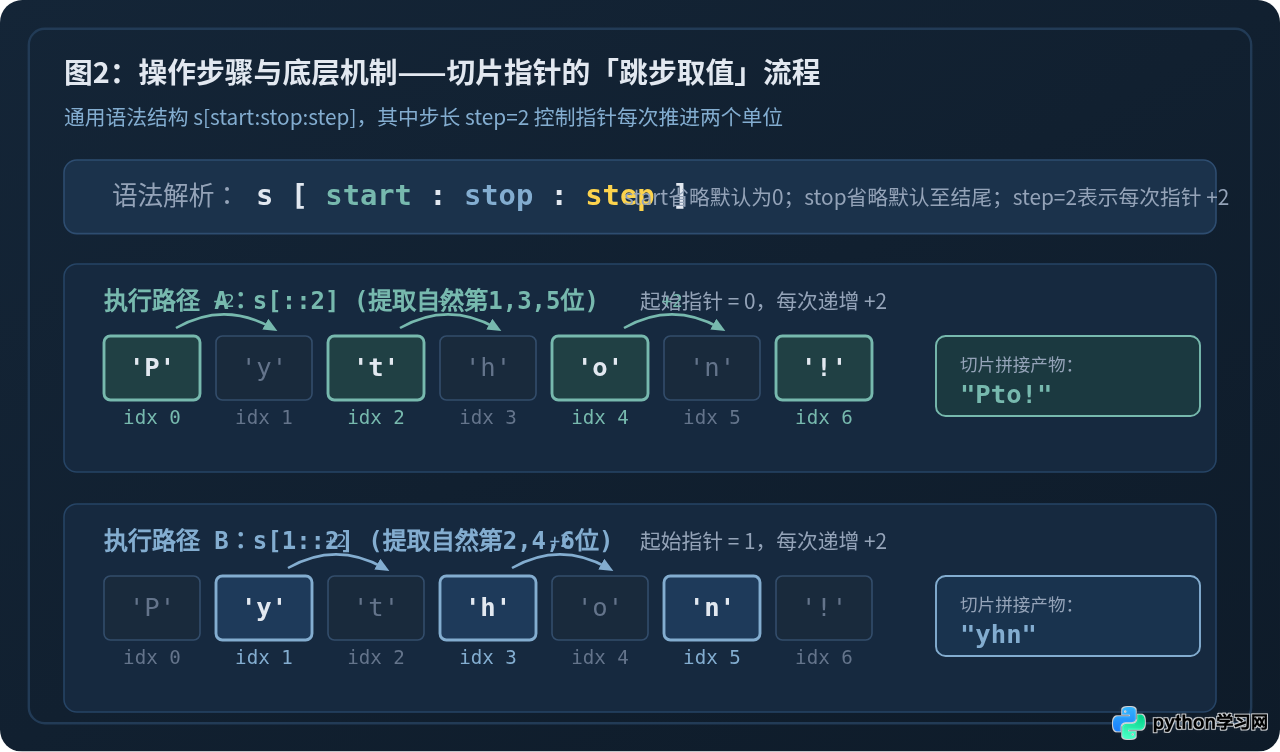
如上图所示:
- 在执行
s[::2]时,起始点省略代表从索引0启动,指针取走第 0 位的字符后,跳步计算0 + 2 = 2,接着取走第 2 位字符,再跳步2 + 2 = 4……最终把所有偶数索引(即自然序数第 1, 3, 5 位)组合成新的子字符串。 - 在执行
s[1::2]时,起始点显式声明为1,指针取走第 1 位字符后跳步至3,随后跳步至5……最终把所有奇数索引(即自然序数第 2, 4, 6 位)拼接输出。
三、实操演练:具体代码示例与应用场景
下面我们通过四个具体且完整的 Python 代码示例,展示不同业务场景下的具体写法与输出结果。
示例 1:提取自然奇数位字符(第 1, 3, 5... 位)
假设我们接收到一条混编的物料编码 text = "A1B2C3D4E5",需要将其中的英文字母(位于自然位置第 1、3、5、7、9 位)完整提取出来:
# 准备测试字符串
text = "A1B2C3D4E5"

# 从索引 0 开始,步长设为 2,提取自然奇数位
odd_positions = text[::2]

print("提取结果:", odd_positions)
# 示例输出:
# 提取结果: ABCDE
示例 2:提取自然偶数位字符(第 2, 4, 6... 位)
继续沿用上面的字符串,若我们需要提取其中的数字编号(位于自然位置第 2、4、6、8、10 位):
# 准备测试字符串
text = "A1B2C3D4E5"

# 从索引 1 开始,步长设为 2,提取自然偶数位
even_positions = text[1::2]

print("提取结果:", even_positions)
# 示例输出:
# 提取结果: 12345
示例 3:限定区间提取奇偶位字符
在某些报文协议中,头部和尾部可能带有固定的标志位(如帧头和校验码),我们仅希望在指定区间(例如索引 2 到索引 8 之间)进行奇偶字符提取,此时可以显式传入 stop 参数:
raw_data = "HDR_X1Y2Z3W4_END"

# 仅在下标 [4, 12) 区间内提取偶数位字符
# start=4, stop=12, step=2
sliced_sub = raw_data[4:12:2]

print("区间提取结果:", sliced_sub)
# 示例输出:
# 区间提取结果: XYZW
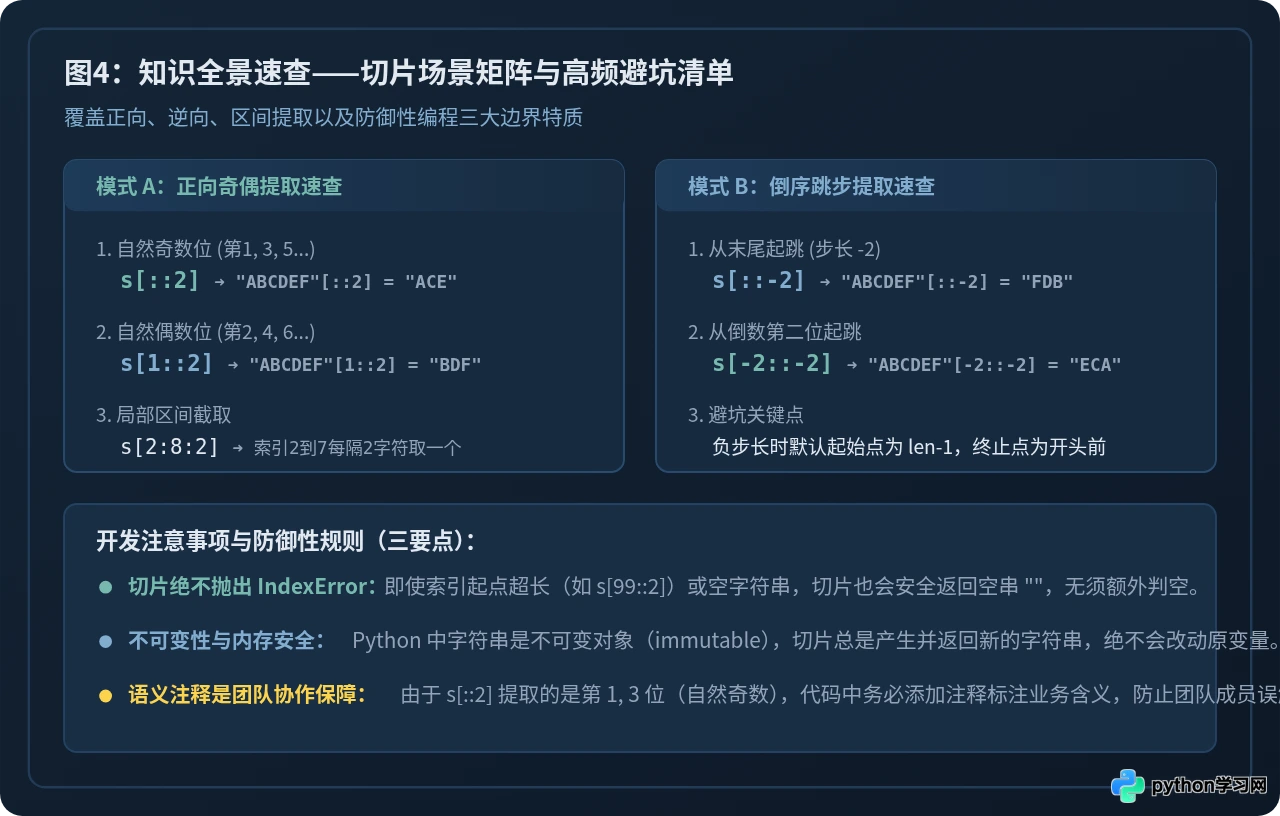
示例 4:倒序跳步提取(结合负数步长)
如果业务不仅要求隔位提取,还要求结果按相反顺序逆向输出,可以直接将步长改为负数 -2:
word = "ABCDEF"

# 从字符串最末尾开始倒序跳步提取(索引 5, 3, 1)
rev_a = word[::-2]
print("从末尾倒序跳步:", rev_a)
# 示例输出:
# 从末尾倒序跳步: FDB

# 从倒数第2个字符开始倒序跳步(索引 4, 2, 0)
rev_b = word[-2::-2]
print("从倒数第二位倒序跳步:", rev_b)
# 示例输出:
# 从倒数第二位倒序跳步: ECA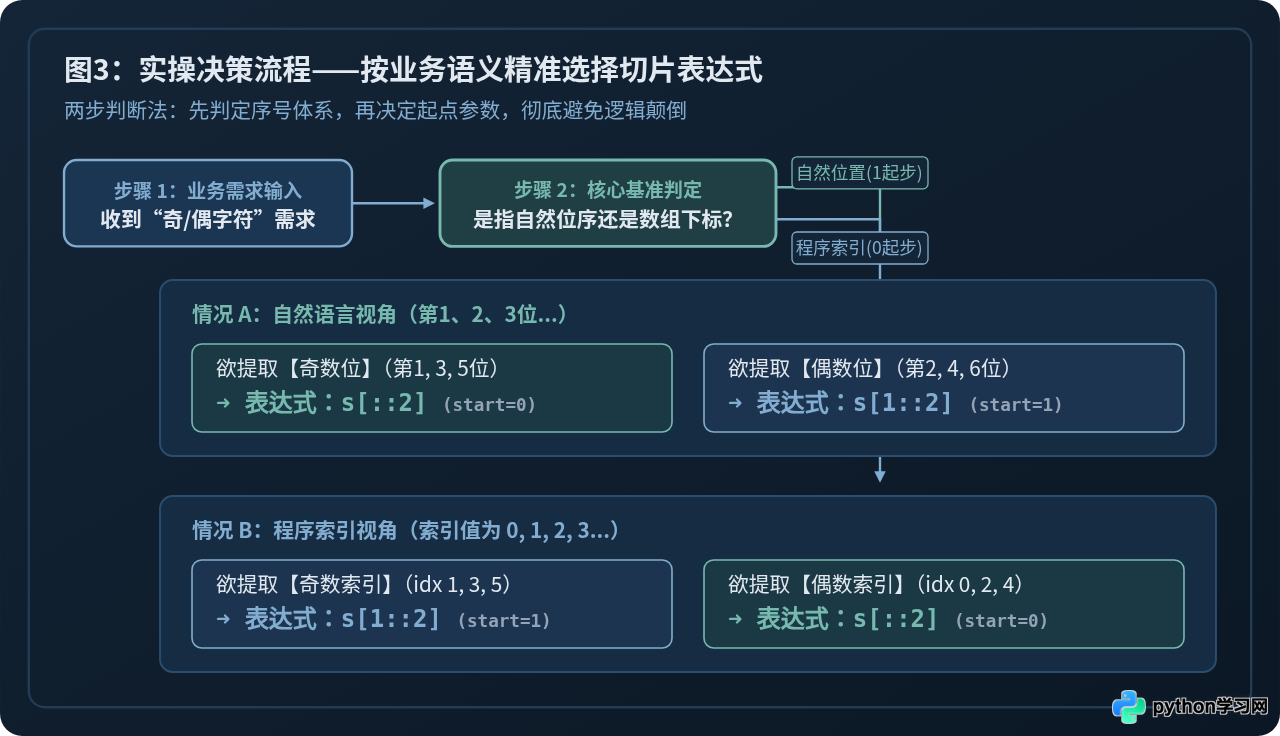
四、开发中必须注意的高频细节与避坑指南
尽管 Python 切片语法简洁明了,但在工业级代码编写中,仍有几个关键特性需要特别注意:
1. 切片天然具备越界容错性(IndexError 免疫)
在 Python 中,通过单下标直接访问字符时,如果索引超出字符串长度会抛出 IndexError: string index out of range 异常;但切片操作永远不会因为索引超出范围而报错。如果 start 超过了字符串的最大有效索引,或者针对空字符串进行切片,Python 会安全地返回一个空字符串 "":
empty_str = ""
print(repr(empty_str[::2]))   # 安全输出: ''

short_str = "A"
print(repr(short_str[1::2])) # 安全输出: ''(不会抛出越界异常)s[1::2] 无须预先使用 if len(s) > 1 进行判空保护,切片自带防越界保护。
2. 字符串的不可变性(Immutability)
在 Python 中,字符串属于不可变对象。切片表达式 s[::2] 并不会改变原变量 s 本身的内容,而是会开辟内存构建一个包含提取字符的全新字符串对象。如果后续需要复用提取结果,请务必使用新变量承接返回值。
3. 团队协作中的可读性建议
对于经验丰富的 Python 工程师来说,s[::2] 与 s[1::2] 是公认的标准惯用法(idiomatic Python);但对于初学阶段或刚从其他非 0 索引语言(如 R、MATLAB、Lua)转来的工程师,s[::2] 到底取的是“奇数”还是“偶数”极易产生理解歧义。
五、全篇总结
回顾本文的核心内容,使用 Python 切片提取字符串奇偶位字符的关键总结如下:
- 核心机制:切片的第三个参数
step控制跳步间隔,将其设置为2是实现隔位提取的核心。 - 日常奇数位(第1, 3, 5...位):对应 Python 索引
0, 2, 4...,使用s[::2]快速提取。 - 日常偶数位(第2, 4, 6...位):对应 Python 索引
1, 3, 5...,使用s[1::2]快速提取。 - 健壮性优势:切片在处理空串或边界超长时会自动收敛截断,具备天然的异常安全性。
掌握这一简洁的语法模式,不仅能写出地道优美的 Pythonic 代码,也能在日常文本解析、日志清洗及密码学初步处理中大幅提升开发效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















