


通义千问网页版对话数据是否会被用于训练
深入解答通义千问网页版对话数据是否会被用于模型训练。分析官方服务协议、脱敏处理流程、网页端停用训练授权的详细操作步骤及多场景下的数据安全建议。
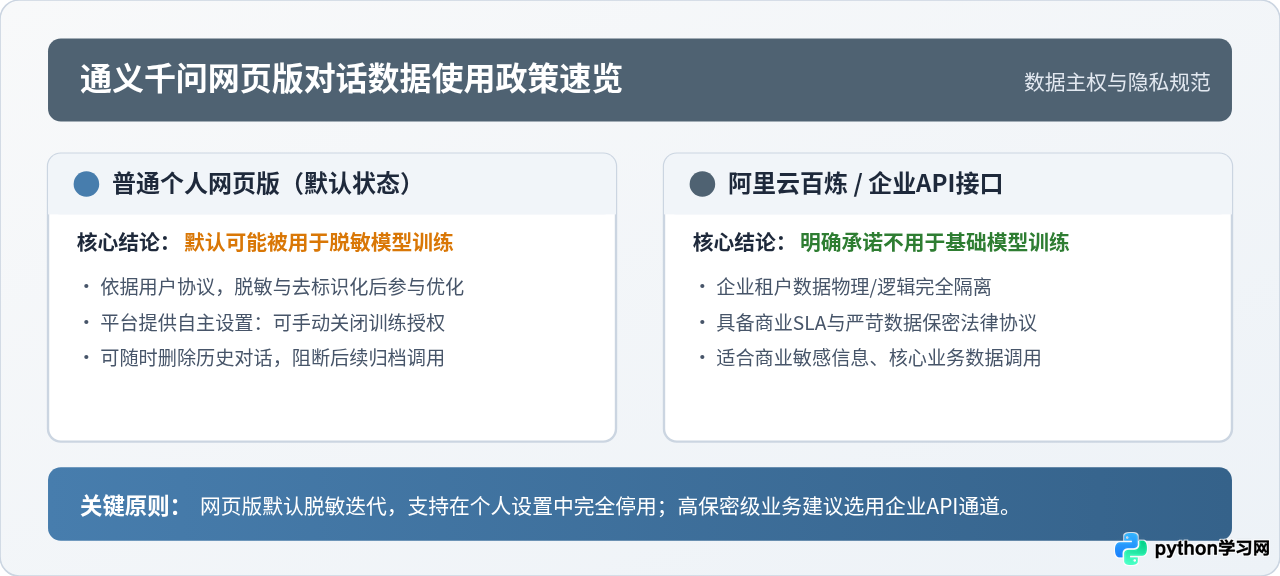
官方协议约定与默认规则:对话数据的使用边界
在注册并登录通义千问网页版(qianwen.aliyun.com)时,用户所签署的《服务协议》与《个人信息保护政策》中,对交互数据的处理方式做出了明确说明。作为面向大众的生成式人工智能产品,平台收集的对话数据主要分为两类:一是用户输入的提示词(包括文字、上传的图片与文档),二是用户对模型回答所作出的反馈(例如点击“赞”、“踩”或重新生成)。
根据现行规范,默认情况下,这些数据会被纳入平台的服务质量监控与技术演进流程。研发团队通过分析实际问答场景中的语义偏差、错答案例以及用户的高频需求,提炼训练语料并开展强化学习对齐。需要明确的是,这种训练并非直接将用户的原话机械记忆,而是通过算法提取语言模式与推理范式。
数据流转与脱敏原理:进入训练池的技术链路
许多读者最关心的问题是:如果数据被用于训练,个人隐私是否会暴露给其他用户?从技术架构上看,网页端的每一次交互到最终可能进入训练集,中间存在严格的自动化工程防护链路。
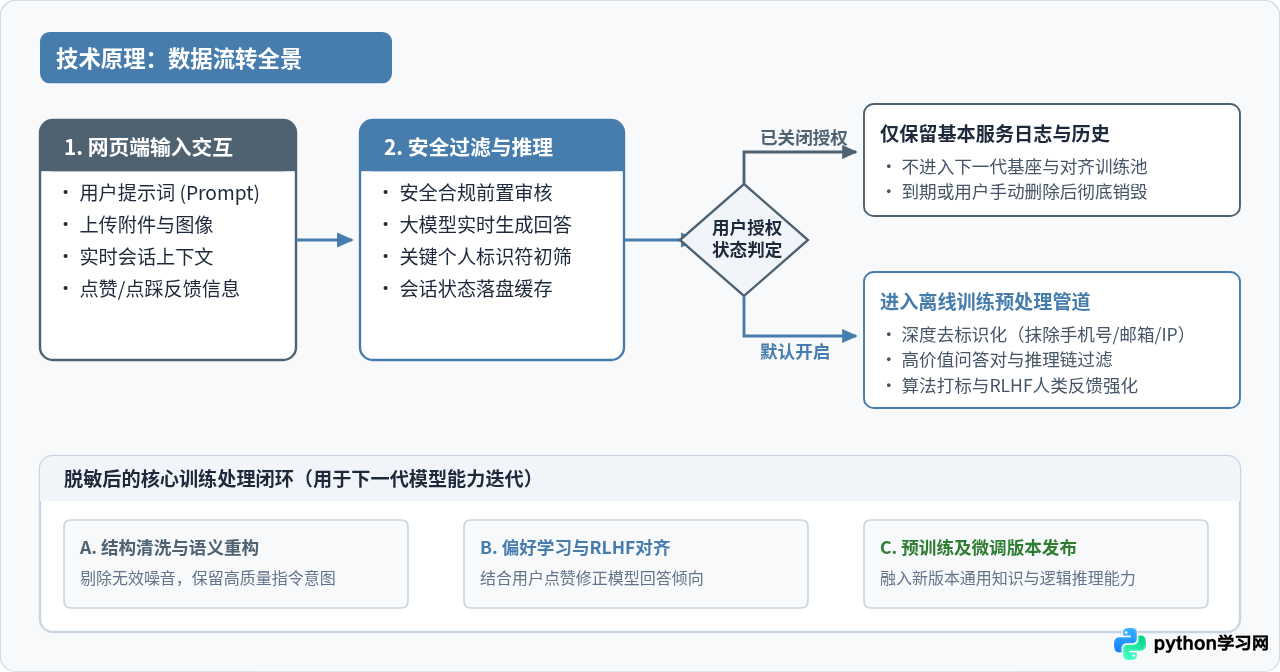
整个数据处理流程主要包含以下四个阶段:
- 实时交互与安全风控: 当你在网页端对话框发送内容时,请求首先经由 API 安全网关进行实时违规词与恶意代码检测,随后调用底座模型完成推理并将答案回传至浏览器。
- 标识符过滤(PII 脱敏): 落盘存储的对话数据会与用户账号(如手机号、阿里云 UID、登录 IP)在逻辑上进行剥离,并通过敏感信息识别引擎自动隐匿电话号码、身份证号、银行卡号及邮箱等个人可识别信息。
- 授权状态判定分流: 系统在进行离线数据归档时,会检索用户的隐私授权标记。若用户已关闭“模型改进计划”,该批次数据仅保留为用户本人的历史查看记录与法定合规留存日志,不会进入下一代预训练和微调语料库。
- 强化学习与模型迭代: 对于保留授权的高价值问答对,数据工程团队会进一步剔除乱码、重构指令结构,并结合用户点赞点踩反馈,用于人类反馈强化学习(RLHF)及指令微调(SFT)。
关闭数据训练授权:网页版具体操作步骤
如果你希望继续使用通义千问网页版的各项辅助功能,但明确不希望自己的任何对话记录被用于后续模型优化,可以在网页端按照以下路径关闭数据共享。
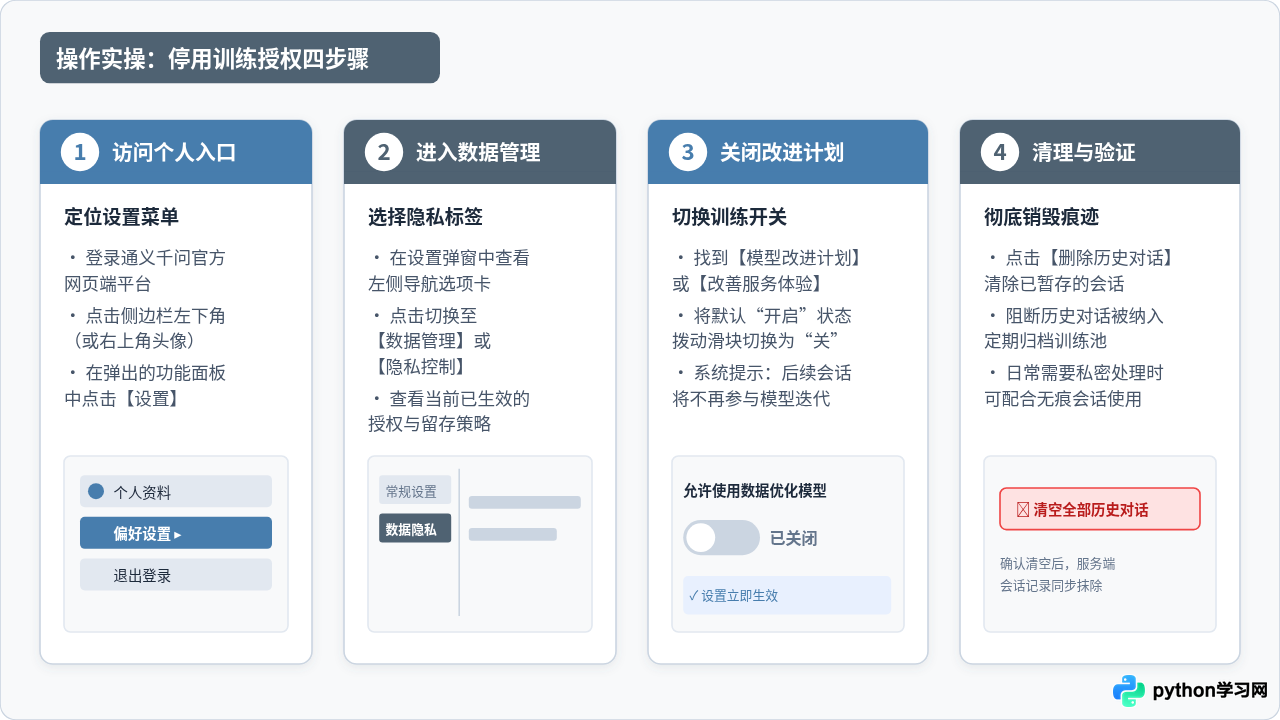
步骤 1:打开个人功能抽屉
在浏览器中访问通义千问网页版主页并完成登录。在左侧会话历史栏的底部(部分界面布局位于右上角),点击个人用户头像或昵称,在展开的浮层中选择设置选项。
步骤 2:切换至数据与隐私管理
在弹出的系统设置浮层中,找到左侧的导航标签,点击进入数据管理或隐私设置页面。在该页面中,你可以看到当前账号所关联的数据存储周期与功能开关。
步骤 3:关闭“模型服务改进计划”
在列表中定位名为允许使用我的对话数据改善模型体验或模型改进计划的选项。默认情况下该选项呈开启(高亮)状态,将其拨动切换为关闭状态。切换后系统会即时更新用户画像标记,后续产生的新会话将直接退出算法迭代池。
步骤 4:清空历史会话记录(可选但推荐)
关闭训练开关仅对后续交互及未清洗数据生效。若此前输入过较为敏感的上下文,建议在设置中点击清空全部历史对话,或在左侧列表逐条删除对应会话,服务端数据库将在同步周期内清除对应的缓存记录。
个人版与企业版区别:不同环境下的隐私保障矩阵
很多企业员工或团队开发者常在工作中直接粘贴业务数据到通义千问网页版,这是存在合规风险的。通用网页版与阿里云百炼平台(Model Studio)的企业 API 在数据处理权限上有着本质区别。
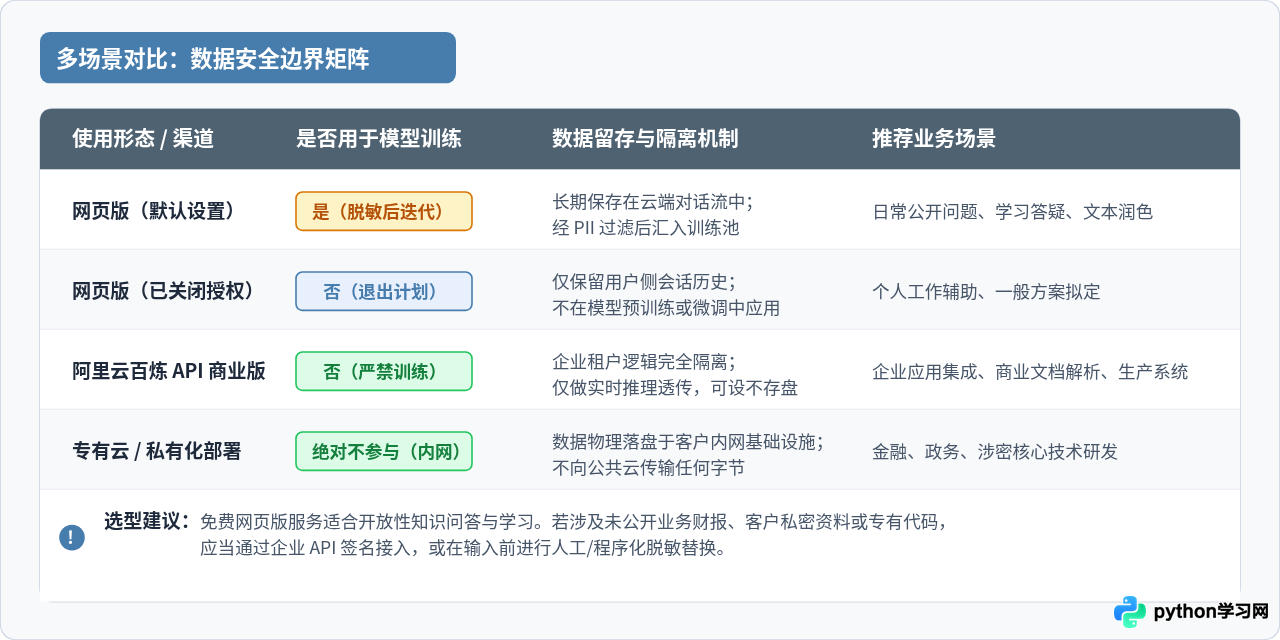
通过上图的对比矩阵可以看出:
- 免费个人网页版:定位于大众辅助工具,主要依托广泛的用户交互反馈来实现模型的敏捷演进。其免费使用的商业逻辑包含了一定程度的数据反哺生态,虽然提供退出选项,但默认偏向于算法优化。
- 阿里云百炼商业 API:面向企业和开发者提供付费模型调用服务。阿里云官方遵循企业级云计算合规标准(包括 ISO 27001、等保三级等),明确在服务等级协议(SLA)中承诺:客户通过 API 传输的 Prompt 与生成结果均属于客户资产,绝不用于公模训练,租户之间具备严格的沙箱逻辑隔离。
- 专属大模型与私有化部署:针对金融机构、政府部门及涉密科研单位,通义千问支持输出专有云或本地一体机。模型权重与运行环境完全位于客户自身的内网物理防火墙内,从物理层面阻断一切向外回传的可能性。
日常使用安全指引:输入前的自查决策
了解了平台的训练策略与设置方法后,读者在日常工作与学习中可以通过一套标准化的决策流程,确保数据安全万无一失。
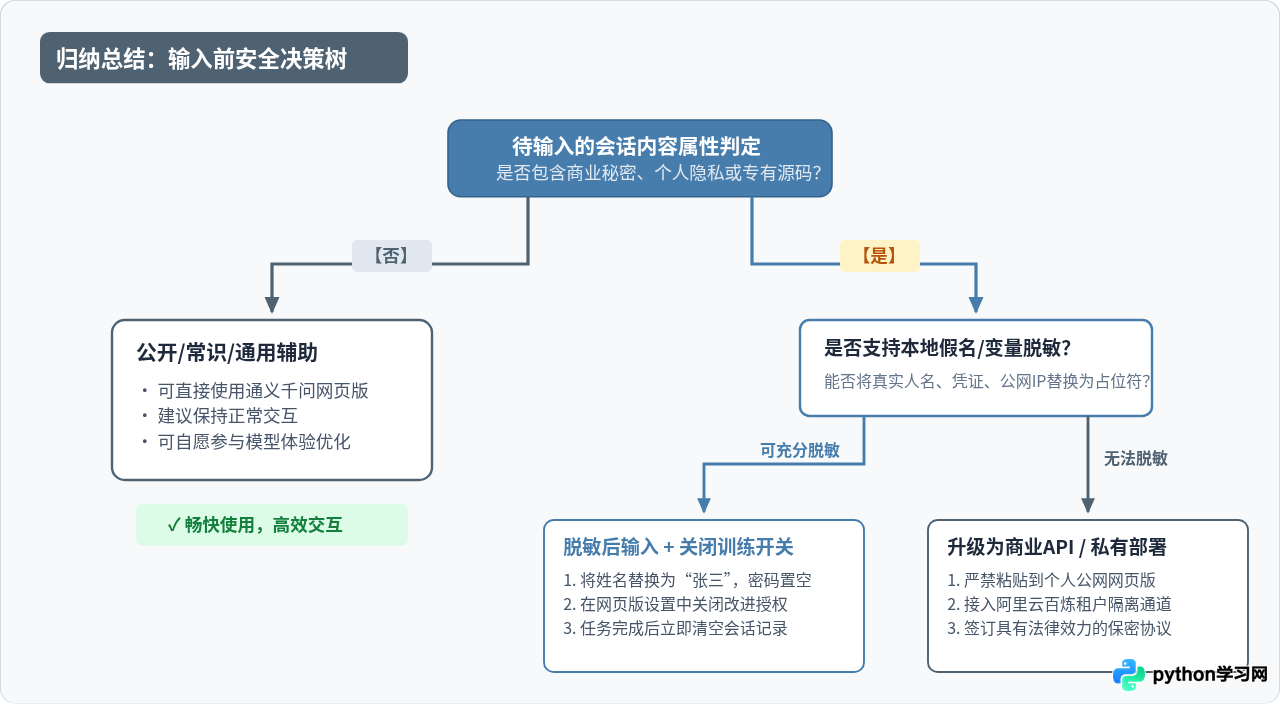
在实际操作中,建议读者遵守以下五条切实可行的使用准则:
- 通用任务放心使用: 对于日常语言翻译、语法检查、公开文献总结、常规编程语法咨询等不含私密属性的任务,可放心在网页版中处理。
-
敏感标识本地替换:
如果需要借助通义千问分析业务方案或调试代码,应在粘贴前进行人工“假名化”处理。例如将真实的客户姓名替换为“某客户A”,将服务器公网真实 IP 替换为
192.168.1.X,删除数据库账号密码与公私钥。 - 确认账号隐私开关已关闭: 定期在个人设置中检查“模型改进计划”是否处于关闭状态,防止平台版本更新重置偏好。
- 杜绝核心机密输入公网网页端: 严禁将未公开的财报底稿、核心算法专利明文、用户核心个人信息(PII)直接提交给任何公网网页端大模型。
- 涉密与商用需求选用 API 渠道: 企业若需搭建知识库或开展批量文本处理,应统一采购阿里云百炼 API 或部署开源端侧模型,通过技术手段与合同条款确保商业资产安全。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















