


通义千问API怎么接入:Python调用示例、Key申请与计费说明

在应用开发中引入大语言模型,往往意味着要在“黑盒体验”与“可控集成”之间做取舍。直接调用网页版聊天界面虽然零门槛,但无法嵌入业务逻辑;而自行部署开源模型又面临算力成本与维护复杂度的双重压力。对于大多数希望快速赋予应用对话、推理或内容生成能力的开发者而言,调用成熟的云端API是性价比最高的路径。
通义千问作为阿里云推出的主力大模型,其API接入流程已经高度标准化,但初次接触时仍容易在鉴权方式、参数配置和计费理解上产生困惑。本篇不罗列枯燥的参数表,而是从实际开发场景出发,梳理从获取密钥到代码落地的完整链路,明确每一步的操作意义与边界。
钥匙与门槛:在阿里云百炼获取API Key
接入任何云服务的第一步都是身份鉴权。通义千问的API服务依托于“阿里云百炼”平台,这与传统的阿里云ECS或RDS控制台略有不同,是一个专门针对大模型应用开发的聚合平台。
登录阿里云百炼控制台后,需要在左侧导航栏找到“API-KEY管理”模块。这里需要注意,创建Key时系统通常会提示设置有效期或绑定特定项目,建议为测试环境和生产环境分别创建不同的Key,以便后续进行权限隔离和安全审计。复制生成的Key时,务必妥善保存,因为出于安全考虑,平台通常不会再次显示完整的密钥字符串。
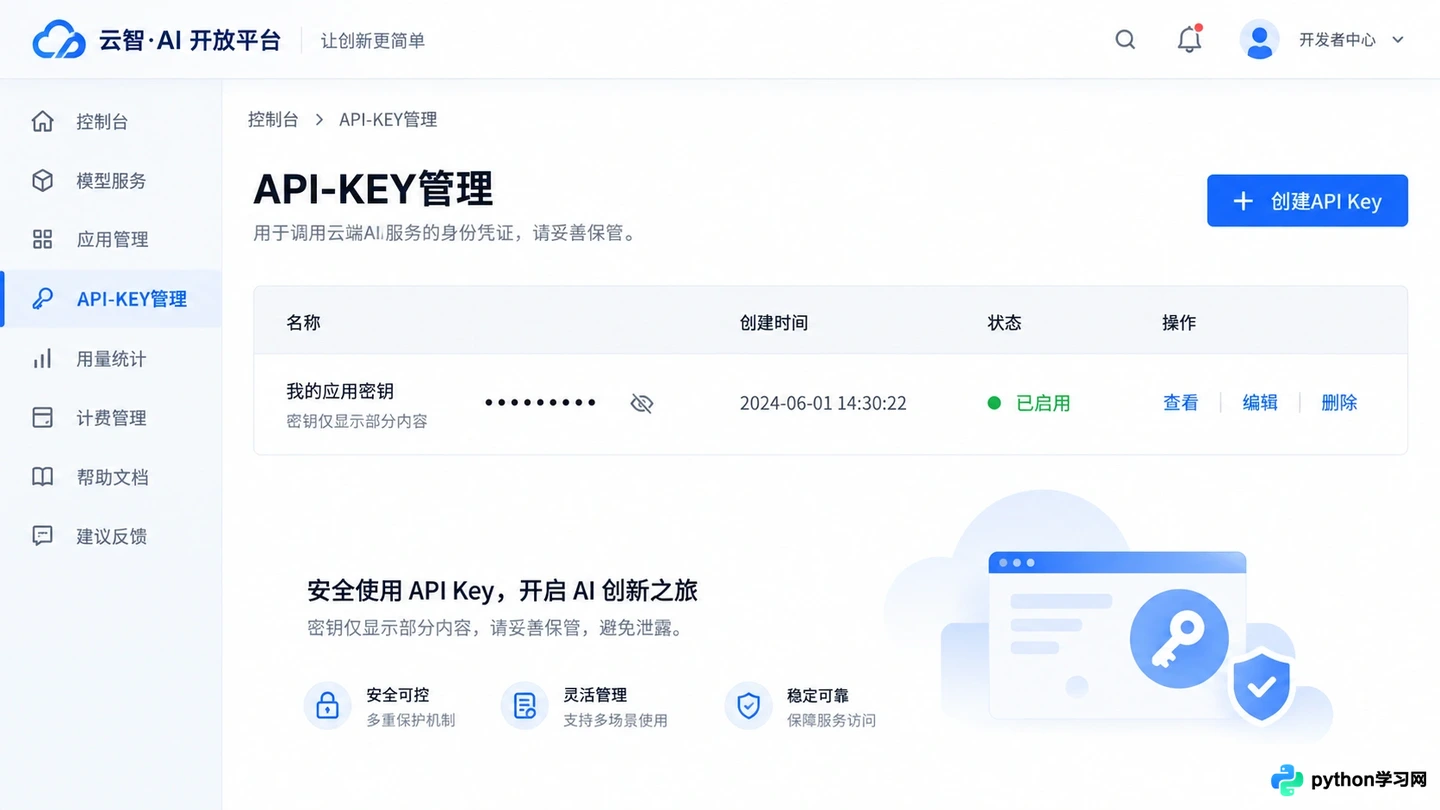
阿里云百炼控制台API Key创建与管理界面示意
获得Key只是第一步,真正的“门槛”在于开通服务。在百炼平台的“模型广场”或“我的应用”中,需要确认已开通通义千问相关模型(如qwen-turbo、qwen-plus等)的服务权限。部分新注册用户可能享有免费额度,但这通常需要手动领取或在首次调用时触发开通流程。如果跳过这一步直接运行代码,往往会收到“ServiceUnavailable”或“PermissionDenied”的错误提示,而非简单的鉴权失败。
环境搭建:Python SDK的正确安装姿势
虽然通过HTTP请求直接调用RESTful API是通用做法,但对于Python开发者,使用官方提供的SDK能大幅减少构造请求头、处理签名和解析响应的重复工作。阿里云提供了dashscope库,这是接入通义千问的标准客户端。
在虚拟环境中执行安装命令:
pip install dashscope
安装完成后,关键的一步是配置环境变量。硬编码API Key在代码中是严重的安全隐患,尤其是在将代码提交至GitHub等公共仓库时。推荐的做法是在操作系统的环境变量中设置DASHSCOPE_API_KEY,或者在项目根目录创建.env文件并通过python-dotenv库加载。
import os
from dotenv import load_dotenv

load_dotenv()
# 确保环境变量已正确加载
api_key = os.getenv("DASHSCOPE_API_KEY")
if not api_key:
    raise ValueError("未找到DASHSCOPE_API_KEY环境变量")
这种配置方式不仅安全,还便于在不同部署环境(如本地开发、测试服务器、生产容器)间无缝切换配置,无需修改代码逻辑。
核心交互:从单次对话到流式输出
在实际业务中,对话接口是最基础也最常用的功能。通义千问API支持两种主要的响应模式:非流式(一次性返回完整结果)和流式(Server-Sent Events,逐字返回)。
非流式调用适合对延迟不敏感、需要完整文本进行后续处理的场景,如文章摘要生成或数据提取。代码结构简洁,等待模型生成完毕后一次性返回对象。
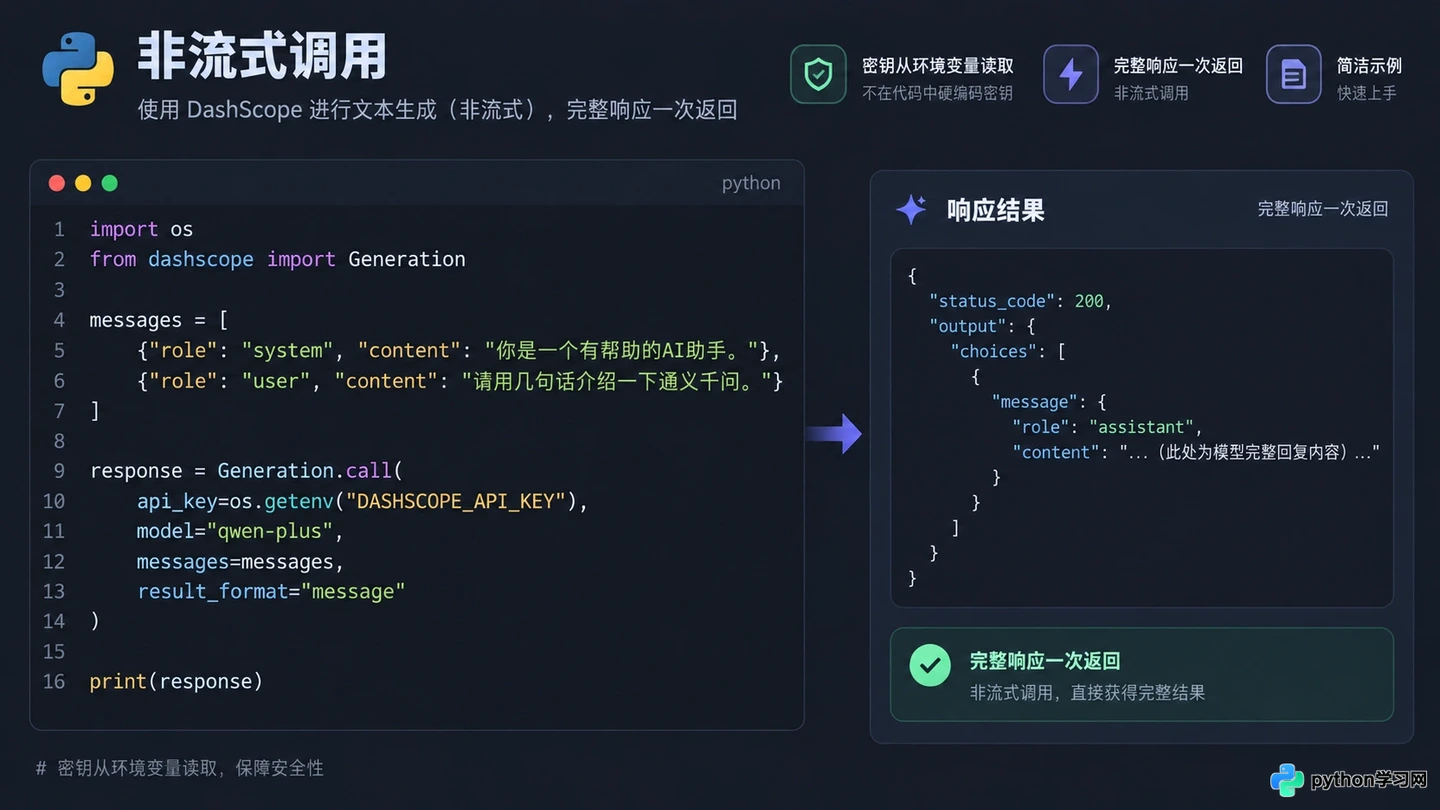
Python代码中调用通义千问非流式接口的示例
然而,在聊天机器人或实时辅助写作场景中,用户更希望看到“打字机”效果,即模型思考的同时前端逐步展示内容。这时必须启用流式输出。在dashscope SDK中,只需将incremental_output参数设置为True,并使用迭代器处理响应。
import dashscope
from dashscope.api_entities.dashscope_response import Role

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

def stream_chat(prompt):
    messages = [
        {'role': Role.SYSTEM, 'content': '你是一个有用的助手。'},
        {'role': Role.USER, 'content': prompt}
    ]

    response = dashscope.Generation.call(
        model='qwen-turbo',
        messages=messages,
        result_format='message',
        stream=True, # 开启流式输出
        incremental_output=True # 增量输出
    )

    full_content = ""
    for chunk in response:
        if chunk.status_code == 200:
            content = chunk.output.choices[0].message.content
            print(content, end='', flush=True) # 实时打印
            full_content += content
        else:
            print(f"Error: {chunk.code} - {chunk.message}")
            break
    return full_content

stream_chat("请写一首关于春天的短诗")
这段代码展示了如何处理流式数据块。需要注意的是,流式返回的每个chunk只包含新增的内容片段,因此需要开发者在前端或后端自行拼接完整字符串。如果忽略incremental_output=True,可能会遇到重复累积内容的bug。
成本与控制:理解计费模式与Token限制
接入API不仅是技术问题,更是成本问题。通义千问的计费主要基于Token数量,分为输入Token(Prompt)和输出Token(Completion)。不同模型版本(如Turbo、Plus、Max)的单价差异显著,通常性能越强的模型,单位Token价格越高。
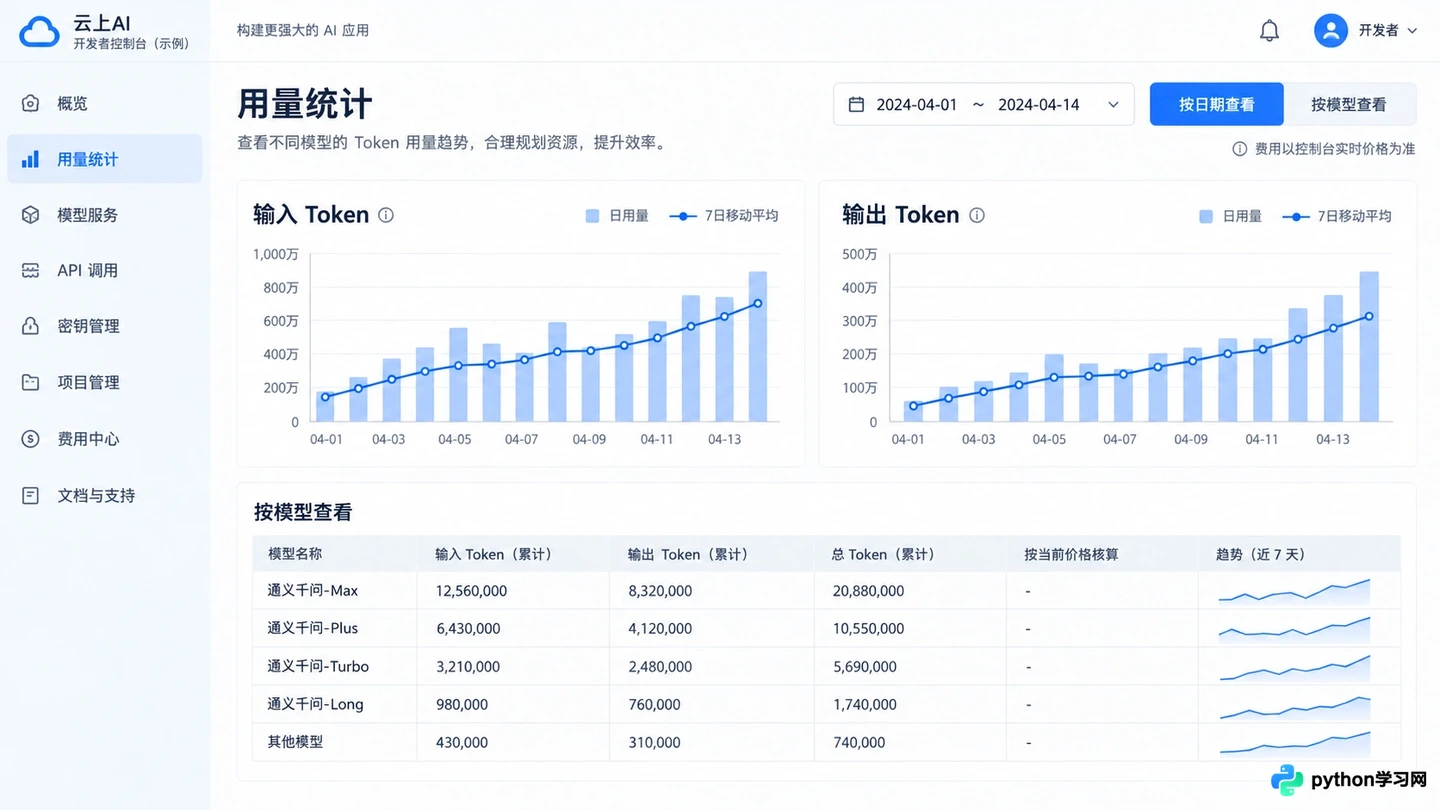
阿里云百炼平台的Token用量统计与计费详情页面
在开发阶段,容易忽视的是上下文长度带来的隐性成本。每次调用API时,如果需要保留历史对话记录,必须将之前的消息列表一并发送给模型。这意味着随着对话轮数增加,输入Token的数量会线性增长,甚至指数级膨胀(如果包含长文档引用)。
为了控制成本,建议在应用层实现上下文窗口管理。例如,只保留最近的N轮对话,或者对过长的历史消息进行摘要压缩后再传入。此外,合理设置max_tokens参数可以防止模型生成过长且无意义的回复,从而避免意外的高额账单。
阿里云百炼控制台提供了详细的用量查询功能,可以按天、按模型查看Token消耗情况。建议在项目中设置预算报警,当每日消耗超过预设阈值时,通过短信或邮件通知管理员,以便及时调整策略或排查异常调用。
结语:从调用到集成的跨越
通义千问API的接入本身并不复杂,真正的挑战在于如何将这一能力平滑地融入现有业务架构。从安全地管理API Key,到选择合适的响应模式以优化用户体验,再到精细化的成本控制,每一个环节都决定了最终应用的稳定性与经济性。
对于初学者,建议先从qwen-turbo入手,因其性价比高且响应速度快,适合大多数常规任务。随着对模型特性的熟悉,再逐步尝试更复杂的参数调整和高级模型。记住,API只是一个工具,价值在于你如何用它解决具体问题,而不是仅仅展示技术连通性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















