


Python正则命名组怎么实现内容重排
详细讲解在Python中如何使用正则表达式命名捕获组实现字符串内容重排。全面解析\g替换语法与回调函数两种核心方案,提供完整的代码示例、执行步骤和避坑指南。
一、命名捕获组的核心语法与重排原理解析
在处理诸如“年-月-日”调整为“日/月/年”、颠倒英文姓名“姓, 名”为“名 姓”、或者将系统日志的各列字段换序时,传统的正则表达式通常使用普通的括号 () 来创建无名捕获组,并在替换时用 、 引用。一旦正则变长、嵌套加深,或者后续由于需求变更增减了括号,数字编号便会整体偏移,极易引发难以察觉的数据错乱。
为了解决这个问题,Python 在正则表达式中引入了扩展语法 (?P<name>...):
- 语法标记:开头的
?P<表示声明一个具名组,紧随其后的name是开发者自拟的组名,末尾以>闭合名称,紧接着放置该组具体的匹配规则。 - 组名规范:组名必须是合法的 Python 标识符,即由英文字母、数字和下划线组成,且不能以数字开头。
- 反向引用格式:在
re.sub()的替换字符串模板中,必须使用带有尖括号的\g<name>语法。这里的g代表 group,尖括号清晰地标明了组名的起始与边界,避免与后续的普通文字产生歧义。
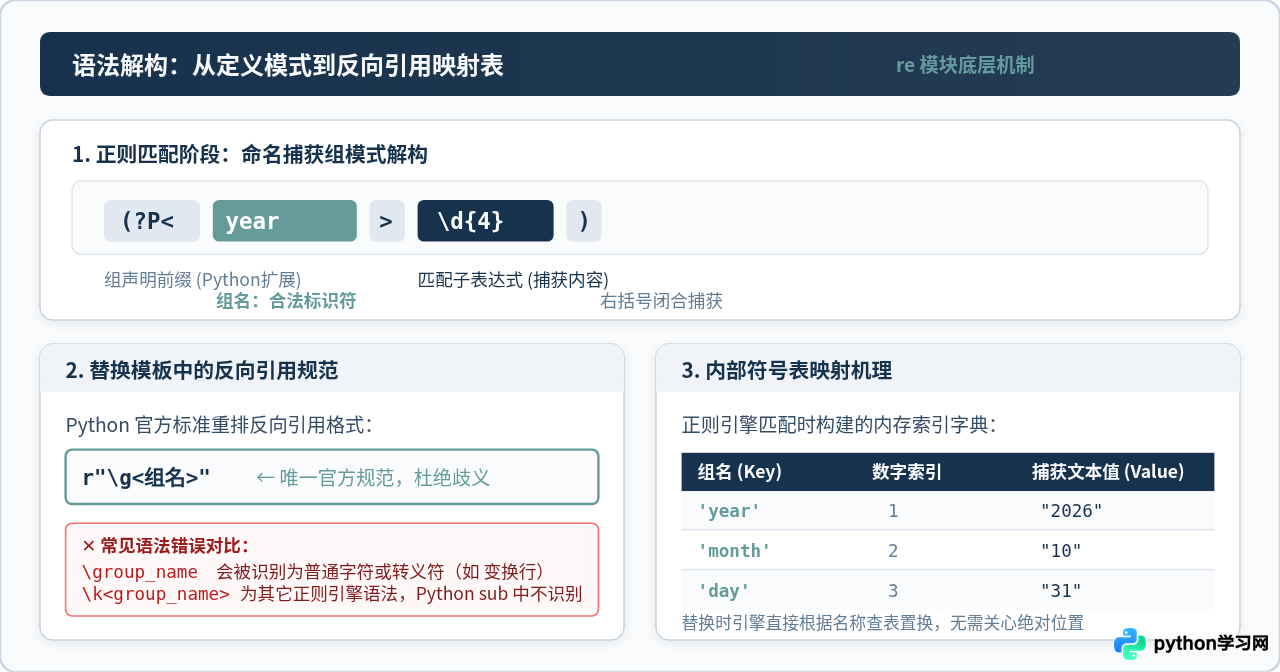
从底层机制来看,当正则引擎在源文本中匹配成功时,Python 内部不仅为每个捕获组维护了按出现顺序自增的数字序号,同时还在哈希表中建立了一份以组名为键、捕获字符串切片为值的符号字典。在替换阶段,引擎遇到 \g<name> 就会直接根据键名提取对应的内容并写入目标输出缓冲区。
二、实现内容重排的标准操作步骤
利用命名组实现内容重排并非简单的函数调用,而是一套严谨的“分析-定义-排版-执行”流程。下面以最典型的美式日期(MM/DD/YYYY)重排为中式标准日期(YYYY年MM月DD日)为例,拆解落地四个关键步骤。
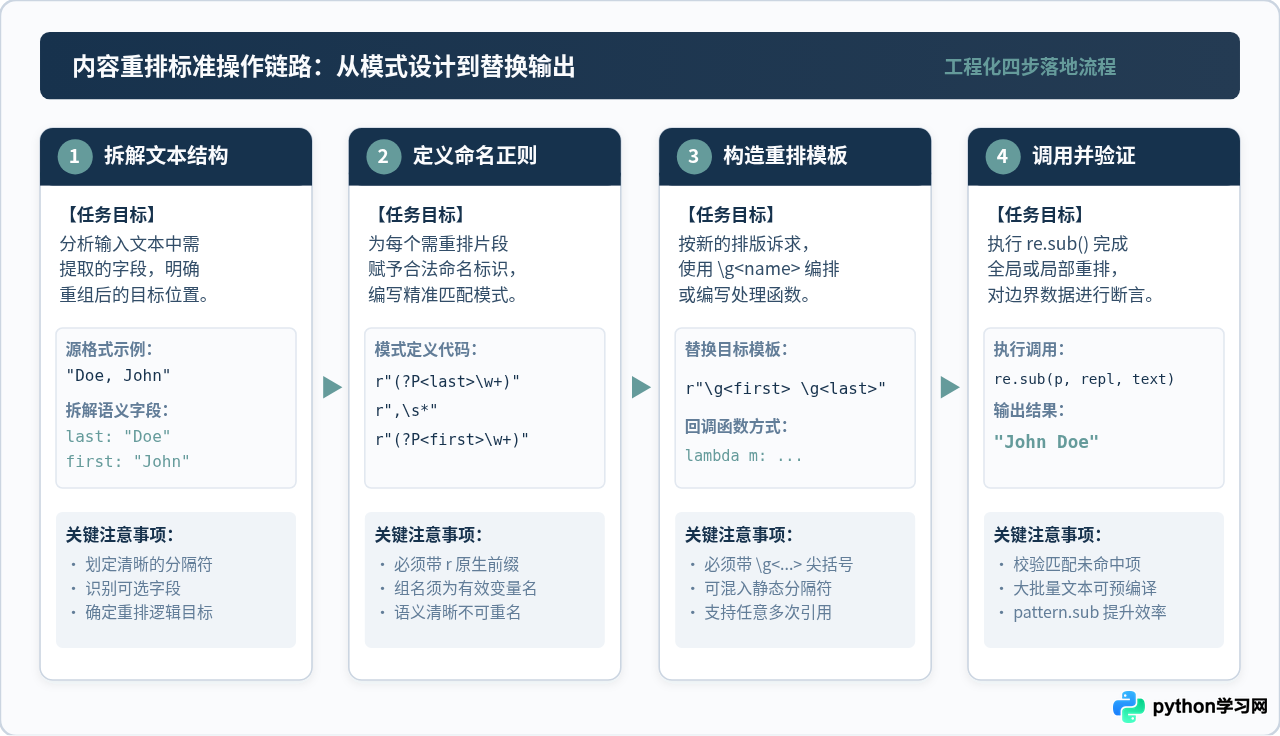
步骤 1:分析原始文本片段与重组目标
假设我们有一组原始数据形如 "10/31/2026",目标是提取出月份、日期与年份三个独立信息元,并最终重组为 "2026年10月31日"。我们明确需要提取的三项数据分别为:month、day 和 year。
步骤 2:编写包含命名捕获组的正则表达式
为每个需要重排的目标片段设计精准的匹配子模式,并包裹在 (?P<组名>...) 中。注意在字符串前添加 r 原始字符串前缀:
import re

# 命名正则模式:分别捕获月、日、年
pattern = r"(?P<month>\d{2})/(?P<day>\d{2})/(?P<year>\d{4})"
步骤 3:构建包含反向引用的目标替换模板
根据最终期望的排版格式,使用 \g<组名> 将需要的组按新次序组织起来,并在组与组之间直接插入任何需要的静态文字或标点:
# 替换模板:按照 year -> month -> day 顺序重排,并嵌入汉字
replacement_template = r"\g<year>年\g<month>月\g<day>日"
步骤 4:调用 re.sub() 并验证替换结果
将模式、替换模板和源字符串传入 re.sub(),完成全量重排:
source_text = "会议定于 10/31/2026 召开,备选日期为 11/05/2026。"

# 执行重排
result = re.sub(pattern, replacement_template, source_text)

print(result)
# 示例输出:会议定于 2026年10月31日 召开,备选日期为 2026年11月05日。
可以看到,无论一行文本中出现一次还是多次符合规则的字符串,re.sub() 都能精准找到对应字段,并依据模板设定的新次序完成重置。
三、两种实现途径:模板字符串 vs 回调函数
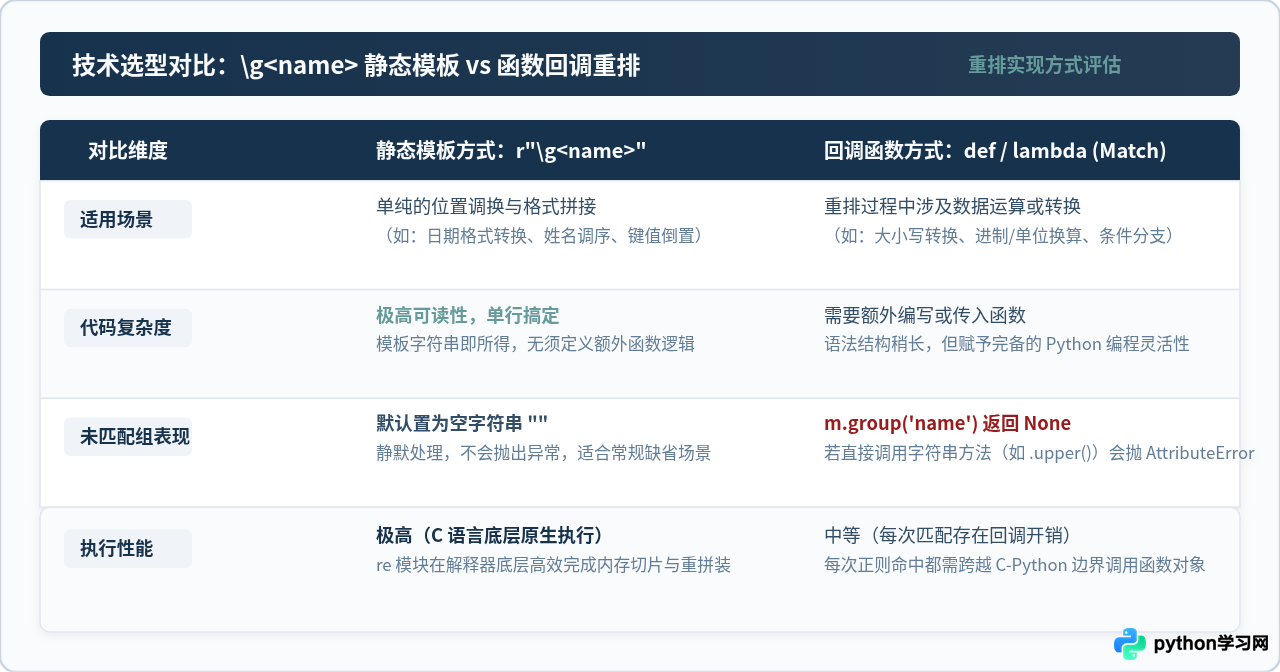
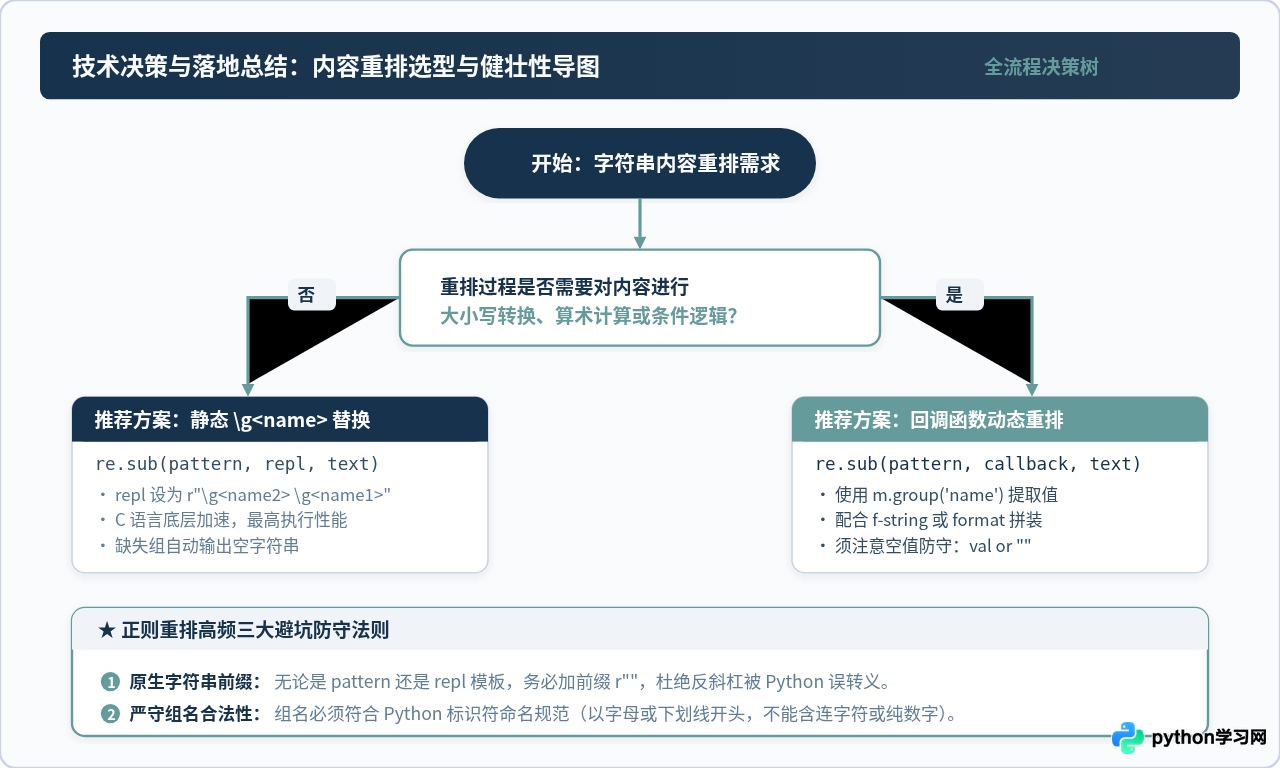
在实际业务开发中,内容重排的需求通常分为两类:一类是纯粹的位置调整与静态文本拼接;另一类则是在重排的同时,要求对捕获的内容做加工计算(如大小写转换、去除多余空格或条件填充)。针对这两种诉求,Python 分别提供了静态模板与函数回调两种机制。
途径 A:使用 \g<name> 模板进行高效静态重排
这是最常见且执行效率最高的方法。整个重排逻辑直接由 C 语言底层在解释器内执行,不涉及 Python 层面的函数堆栈调用。
例如,在整理服务器日志时,原始日志格式为 [时间] [日志级别] 模块: 详细消息,现在需要调整为 级别: [时间] (模块) 详细消息:
import re

log_line = "[2026-10-31 15:30:20] [WARNING] user_service: Database connection timeout."

pattern = r"\[(?P<time>[^\]]+)\] \[(?P<level>[A-Z]+)\] (?P<module>[a-zA-Z_]+): (?P<msg>.*)"
repl = r"\g<level> - [\g<time>] (\g<module>) -> \g<msg>"

rearranged_log = re.sub(pattern, repl, log_line)
print(rearranged_log)
# 示例输出:WARNING - [2026-10-31 15:30:20] (user_service) -> Database connection timeout.
途径 B:传入回调函数实现带逻辑的动态重排
re.sub() 的第二个参数除了可以是字符串外,还可以接收一个回调函数。每次正则匹配成功时,Python 就会把当前的 re.Match 对象传递给该函数,函数的返回值将作为重排后的替换内容。
在回调函数内部,我们既可以通过 match.group('组名') 单独读取某个命名组,也可以通过 match.groupdict() 获取包含所有命名组的字典,再结合 Python 的 f-string 完成重排:
import re

text = "姓名记录: doe, john; smith, alice"

pattern = r"(?P<last>[a-zA-Z]+),\s*(?P<first>[a-zA-Z]+)"

def rearrange_and_capitalize(match):
    # 通过组名提取,并执行首字母大写转换
    first_name = match.group('first').capitalize()
    last_name = match.group('last').upper()
    return f"{first_name} {last_name}"

result = re.sub(pattern, rearrange_and_capitalize, text)
print(result)
# 示例输出:姓名记录: John DOE; Alice SMITH
如果只是简单重新组装字典,还可以利用字典解包(Unpacking)技巧写成精简的单行 lambda:
# 使用 groupdict() 配合 format 进行格式化重排
result = re.sub(
    pattern,
    lambda m: "{first} {last}".format(**m.groupdict()),
    text
)
四、高频陷阱与防守注意事项
虽然命名捕获组直观可靠,但在日常编写中,以下几个关键细节如果稍有疏忽,便可能导致代码运行报错或替换结果不符合预期。
在 Python 普通字符串中,\g 不是合法转义字符,但若后面跟特定字母(例如组名叫 n_count,写成 "\g<n_count>"),Python 解释器在某些情况下可能会将
错误解析为换行符。因此,编写 pattern 和 repl 模板时,务必强制添加 r"" 前缀。
其他编程语言(如 Perl 或 PCRE)支持在替换时使用 \k<name> 或 ${name},但在 Python 的 re.sub() 替换字符串中,只认可 \g<name>。若误写为 \k<name>,Python 会将其当作普通字符 k<name> 直接输出。
陷阱 3:可选命名组未匹配时的行为差异
当正则表达式中包含可选的命名捕获组(例如加了 ? 的中间名)时,两种重排方式的表现完全不同:
- 在
\g<name>模板中:如果该命名组在当前匹配中没有捕获到任何内容,Python 会静默将其替换为空字符串"",不会抛出异常。 - 在回调函数中:
match.group('name')会返回None。如果此时直接对返回值调用字符串操作(如match.group('middle').strip()),程序将立即抛出AttributeError: 'NoneType' object has no attribute 'strip'。
# 包含可选中间名的匹配模式
pattern = r"(?P<first>\w+)(?:\s+(?P<middle>\w+))?\s+(?P<last>\w+)"

# 在回调函数中重排时,务必做 None 防守
def safe_rearrange(m):
    middle = m.group('middle') or ""
    middle_part = f" ({middle})" if middle else ""
    return f"{m.group('last')}, {m.group('first')}{middle_part}"
五、总结与选型决策指南
通过 Python 正则命名组实现内容重排,是编写高维护性数据清洗与文本重构脚本的核心技能。为了帮助读者在实际项目中快速做决断并避免失误,可以参考以下决策路径图:
| 重排任务类型 | 推荐实现语法 | 核心优势 | 代表性场景 |
|---|---|---|---|
| 静态字段倒序 / 格式规范化 | re.sub(pattern, r"\g<b> - \g<a>", text) |
代码简短、纯 C 底层执行性能极高、缺失组自动填空 | 日期格式翻转、日志列调序、CSV列位置互换 |
| 内容加工 / 动态计算重排 | re.sub(pattern, lambda m: ..., text) |
具备全功能 Python 编程能力,支持大小写转换、算术计算与分支过滤 | 数据单位转换、文本清洗脱敏、动态拼装复杂结构 |
| 高频重复调用处理 | compiled_p.sub(repl, text) |
预编译正则对象,避免每次调用重复解析表达式 | 处理百万级大文件或高并发实时文本流 |
总体而言,掌握 (?P<name>...) 定义与 \g<name> 反向引用这两大语法核心,就能在大部分文本重排场景中写出优雅、自解释且易于后续扩展的高质量 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















