


Python numpy.random批量生成随机数组代码教程
本篇Python numpy.random批量生成随机数组代码教程,系统讲解现代NumPy生成器架构、多维形状size控制、常用分布采样实战以及新旧API避坑辨析,提供可复现的完整代码与工程规范。
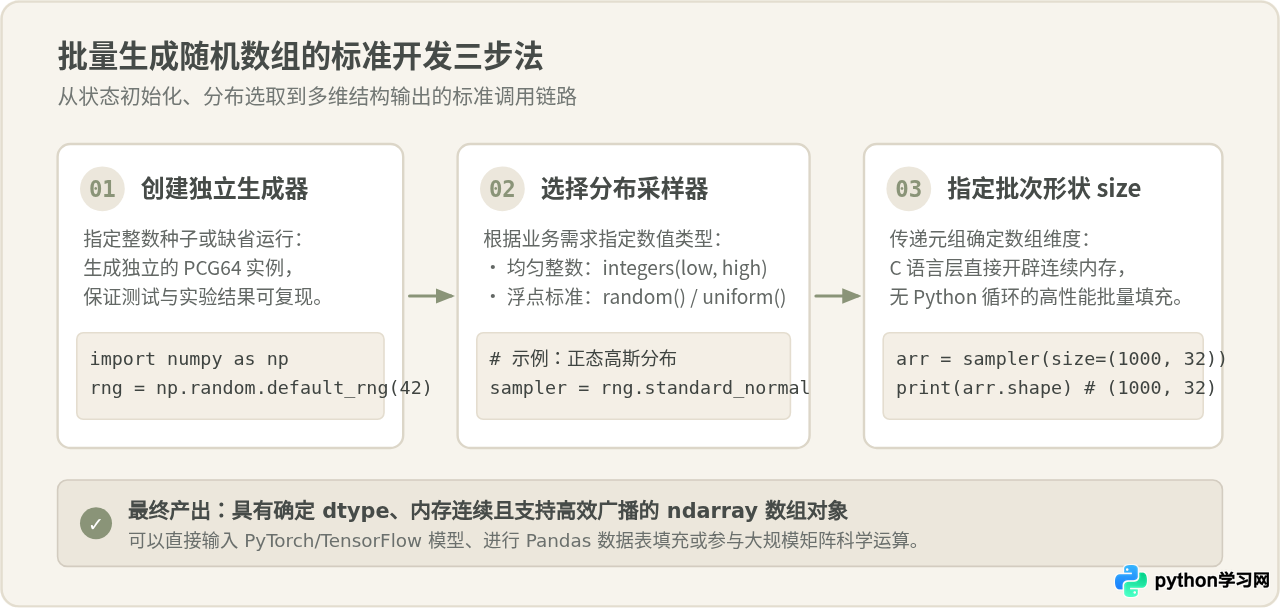
numpy.random.default_rng(seed) 实例化一个独立的现代随机数生成器,随后调用目标分布采样方法,并利用 size 参数一次性在底层开辟连续内存输出所需形状的 NumPy 多维数组。本文将从现代 Generator 运行机制、批量多维形状控制、常见统计分布实战到历史遗留接口的深度避坑进行逐一解析。
一、批量生成随机数组的标准开发流程
很多初学者在需要生成一批随机数时,习惯使用 Python 内置的 random 模块配合列表推导式。当数据规模上升到数万或数百万量级时,列表推导式会产生显著的对象创建开销和解释器循环瓶颈。而 NumPy 通过 C 语言底层内存分配,能够以极高的吞吐率直接产出连续存储的 ndarray。
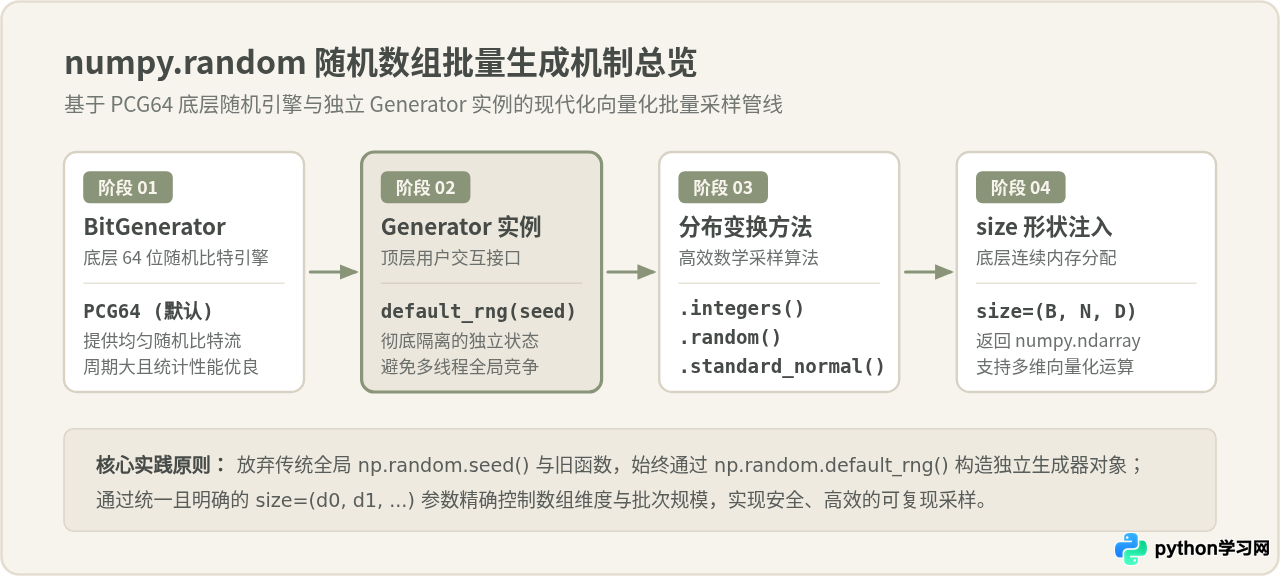
现代 NumPy(1.17 及以上版本)推荐的批量生成流程清晰划分为三个规范步骤:
- 初始化独立生成器:通过
np.random.default_rng(seed)创建 Generator 实例。传入固定的整数种子(如 42)能保证整个批量生成过程具备百分之百的可复现性。 - 选择对应的分布采样器:根据实际工程或模型特征需求,选择浮点均匀分布、离散整数、高斯白噪声或特定概率抽样方法。
- 配置多维形状参数
size:传入整数或形状元组,让 NumPy 底层预先计算内存块并批量完成向量化填充。
以下是完成上述三步法的最精炼基础代码示例:
import numpy as np

# 步骤 1:使用种子初始化独立的生成器实例
rng = np.random.default_rng(seed=2026)

# 步骤 2 & 3:选择采样方法,并通过 size 参数批量生成 3 行 4 列的浮点数组
batch_data = rng.random(size=(3, 4))

print("生成的批量数组内容:")
print(batch_data)
print("数组形状:", batch_data.shape)
print("数据类型:", batch_data.dtype)二、常用分布批量生成代码实战
不同应用场景对随机数值的范围与分布特征有严格要求。本节针对数据分析、模拟仿真与机器学习中最常见的四类批量需求,提供开箱即用的标准代码。
1. 批量生成均匀分布浮点数组
如果需要生成区间在 [0.0, 1.0) 之间的浮点数(常用于模型输入的归一化模拟或丢弃概率判定),直接使用 rng.random(size);如果需要任意区间 [low, high) 的连续数值,使用 rng.uniform(low, high, size)。
# 批量生成指定区间的连续物理量(例如模拟传感器读数:温度范围 20.0℃ 至 35.0℃)
temperatures = rng.uniform(low=20.0, high=35.0, size=(4, 3))
print("批量模拟温度矩阵 (4, 3):
", np.round(temperatures, 2))2. 批量生成离散整数数组(带边界控制)
用于构造离散分类标签、随机采样索引或用户模拟 ID。在现代生成器中,批量整数生成统一使用 rng.integers() 函数。
# 生成 10 个介于 10 到 50 之间的整数(默认不含 50,即左闭右开 [10, 50))
int_arr1 = rng.integers(low=10, high=50, size=10)

# 若需包含上限 50(即完全闭区间 [10, 50]),显式设置 endpoint=True
int_arr2 = rng.integers(low=10, high=50, size=(2, 5), endpoint=True)

print("半开区间整数一维向量:
", int_arr1)
print("完全闭区间 2x5 整数矩阵:
", int_arr2)3. 批量生成正态分布(高斯噪声)数组
在深度学习参数初始化或通信信号仿真中,高斯白噪声是最高频的需求。若需要标准正态分布(均值 \(\mu=0\),标准差 \(\sigma=1\)),推荐使用计算效率最高的 rng.standard_normal(size);若需要任意均值与方差的高斯分布,使用 rng.normal(loc, scale, size)。
# 批量生成满足特定均值与标准差的高斯样本(均值 loc=5.0, 标准差 scale=1.5)
gaussian_batch = rng.normal(loc=5.0, scale=1.5, size=(3, 3))
print("高斯分布批量样本 (3, 3):
", np.round(gaussian_batch, 3))4. 批量样本抽样与洗牌
当数据源已经存在(如已有类目列表或候选样本),需随机抽取一个批量时,使用 rng.choice()。
categories = np.array(["电子", "服装", "美妆", "家居", "食品"])

# 有放回抽样 8 个样本(replace=True 为默认)
sampled_with_replacement = rng.choice(categories, size=8)

# 无放回抽样 3 个样本(每个元素最多被抽中一次)
sampled_without_replacement = rng.choice(categories, size=3, replace=False)

print("有放回抽样批次:", sampled_with_replacement)
print("无放回抽样批次:", sampled_without_replacement)三、size 参数的维度规则与批量张量控制
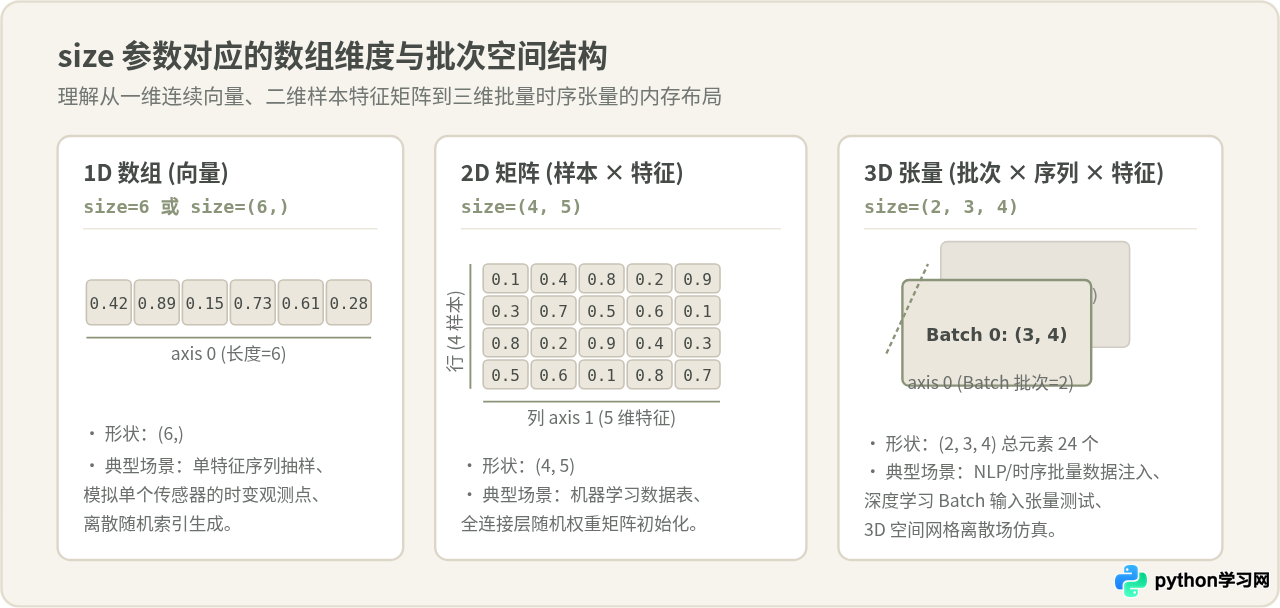
在 numpy.random 中,size 参数直接决定了输出数组的维度(ndim)与形状(shape)。
- 标量形式(整数 \(N\)):如
size=10或size=(10,),生成长度为 10 的一维向量。 - 二维元组 \((M, N)\):生成 \(M\) 行 \(N\) 列的数据表格,常用作训练集的批次特征矩阵。
- 高维元组 \((B, S, D)\):生成三维或更高维张量,例如在自然语言处理或时序建模中,\(B\) 代表批大小(Batch Size),\(S\) 代表序列长度(Sequence Length),\(D\) 代表特征维度(Embedding Dimension)。
以下代码演示一次性批量构建高维张量:
# 一次性构建 3D 批处理张量:2 个批次,每个批次包含 3 个时间步,每个时间步 4 维特征
batch_tensor = rng.standard_normal(size=(2, 3, 4))

print("生成的 3D 张量形状:", batch_tensor.shape)
print("张量总元素个数:", batch_tensor.size)
print("批次 0 数据切片:
", np.round(batch_tensor[0], 2))四、容易混淆的说法与新旧 API 深度辨析
在阅读较早的技术博客或开源代码时,读者常能见到 np.random.seed(0) 以及 np.random.rand()、np.random.randint() 等写法。很多人会疑惑:既然这些老代码能够正常运行,为什么官方与现代标准坚决推荐使用 default_rng()?
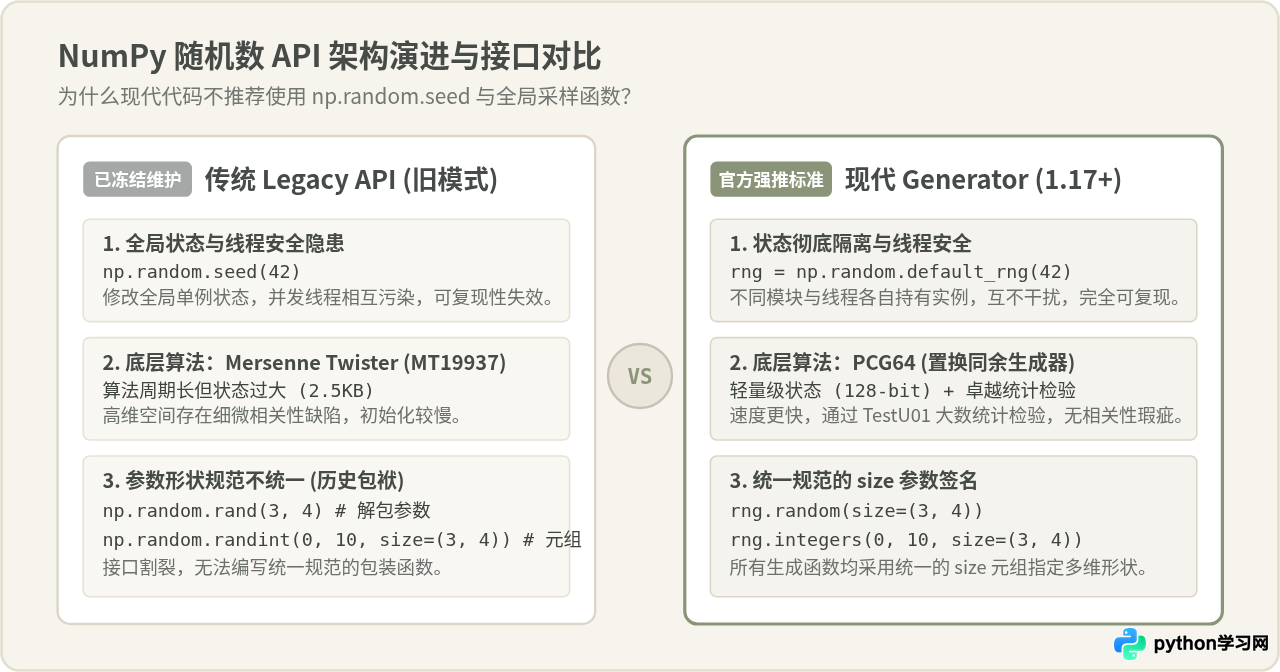
看似合理的原因:在单个简单脚本中,调用 np.random.seed(42) 确实能让随后的采样保持一致。
问题所在:传统方法修改的是 NumPy 底层的全局单例伪随机状态。当项目规模扩大,或者引入多线程、并发数据加载管道时,任何一个第三方库或异步子任务调用全局随机函数,都会导致全局状态被悄悄推进。这使得后续看似相同的代码产生完全不可控的变动。而 default_rng() 返回独立的 Generator 对象,每个对象维持私有内存状态,彻底杜绝了并发污染。
看似合理的原因:它们都能生成 [0, 1) 区间的均匀分布浮点数。
问题所在:历史遗留的 np.random.rand(d0, d1, ...) 接受可变位置参数(解包传参),如 rand(3, 4);而 randint(low, high, size=(3, 4)) 却要求通过 size 关键字传入元组。这种接口参数的不一致性是历史遗留包袱。现代 Generator 彻底统一了规范:无论调用 rng.random()、rng.integers() 还是 rng.standard_normal(),均统一通过 size=(d0, d1, ...) 指定维度。
极易踩坑的细节:Python 原生标准库中的 random.randint(a, b) 是完全闭区间(包含 \(b\));而 NumPy 现代接口 rng.integers(low, high) 默认是遵循科学计算惯例的左闭右开区间 [low, high)。如果需要包含右端点,必须显式传递参数 endpoint=True。混淆这一点常会导致数据越界或最大类别标签永远无法被采样的隐蔽 Bug。
五、批量生成方法快速选型指南
为了在实际开发中快速准确地写出无瑕疵的生成代码,读者可以根据下方的决策树与速查表进行对照选型:
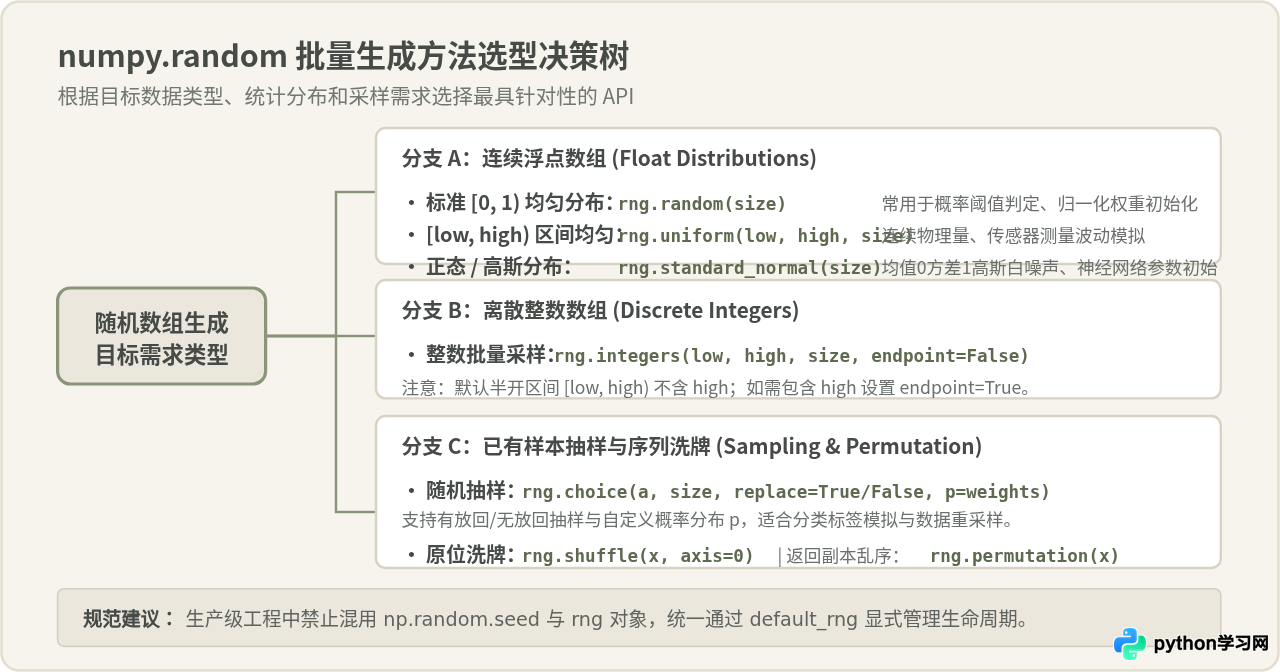
| 生成目标需求 | 现代推荐方法 (NumPy 1.17+) | 典型传参示例 | 替代的废弃旧写法 |
|---|---|---|---|
| [0, 1) 标准均匀浮点 | rng.random(size) |
rng.random((100, 4)) |
np.random.rand(100, 4) |
| [a, b) 任意区间连续浮点 | rng.uniform(low, high, size) |
rng.uniform(-1.0, 1.0, size=50) |
np.random.uniform(...) |
| 离散随机整数 | rng.integers(low, high, size) |
rng.integers(0, 10, size=(10, 2)) |
np.random.randint(...) |
| 标准正态高斯分布 | rng.standard_normal(size) |
rng.standard_normal(size=(32, 128)) |
np.random.randn(32, 128) |
| 指定均值与方差高斯 | rng.normal(loc, scale, size) |
rng.normal(0.0, 0.5, size=(10, 10)) |
np.random.normal(...) |
| 已有样本抽样 | rng.choice(a, size, replace, p) |
rng.choice(items, size=5, replace=False) |
np.random.choice(...) |
| 数组顺序随机置换 | rng.permutation(x) |
shuffled = rng.permutation(arr) |
np.random.permutation(...) |
六、总结与工程落地建议
在批量生成随机数组时,遵循以下几条工程军规能够显著提高代码的健壮度与可复现性:
- 显式传递种子:在需要进行单元测试、实验对比或模型验证时,始终在
default_rng(seed)中显式注入整数种子。 - 避免在循环体内重复实例化:不要在
for循环中频繁调用default_rng(),这会破坏随机比特流的连续性;应在函数外部或类初始化时创建一次rng实例,随后在循环内持续采样。 - 优先使用原生
size避免二次变形:直接通过size=(B, N, D)生成多维数组,避免先生成扁平的一维数组再调用.reshape(),这样能让 C 语言内部直接完成目标维度的步长(strides)初始化,速度更快且语义更加直观。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















