


Python ctypes多维数组怎么定义和访问
深入讲解 Python ctypes 模块中多维数组的定义语法、初始化赋值、元素访问与切片机制,剖析行优先连续内存排列原理与 C 语言指针交互细节,提供可运行示例与常见陷阱排查方案。
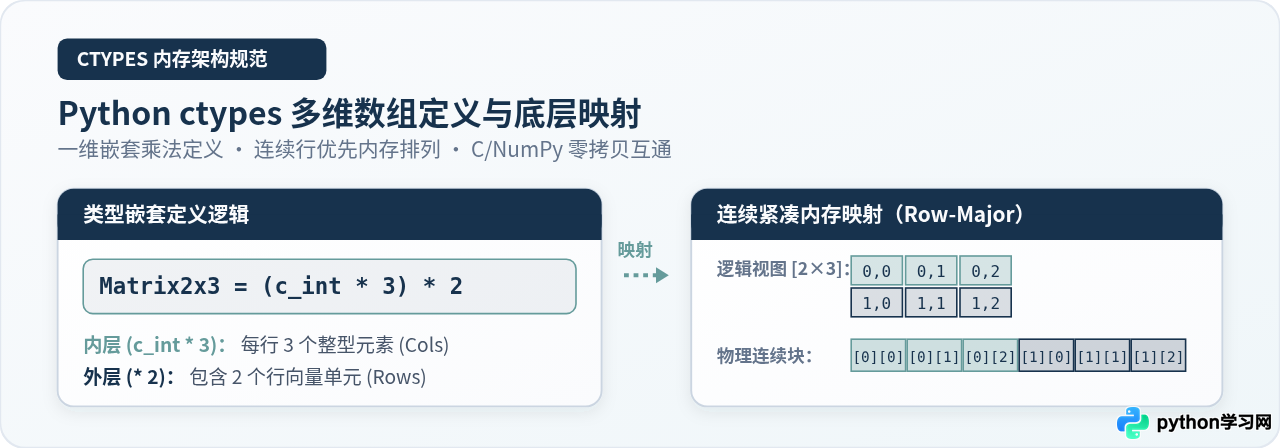
ctypes 模块中,多维数组并不是通过特殊的多维容器类型实现的,而是基于一维数组类型的嵌套乘法构建而成:例如一个 2 行 3 列的整型数组类型,标准定义语法为 (ctypes.c_int * 3) * 2(先将标量类型乘以 3 得到包含 3 个元素的单行数组类型,再将该行类型乘以 2 构成 2 行)。在访问数据时,它完美支持与 Python 原生列表一致的双重索引下标 arr[row][col],并且在物理内存上以严格的行优先(Row-Major)连续排列。掌握这种类型推导机制与物理布局,是正确进行底层高性能运算与 C 动态库接口交互的核心基础。
一、多维数组的定义语法与推导逻辑
在 C 语言中,二维数组例如 int arr[2][3] 的本质是“一个包含 2 个元素的数组,且其中的每一个元素都是包含 3 个整数的一维数组”。ctypes 忠实还原了 C 语言的这一类型系统。
在 ctypes 中,定义一维数组的固定公式为:数组类型 = 元素类型 * 长度。定义多维数组时,只需将该乘法规则由内向外依次嵌套即可:
import ctypes

# 步骤 1:定义基本类型(int 标量)
BaseType = ctypes.c_int

# 步骤 2:定义单行数组类型(每行 3 个元素,即 3 列)
Row3Type = BaseType * 3      # 生成 c_int_Array_3

# 步骤 3:定义包含 2 行的二维矩阵类型
Matrix2x3 = Row3Type * 2     # 生成 c_int_Array_3_Array_2

# 生产环境中推荐的紧凑一行式定义:
Array2D = (ctypes.c_int * 3) * 2
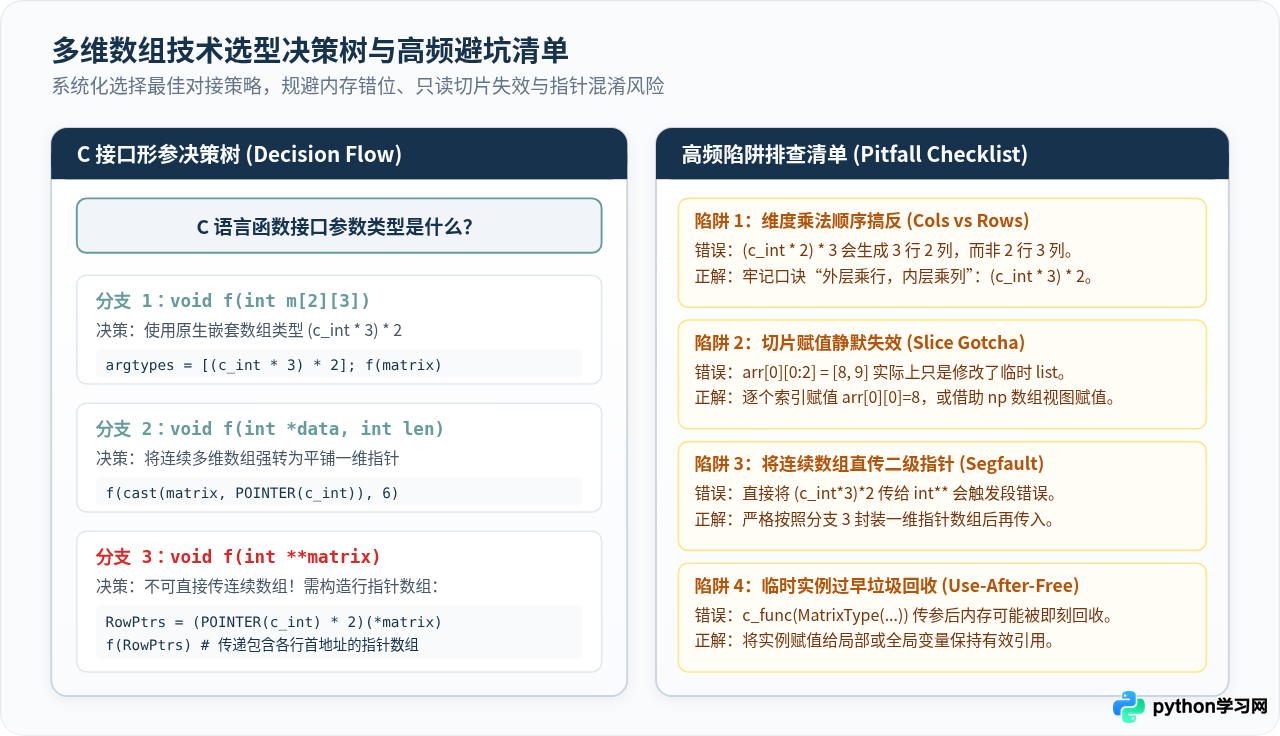
理解括号的优先级和维度乘法的顺序至关重要。很多初学者容易将 (c_int * 3) * 2 误认为是 3 行 2 列,实际上内层括号 * 3 确定的是列数,外层 * 2 确定的才是行数。
这一推导逻辑可以无缝扩展到三维及更高维度。例如在 C 语言中定义的立体张量 int tensor[2][3][4](2 个矩阵切片,每个切片 3 行 4 列),在 ctypes 中的对应写法如下:
# 三维数组:从内向外依次为最低维到最高维
# 最内层 4 列 -> 中间层 3 行 -> 最外层 2 个深度分块
TensorType = ((ctypes.c_int * 4) * 3) * 2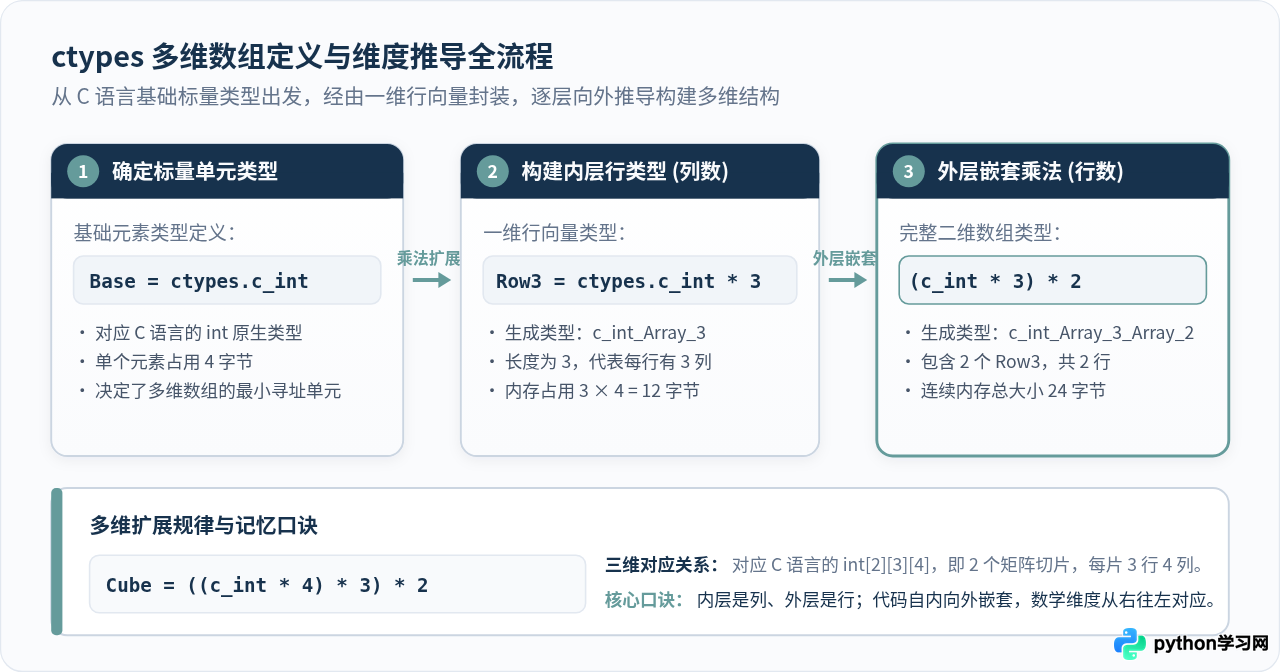
二、多维数组的实例化与初始化赋值
定义好多维数组类型后,需要实例化才能在内存中开辟空间并填充具体数据。ctypes 支持以下几种常见的实例化和初始化方式:
1. 默认零值初始化
直接调用类型构造函数且不传任何参数时,ctypes 会在进程内存中开辟指定字节数的连续内存,并自动进行零值清零(类似于 C 语言的 calloc):
# 创建 2 行 3 列的数组实例,所有元素初始化为 0
matrix_zero = Matrix2x3()
2. 嵌套元组或列表传参初始化
如果希望在创建时直接填充数据,可以传入嵌套元组(或者由行类型实例构成的参数序列)。每一行对应一个子元组:
# 传入两个子元组,分别对应第 0 行和第 1 行
matrix_init = Matrix2x3(
    (1, 2, 3),
    (4, 5, 6)
)

# 也可以显式使用单行类型构造后再传入:
row_type = ctypes.c_int * 3
matrix_init2 = Matrix2x3(
    row_type(10, 20, 30),
    row_type(40, 50, 60)
)
三、多维数据的访问、修改与切片陷阱
ctypes 数组重载了 Python 的 __getitem__ 和 __setitem__ 协议,因此在读取和单元素赋值时,其语法与普通 Python 嵌套列表完全一致。
1. 双重下标访问与修改
使用 matrix[row][col] 格式可以直接读写特定坐标的元素:
# 读取第 0 行第 1 列元素
val = matrix_init[0][1]
print("读取 matrix_init[0][1] =", val)  # 输出: 2

# 就地修改第 1 行第 2 列元素
matrix_init[1][2] = 99
print("修改后 matrix_init[1][2] =", matrix_init[1][2])  # 输出: 99
2. 提取整行与子数组视图
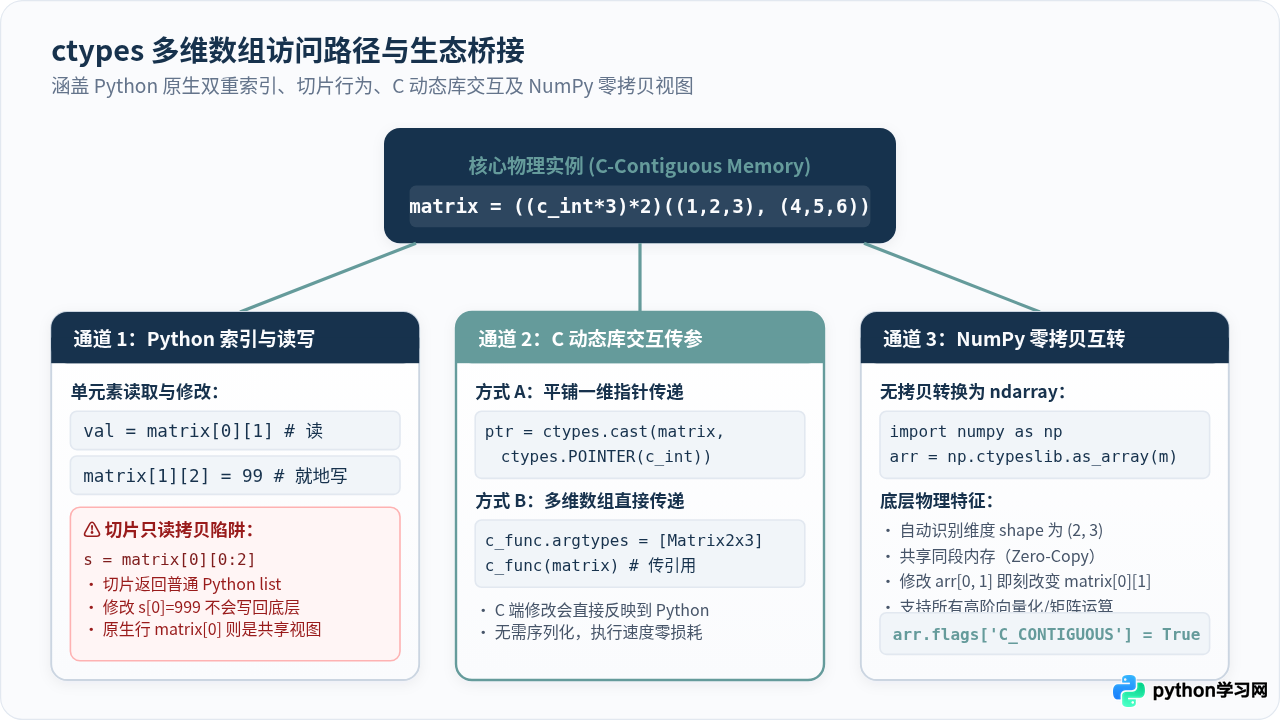
当只使用单个索引 row0 = matrix_init[0] 时,返回的是内部包含 3 个整数的行数组对象(类型为 c_int_Array_3)。这个子数组对象与原多维数组共享底层物理内存:
row0 = matrix_init[0]
row0[0] = 888

# 原二维数组中的对应位置随之同步更新
print("matrix_init[0][0] =", matrix_init[0][0])  # 输出: 888
3. 遍历多维数组
可以使用传统的双层 for 循环按行逐项遍历:
for r_idx, row in enumerate(matrix_init):
    for c_idx, elem in enumerate(row):
print(f"坐标 [{r_idx}][{c_idx}] = {elem}")在 Python 中对
ctypes 数组进行切片(如 sub = matrix_init[0][0:2])时,ctypes 返回的是一个标准 Python 列表(list),而不是底层的内存视图!这意味着:如果你执行
matrix_init[0][0:2] = [100, 200],Python 会抛出 TypeError 异常拒绝切片赋值;而如果将切片赋值给中间变量后再修改 sub[0] = 999,原 matrix_init 内部的数据不会发生任何改变。修改数据必须使用逐项标量赋值 matrix[r][c] = val。
四、底层行优先连续内存与 C 动态库传参
理解 ctypes 多维数组的底层原理,必须了解其内存存储方式。无论数组被声明为几维,在计算机的物理内存中,数据总是紧凑平铺在单块连续线性空间中,并且严格遵守 C 语言的行优先(Row-Major)排列规范。
对于 (c_int * 3) * 2 类型的数组,内存总字节数为:
print("总内存大小(字节):", ctypes.sizeof(matrix_init)) # 2 * 3 * 4 = 24 字节其二维下标 (row, col) 在一维内存中的相对字节偏移量遵循以下计算公式:
Offset = (row × 总列数 + col) × sizeof(基础元素类型)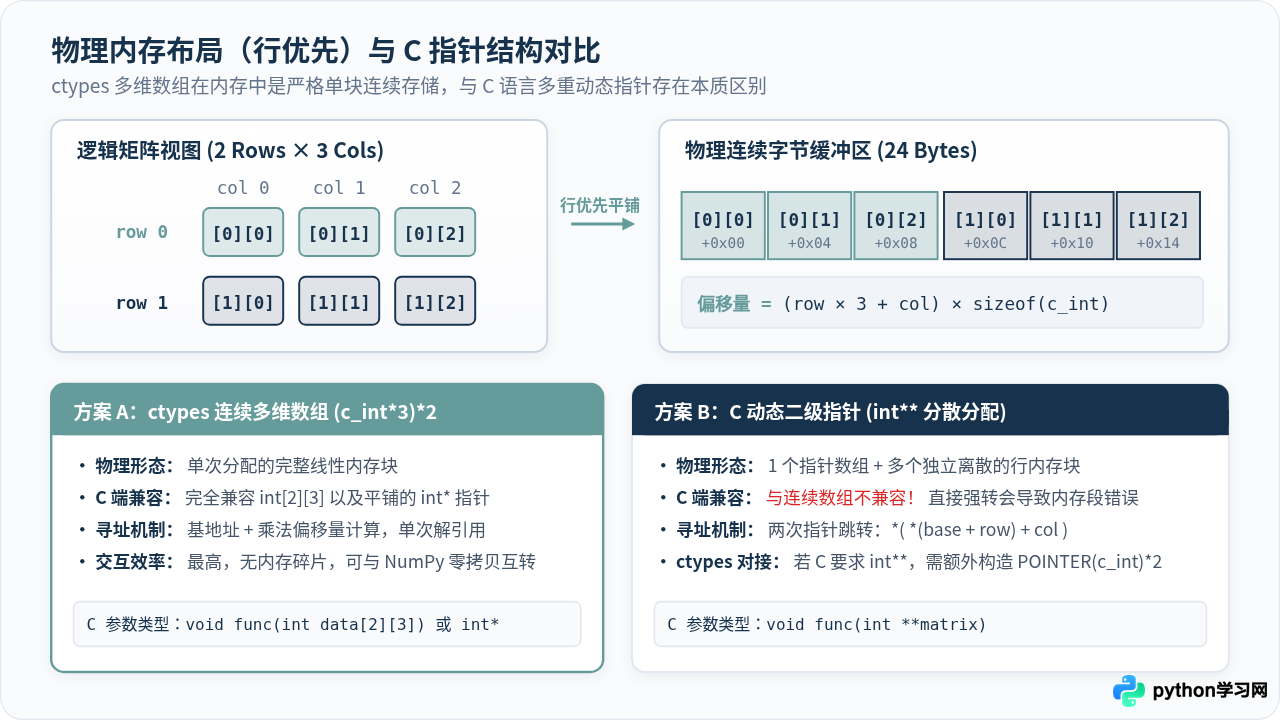
与 C 语言动态链接库传参对接
在实际工程中,使用 ctypes 多维数组往往是为了调用 C/C++ 编写的动态链接库(.so / .dll)。根据 C 语言函数形参签名的不同,主要分为以下两种传参方案:
| C 函数形参声明 | C 端内存预期 | ctypes Python 端参数配置与传参方式 |
|---|---|---|
void func(int data[2][3]) |
固定维度的连续内存块 | 直接声明 func.argtypes = [Matrix2x3],调用时直接传 func(matrix)。 |
void func(int *data, int rows, int cols) |
一维连续首地址指针 | 声明 func.argtypes = [ctypes.POINTER(ctypes.c_int), ctypes.c_int, ctypes.c_int],传参时使用 ctypes.cast(matrix, ctypes.POINTER(ctypes.c_int)) 强转。 |
void func(int **data, int rows, int cols) |
指针数组(离散内存二级指针) | 严禁直接传多维数组!必须额外构造包含各行首地址的一维指针数组:(ctypes.POINTER(ctypes.c_int) * rows)(*matrix)。 |
五、进阶:与 NumPy 进行零拷贝无缝转换
ctypes 数组对象原生实现了 Python 的 Buffer 协议(缓冲区协议)。如果你的项目中引入了科学计算库 numpy,可以通过 numpy.ctypeslib.as_array 实现 ctypes 多维数组与 NumPy 数组之间的零拷贝(Zero-Copy)视图转换。
import ctypes
import numpy as np

# 1. 创建 ctypes 多维数组
Matrix2x3 = (ctypes.c_int * 3) * 2
c_matrix = Matrix2x3((1, 2, 3), (4, 5, 6))

# 2. 转换为 NumPy 数组(零内存拷贝,完全共享同一块内存)
np_view = np.ctypeslib.as_array(c_matrix)

print("NumPy 形状:", np_view.shape)      # 输出: (2, 3)
print("NumPy 数据类型:", np_view.dtype)   # 输出: int32

# 3. 通过 NumPy 进行切片批量赋值或矩阵运算
np_view[0, :] = [100, 200, 300]

# 4. 检验原 ctypes 数组是否实时更新
print("原 c_matrix[0][1] =", c_matrix[0][1])  # 输出: 200,说明直接就地同步!
利用这种桥接机制,开发者既可以享受 C 动态库直接操作裸内存的高性能,又能在 Python 端借助 NumPy 丰富强大的切片、线性代数和矩阵运算算子,实现两全其美。
六、高频陷阱排查与选型决策指南
在开发和维护涉及 ctypes 多维数组的项目时,以下四个高频失误需要格外警惕:
- 维度乘法反转导致维度错位:牢记公式
(基本类型 * 列数) * 行数。如果写成(c_int * 2) * 3,在试图访问arr[1][2]时会报IndexError: invalid index,因为行数变成了 3,而列数只有 2。 - 误将多维数组当做二级指针传参:C 语言初学者常误认为
int[2][3]等价于int**。实际上二维数组是纯平铺内存,解引用一次即可拿到数据;而int**要求首地址指向的是指针变量。如果强行把byref(matrix)传入要求int**的 C 函数,程序在尝试二次解引用时会读取错误地址并引发严重段错误(Segmentation Fault)。 - 切片修改静默丢失:切记不要使用
matrix[0][0:2] = [...]的方式批量写回数据。如需批量操作,请使用嵌套循环赋值或上述 NumPy 零拷贝视图。 - 临时变量提前垃圾回收引发野指针:在调用 C 动态库时,如果通过
c_func(Matrix2x3(...))传入未绑定到变量的临时对象,Python 垃圾回收器可能会在 C 函数尚未执行完毕或后台异步访问前将其内存回收,造成野指针访问故障。必须始终使用有变量引用的持久实例。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















