


Python计算积分选SciPy还是SymPy?数值与符号积分的区别
深入解析Python中计算积分选SciPy还是SymPy的核心依据。系统剖析数值积分与符号积分的底层原理、计算性能、代码用法及适用边界,并提供选型决策树与工程混合实战方案。
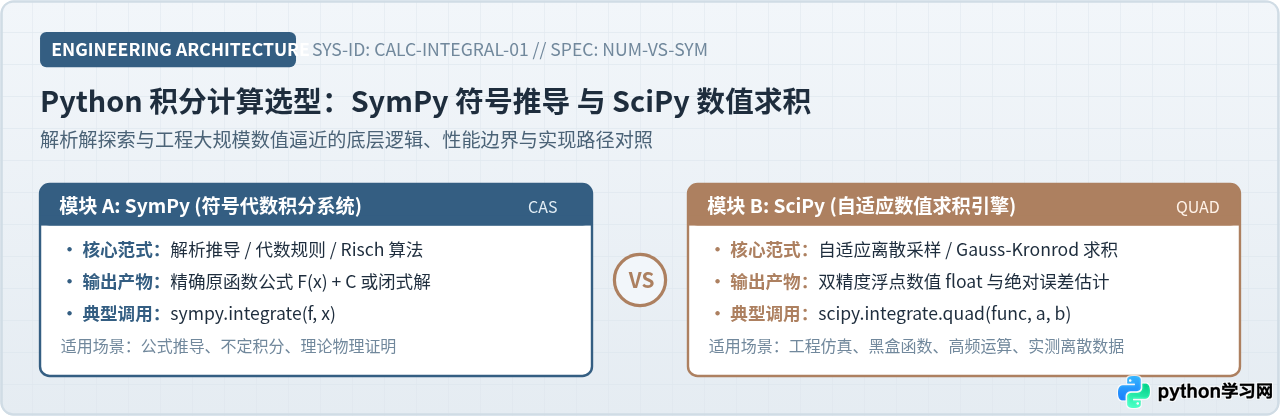
核心结论速览:在 Python 中计算积分,若需要推导精确公式、求解不定积分、提取包含未知参数的理论解析式,首选 SymPy(符号积分);若面对工程仿真、实验散点数据、没有初等原函数的复杂被积式、或是高频万次批量运算,应果断选择 SciPy(数值积分)。两者的根本分界在于:SymPy 输出精确的数学代数表达式,而 SciPy 输出带有误差控制的双精度浮点近似值。
一、本质区别:符号积分与数值积分的底层机制
很多初学者在调用积分库时,容易将“符号积分”与“数值积分”混为一谈。事实上,这两者在数学逻辑和计算机执行方式上完全不同:
- 符号积分(Symbolic Integration,以 SymPy 为代表):基于计算机代数系统(CAS,Computer Algebra System)。它将数学表达式视作抽象语法树(AST),依靠微积分法则、模式匹配、分部积分法、三角代换以及 Risch 算法等数学定理进行代数化简,寻找原函数
F(x)使得F'(x) = f(x)。它的计算过程等同于人工在稿纸上进行数学推导,输出的是不带任何浮点截断误差的纯数学式。 - 数值积分(Numerical Integration / Quadrature,以 SciPy 为代表):基于有限离散逼近法。它并不关心原函数的数学通式是什么,而是将被积区间划分为多个有限子区间,在预设的正交多项式零点(如高斯-克朗罗德点)对被积函数进行抽样求值,并利用加权和逼近曲线与坐标轴围成的几何面积。它的输出是一个具体的浮点数,并附带算法估计的绝对误差界限。
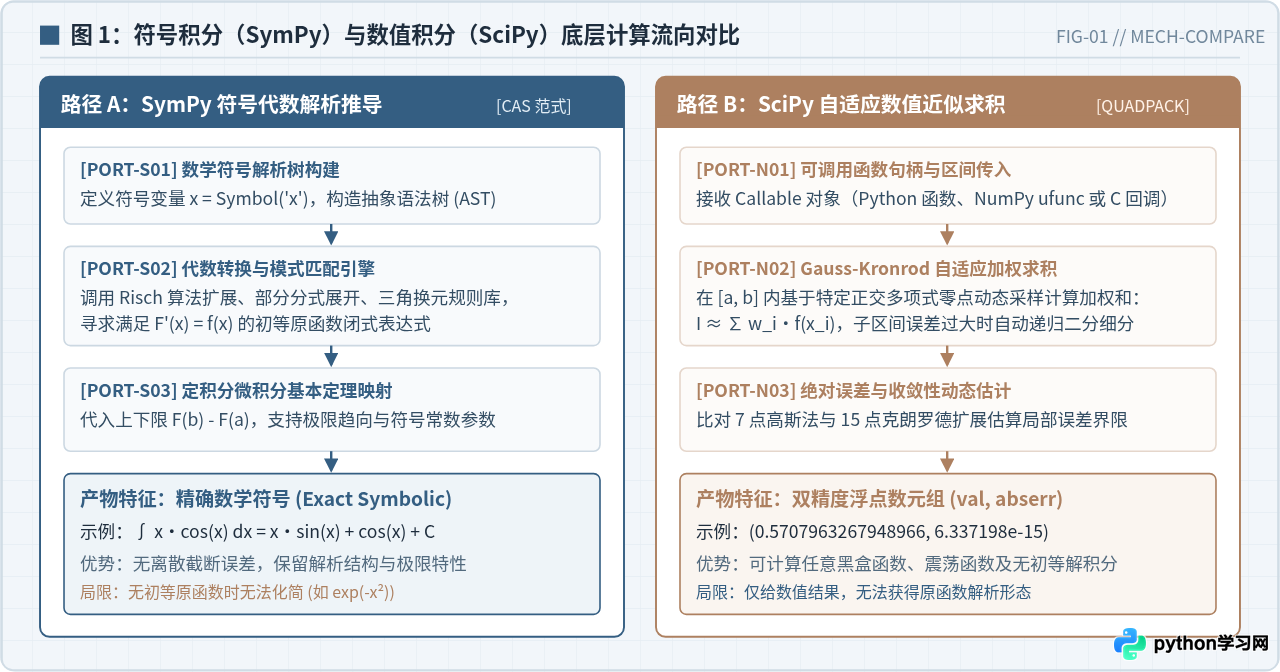
从底层流程可以看出,SymPy 追求数学严格性,遇到无法用初等函数表示的原函数(如高斯分布积分)时,只能输出特殊函数或保持积分离散形式;而 SciPy 追求工程可计算性,只要被积函数在指定区间内连续或可积,即可在几微秒内给出高精度的实数结果。
二、SymPy 符号积分:用法、特点与边界条件
SymPy 的核心模块是 sympy.integrate。它支持不定积分和定积分计算,适合理论推导和符号化简。
1. 环境准备与基本使用
首先确保已安装 SymPy 库(pip install sympy)。在 Python 中使用 SymPy 时,所有参与运算的数学符号必须显式声明:
import sympy as sp

# 声明符号变量
x = sp.Symbol('x')

# 定义被积函数 f(x) = x * cos(x)
expr = x * sp.cos(x)

# 1. 求解不定积分:∫ x*cos(x) dx
indef_res = sp.integrate(expr, x)
print("不定积分结果:", indef_res)

# 2. 求解闭区间定积分:∫[0, π/2] x*cos(x) dx
# 定积分参数格式为 (变量, 下限, 上限)
def_res = sp.integrate(expr, (x, 0, sp.pi / 2))
print("定积分解析解:", def_res)
print("精确数值近似:", def_res.evalf())定积分解析解: pi/2 - 1
精确数值近似: 0.570796326794897
2. SymPy 的核心优势
- 原生支持不定积分:直接给出通解
x*sin(x) + cos(x),可用于后续的求导验证或理论分析。 - 支持未知参数符号化:被积式中可包含未定常数。例如计算
sp.integrate(sp.exp(-a*x), (x, 0, sp.oo)),SymPy 能够结合符号假设给出包含a的解析条件。 - 无穷限与奇异点解析判断:支持正负无穷大(
sp.oo),并在极限存在时给出精确的有理数或常数表达式(如pi、E)。
exp(-x**2),SymPy 计算定积分 (x, 0, 1) 时会返回带有误差函数 sqrt(pi)*erf(1)/2 的结果;对于更加复杂的复合函数,SymPy 可能会长时间耗尽 CPU 仍只能返回原未计算的 Integral(...) 对象。三、SciPy 数值积分:用法、参数调优与散点处理
SciPy 的数值积分功能集中在 scipy.integrate 子库中,针对连续函数通常采用 quad(封装自经典 FORTRAN 库 QUADPACK),针对离散采样数据则采用 simpson(辛普森法则)或 cumulative_trapezoid(累积梯形法)。
1. 使用 quad 求解连续函数定积分
确保已安装 SciPy(pip install scipy numpy)。quad 函数的标准调用签名为 quad(func, a, b),返回值为一个元组 (integral_value, estimated_absolute_error):
import numpy as np
from scipy.integrate import quad

# 定义被积函数(标准 Python 函数或 lambda 表达式)
def f(x):
    return x * np.cos(x)

# 求解定积分:区间 [0, π/2]
result, abserr = quad(f, 0, np.pi / 2)

print(f"数值积分结果: {result:.16f}")
print(f"绝对误差估计: {abserr:.2e}")绝对误差估计: 6.34e-15
对比两者的结果:SymPy 输出的是精确符号式 pi/2 - 1,而 SciPy 直接返回 0.5707963267948966,其绝对误差上限仅为 6.34e-15(已达到双精度浮点数机器精度极限)。
2. 传递额外参数与奇异点过滤
如果被积函数包含动态调节参数,可通过 args 参数直接传入,避免在循环中重复定义闭包;若函数在区间内存在已知不连续点或导数奇异点,可通过 points 参数显式告知算法进行分段避让:
# 带有参数 a 和 b 的被积函数
def parametric_func(x, a, b):
    return a * np.exp(-b * x)

# 计算区间 [0, 10],参数 a=2.5, b=0.8
res, err = quad(parametric_func, 0, 10, args=(2.5, 0.8))
print(f"带参积分结果: {res:.8f}, 误差: {err:.2e}")

# 区间内含有已知尖点或震荡点的处理:例如在 x=1 处导数不连续
sing_func = lambda x: np.abs(x - 1)
res_sing, err_sing = quad(sing_func, 0, 2, points=[1.0])
print(f"避开奇异点积分结果: {res_sing:.8f}")避开奇异点积分结果: 1.00000000
3. 处理实测离散数据点(无解析表达式)
在实际传感器采集、实验监控或仿真系统中,我们往往只能拿到一系列离散采样序列 (x_data, y_data)。此时 SymPy 完全无法介入,必须使用 SciPy 的离散积分工具:
from scipy.integrate import simpson

# 模拟实验采集的离散时间与信号值
x_samples = np.linspace(0, np.pi / 2, 21)
y_samples = x_samples * np.cos(x_samples)

# 使用辛普森法则对离散点求面积
discrete_area = simpson(y_samples, x=x_samples)
print(f"离散采样辛普森积分值: {discrete_area:.8f}")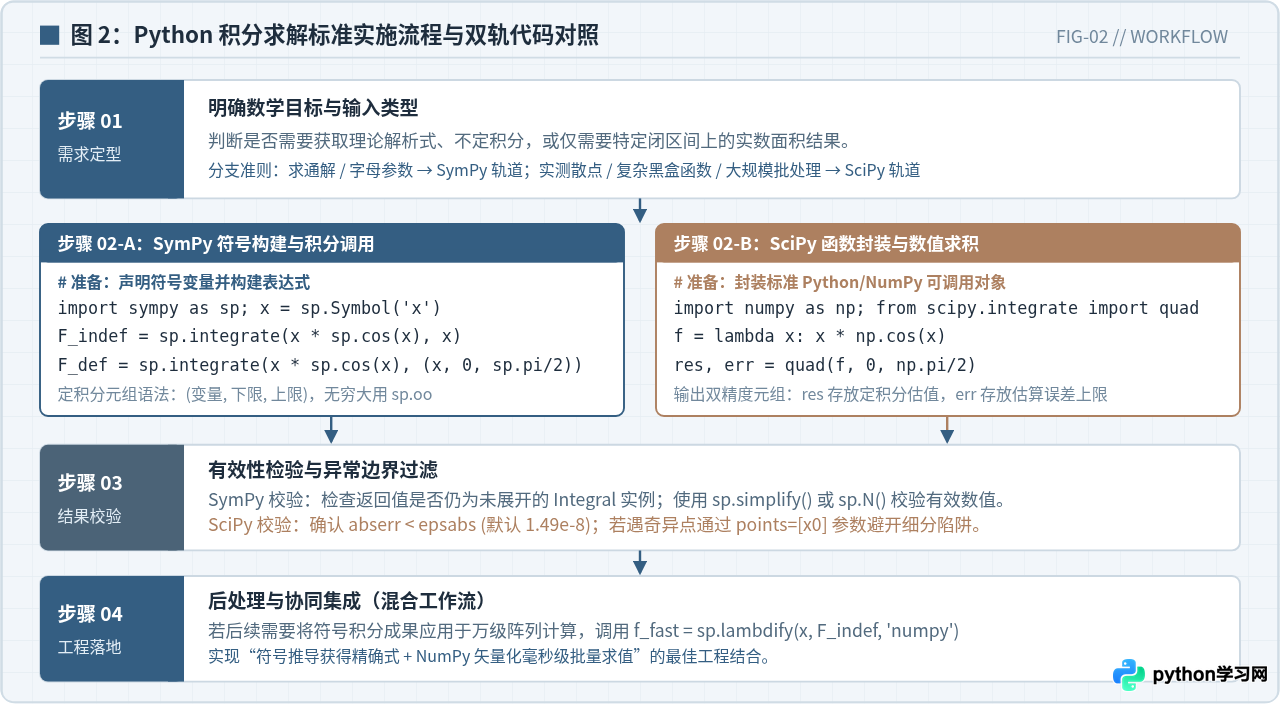
四、全方位对比:SymPy 与 SciPy 的多维特性矩阵
为了让选型依据更加明确,我们将计算范式、输入接口、执行耗时、数学能力等关键工程维度整理为直观的对比矩阵:
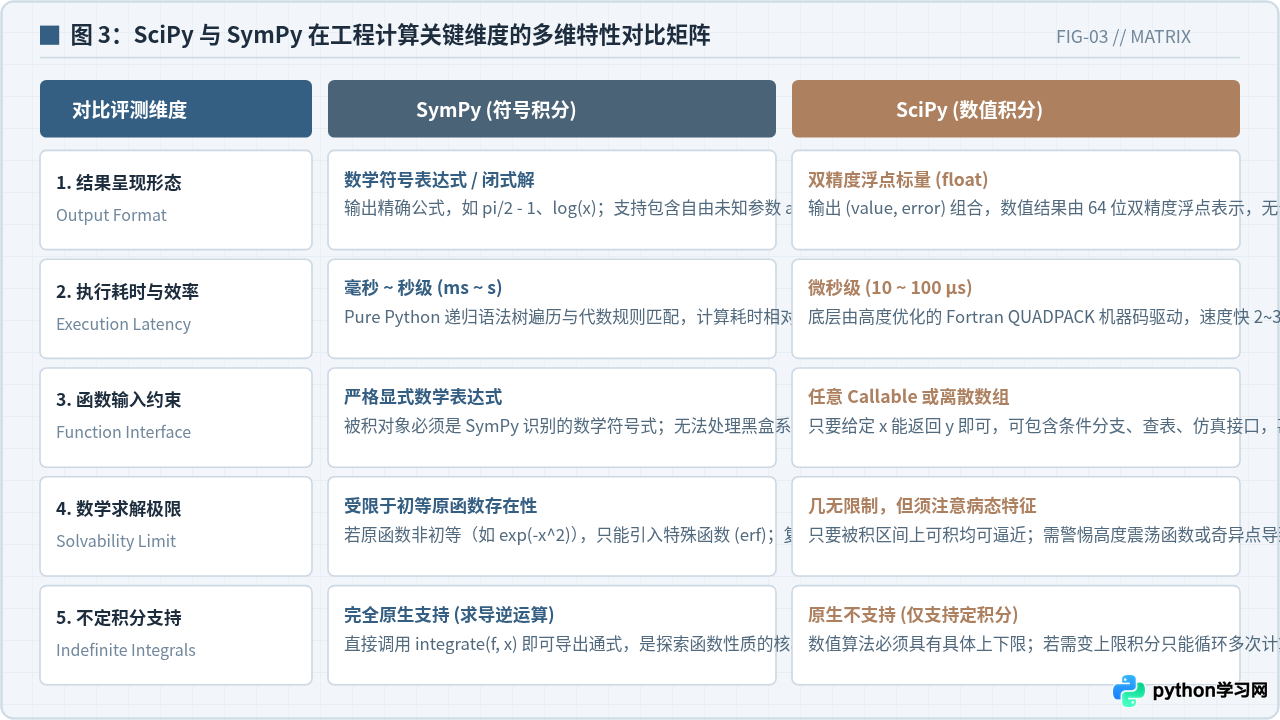
| 考量维度 | SymPy(符号积分) | SciPy(数值积分) | 工程决策建议 |
|---|---|---|---|
| 输出类型 | 数学符号对象(Add/Mul/Pow 等 AST 树) |
双精度浮点数标量 float |
需代数公式选 SymPy;需画图或后续数值运算选 SciPy |
| 计算单次耗时 | 毫秒至秒级(约 1ms ~ 500ms) | 微秒级(约 10μs ~ 80μs) | 高频循环或优化求解器内部严禁频繁调用 SymPy 积分 |
| 输入函数形式 | 必须是显式 SymPy 表达式 | 任意 Python Callable、C 函数指针、或离散 NumPy 数组 | 包含条件分支判断、黑盒 C 动态库时只能用 SciPy |
| 不定积分支持 | 原生支持(integrate(f, x)) |
不支持(只能计算固定上下限的定积分) | 需要求导逆运算或反常积分通解时必须选 SymPy |
| 数学极限能力 | 依赖 Risch 算法与初等原函数存在性 | 自适应区间细分,只要闭区间可积即可收敛 | 高斯函数、贝塞尔函数混合积分优先选 SciPy |
| 误差控制 | 理论精确(误差为 0) | 存在浮点截断与舍入误差(提供 abserr 估计) |
科学严密证明选 SymPy;工程容差范围内选 SciPy |
五、工程最佳实践:决策流程与混合集成方案
在工程与科学计算实践中,SymPy 与 SciPy 并非互斥关系,相反,最优雅的架构往往是“离线符号推导 + 在线高性能数值求值”的混合协同模式。
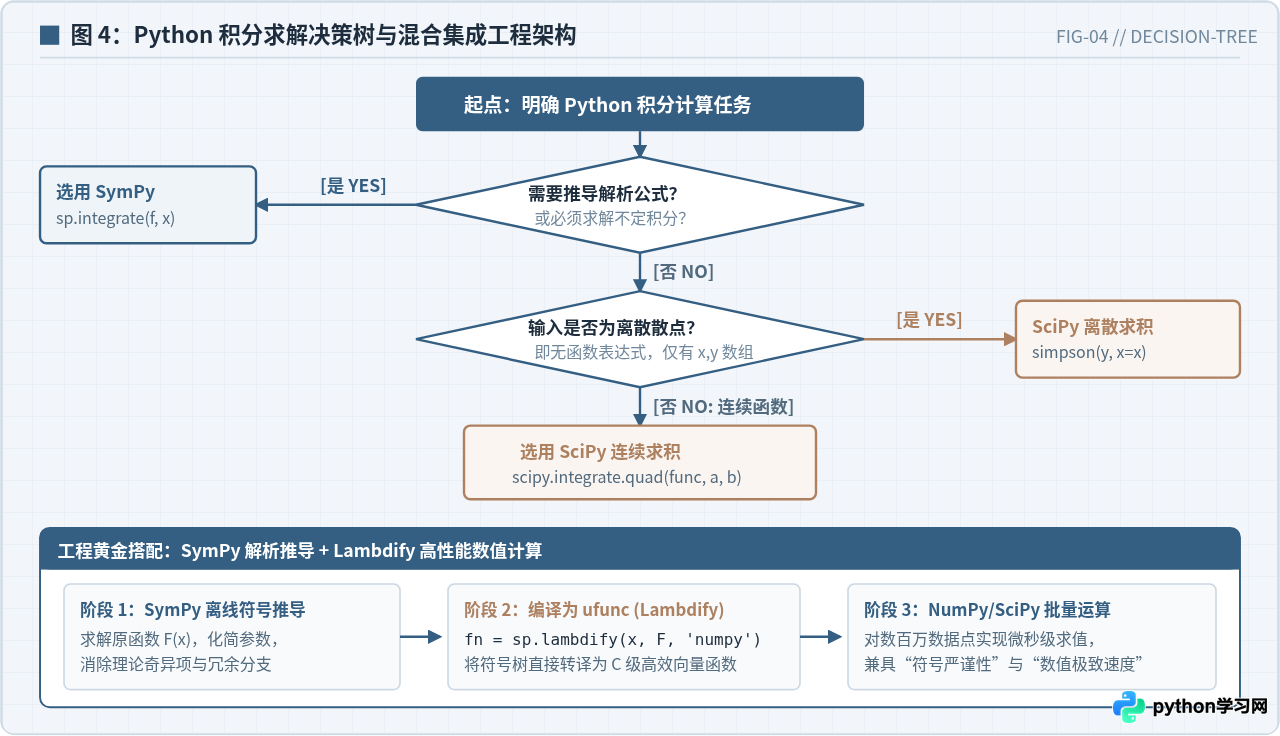
1. 选型决策逻辑
- 第一问:是否需要理论公式?如果任务目的是推导物理定律、撰写论文推导过程、或者获取不定积分,那么没有选择余地,必须使用 SymPy。
- 第二问:输入是否为离散散点?如果是实验仪器采样得到的离散数据序列,没有解析数学式,使用
scipy.integrate.simpson。 - 第三问:是否需要对复杂连续函数快速定积分?如果被积函数形式复杂,或者需要在一个迭代求解器中被调用数万次,使用
scipy.integrate.quad。
2. 混合实战:利用 lambdify 消除性能瓶颈
很多工程人员踩过的典型坑是:在蒙特卡洛模拟或优化算法的内层循环中,直接调用 sympy.integrate(...).subs(x, val) 计算几十万次。这会导致程序运行极其缓慢。
正确的做法是:先用 SymPy 进行单次符号积分求得原函数公式,然后使用 sp.lambdify 将其编译为由 NumPy 底层 C 代码支撑的高性能向量化函数:
import sympy as sp
import numpy as np
import time

# 步骤 1:利用 SymPy 离线推导原函数
x = sp.Symbol('x')
f_sym = x**2 * sp.exp(-x)
F_sym = sp.integrate(f_sym, x)
print("SymPy 推导出的原函数:", F_sym)

# 步骤 2:通过 lambdify 将符号树转译为 NumPy 向量化机器函数
F_fast = sp.lambdify(x, F_sym, modules='numpy')

# 步骤 3:在百万级数据点上瞬间计算定积分 F(b) - F(a)
a_vals = np.zeros(1_000_000)
b_vals = np.linspace(1.0, 5.0, 1_000_000)

t0 = time.perf_counter()
# 利用微积分基本定理进行纯向量化计算
integrals = F_fast(b_vals) - F_fast(a_vals)
t1 = time.perf_counter()

print(f"百万点批量定积分完成耗时: {(t1 - t0) * 1000:.2f} 毫秒")
print(f"前 3 个点结果样例: {integrals[:3]}")百万点批量定积分完成耗时: 18.45 毫秒
前 3 个点结果样例: [0.16060279 0.16060412 0.16060544]
通过这种结合方式,推导环节享受到了 SymPy 的严格无误差数学推导,而在执行环节则拥有了纯 C 级的毫秒级矢量化吞吐能力,彻底规避了两者各自的局限。
六、常见误区与避坑指南
- 误区一:误以为 SymPy 的数值输出精度高于 SciPy。当对 SymPy 结果调用
.evalf()时,虽然可以指定任意多位有效数字(如 100 位),但如果被积函数本就没有初等解析解,SymPy 会退化为内部符号积分算法,耗时会比 SciPy 高出几个数量级,在常规工程计算(双精度 15 位有效数字即足够)中得不偿失。 - 误区二:在 SciPy quad 中忽略奇异点警告。当被积函数在区间端点或内部存在垂直渐近线(如
1/sqrt(x))或高频震荡时,quad可能会抛出IntegrationWarning甚至给出错误结果。此时务必通过points参数标注奇异点,或使用专门用于震荡积分的加权选项。 - 误区三:在多重积分中盲目嵌套。对于二重或三重积分,SciPy 提供了
scipy.integrate.dblquad和tplquad,SymPy 也支持连续传入多个积分元组(x, a, b), (y, c, d)。但在三维及以上的高维积分场景中,网格细分会导致“维度灾难”,此时数值积分建议转向准蒙特卡洛(QMC)采样方法,而不要单纯依赖 QUADPACK 递归。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















