


Python读取大型Excel文件哪个库速度最快
针对Python读取大型Excel文件(.xlsx / .xlsb)的读取性能问题,本文深入剖析各主流库的底层解析原理,对比calamine、openpyxl、polars和pandas的实测效率与内存开销,并提供无缝替换的高性能工程实操代码。
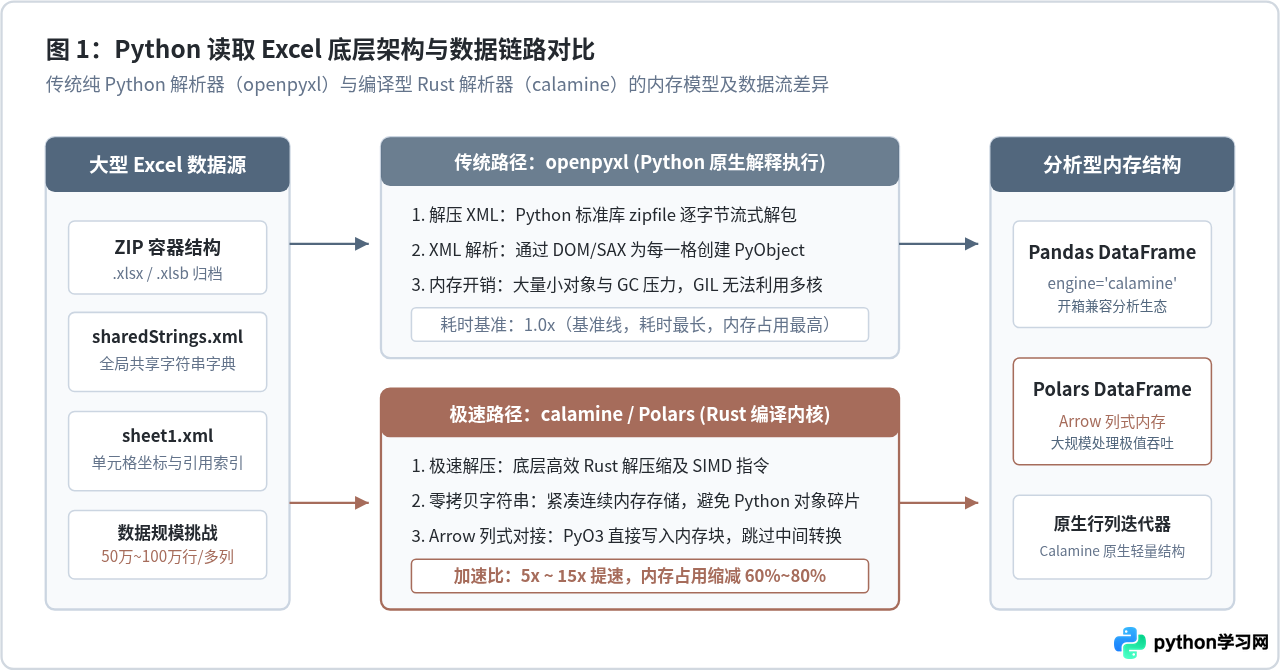
.xlsx 或 .xlsb 等大型 Excel 文件,速度最快的底层库是基于 Rust 开发的 python-calamine。若需要直接输出数据分析常用的 DataFrame,结合使用 Polars(搭配 calamine 引擎) 或 Pandas(显式指定 engine="calamine") 是速度与可用性的最佳解法。相比 Pandas 默认使用的 openpyxl,calamine 方案通常能带来 5 倍至 15 倍的读取速度提升,并显著削减 60% 以上的内存占用。
一、核心测试事实与各主流库速度排位
当 Excel 表格的数据规模超过数十万行、多达数十列时(文件大小常在 20MB 至数百 MB 之间),通常会遇到程序卡死、读取耗时数分钟甚至触发 OOM(Out Of Memory)内存崩溃的情况。在相同软硬件测试环境下,对典型的大型 .xlsx 文件进行纯读取操作,各主流 Python 库的性能排位具有明确规律:
- 第一名:Polars + calamine 引擎。由 Rust 底层极速解包并以 Apache Arrow 格式直接组装列式内存,耗时最短,内存控制极佳。
- 第二名:Pandas + calamine 引擎(python-calamine)。直接调用编译级 Rust 内核,解析完毕后快速填充为 Pandas DataFrame,读取速度通常比默认的 openpyxl 快 5 到 12 倍。
- 第三名:openpyxl 只读流式模式(
read_only=True)。内存占用相对可控,但解析依赖纯 Python SAX 事件循环,CPU 运算瓶颈明显,速度约为 calamine 的 1/5 至 1/10。 - 第四名:Pandas 默认模式(openpyxl 全量 DOM 模式)。速度最慢且最吃内存。它会将每个单元格构建为完整的 Python 对象,极易使解释器内存暴增数倍。
- 特异场景分支:pyxlsb(仅针对 .xlsb 二进制文件)。如果原始文件能保存为 Excel 二进制工作簿(
.xlsb),pyxlsb 速度十分优异;但 calamine 同样原生支持读取.xlsb,在通用性和绝对速度上依旧占优。
| 解析库 / 引擎组合 | 底层实现语言 | 读取速度级别 | 内存消耗特征 | 适用数据格式 | 安装依赖 |
|---|---|---|---|---|---|
| Polars (engine="calamine") | Rust (C-ABI) | 极快(基准耗时的 8%~15%) | 极低,直接构建 Arrow 列式缓存 | .xlsx, .xlsb, .xls, .ods | polars, fastexcel 或 python-calamine |
| Pandas (engine="calamine") | Rust / C-ABI | 极快(基准耗时的 10%~20%) | 较低,跳过中间大量 Python 对象 | .xlsx, .xlsb, .xls, .ods | pandas >= 2.0, python-calamine |
| openpyxl (read_only=True) | 纯 Python | 中等偏慢(耗时为基准的 60%) | 中等,流式生成器逐行释放 | .xlsx | openpyxl |
| Pandas 默认 (openpyxl DOM) | 纯 Python | 极慢(耗时 100%,耗时最长) | 极高,内存容易放大 5~10 倍 | .xlsx | openpyxl |
| pyxlsb | 纯 Python | 较快(仅限特定格式) | 较低,解析二进制记录流 | 仅限 .xlsb | pyxlsb |
二、为什么传统 openpyxl 慢?.xlsx 物理结构与解析瓶颈剖析
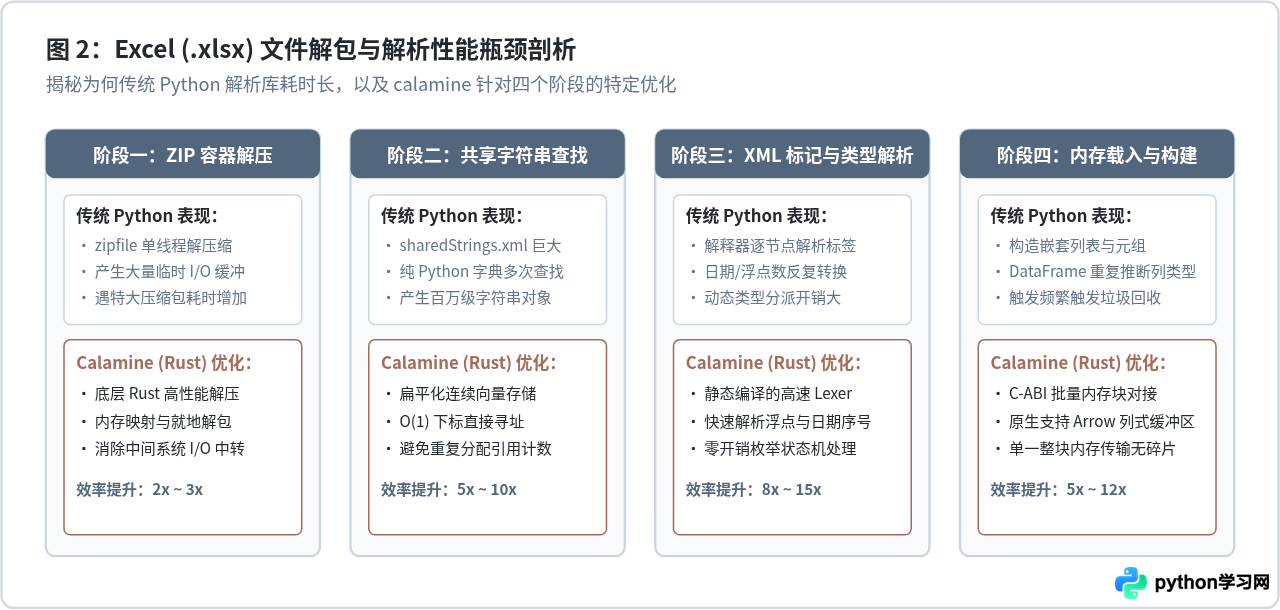
为了理解为什么基于 Rust 的 calamine 能够获得数倍以上的性能飞跃,有必要理清 .xlsx 文件的内部构造。日常见到的 .xlsx 并非扁平的文本,其本质是一个使用 ZIP 压缩的标准 Office Open XML 归档容器包。把一个 .xlsx 文件后缀改为 .zip 并解压后,会看到一系列由 XML 文件构成的树形目录:
xl/sharedStrings.xml:共享字符串表。为了节省磁盘体积,Excel 会把整张工作表内所有出现的文本提取到一个统一的全局字符串池中。工作表内部只存储该字符串在池中的数字索引 ID。xl/worksheets/sheet1.xml:存放具体的单元格行列坐标(如<c r="A1" t="s"><v>0</v></c>)。
在解析大型表格时,纯 Python 编写的解析器面临着严重的固有瓶颈:
1. 频繁的 XML 节点遍历与字符串查找:当表格包含 50 万行、20 列时,总单元格数达到 1000 万个。Python 解释器必须在纯解释模式下对数以千万计的 XML 标签进行分词、属性抽取,并频繁在 sharedStrings 中回表检索对应的真实字符串。这类高密度的 CPU 运算在 Python 虚拟机中执行时开销巨大。
2. Python 对象的创建与内存碎片:Python 中一切皆对象。默认模式下的 openpyxl 会将每个单元格封装为一个 Cell 实例,包含行列号、数据类型、样式索引和值。每个 Python 对象的内存头及引用计数开销使得小对象累计占用内存急剧膨胀,不仅极易耗尽系统内存,还会引发 Python 垃圾回收机制(GC)的漫长停顿。
3. Calamine 的破局之道:calamine 是基于 Rust 语言实现的 Excel 只读引擎。它在底层利用静态编译的轻量级流式解析器处理 XML 和二进制 BIFF 数据,字符串以紧凑连续的内存切片(String Interning)存放。解析过程完全在原生内存中完成,只在最终阶段将成块数据通过 C-ABI 映射给 Python,彻底规避了解释器层面的海量小对象分配。
三、工程落地操作指南:从环境准备到极速读取
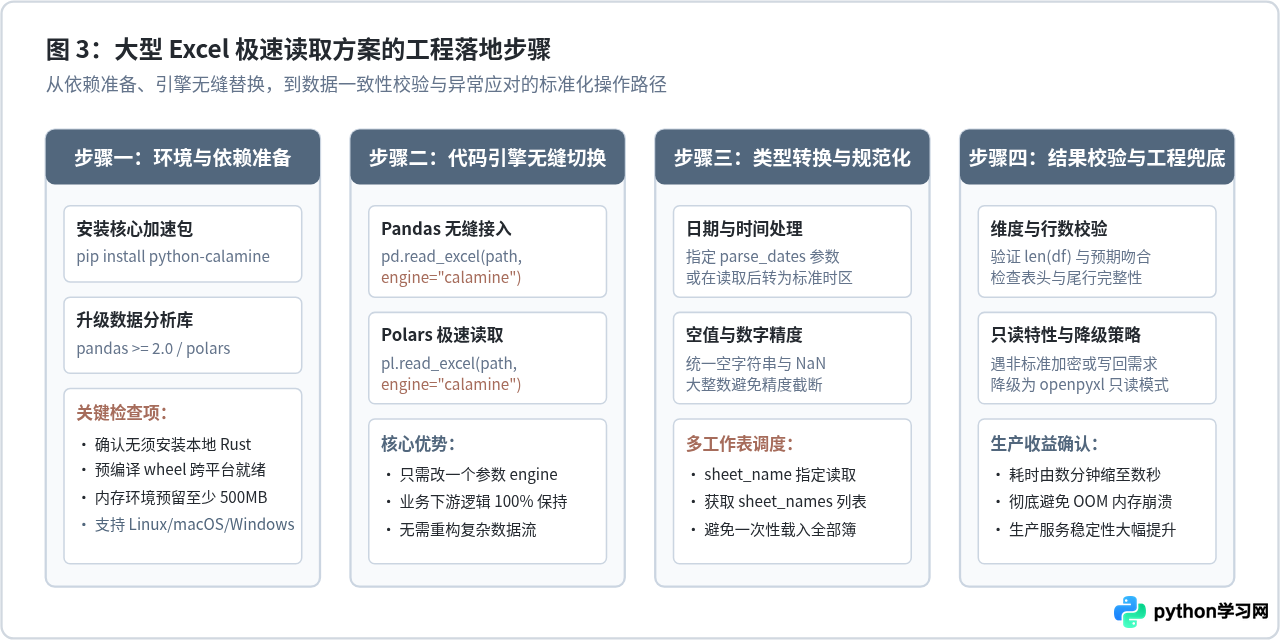
在实际生产项目中切换到最高速的 Excel 解析方案,并不需要颠覆原有的代码架构。通过合理配置引擎参数,几行代码即可完成改造。
1. 依赖安装与版本要求
Pandas 从 2.0 版本开始正式内置对 calamine 引擎的支持。在终端中执行以下命令安装所需依赖:
# 基础加速引擎:python-calamine(支持跨平台预编译二进制轮子,无需自行安装 Rust 编译器)
pip install --upgrade python-calamine

# 推荐同时安装或升级 Pandas 和 Polars
pip install --upgrade pandas polars
2. 在 Pandas 中极速读取(无缝改造现有项目)
如果现有代码重度依赖 Pandas,只需在调用 pd.read_excel() 时增加 engine="calamine" 参数。下游的所有 DataFrame 操作无需任何改动:
import pandas as pd

# 显式指定 engine="calamine"
df = pd.read_excel(
    "large_dataset.xlsx",
    sheet_name="Sheet1",
    engine="calamine"
)

# 查看数据规模与前 5 行
print(f"已成功载入数据:{len(df)} 行,{len(df.columns)} 列")
print(df.head())
3. 在 Polars 中极速读取(获取极致吞吐量)
Polars 是现代列式数据处理库,其原生内存模型基于 Apache Arrow。当与 calamine 结合时,它能在极低内存占用的情况下以极短时间载入大型表格:
import polars as pl

# Polars 通过内置引擎对接,性能达到极致
df_polars = pl.read_excel(
    "large_dataset.xlsx",
    sheet_name="Sheet1",
    engine="calamine"
)

print(df_polars.shape)
print(df_polars.head(5))
4. 内存极度受限时的纯流式逐行处理
如果机器内存仅有 1GB 至 2GB,而文件达到数百万单元格,即便构建 DataFrame 也可能超出限制。此时可以直接使用 python-calamine 的原生迭代器,以极低内存占用逐行提取数据:
from python_calamine import CalamineWorkbook

# 打开工作簿
workbook = CalamineWorkbook.from_path("large_dataset.xlsx")

# 获取指定工作表的数据载入层
sheet = workbook.get_sheet_by_name("Sheet1")
rows_iter = sheet.to_python()

# 提取第一行为表头
headers = next(rows_iter)

# 流式遍历处理,内存始终保持在几兆字节的极低水位
for row in rows_iter:
    # 在此处执行逐行入库或条件过滤逻辑
pass1. 只读限制:calamine 是纯粹的只读(Read-Only)库。它不支持修改单元格、更新公式、添加图表或写回 .xlsx。如果后续流程需要保留 Excel 样式写回,则必须使用 openpyxl 或 XlsxWriter。
2. 公式单元格的求值结果:calamine 读取公式单元格时,获取的是该单元格在 Excel 最近一次保存时缓存的计算结果(Cached Value)。如果该文件由某些第三方脚本直接生成且未执行公式计算,则单元格可能返回空值。
3. 日期时间解析格式:Excel 内部的日期是以 1899-12-30 起始的浮点序列数存储的。calamine 会自动根据单元格的数值格式样式(Number Format)识别日期;在 Pandas 中使用时,若遇到特殊自定义日期格式,建议配合 parse_dates 参数或调用 pd.to_datetime() 明确格式化。
四、技术选型决策与总结
结合文件规模、处理目的和上下游系统,选用最适配的工具能有效解决大型 Excel 的读取性能痛点:
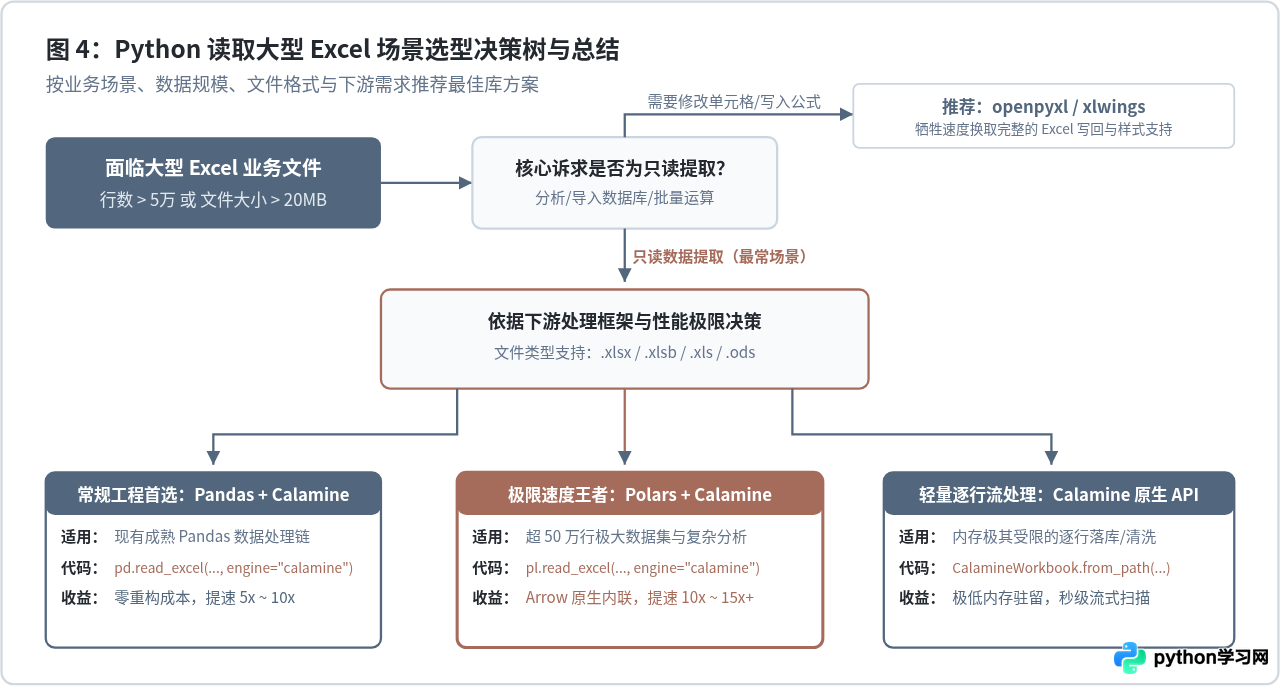
总结选型要点:
- 追求最快速度与最低重构成本:安装
python-calamine,在现有 Pandas 代码中传入engine="calamine",这是性价比最高的改进方案。 - 超大规模分析与极致吞吐:采用
Polars + calamine,借助 Rust 与 Arrow 内存架构获得全方位的计算加速。 - 超低内存逐行 ETL 扫描:使用
python-calamine原生 API 遍历行流,避免实例化 DataFrame。 - 需写入或带有高级样式操作:只能继续使用
openpyxl(配合read_only=True尽量降低内存压力)。 - 架构层面的终极优化:如果数据规模长期在百万行级别,建议在数据落盘初期即选用 Parquet 或 CSV / SQLite 格式,从源头避免将办公电子表格用作海量数据仓库。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















