


Python Fabric与Paramiko对比:哪种更适合批量远程执行Shell命令?
深度对比Python生态中Fabric与Paramiko在批量远程执行Shell命令时的架构层级、开发效率、并发机制与适用边界,提供清晰的选型决策依据。
ThreadingGroup 与 SerialGroup)以及高层的执行抽象。使用 Fabric 可以省去自行编写多线程连接池、管理标准输入输出管道缓冲以及捕获多节点异常的沉重模板代码。
一、定位与技术分层关系
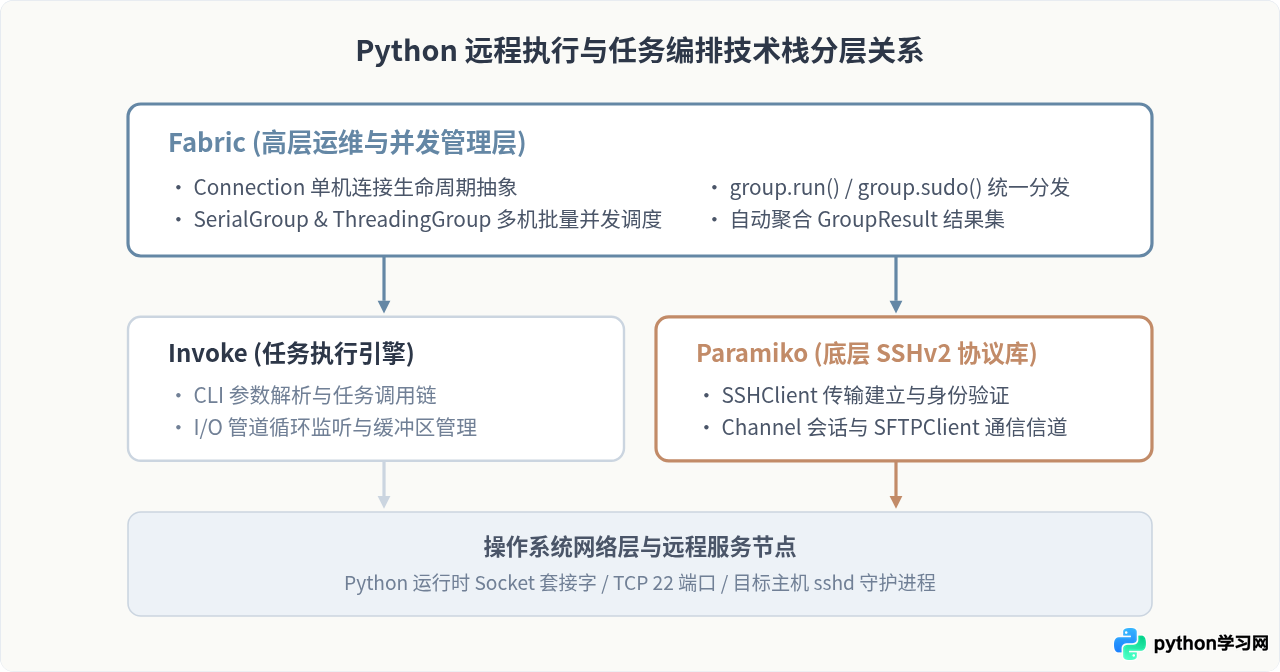
许多开发者在面对自动化运维任务时,常把 Fabric 与 Paramiko 视为相互竞争的平级替代方案,这其实是对 Python SSH 生态层次结构的误解。两者并不是同层竞争关系,而是典型的上下层封装与依赖关系。
Paramiko 是纯 Python 实现的 SSHv2 协议底层客户端库。它精确映射了 RFC 4251 等 SSH 规范,核心对象是 SSHClient、Transport、Channel 和 SFTPClient。Paramiko 的职责是与单台目标主机建立安全 Socket 连接、协商加密套件、处理身份认证并打开传输信道。由于紧贴协议底层,它不负责多台主机的协同运行,也不关心任务工作流的编排。
Fabric 则是面向应用场景的高级自动化工具包。在现代版本(Fabric 2.x/3.x)中,整个架构由两大部分支撑:底层的 SSH 协议交互完全委托给 Paramiko,而本地/远程命令执行的上下文环境与任务管理机制则基于 Invoke 框架。Fabric 在两者之上抽象出了 Connection(单机连接)与 Group(多机组),使开发者可以直接面向“一组服务器”声明并执行 Shell 指令。
二、批量执行的代码实现与开发成本对比
为了直观评估两者在批量命令执行上的差异,我们来看一个经典场景:需要向三台独立的应用服务器并发下发 uptime 命令,并收集各个节点的执行状态、标准输出以及退出状态码。
1. 使用 Paramiko 实现批量远程执行
Paramiko 的 SSHClient 本质上是单会话阻塞客户端。如果要实现批量并发,开发者必须自行引入多线程池(例如 ThreadPoolExecutor),并手动管理连接生命周期与流读取:
import concurrent.futures
import paramiko

hosts = ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
username = "deploy"
key_path = "/home/deploy/.ssh/id_rsa"
command = "uptime"

def run_on_host(host):
    client = paramiko.SSHClient()
    client.set_missing_host_key_policy(paramiko.AutoAddPolicy())
    try:
        client.connect(hostname=host, username=username, key_filename=key_path, timeout=5)
        stdin, stdout, stderr = client.exec_command(command)
        out_msg = stdout.read().decode('utf-8').strip()
        err_msg = stderr.read().decode('utf-8').strip()
        exit_code = stdout.channel.recv_exit_status()
        return host, exit_code, out_msg, err_msg
    except Exception as e:
        return host, -1, "", str(e)
    finally:
        client.close()

# 需自行调度并发线程池
results = {}
with concurrent.futures.ThreadPoolExecutor(max_workers=len(hosts)) as executor:
    futures = {executor.submit(run_on_host, h): h for h in hosts}
    for future in concurrent.futures.as_completed(futures):
        host, code, out, err = future.result()
        results[host] = {"code": code, "stdout": out, "stderr": err}
2. 使用 Fabric 实现批量远程执行
在 Fabric 中,执行相同的多节点并发逻辑只需使用内置的 ThreadingGroup。不仅代码量减少了近三分之二,而且不需要维护任何底层的线程和 Socket 清理细节:
from fabric import ThreadingGroup

hosts = ["192.168.1.101", "192.168.1.102", "192.168.1.103"]
group = ThreadingGroup(
    *hosts,
    user="deploy",
    connect_kwargs={"key_filename": "/home/deploy/.ssh/id_rsa", "timeout": 5}
)

# 一行命令完成全部节点的并发下发与结果收集
results = group.run("uptime", hide=True, warn=True)

# 统一解析 GroupResult 字典
for connection, result in results.items():
    print(f"主机 [{connection.host}] 状态: {result.exited}, 输出: {result.stdout.strip()}")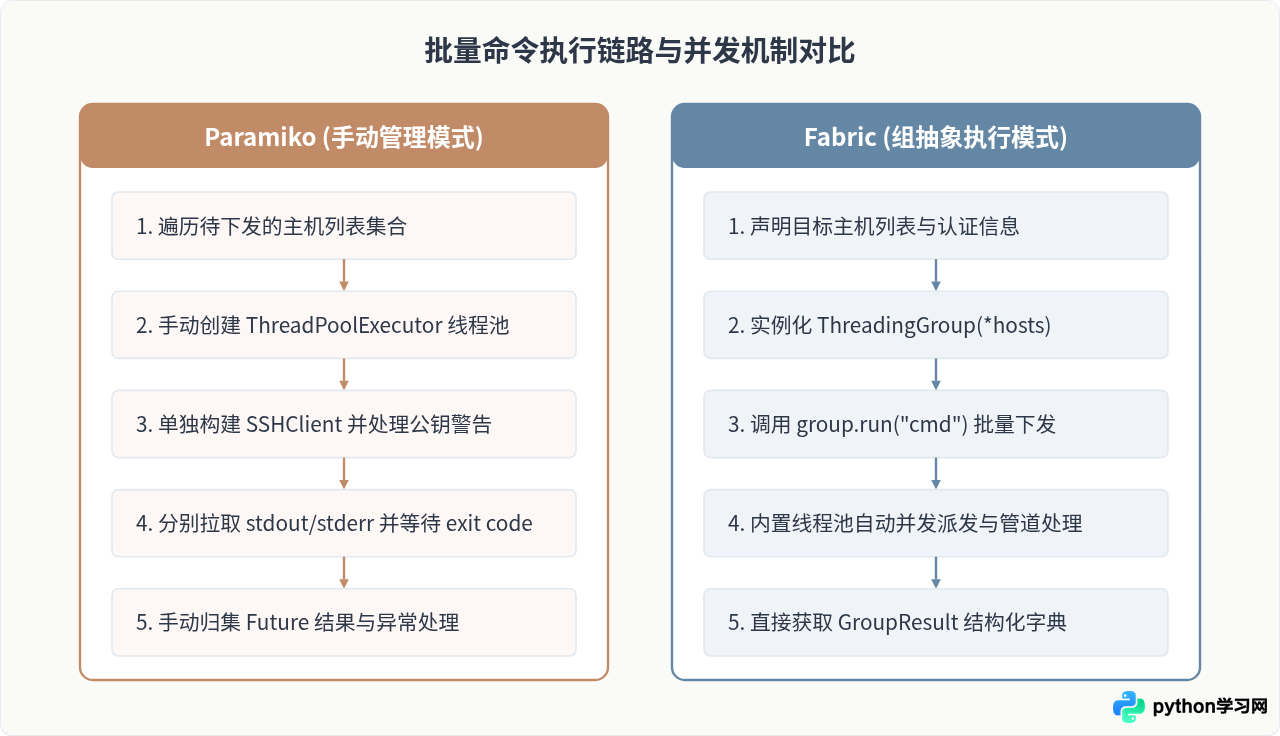
三、并发管理、管道死锁与异常控制的深度差异
除了表面的代码简洁度之外,Fabric 之所以更适合批量执行,核心在于它在内部解决了 Paramiko 原生使用中极易踩中的工程隐患。
1. 管道缓冲区死锁问题 (Pipe Buffer Deadlock)
在 Paramiko 中执行 client.exec_command() 时,库底层会为远程进程的 stdin、stdout、stderr 各分配一个 OS 级管道。如果远程命令输出了大量日志(例如超过 4KB 或 64KB,取决于系统管道限制),而开发者采用同步先读 stdout、再读 stderr 的常见写法,当远程进程同时向 stderr 写入大量数据导致管道缓冲区填满时,进程就会陷入挂起等待,导致 Python 主线程在读取 stdout 时永久死锁。
Fabric 由于继承了 Invoke 的流监听引擎,内部拥有健全的非阻塞轮询与缓冲区自动消费循环,能够保证输出日志即使非常庞大也不会发生阻塞挂起。
2. 异常隔离与多节点容错控制
在集群批量执行中,单台节点的故障(如因网络抖动超时、权限不足报错等)绝不能粗暴阻断其余正常主机的执行过程:
- Paramiko:需要开发者在线程函数内部自行设计精密的
try...except分支,否则单个异常未捕获可能导致线程异常退出、连接句柄无法释放。 - Fabric:通过参数
warn=True,Fabric 会自动抑制非零退出码引发的UnexpectedExit异常,并将失败主机与成功主机全部保存在返回的GroupResult实例中,开发者可以通过result.failed或result.exited轻松过滤故障节点。
四、基于 Fabric 实现批量远程执行的核心开发步骤
在实际生产中,使用 Fabric 进行批量远程 Shell 执行通常遵循标准化的四步工作流:
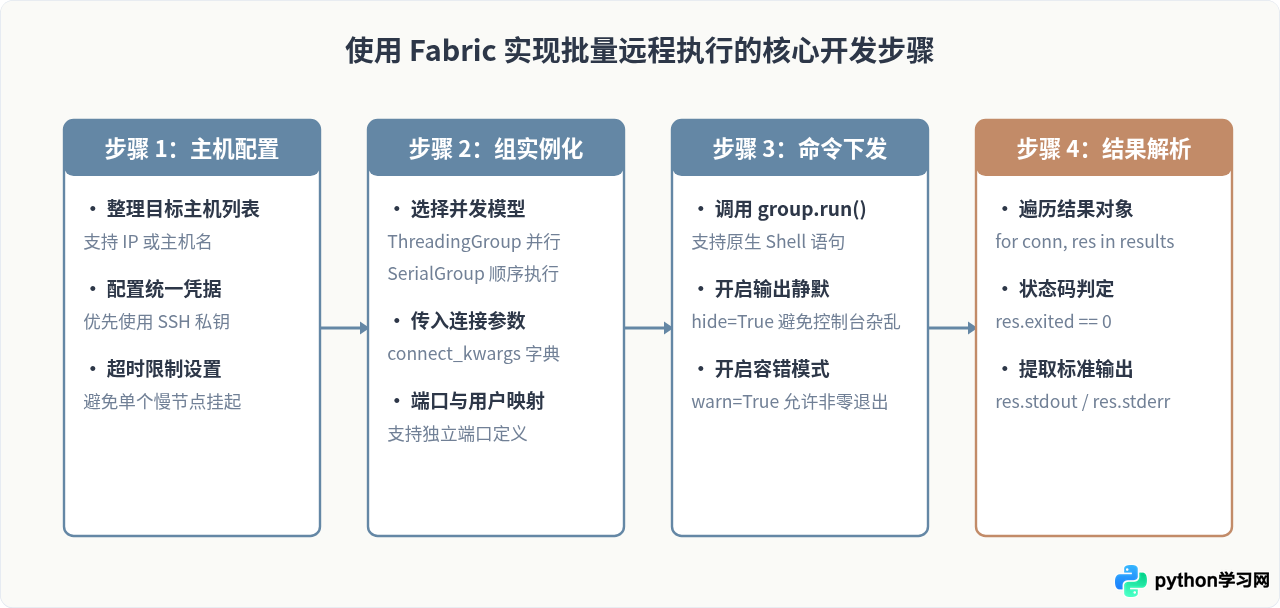
下面是一个符合生产级规范的完整范例,展示了如何使用 ThreadingGroup 批量检查主机磁盘根目录使用率:
from fabric import ThreadingGroup
from invoke.exceptions import GroupException

target_nodes = ["node01.infra.local", "node02.infra.local", "node03.infra.local"]

# 步骤 1 & 2:初始化并发组与凭据
group = ThreadingGroup(
    *target_nodes,
    user="ops",
    connect_kwargs={
        "key_filename": "/etc/ops/id_rsa",
        "timeout": 10
    }
)

# 步骤 3:下发命令并收集结果
check_cmd = "df -h / | awk 'NR==2 {print $5}'"
try:
    results = group.run(check_cmd, hide=True, warn=True)
except GroupException as ge:
    print(f"部分节点连接发生严重通信失败: {ge}")
    results = ge.result

# 步骤 4:结构化解析
for conn, res in results.items():
    host_ip = conn.host
    if res.exited == 0:
        usage = res.stdout.strip()
        print(f"[OK] 主机 {host_ip}: 根目录占用率 {usage}")
    else:
        err = res.stderr.strip()
print(f"[ERROR] 主机 {host_ip}: 命令执行失败 (退出码 {res.exited}): {err}")注意:如果操作任务有严格的前后依赖(例如分布式数据库的主从按序升级),请将 ThreadingGroup 替换为 SerialGroup。两者的 API 完全一致,但 SerialGroup 会按照传入的主机顺序严格串行执行,确保前一节点成功后再执行下一节点。
五、综合对比与技术选型边界
虽然在批量远程执行命令这一核心问题上 Fabric 占有明显优势,但并不代表 Paramiko 没有使用场景。两者的技术选型界限非常明确:
| 评估维度 | Fabric | Paramiko |
|---|---|---|
| 核心定位 | 批量多机运维与自动化任务框架 | 底层的 SSHv2 协议纯实现库 |
| 批量执行能力 | 原生内置(ThreadingGroup / SerialGroup) |
无内置支持,需自行编写线程池/进程池调度 |
| 开发代码量 | 极少(通常几行到十几行完成分发与汇总) | 较多(需处理连接建立、认证、信道读取及关闭) |
| 管道与 I/O 稳健性 | 内置 Invoke 事件循环,自动避免管道死锁 | 需开发者自行避免大输出缓冲导致的管道死锁 |
| 控制粒度 | 高层操作抽象,隐藏底层网络连接细节 | 可精准操控底层 Socket、密钥交换、通道多路复用 |
| 外部依赖项 | 依赖 Paramiko、Invoke、cryptography 等 | 主要依赖 cryptography,无上层框架包 |
| 最佳适用场景 | 集群巡检、批量部署、配置变更、跨节点命令分发 | 自定义 SSH 服务器、端口转发隧道、特殊底层安全协议审计 |
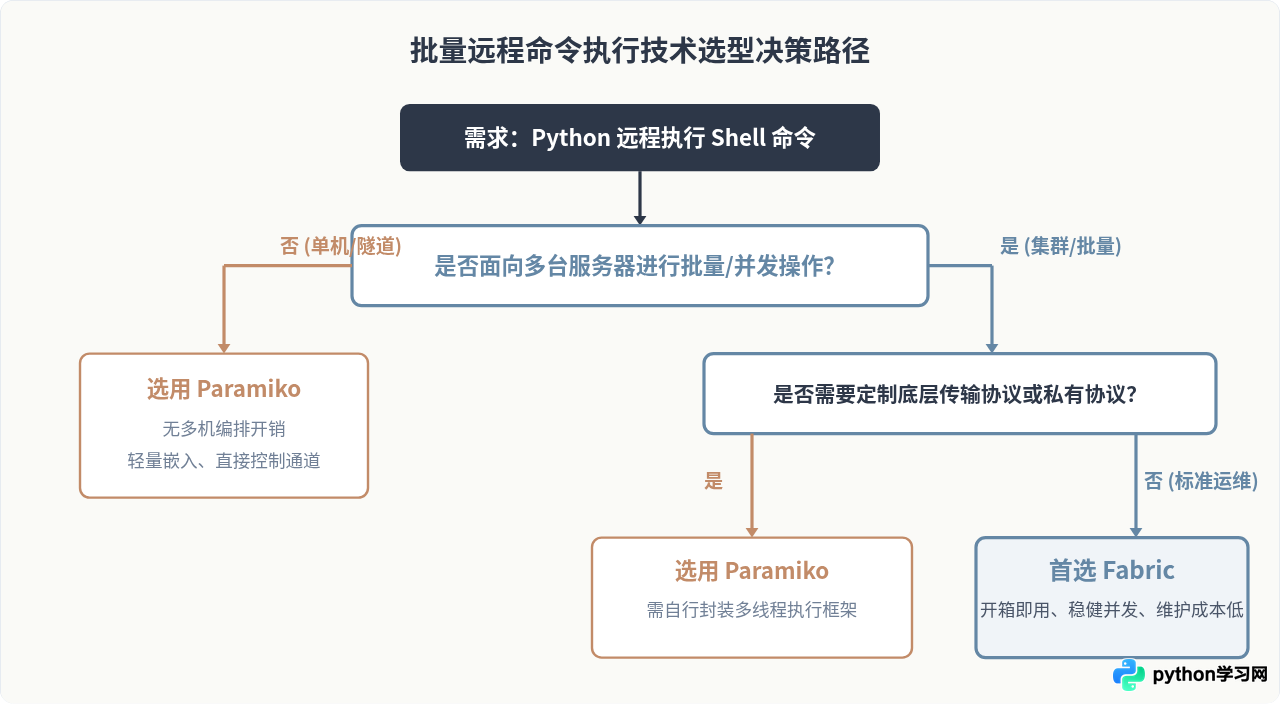
综上所述,当你的业务目标是对多台服务器批量执行 Shell 脚本、抓取运行指标、执行日常运维升级或分发配置时,Fabric 是性价比最高且工程隐患最少的方案。它在底层依赖 Paramiko 保证协议兼容性的同时,在上层消除了所有的并发模板代码与管道阻塞隐患,让代码更健壮、更易读且更易于维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















