


Python新手入门爬虫:先学BeautifulSoup还是直接上Scrapy?
针对Python爬虫初学者,深度对比BeautifulSoup与Scrapy的核心机制、适用场景、学习曲线与工程复杂度,提供清晰明确的技术选型决策与进阶成长路径。
面对网络上海量的数据采集需求,许多刚学完 Python 语法的初学者常在这个问题前犹豫不决:是一步到位直接攻克名气响亮的 Scrapy 框架,还是先从看似朴素的 Requests + BeautifulSoup 组合起步?本文将从运行原理、代码开发体验、适用边界与学习曲线四个维度,为你梳理出清晰明确的答案。
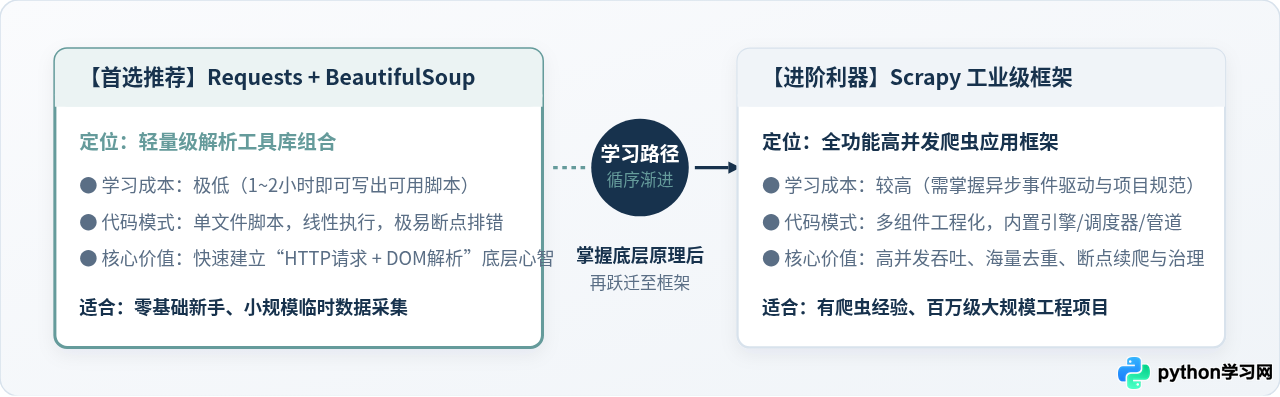
明确结论:对于绝大多数新手,强烈建议先学 Requests + BeautifulSoup,切忌“一步到位”直接上 Scrapy。
爬虫最核心的底层逻辑是 “发起网络请求” 与 “文档节点解析”。BeautifulSoup 配合 requests 可以在单文件、几十行代码内完成完整的数据闭环,让你在极低的心智负担下看清 HTTP 交互与 DOM 树的本质;而 Scrapy 是一套包含并发引擎、请求调度器、管道持久化与中间件体系的工业级重型框架。如果跳过基础原理直接硬啃 Scrapy,新手不仅容易被复杂的项目目录、异步机制与命令行工具绕晕,一旦遇到抓取失败更难以排查是网络问题、选择器错误还是框架调度问题,极易产生挫败感。
一、本质差异:脚本解析库 vs 工业级爬虫框架
很多初学者之所以在两者的选择上产生困惑,根本原因是没有分清“解析工具库”与“应用开发框架”在职责边界上的天壤之别。
1. BeautifulSoup 到底是什么?
严格来说,BeautifulSoup 并不是一个“爬虫框架”,它甚至完全不具备网络通信的能力。
BeautifulSoup 仅仅是一个HTML/XML 文档解析器。在实际爬虫开发中,它必须与网络请求库(通常是 requests 或内置的 urllib)协同工作:由 requests 负责把网页的 HTML 源码通过网络接口“拉取”到本地内存,再由 BeautifulSoup 将这段纯文本字符串解析成一棵树状结构的 DOM 节点树,供你使用 find()、find_all() 或 CSS 选择器轻松抽取其中的文本和属性。
2. Scrapy 到底是什么?
Scrapy 是一个端到端的高性能网络爬虫应用框架。它不是一个单独的函数库,而是一整套完备的软件工程体系。
Scrapy 内部自带了基于 Twisted(或 asyncio)的非阻塞异步网络下载器、优先级请求队列与 URL 指纹去重调度器、专用的数据项模型(Item)、数据清洗持久化管道(Item Pipeline)以及针对请求与响应的切面扩展(Downloader/Spider Middlewares)。只要你按照它的规约编写代码,框架引擎会自动接管多任务并发调度、错误重试和管道分发。
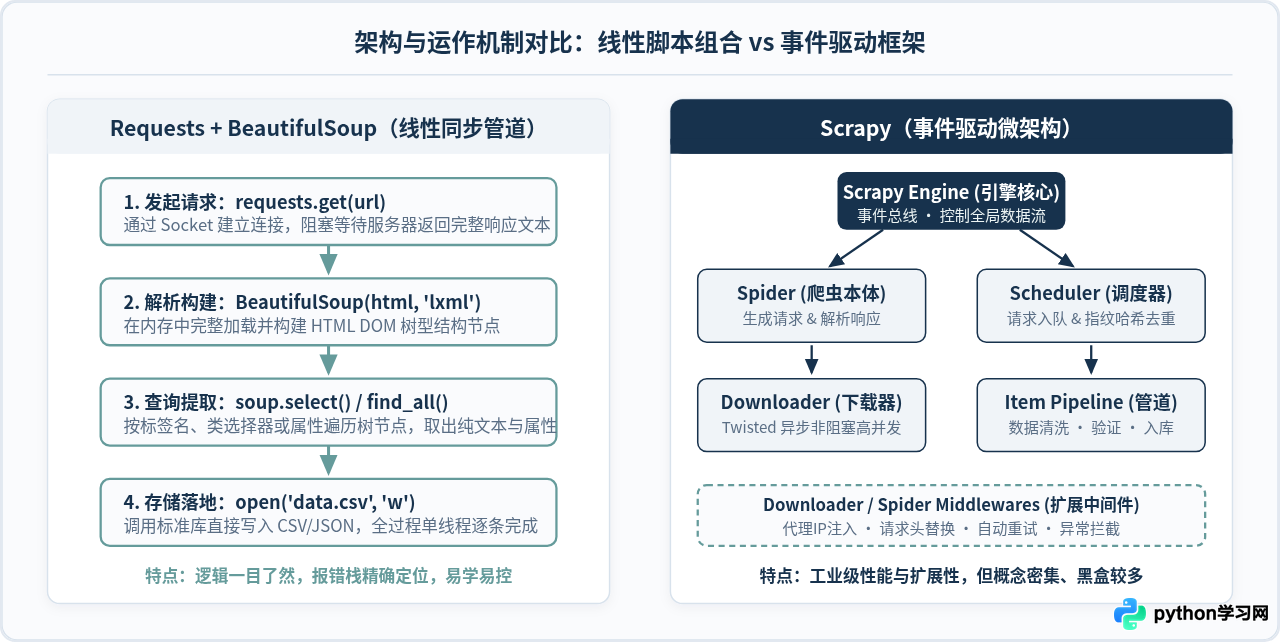
从图 1 可以直观看出:Requests + BeautifulSoup 是一条清晰见底的单行道,哪里报错就在哪里停下,代码完全按照人类直觉顺序执行;而 Scrapy 是一个由中心引擎统一协调的交通枢纽,组件之间高度解耦、异步流转,具备强大的工业吞吐量,但对使用者的系统理解要求明显更高。
二、核心维度全面对比:新手视角下的权衡
为了帮助你根据个人背景和实际需求做出理性判断,我们将两者在新手关心的核心维度上进行了逐项拆解:
| 比较维度 | Requests + BeautifulSoup | Scrapy 工业级框架 | 对初学者的影响与建议 |
|---|---|---|---|
| 概念密度与上手门槛 | 极低:仅需掌握函数调用、常用标签查找和属性获取,1 小时即可写出可用脚本。 | 较高:需要理解生成器(yield)、Twisted 异步回调、Settings 配置项及目录规约。 | 新手应先通过简单工具树立信心,避免一开始被过多抽象概念劝退。 |
| 工程与代码形态 | 极简:一个独立 .py 文件即可跑通整个采集任务。 |
工程化:脚手架强制生成 6 个以上配置文件与模块,需多文件协同。 | 轻量级任务用脚本更灵活;多人协作和大型项目才需要 Scrapy 的规范目录。 |
| 排错与调试体验 | 直观透明:随时使用 print() 或 VS Code 断点调试,调用栈清晰。 |
相对黑盒:异步事件驱动导致断点跳转复杂,日志量大,需熟悉内置 Shell。 | 初学者写爬虫 70% 的时间在排错,直观的调试机制至关重要。 |
| 网络性能与并发 | 单线程同步阻塞:按顺序逐页请求,速度较慢(可通过多线程库补充)。 | 原生高并发:异步非阻塞机制,吞吐量轻松达到每秒数十甚至上百页。 | 个人小规模抓取(千页以内)完全不需要极高并发,反而更容易触发反爬封锁。 |
| 海量数据与去重 | 无内置机制:需要开发者自己手动维护 Set 集合或数据库主键过滤。 | 内置指纹去重:调度器自动对 URL 进行哈希去重,支持断点续爬。 | 全站深度多层爬取时,Scrapy 的自动化调度能够节省大量底层造轮子时间。 |
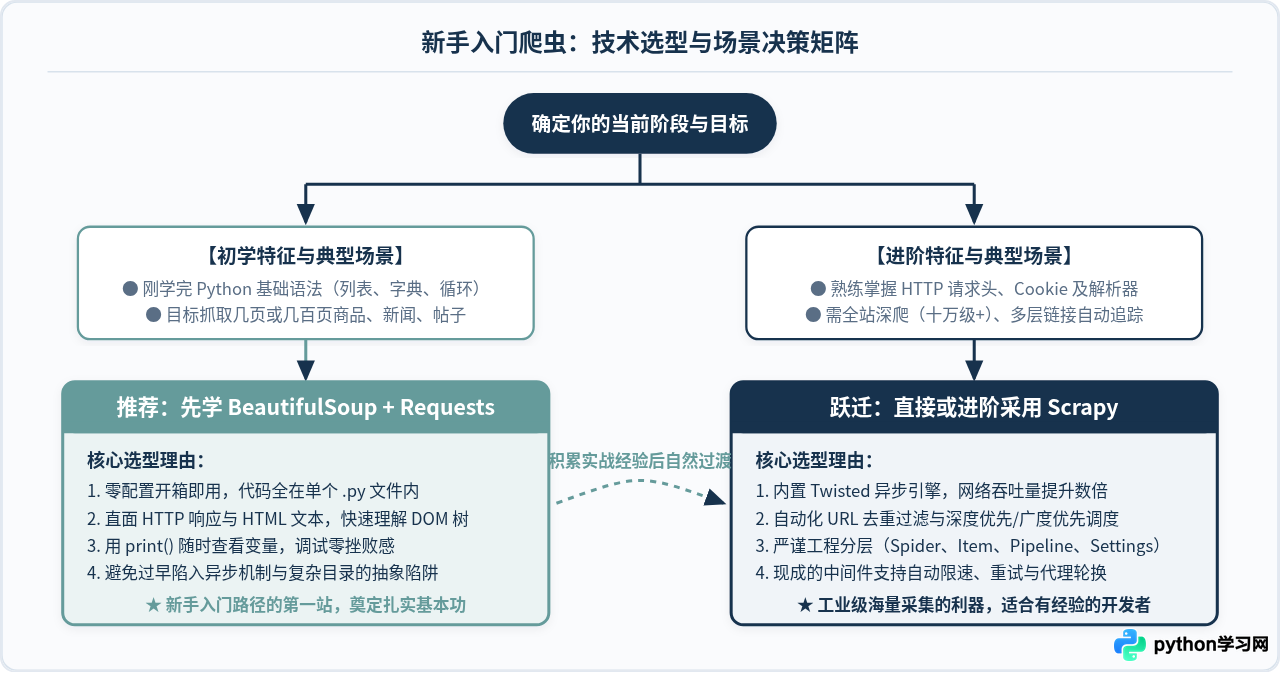
结合图 2 的决策逻辑,你可以非常清晰地自我对照:
- 如果你处于 Python 基础语法的巩固期,目标是爬取几页新闻、抓几百篇论文摘要、提取几十张图片,请毫不犹豫选择 Requests + BeautifulSoup。
- 只有当你已经 透彻理解了 HTTP 请求头、DOM 选择器逻辑,且面临 数十万级页面深爬、自动化分布式存储或复杂重试机制 时,直接引入 Scrapy 才是最经济的投资。
三、实战对比:抓取相同数据的代码与开发流程
“感受差异的最好方式就是看代码。”下面我们以抓取示例页面上的图书列表(获取标题与详情链接)为例,对比两种方式的具体编写过程。
1. 路径 A:Requests + BeautifulSoup 编写方式
你只需新建一个名为 books_bs4.py 的文件,输入以下完整代码即可运行:
pip install requests beautifulsoup4import requests
from bs4 import BeautifulSoup
# 1. 目标地址与请求头配置
url = "https://books.toscrape.com/"
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}
# 2. 发起网络请求获取 HTML 源码
response = requests.get(url, headers=headers, timeout=10)
response.encoding = response.apparent_encoding # 防止中文或特殊字符乱码
# 3. 传入 BeautifulSoup 进行 DOM 解析
soup = BeautifulSoup(response.text, "html.parser")
# 4. 使用 CSS 选择器定位书籍节点
book_nodes = soup.select("article.product_pod")
print(f"成功定位到 {len(book_nodes)} 本书籍,开始提取:")
for book in book_nodes:
title_tag = book.select_one("h3 > a")
price_tag = book.select_one(".price_color")
title = title_tag.get("title") or title_tag.text.strip()
link = title_tag.get("href")
price = price_tag.text.strip() if price_tag else "未知"
print(f"书名: {title} | 价格: {price} | 链接: {link}")$ python books_bs4.py
成功定位到 20 本书籍,开始提取:
书名: A Light in the Attic | 价格: £51.77 | 链接: catalogue/a-light-in-the-attic_1000/index.html
书名: Tipping the Velvet | 价格: £53.74 | 链接: catalogue/tipping-the-velvet_999/index.html
...(后续数据依次打印)
体验总结:全流程一共 20 余行代码,输入 python books_bs4.py 即刻看到结果。如果某个标签抓不到,你直接在循环里加一句 print(book.prettify()) 打印子节点结构,几秒钟就能找到问题。
2. 路径 B:Scrapy 规范工程编写方式
在 Scrapy 中,你不能直接写一个脚本运行,而必须先初始化标准工程脚手架。
第一步:创建项目脚手架pip install scrapy
scrapy startproject book_spider
cd book_spider
scrapy genspider book books.toscrape.com
此时磁盘上会自动生成一个完整的目录结构:包含 scrapy.cfg、book_spider/items.py、book_spider/pipelines.py、book_spider/settings.py 以及 book_spider/spiders/book.py。
import scrapy

class BookItem(scrapy.Item):
    title = scrapy.Field()
    price = scrapy.Field()
link = scrapy.Field()import scrapy
from book_spider.items import BookItem
class BookSpider(scrapy.Spider):
name = "book"
allowed_domains = ["books.toscrape.com"]
start_urls = ["https://books.toscrape.com/"]
def parse(self, response):
books = response.css("article.product_pod")
for book in books:
item = BookItem()
item["title"] = book.css("h3 a::attr(title)").get()
item["price"] = book.css(".price_color::text").get()
item["link"] = book.css("h3 a::attr(href)").get()
yield item
# 翻页追踪示例
next_page = response.css("li.next a::attr(href)").get()
if next_page:
yield response.follow(next_page, callback=self.parse)$ scrapy crawl book -o books.json
[scrapy.utils.log] INFO: Scrapy 2.11.0 started (bot: book_spider)
[scrapy.core.engine] INFO: Spider opened
[scrapy.core.engine] DEBUG: Crawled (200) <GET https://books.toscrape.com/>
[scrapy.core.scraper] DEBUG: Scraped from <200 https://books.toscrape.com/>
{'title': 'A Light in the Attic', 'price': '£51.77', 'link': 'catalogue/a-light-in-the-attic_1000/index.html'}
...
[scrapy.core.engine] INFO: Spider closed (finished)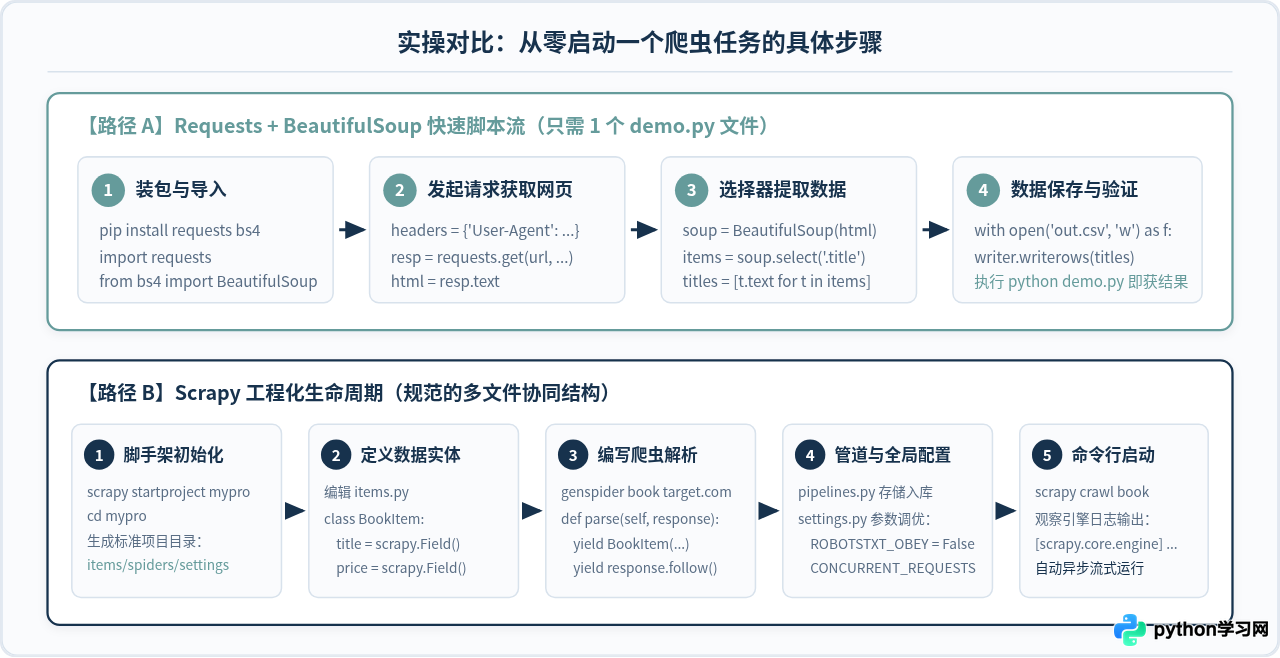
对比图 3 中的两种流派:Scrapy 的严谨性对于大型商业工程来说是一种保护(自动导出、规范数据模型、自动追踪下一页);但对于刚学习爬虫第一天的新手而言,为了抓 20 个标题,需要先在终端敲命令建项目,再在 3 个不同文件之间来回切换修改,一旦少写一个 yield 或者配错了 ROBOTSTXT_OBEY 导致请求被静默拦截,新手往往根本不知道从何查起。
四、常见困惑与初学者容易踩的 3 大误区
误区一:“学了 BeautifulSoup,以后学 Scrapy 是不是就浪费了?”
完全不会。网页数据提取的核心本质是DOM 节点的定位语法。BeautifulSoup 支持的 CSS 选择器规则(如 div.class > a[href]、标签层级遍历),与 Scrapy 内置 Selector(基于 parsel / lxml)所使用的语法一脉相承。你在 BeautifulSoup 中锻炼出的快速看懂网页 Elements 树状结构、找到唯一特征类名的能力,直接能无缝迁移到 Scrapy 的 XPath 和 CSS 选择器中。
误区二:“盲目崇拜高并发,刚学爬虫就想开几十个线程”
许多新手以为爬虫越快越牛,一上来就配置 Scrapy 的 32 个并发线程猛抓目标站,结果刚跑 5 秒就被服务器封禁了 IP。现代网站普遍具备频次限制与风控防御,工业级采集往往需要故意降低速率、设置随机延迟和轮换代理。新手先用 Requests 的单请求逐步调试,学会礼貌爬取和分析响应头中的频率提示,远比盲目追求并发更有价值。
误区三:“把页面抓取失败全部归咎于解析库”
很多初学者在群里提问:“为什么我的 BeautifulSoup 抓不到这个元素?”排查后发现,目标网页是基于 Vue/React 渲染的单页面应用(SPA),数据是通过后台异步 Ajax 请求动态获取的。不论是 BeautifulSoup 还是纯粹的 Scrapy,默认情况下都只下载初始 HTML,不会执行 JavaScript。搞懂“静态源码 vs 动态异步接口”的网络层差异,是每个新手必须通过 Requests 实战建立的常识。
五、什么时候该从 BeautifulSoup 跃迁到 Scrapy?
在充分掌握了 Requests + BeautifulSoup 后,当你遇到以下 4 个明确的现实瓶颈时,就是自然跃迁到 Scrapy 的最佳契机:
- 数据量级跃升至万级以上,单线程耗时不可接受:单靠 requests 串行抓取 10 万个页面可能需要几十小时,而 Scrapy 的异步非阻塞特性可以在几十分钟内高效完成网络 I/O 调度。
- 需要深层全站爬取与自动去重:面对电商、分类信息网站的多层嵌套链接(分类页 -> 列表页 -> 详情页 -> 评论页),手写 requests 队列和指纹去重代码繁重且易内存溢出,Scrapy 的
Scheduler和response.follow()提供了现成的健壮方案。 - 复杂的防反爬策略与管道分流:需要统一管理代理 IP 池、自动处理 403 随机指数退避重试、同时将数据清洗并异步写入 MySQL 和 Elasticsearch 时,Scrapy 的
Downloader Middleware和Item Pipeline能够提供高度解耦的工业级设计。 - 团队协作与工程维护标准:多人参与的商业数据采集项目,统一采用 Scrapy 的目录规范和命令行调度,能够大幅降低项目的沟通和维护成本。
六、爬虫开发者的进阶学习成长路线图
爬虫是一项融合了网络协议、数据解析、逆向工程与系统架构的综合技能。为了让你在学习过程中有章可循、不走弯路,建议遵循以下四个阶段循序渐进:
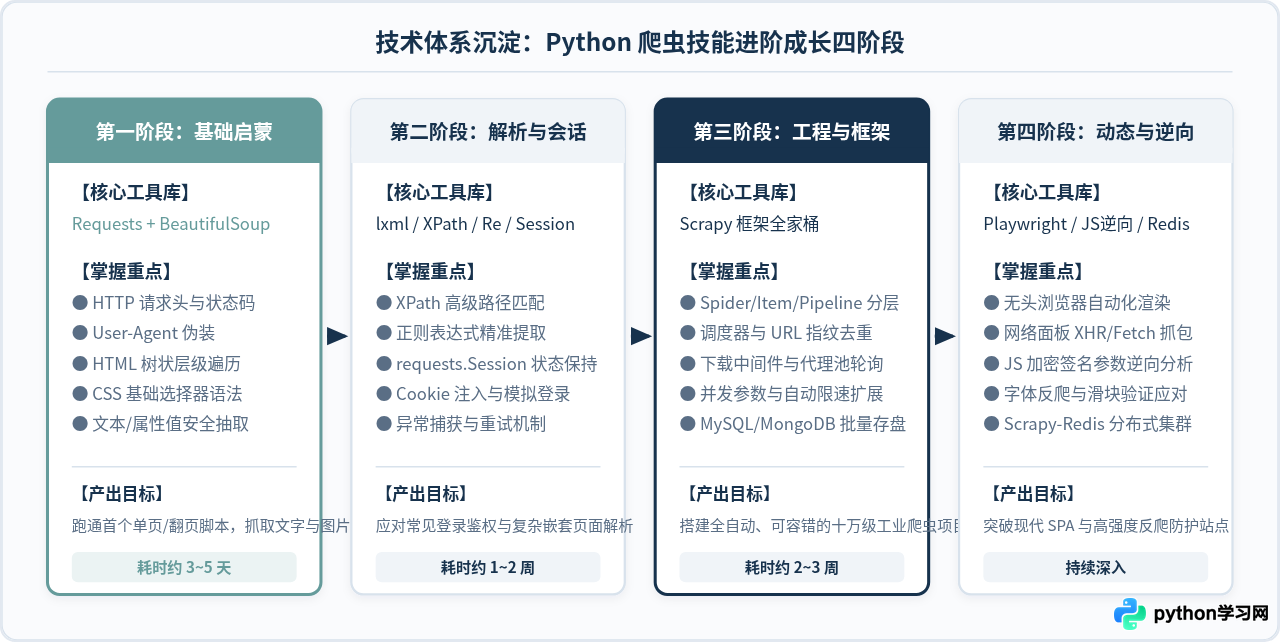
通过图 4 的进阶阶梯,我们可以清晰地给出一个执行清单:
- 第 1 阶段(基础启蒙):使用 Requests + BeautifulSoup,学会伪装 User-Agent,熟练使用浏览器 F12 开发者工具,跑通至少 3 个静态网页的翻页数据抓取与 CSV 文件存盘。
- 第 2 阶段(技巧深化):学习 lxml 与 XPath 语法,掌握
requests.Session处理登录状态维持与 Cookie 管理,理解异常处理(try-except与重试)。 - 第 3 阶段(工程进阶):系统学习 Scrapy 框架,掌握 Spiders、Pipelines、Downloader Middlewares 的协同,对接数据库实现规模化持久存储。
- 第 4 阶段(动态与逆向):针对现代重度前端渲染网站,学习 Playwright / Selenium 自动化无头浏览器,掌握抓包分析网络 XHR 接口及 JavaScript 加密参数的基础逆向。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















