


数据科学开发推荐使用哪个Python版本
在数据科学开发中,Python版本的选择直接决定了NumPy、PyTorch、SciPy等核心包的安装顺畅度与运行稳定性。本文深入分析数据科学底层Wheel编译生态,解析N-1/N-2法则,并给出精准的选择策略与环境隔离配置实操。
在普通的 Web 开发或自动化脚本编写中,开发者往往可以放心地紧跟 Python 官方的最新版本。但在数据科学、机器学习和深度学习领域,升级 Python 版本往往伴随着严重的依赖危机与不可预测的构建报错。很多初学者在安装了官网刚推出的最新版 Python 后,运行 pip install torch 或 pip install numpy 时,会遭遇冗长的编译日志甚至 error: command 'gcc' failed 报错,其根源就在于忽视了数据科学包的底层编译特殊性。
为什么数据科学不能“无脑追最新”:底层 Wheel 生态机制
理解数据科学对 Python 版本的严苛要求,首先需要了解 Python 库的分发机制。普通的纯 Python 库(如 Flask、Requests)代码全是以 .py 文本形式组织,解释器只需解析语法即可直接运行,因此几乎不受 CPython 内部底层修改的影响。
而数据科学核心库(包括 NumPy、SciPy、Pandas、PyTorch、Scikit-learn、Numba 等)完全不同。为了追求极速的矩阵运算与内存操作,它们的底层核心全部用 C、C++、Fortran 或 CUDA 编写,并针对特定的硬件架构(如 x86-64 的 AVX-512、Apple Silicon 的 NEON)进行了深度编译优化。
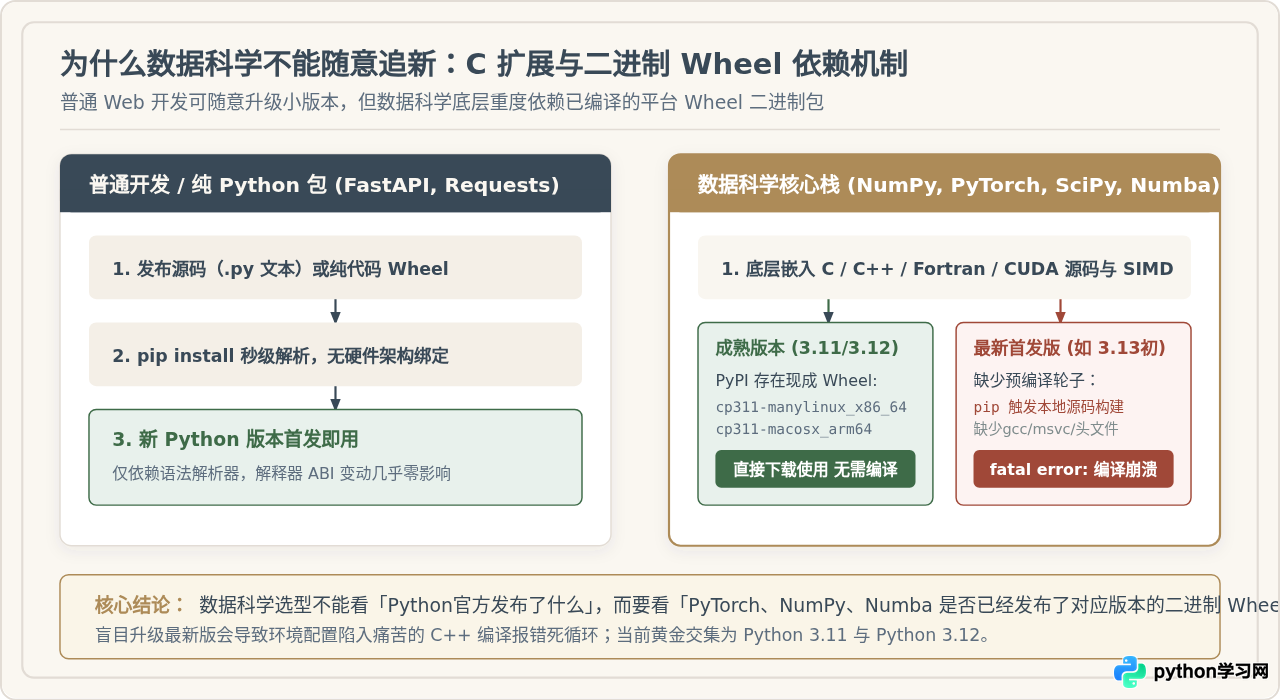
当我们在终端执行 pip install 时,理想状态是直接从 PyPI 下载预先编译好的二进制轮子(Wheel 文件,后缀为 .whl)。例如名为 numpy-1.26.4-cp311-cp311-manylinux_2_17_x86_64.whl 的文件,代表它专为 CPython 3.11 预编译。这种安装在数秒内即可完成解压就绪,无需开发者本地安装任何编译器。
然而,Python 官方每年发布一个次版本(如从 3.11 升级到 3.12,再到 3.13)时,其内部的 C-API 和应用二进制接口(ABI)往往会发生重大调整。这意味着开源社区维护者必须针对新的 ABI:
- 修改底层 C/C++ 代码以适配新的 API 变更;
- 搭建涵盖 Linux、macOS (Intel/Apple Silicon)、Windows 的庞大持续集成(CI)矩阵;
- 完成对 GPU 驱动(CUDA/ROCm)与底层加速库(MKL/OpenBLAS)的联调测试;
- 打包并上传对应的二进制 Wheel 文件至官方仓库。
整个链条的适配周期通常需要 6 个月至 1 年以上。只要你的算法工程所依赖的几十个间接依赖包中,有哪怕一个尚未发布对应版本的二进制 Wheel,pip 就会自动退回“源码编译模式”(Source Distribution, .tar.gz)。而在缺乏对应版本 C++ 编译器、CUDA Toolkit 或底层头文件的开发者电脑上,编译几乎注定失败。这就是数据科学工程界必须坚守“N-1 / N-2 原则”(落后最新大版本 1 到 2 代)的本质原因。
各主流 Python 版本横向深度对比
为了给实际项目选型提供严谨的参考依据,我们将当前活跃在生态中的主要版本进行多维度对照:
| Python 版本 | 发布与维护状态 | 预编译 Wheel 生态就绪度 | 算力与硬件加速支持 | 选型定级 |
|---|---|---|---|---|
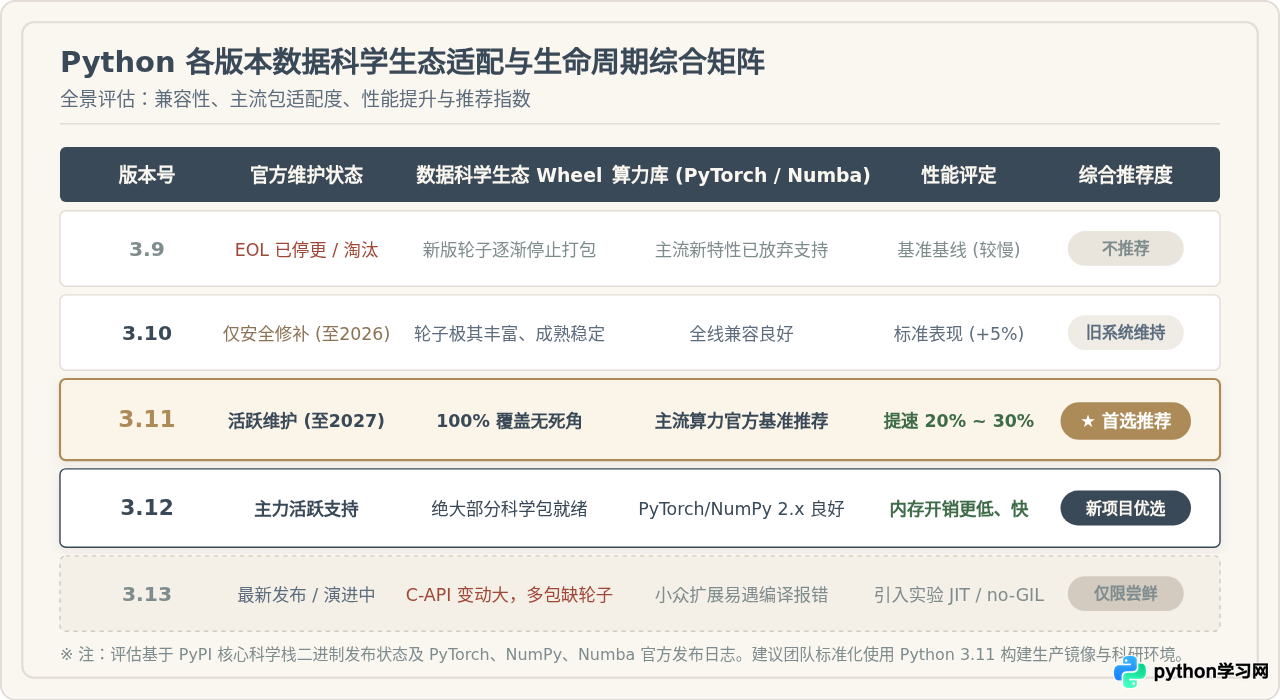
| Python 3.11 | 稳定维护期(支持至 2027 年) | 100% 全覆盖,生态最为健全成熟 | PyTorch、TensorFlow、JAX、CUDA 官方标配 | 黄金首选主力 |
| Python 3.12 | 主力活跃期(推荐现代项目) | 95% 覆盖,主流通用科学栈均已适配 | PyTorch 稳定适配;小众旧扩展偶有摩擦 | 新项目优选 |
| Python 3.10 | 仅安全修补期(2026年到期) | 全覆盖,但部分新算法库已不再提供新特性 | 良好,但无法享受 Faster CPython 加速 | 存量过渡维持 |
| Python 3.13 | 首发阶段(暂未成熟) | 严重欠缺,尤其是 Numba、PyTorch 插件层 | 引入实验性自由线程(no-GIL)与 JIT,尚未进入工业级 | 仅限实验尝鲜 |
| Python 3.9 及更早 | 已停止官方生命周期维护 | 新版 NumPy 2.x 等前沿包已明确放弃打包 | 不再获得现代 GPU 架构的驱动优化 | 坚决淘汰 |
1. 为什么 Python 3.11 是当前无可争议的黄金版本?
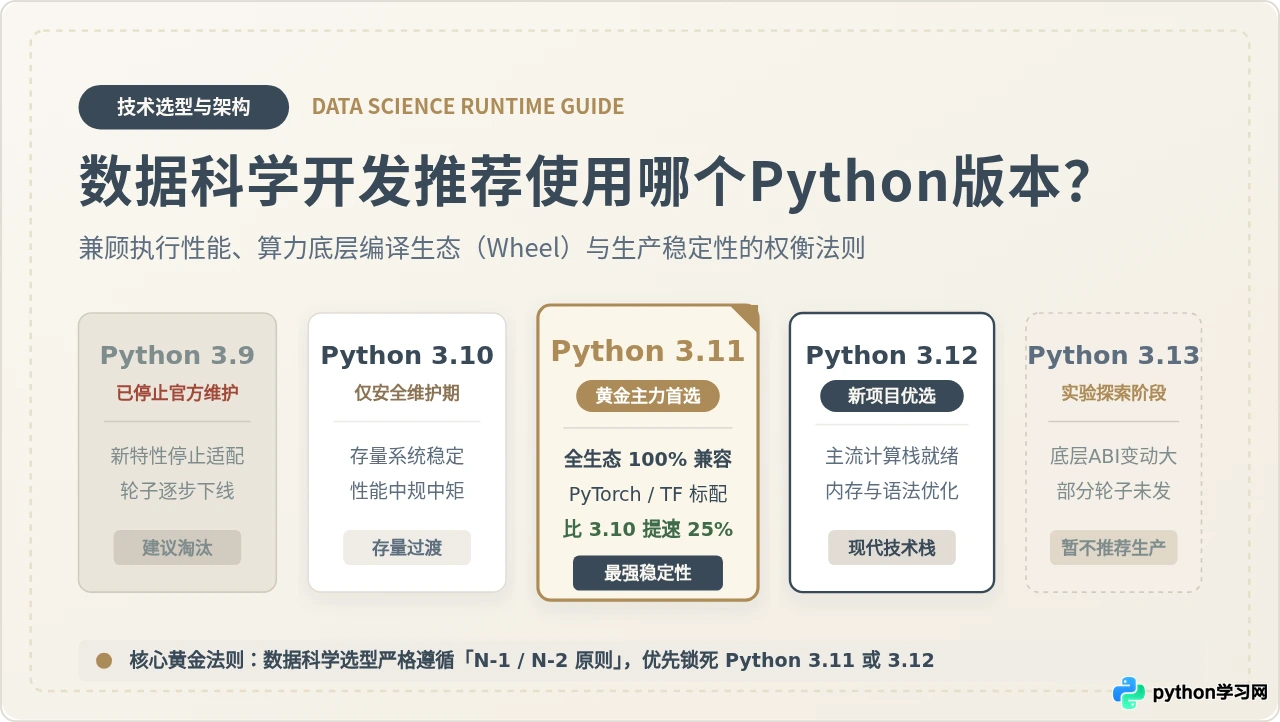
Python 3.11 是 Python 官方推进“Faster CPython”计划的首个里程碑版本。相较于 3.10,3.11 引入了自适应特化解释器(Adaptive Specializing Interpreter),在纯 Python 逻辑层实现了 10% 到 60%(平均 25%)的显著提速,同时改善了调用堆栈的错误高亮显示。
更为关键的是时间窗口:Python 3.11 经历了数年的社区打磨,目前 PyTorch、TensorFlow、Scikit-learn、Pandas、XGBoost、LightGBM、Numba 以及各类大模型推理加速框架(如 vLLM、Hugging Face Transformers)对其的支持率达到了 100%。在任何操作系统上配置 Python 3.11,都不会遇到 Wheel 缺失导致的编译障碍。
2. 什么时候应该选择 Python 3.12?
如果你的项目定位是现代数据清洗、ETL 处理、轻量化分析,主要使用 Polars、DuckDB、Pandas 2.x、FastAPI、SQLAlchemy 等现代栈,且不强依赖特定的冷门底层旧模型,那么 Python 3.12 是非常卓越的选择。
Python 3.12 拥有更加优雅的泛型与类型提示语法、更优异的内存控制,且主流科学栈已全面提供预编译 Wheel。但请注意:对于某些高度依赖 C-API 私有结构的 JIT 库(如某些版本的 Numba),需要先确认其发布的更新日志是否已正式支持 3.12。
精准场景决策树:如何针对具体项目选型
数据科学开发涵盖了从科研实验、工业流水线到商业 BI 的多样化场景。在具体立项时,建议参考以下决策逻辑快速定位:
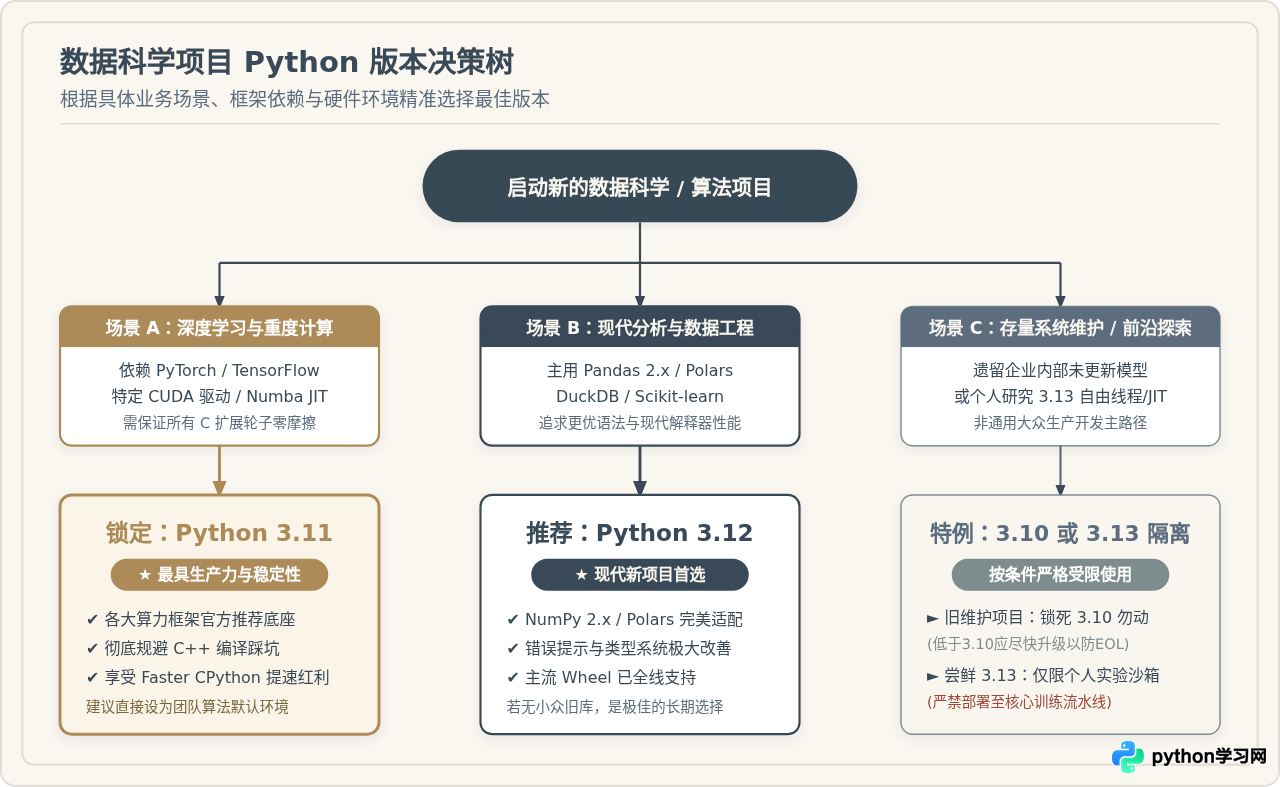
- 深度学习与 AI 大模型研发:优先选择 Python 3.11。PyTorch 社区的 CUDA 轮子打包更新节奏始终将 3.11 作为核心标配,能够最大化规避驱动层与算子库编译冲突。
- 商业智能(BI)、表格分析与现代数据管道:优先选择 Python 3.12。能够充分利用新解释器对现代纯计算库(如 Polars)的高效调度与更友好的报错提示。
- 既有老模型维护:若项目当前运行在 Python 3.10 且运行稳定,可继续维持;但若低于 3.10(如 3.8 或 3.9),应立即规划迁移升级至 3.11,避免依赖包由于 EOL 停止提供安全补丁。
- 个人学术研究 / 前沿 CPython 性能探索:如需探究无 GIL(自由线程)或 JIT 编译器的性能潜能,可单独创建 Python 3.13 试验沙箱,切勿将其用于团队公共仓库或生产交付。
从版本选型到环境落地的标准实操
选定 Python 版本后,切忌直接在操作系统全局环境中安装科学包。系统自带的 Python 往往被操作系统的内部工具所共享,直接污染全局环境会导致依赖版本冲突,甚至破坏系统工具的运行。
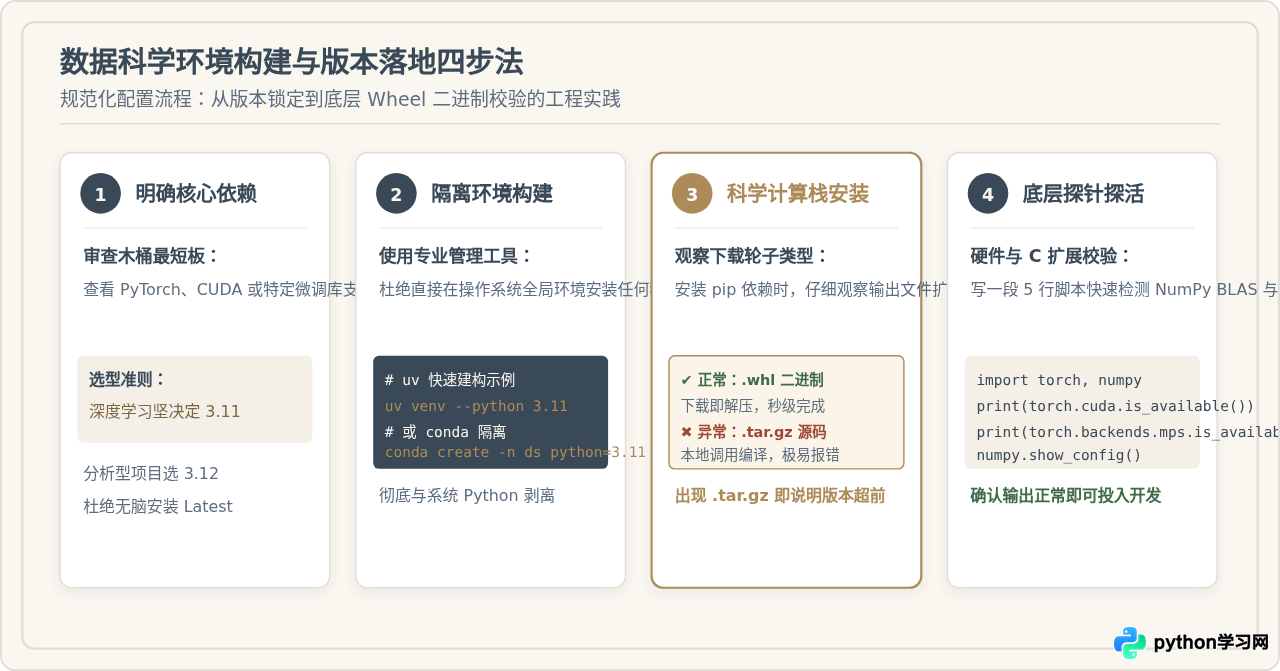
步骤一:使用现代工具创建严格指定版本的隔离环境
推荐使用 uv(极速 Rust 构建的现代包管理器)或 conda / mamba(具备强大非 Python 二进制依赖解决能力的环境管理器)来创建隔离环境。
方法 A:使用现代工具 uv(极速推荐)
# 1. 自动下载并指定安装 Python 3.11 的虚拟环境
uv venv .venv --python 3.11

# 2. 激活虚拟环境 (macOS/Linux)
source .venv/bin/activate

# 2. 激活虚拟环境 (Windows PowerShell)
# .venv\Scripts\Activate.ps1
方法 B:使用 Conda 隔离环境
# 1. 创建指定版本的 conda 环境并安装基础科学解释器
conda create -n ds_py311 python=3.11 -y

# 2. 激活该环境
conda activate ds_py311
步骤二:安装核心科学计算栈并观察下载特征
激活环境后,开始安装核心数据科学包。在安装过程中,请特别留意终端打印出的文件名:
# 安装经典数据科学全家桶
pip install numpy pandas scipy scikit-learn matplotlib jupyterlab

# 安装深度学习框架 PyTorch (以常见 CPU/默认轮子为例,如需 CUDA 请查阅官方命令)
pip install torch torchvision torchaudio正常情况下,终端应输出形如 Downloading numpy-1.26.4-cp311-cp311-manylinux...whl (18.2 MB) 的日志,说明直接采用了预编译二进制文件;
如果看到输出 Downloading ...tar.gz 并随后进入 Running setup.py bdist_wheel for ... 或长达数分钟的卡顿,说明该包在当前 Python 版本下没有预编译 Wheel,正强行调用你电脑上的本地编译器。此时应果断中断(Ctrl+C),检查是否错误使用了过高版本的 Python。
步骤三:编写探测脚本完成环境健康验证
环境安装完成后,在工作目录下新建一个 verify_env.py 脚本,运行以下内容以全面校验解释器、C 扩展调用及底层加速支持:
# verify_env.py:数据科学环境基准探针
import sys
import numpy as np
import pandas as pd
import torch

print("========================================")
print(f"Python 解释器版本 : {sys.version}")
print(f"NumPy 核心库版本   : {np.__version__}")
print(f"Pandas 核心库版本  : {pd.__version__}")
print(f"PyTorch 核心库版本 : {torch.__version__}")
print("----------------------------------------")

# 校验底层 BLAS/LAPACK 线性代数加速支持
print("NumPy 底层 BLAS 架构配置状态:")
np.show_config()

# 校验 GPU/硬件加速是否就绪
cuda_avail = torch.cuda.is_available()
mps_avail = hasattr(torch.backends, "mps") and torch.backends.mps.is_available()

print(f"NVIDIA CUDA 加速就绪 : {cuda_avail}")
print(f"Apple Silicon MPS加速 : {mps_avail}")
print("========================================")
print("✅ 验证完成:数据科学底层扩展库加载正常!")
在终端执行 python verify_env.py,若各库版本均打印无误且未触发动态链接库(DLL / so / dylib)加载缺失异常,即证明该 Python 版本的科学计算运行环境构建成功。
总结与长期维护建议
数据科学开发是一项重度依赖工程底层稳定性的工作。在制定技术栈规范时,切忌盲目追求版本号的最新,而应始终以“生态二进制 Wheel 的完备度”作为第一评判标准:
- 现阶段最稳妥、最省心的生产主力:首选 Python 3.11;
- 希望兼顾现代语言特性且以轻量分析为主的新工程:选 Python 3.12;
- 在任何跨团队协同、代码交付与服务器部署中:务必通过
environment.yml、pyproject.toml或固化版本的 Docker 基础镜像(如FROM python:3.11-slim)锁定小版本号,确保本地开发、测试机与生产集群环境的高度一致。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















