


Python lambda匿名函数与普通函数的区别及使用场景
深入解析Python中lambda匿名函数与def普通函数的核心区别,剖析单表达式限制、堆栈跟踪、闭包机制及PEP 8规范,提供常见使用场景与反模式防坑指南。
在日常 Python 开发中,经常会遇到只需要一次性提取某个字段进行排序的场景。例如对一个包含字典的列表按成绩排序:如果为此专门写一个两行带函数名的 def get_score(x): return x['score'],代码结构会显得冗长且割裂;而使用 sorted(data, key=lambda x: x['score']),一行代码即可表达意图。然而,也有不少开发者由于过度使用 lambda,在单行内塞入嵌套的三元表达式或试图将其赋值给变量,导致代码极难阅读和排查。
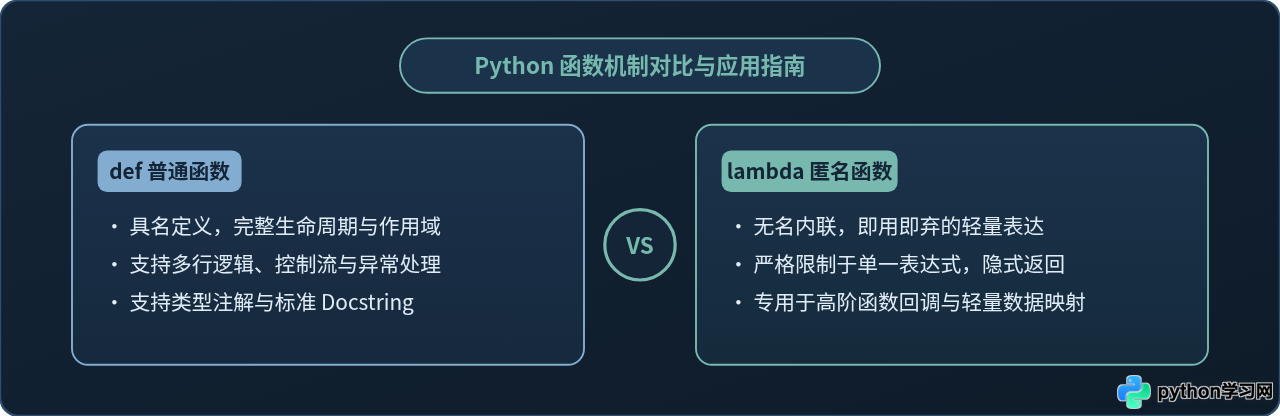
简单而言,lambda 匿名函数的核心在于“即用即弃的轻量表达式”,它用于替代那些逻辑极短、无需复用的临时回调函数;而 普通函数(def)则是完整的语言构件,用于承载清晰命名、多行逻辑、类型注解以及需要持久维护的业务模块。明确两者的语法限制、底层特性与设计取向,是编写优雅且地道 Pythonic 代码的基本功。
一、语法形式与核心能力差异
从语法层面看,def 是一个完整的语句(Statement),而 lambda 是一个表达式(Expression)。这一本质差异直接决定了它们在代码组织能力上的根本不同:
- 定义方式与命名:
def必须声明一个明确的函数名(标识符),并将其绑定到当前命名空间;lambda没有名字,直接在代码出现的位置求值为一个函数对象。 - 单表达式限制:
lambda的函数体仅允许包含单一表达式,不能包含多行代码,也不能使用if、for、while等语句块(但支持单行x if condition else y三元表达式),更不能包含赋值语句=或异常捕获try...except。 - 隐式返回 vs 显式返回:在
def函数中,必须使用return语句返回计算结果,若没有return则默认返回None;而在lambda中,绝对不能出现return关键字,它会自动且隐式地将冒号后的表达式计算结果作为返回值返回。
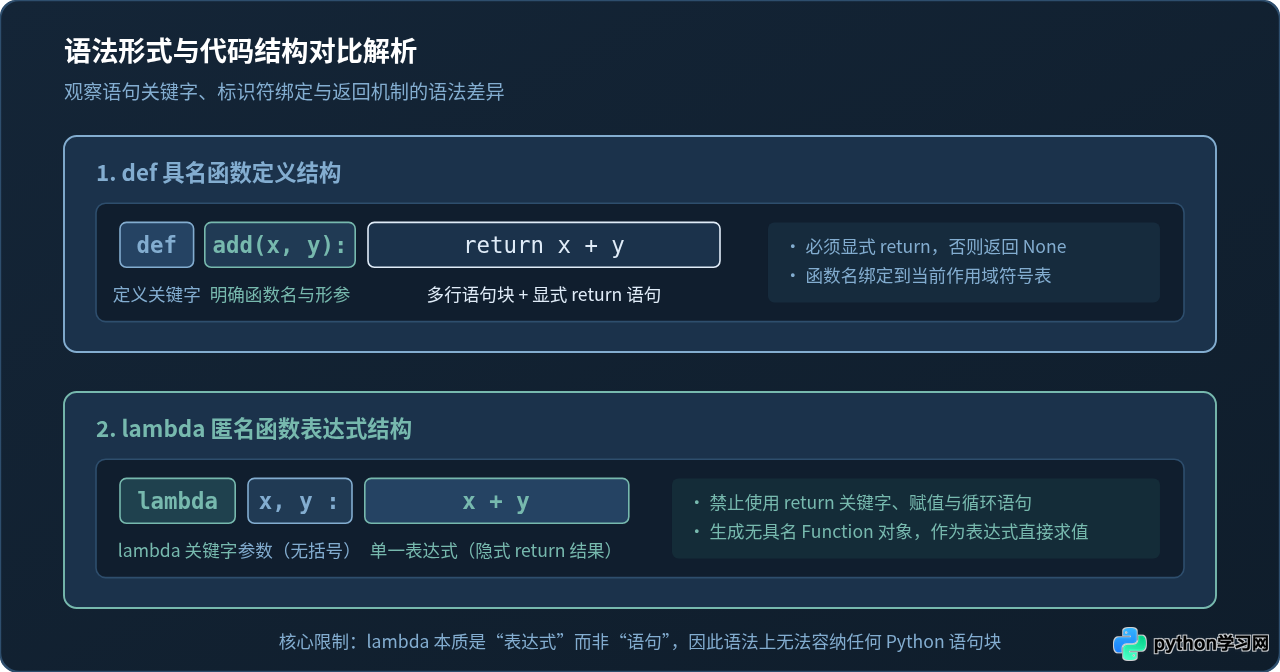
下面的代码清晰展示了相同功能的两种书写形式:
# 普通函数定义
def add(x, y):
    return x + y

# 等价功能的 lambda 表达式(通常直接内联使用)
lambda_add = lambda x, y: x + y

# 示例验证调用
print(add(2, 3))         # 示例输出: 5
print(lambda_add(2, 3))  # 示例输出: 5
二、底层机制与运行时行为的区别
许多初学者容易产生两个极端误解:一是认为 lambda 会比普通函数运行更快,二是认为两者属于完全不同的数据类型。实际上,通过检查 Python 的底层类型可以发现,它们在对象本质上是一致的,但运行时行为存在显著区别。
1. 底层对象同属 FunctionType,无性能特权
在 Python 内部,lambda 表达式创建的对象类型同样是 types.FunctionType。无论是字节码生成还是函数栈帧创建,调用 lambda 与调用单行的普通函数开销基本一致,并不会因为“匿名”就享有 JIT 加速或跳过栈帧的特殊优待。
2. 函数命名标识符(__name__)与错误回溯
普通函数拥有明确的 __name__ 属性,其值即为定义时的函数名。而 lambda 的 __name__ 属性统一为 "<lambda>"。这一差异在项目出现异常时尤为关键:
def broken_named_func(val):
    return 10 / val

broken_lambda = lambda val: 10 / val

# 当传入 0 触发 ZeroDivisionError 时:
# broken_named_func 的异常回溯显示:
#   File "main.py", line 2, in broken_named_func
# 能够瞬间定位到具体出错函数。
#
# 而 broken_lambda 的异常回溯只显示:
#   File "main.py", line 4, in <lambda>
# 若在同一行或复杂链式调用中有多个 lambda,极难辨别究竟是哪个环节触发了错误。
3. 文档字符串与类型注解支持
def 函数天然支持 PEP 257 文档字符串(Docstrings)以及 PEP 484 类型标注(Type Hints),可以被 IDE 自动补全工具与 mypy 等静态分析器精准识别:
def calculate_discount(price: float, rate: float) -> float:
    """计算折后价格,rate 为 0 到 1 之间的小数。"""
return price * (1.0 - rate)相比之下,lambda 无法编写 docstring,在标准语法下也无法直接给形参添加类型注解。这决定了它无法用于对外暴露的公共 API 接口或长期维护的核心业务函数。
三、lambda 匿名函数的经典使用场景
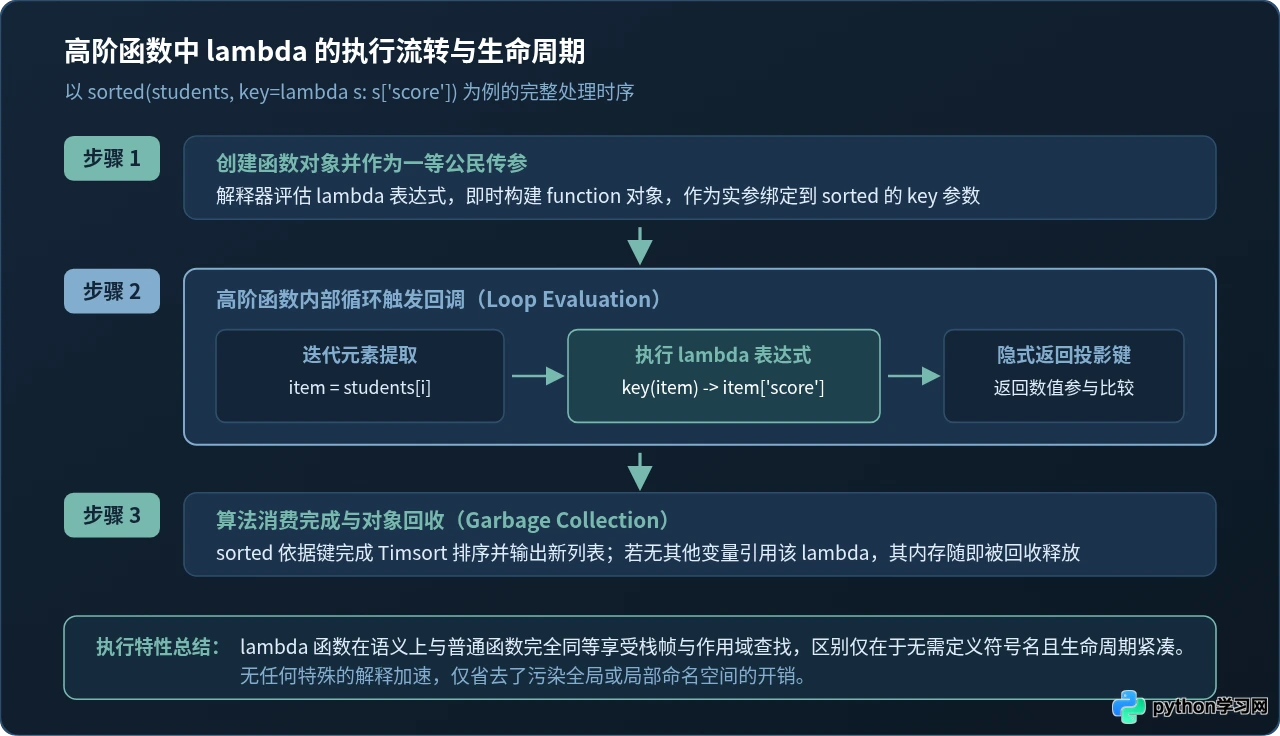
既然 lambda 功能受到诸多限制,为什么 Python 还要保留它?它的价值正是体现在高阶函数(Higher-Order Functions)中作为轻量参数使用,避免为短暂逻辑污染命名空间。
1. sorted()、min()、max() 的 key 排序参数
这是 lambda 最标准、最普遍的使用场景。通过向 key 参数传递一个投射函数,指示排序或极值依据哪个维度进行:
students = [
    {"name": "Alice", "score": 88, "age": 20},
    {"name": "Bob", "score": 95, "age": 19},
    {"name": "Charlie", "score": 72, "age": 21}
]

# 按成绩降序排列
sorted_by_score = sorted(students, key=lambda s: s["score"], reverse=True)
# 示例输出: Bob (95), Alice (88), Charlie (72)

# 获取年龄最小的学员
youngest = min(students, key=lambda s: s["age"])
# 示例输出: Bob (19)
2. 与 filter() 和 map() 搭配进行流式过滤与转换
在函数式数据处理链中,lambda 可以简洁地声明过滤规则:
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

# 过滤偶数并平方
even_squares = list(map(lambda x: x ** 2, filter(lambda x: x % 2 == 0, numbers)))
# 示例输出: [4, 16, 36, 64, 100]map/filter + lambda,如 [x**2 for x in numbers if x % 2 == 0]。推导式可读性更高且往往更快。
3. GUI 编程与事件驱动中的轻量回调包装
在 Tkinter、PyQt 等桌面 GUI 开发中,按钮点击事件通常需要绑定一个不带参数的函数指针。如果需要向响应函数传递特定数据,使用 lambda 包装是经典做法:
# 伪代码演示 Tkinter / 事件监听
# button = Button(text="删除", command=lambda: delete_item(item_id=42))
四、常见误区与反模式(Anti-Patterns)
合理使用 lambda 可以精简代码,但滥用则会迅速破坏项目的可读性与健壮性。以下是四个必须规避的典型误区:
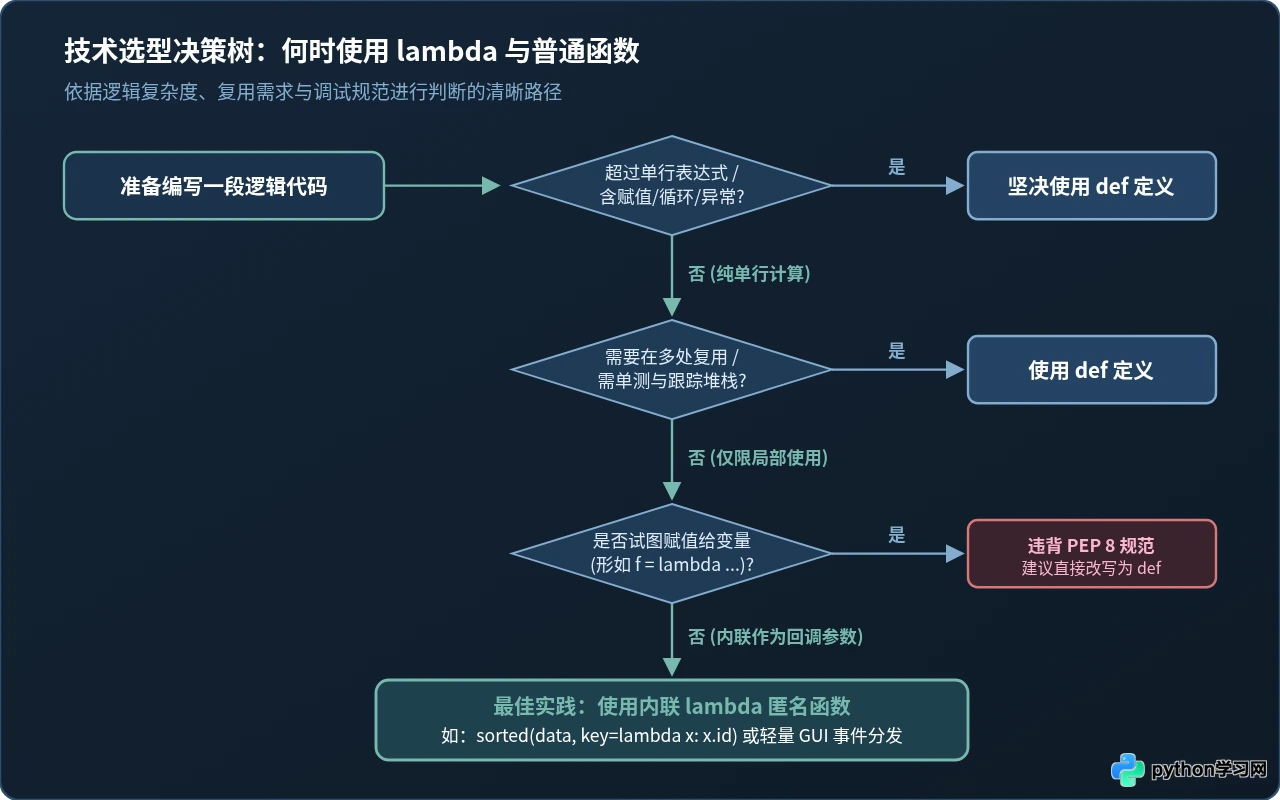
误区 1:违背 PEP 8,给 lambda 显式起名字
Python 官方代码风格指南 PEP 8 明确指出:始终优先使用 def 语句,而不是将 lambda 表达式绑定给一个变量。
# 错误反模式:将 lambda 赋值给变量
square = lambda x: x * x

# 正确规范:直接使用 def 定义
def square(x):
return x * x原因:一旦你给它赋予了变量名,就说明你希望在后续代码中多次复用它,此时它已经失去了“匿名”的初衷;而用 def 还能带来明确的函数名追踪与 docstring 支持。
误区 2:在 lambda 内部堆叠三元运算符
有些开发者为了强行单行化,将复杂的条件判断嵌套进 lambda:
# 糟糕的可读性灾难
grade = lambda score: "优秀" if score >= 90 else ("良好" if score >= 80 else ("及格" if score >= 60 else "不及格"))

# 正确做法:使用普通函数分步处理
def evaluate_grade(score: int) -> str:
    if score >= 90:
        return "优秀"
    elif score >= 80:
        return "良好"
    elif score >= 60:
        return "及格"
    return "不及格"
误区 3:循环闭包中的延迟绑定(Late Binding)陷阱
在循环体中动态生成 lambda 时,闭包变量不是立即绑定,而是在调用时查找外层变量的最终值:
funcs = [lambda x: x + i for i in range(3)]

# 期待输出: 0, 1, 2
# 实际结果:
print([f(0) for f in funcs])
# 示例输出: [2, 2, 2]避坑方案:通过函数形参的默认值机制,在定义时强制完成值绑定:funcs = [lambda x, i=i: x + i for i in range(3)]。
五、全维度对比总结
为了在实际编码中快速做出合理决策,两者的核心指标总结如下:
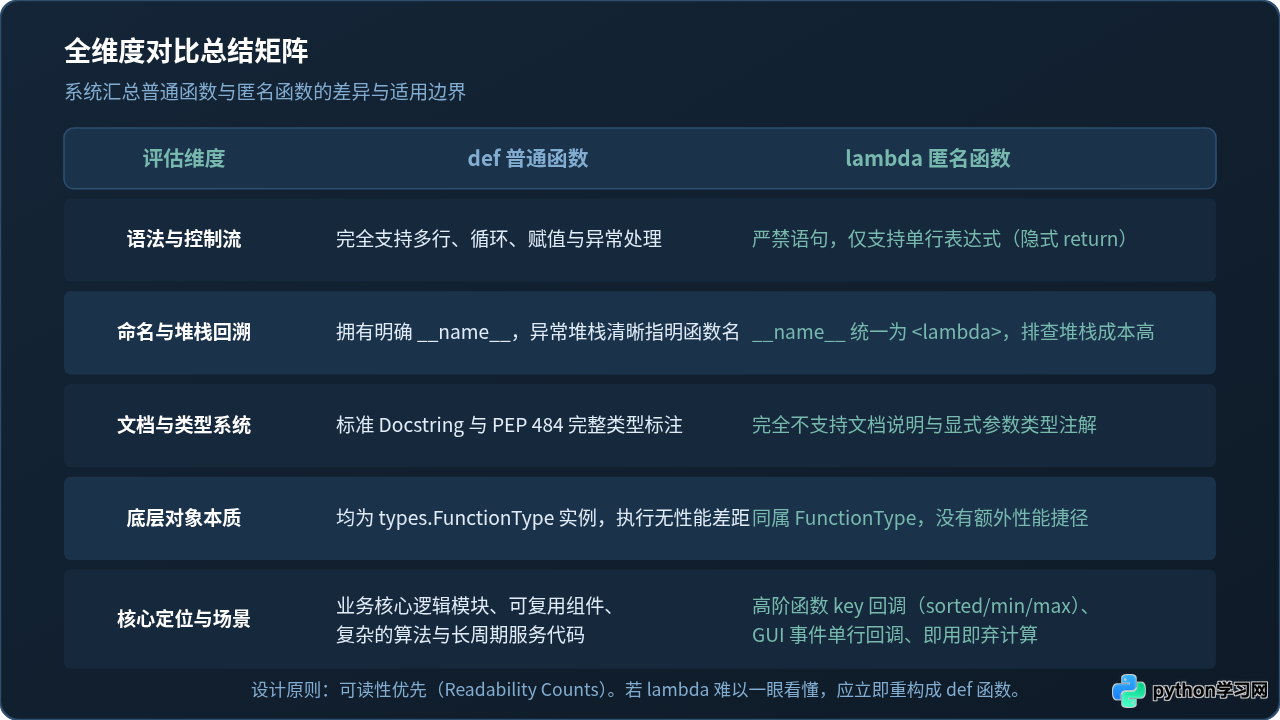
总结来说,“可读性优先(Readability Counts)”是 Python 之禅的核心原则。如果一段逻辑可以通过一行简单的 lambda 明确表达其意图,并且仅在当前语句作为一次性参数使用,那么 lambda 就是最优雅的利器;一旦逻辑超过单行、需要调试回溯、需要复用或需要注释说明,就应该毫无犹豫地选用具名的 def 普通函数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















