


Python自然语言处理入门:NLTK、spaCy与jieba库选型对比
深入对比Python自然语言处理主流库NLTK、spaCy与jieba的设计定位、底层机制、处理流程及代码实操,提供清晰明了的入门选型决策依据。
一、三个库的核心定位与架构差异
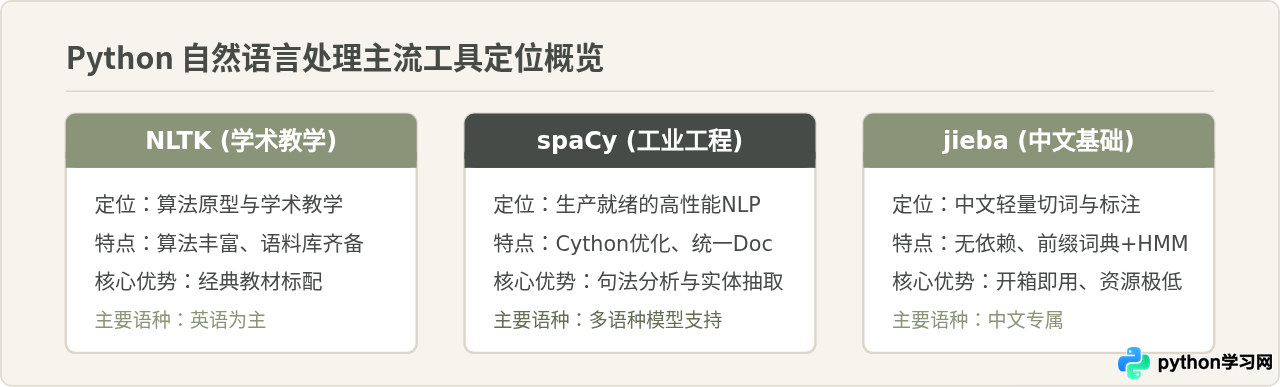
自然语言处理(NLP)涵盖分词、词性标注、句法依存分析、信息抽取等多个环节。很多初学者在搭建第一个文本处理脚本时,面对这三个声名赫赫的库常常陷入纠结。之所以产生选择困难,是因为它们在诞生之初便瞄准了完全不同的工程目标。
1. NLTK:学术导向的算法百宝箱
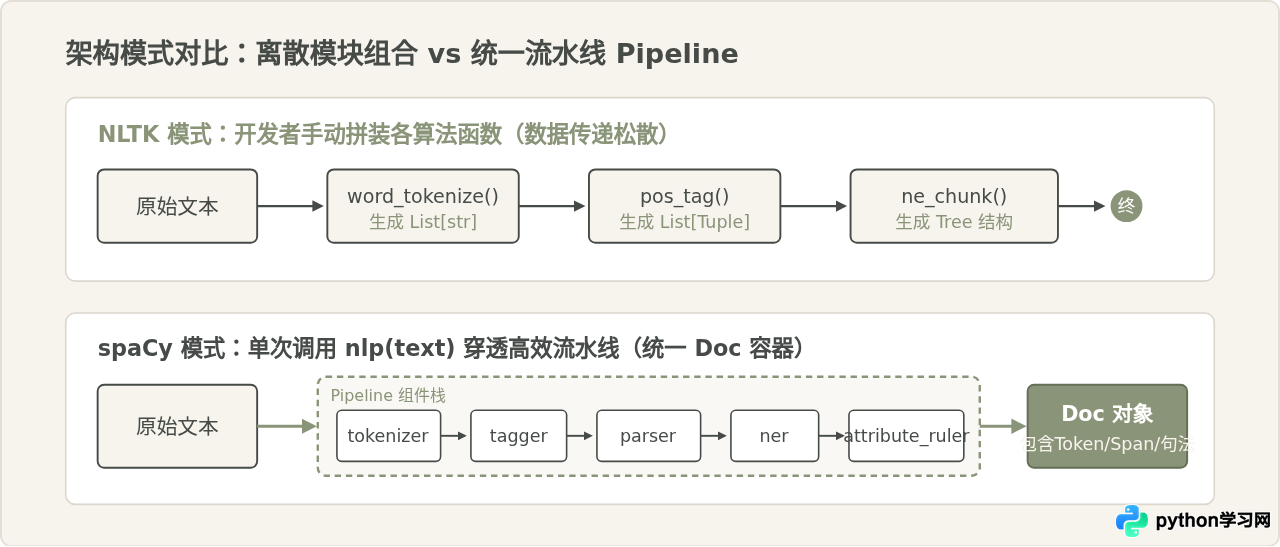
NLTK(Natural Language Toolkit)于 2001 年作为宾夕法尼亚大学的教学工具诞生。它的核心目标是教学与科研。NLTK 收录了几乎所有经典的 NLP 传统算法(如各种分词器、词干提取器、朴素贝叶斯分类器),并附带了数十个学术语料库(如 WordNet、Brown 语料库、树库等)。在 NLTK 中,各项功能以松散的独立模块提供,开发者需要手动串联每一步输入与输出。这种架构使学习者能清晰看清每个算法的内部细节,但也导致了数据结构的非标准化以及相对较低的运行吞吐量。
2. spaCy:工业级单体处理流水线
与 NLTK 形成鲜明对比的是 spaCy。spaCy 于 2014 年发布,设计准则从第一天起就是生产环境的执行效率与开箱即用。spaCy 底层采用 Cython 进行重度性能优化,其数据流围绕统一的 Doc 对象展开。一段文本经过加载的语言模型(Language Pipeline)后,分词、词性标注、形态解析、依存句法分析和实体识别一步完成,所有特征紧凑保存在内存中,避免了多次遍历与中间格式转换。
3. jieba:“结巴”中文分词基石
jieba 并不追求成为覆盖完整 NLP 链路的庞然大物。它的聚焦点非常精准:高效、可靠地解决中文分词难题。在印欧语系中,单词天然由空格隔开;而中文文本是连续的字流,分词是所有下游任务不可逾越的先决步骤。jieba 纯用 Python 编写(亦有 C++ 实现版本 cppjieba),零第三方依赖,通过构建前缀词典构建有向无环图,并辅以隐马尔可夫模型处理未登录词,是国内文本处理与数据分析领域事实上的标配工具。
二、中文处理场景下的实际差异与实现原理
面对中文语料时,这三个库的表现截然不同。了解底层分词逻辑,能避免在工程实践中踩坑。
1. jieba 的分词原理与核心机制
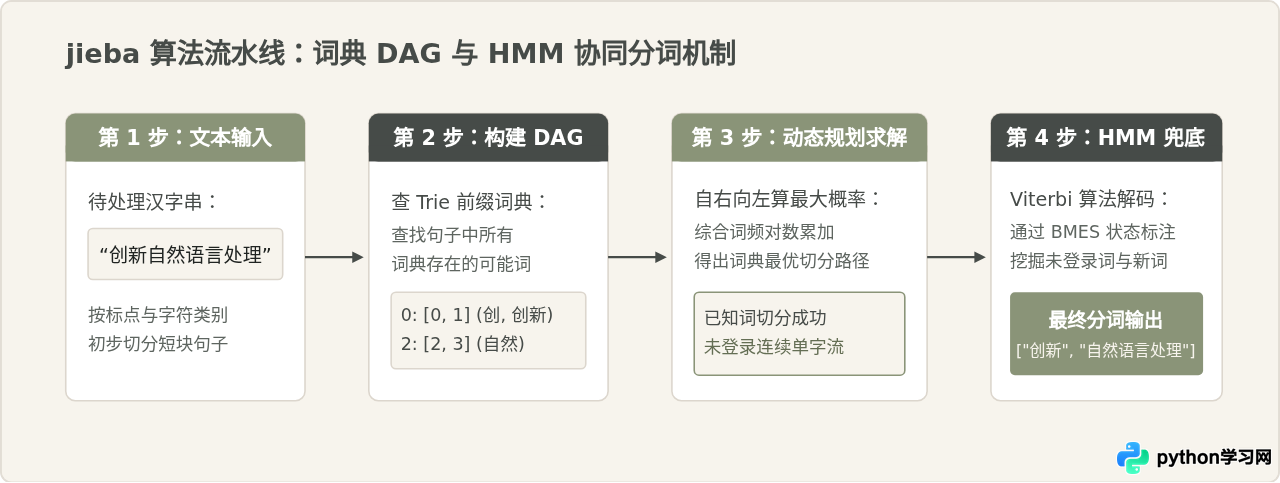
中文分词主要面临两大难题:歧义切分与未登录词(新词)识别。jieba 之所以体积轻小且效果扎实,是因为它结合了统计词典与概率图模型:
- 基于 Trie 树的前缀扫描:jieba 启动时会基于自带的主词典(包含数十万常见词及其词频)加载前缀词典,用于迅速生成句子所有可能切分片段构成的有向无环图(DAG)。
- 动态规划寻找最大概率路径:基于词频,通过动态规划算法自底向上(从右至左)计算,找出在词典概率乘积最大的分词切分组合。
- HMM 与 Viterbi 算法兜底:对于词典中未收录的人名、地名、缩写或流行语(未登录词),jieba 启动基于字标注的隐马尔可夫模型(HMM),利用 Viterbi 算法推断最优的 B(词首)、M(词中)、E(词尾)、S(单字)状态序列,完成新词挖掘。
2. spaCy 与 NLTK 的中文支持现状
spaCy 的中文模型:spaCy 官方通过预训练包支持中文(例如 zh_core_web_sm, zh_core_web_md, zh_core_web_trf)。在其分词器层,spaCy 早期依赖 jieba 或 pkuseg 进行中文底层切分,随后将其接入现代流水线中完成实体标注与依存关系解析。spaCy 中文模型表现很扎实,但使用成本较高:你必须预先单独下载数十兆乃至数百兆的模型权重,无法像 jieba 那样 pip install jieba 导入即用。
NLTK 的中文局限:NLTK 本身几乎没有提供成熟的现代汉语开箱即用分词器。若在 NLTK 中调用 word_tokenize("我爱自然语言处理"),它只会将整个连续中文字符串当成一个词或逐字切碎。在实际中文项目中,若想用 NLTK,通常需要先调用 jieba 将文本切好并用空格拼合,再喂给 NLTK 进行后续统计或分类分析。
三、典型任务代码实测与用法对比
以下通过两个常见的 NLP 基础任务(基础分词与词性标注、实体命名识别),展示三个库的代码组织形态与返回结果差异。
测试环境为 Python 3.9+。安装所需依赖命令如下:
pip install jieba spacy nltk
其中 spaCy 需要额外拉取中文小型模型:python -m spacy download zh_core_web_sm;NLTK 在首次运行时需要下载词性标注数据集(nltk.download('averaged_perceptron_tagger_eng'))。
任务 1:中文/英文基础分词与词性标注
首先看 jieba 进行中文分词与词性标注的代码:
import jieba
import jieba.posseg as pseg

text_cn = "华为在深圳发布了新一代智能终端产品。"

# 1. 基础分词
words = list(jieba.cut(text_cn))
# 示例输出: ['华为', '在', '深圳', '发布', '了', '新一代', '智能', '终端', '产品', '。']

# 2. 词性标注
tagged_words = [(word, flag) for word, flag in pseg.cut(text_cn)]
# 示例输出: [('华为', 'nr'), ('在', 'p'), ('深圳', 'ns'), ('发布', 'v'), ('了', 'ul'), ('新一代', 'n'), ('智能', 'n'), ('终端', 'n'), ('产品', 'n'), ('。', 'x')]
jieba 的 API 直观、零仪式感,切分速度极快。接下来观察 spaCy 处理相同中文文本的方式:
import spacy

# 加载中文预训练流水线
nlp = spacy.load("zh_core_web_sm")
doc = nlp("华为在深圳发布了新一代智能终端产品。")

# 提取词元与词性 (UPOS 标注集)
result = [(token.text, token.pos_) for token in doc]
# 示例输出: [('华为', 'PROPN'), ('在', 'ADP'), ('深圳', 'PROPN'), ('发布', 'VERB'), ('了', 'PART'), ('新一代', 'NOUN'), ('智能', 'NOUN'), ('终端', 'NOUN'), ('产品', 'NOUN'), ('。', 'PUNCT')]
在 spaCy 中,所有的标注信息都被封装进每一个 Token 实例中,无需像 jieba 那样切换到专门的 pseg 子模块。而 NLTK 在英文标注任务中则表现如下:
import nltk

text_en = "Apple introduced the new MacBook Pro in California."
tokens = nltk.word_tokenize(text_en)
tagged = nltk.pos_tag(tokens)
# 示例输出: [('Apple', 'NNP'), ('introduced', 'VBD'), ('the', 'DT'), ('new', 'JJ'), ('MacBook', 'NNP'), ('Pro', 'NNP'), ('in', 'IN'), ('California', 'NNP'), ('.', '.')]
任务 2:命名实体识别(NER)与依存句法分析
对于实体抽取(识别公司名、地名等)和句子主谓宾依存关系解析,三个库的能力差异变得极为悬殊:
- jieba:无命名实体识别(NER)引擎,亦无句法分析能力。开发者只能借助其词性标注中的
nr(人名)、ns(地名)、nt(机构名)做简单的启发式过滤,缺乏上下文语义感知。 - NLTK:提供了
ne_chunk(),但基于较早期的最大熵模型,识别精度有限,返回的是嵌套的Tree结构,解析起来较为繁琐。 - spaCy:这是 spaCy 最引以为傲的领域。只需一行调用,即可同时获取实体、实体类别以及完整的语法树:
import spacy

nlp = spacy.load("zh_core_web_sm")
doc = nlp("华为在深圳发布了新一代智能终端产品。")

# 1. 命名实体提取
for ent in doc.ents:
    print(f"实体: {ent.text} | 类型: {ent.label_}")
# 示例输出:
# 实体: 华为 | 类型: ORG (机构)
# 实体: 深圳 | 类型: GPE (行政区/地点)

# 2. 依存句法分析 (寻找主语、核心谓语和宾语)
for token in doc:
    print(f"{token.text:<6} -> 依赖于: {token.head.text:<6} (依存关系: {token.dep_})")
# 示例输出:
# 华为   -> 依赖于: 发布   (nsubj - 名词主语)
# 在     -> 依赖于: 发布   (prep - 介词状语)
# 深圳   -> 依赖于: 在     (pobj - 介词宾语)
# 发布   -> 依赖于: 发布   (ROOT - 核心谓词)
# 产品   -> 依赖于: 发布   (dobj - 直接宾语)
四、容易混淆的常见说法与深度辨析
在技术社区与交流群中,常能见到关于这三个库的一些论调。这些说法往往在特定情境下成立,但如果照单全收,容易误导选型决策。
辨析 1:“在大模型时代,传统 NLP 库已经完全没有存在价值了?”
为什么看似合理:现代化的大语言模型(LLM)具备强大的理解与生成能力,一段 Prompt 就能完成实体抽取和情感分类,看起来似乎不再需要传统分词与规则分析。
成立的条件:如果任务属于端到端的复杂信息生成、多轮对话或小批量高质量知识推理,直接使用大模型确实更省事。
需要修正的地方:在大规模生产系统中,纯依赖大模型存在高昂的 Token 成本、无法预测的响应延迟以及幻觉问题。现代工业架构中,jieba 与 spaCy 常作为 LLM 的前置守门员与后置验证器:例如基于 jieba 做高并发敏感词初筛、词频倒排索引构建(Elasticsearch)、RAG(检索增强生成)中文档智能分块切片;基于 spaCy 提取关键实体构建知识图谱,用以校验模型回答。传统 NLP 库与大模型是互补的分工关系,而非非此即彼。
辨析 2:“NLTK 太老太慢,现在初学者根本不需要接触它了?”
为什么看似合理:在工业级生产 API 服务中,几乎不会有人使用 NLTK 作为核心推理引擎,其速度与内存占用确实落后于 spaCy。
成立的条件:如果是为了交付商业级高并发服务,确实应当避开 NLTK。
需要修正的地方:在大学课程与自学经典 NLP 原理时,NLTK 依旧是最适合的教学沙盒。NLTK 的代码透明度极高,内置了朴素贝叶斯、隐马尔可夫、CFG(上下文无关文法)等教科书级实现,配合 WordNet 语义词网,可以非常直观地理解 NLP 底层数学与规则逻辑,而不是仅仅当一个调用黑盒模型的调包侠。
辨析 3:“做中文自然语言处理,只要装一个 jieba 就万事大吉?”
为什么看似合理:中文 NLP 的第一道坎就是分词,jieba 分词快、词典自定义简单,能解决 80% 的初级文本清洗与词云绘制工作。
成立的条件:如果任务只停留在情感极性打分、词云展示、TF-IDF 关键词抽取或配合 scikit-learn 做文本分类,jieba 确实足够胜任。
需要修正的地方:如果项目需要挖掘“谁对谁在什么时间做了什么事”(事件抽取)、句法结构挖掘、指代消解或合同条款合规核查,单纯的切词无法提供句子骨干结构信息。此时必须引入支持深度依存句法的工具(如 spaCy 中文模型、HanLP 或 LTP),单靠 jieba 无法支撑深层语义任务。
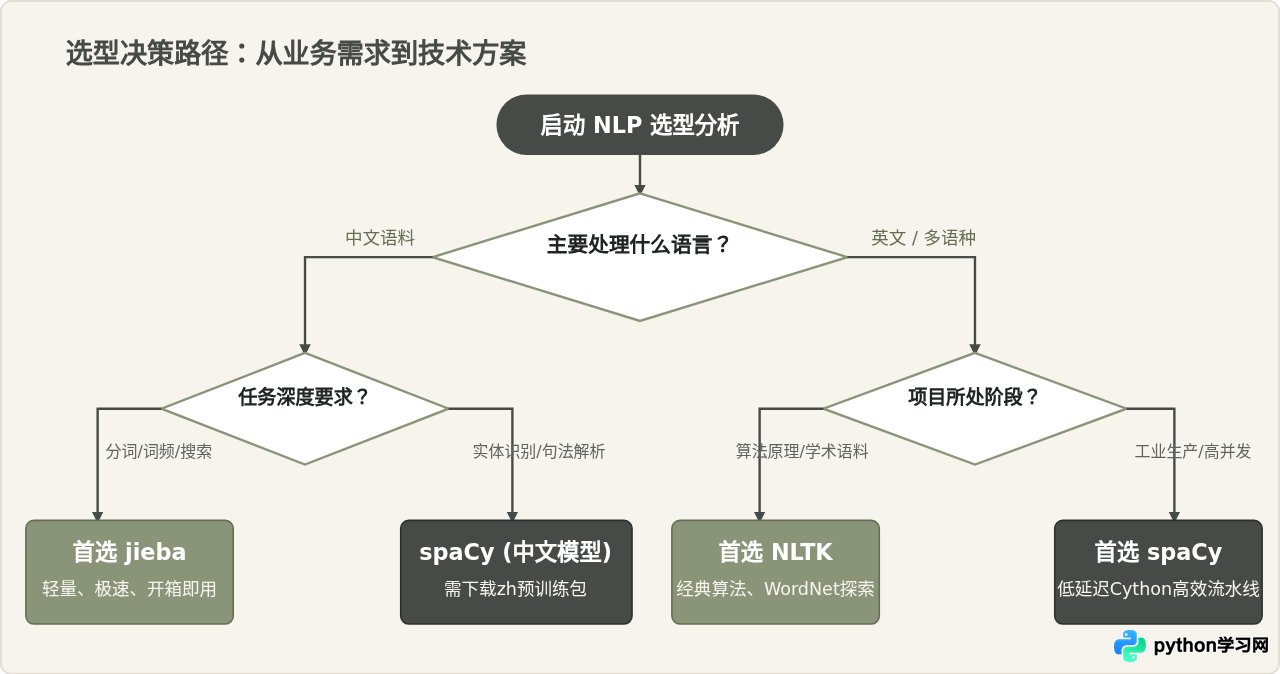
五、项目选型决策路径与落地建议
为了让选型决策更加直观,我们梳理了以下多维度决策路径。面对新项目时,只需顺着条件逐步筛选,即可明确最佳技术方案:
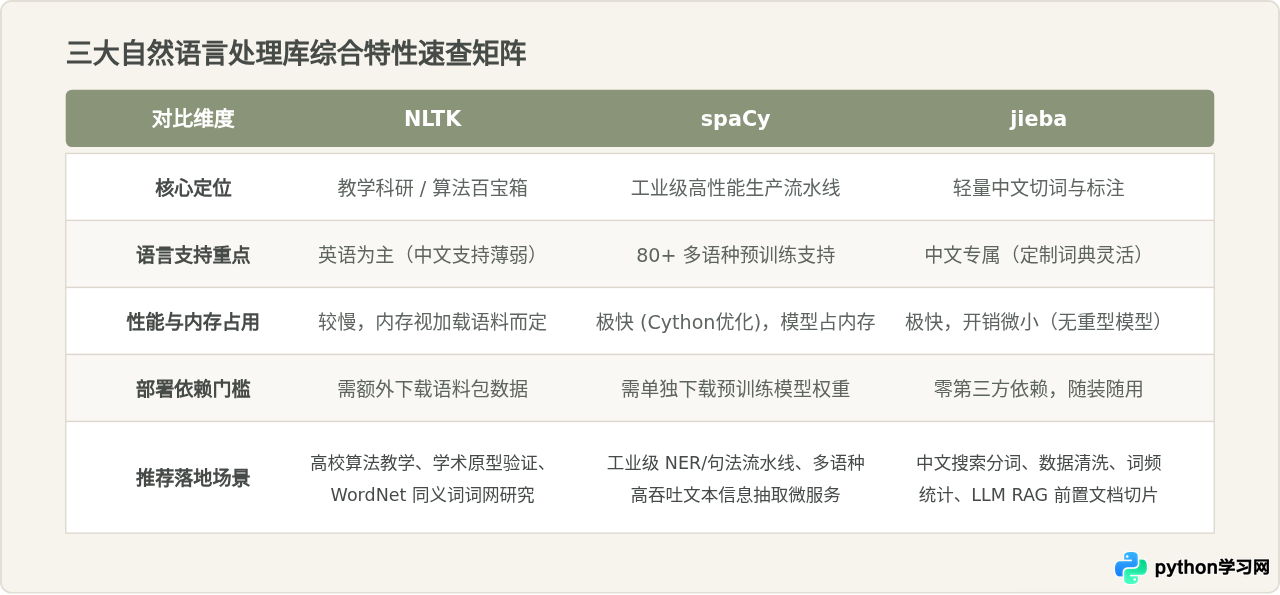
六、综合维度对比总结
为了让读者对三者的各维度参数一目了然,我们将核心指标与选型评估总结如下:
小结
对于刚步入自然语言处理领域的开发者而言,不必将库的选型视为“非此即彼”的单选题:
- 若你的项目是中文为主的数据分析或搜索前处理:毫不犹豫选择 jieba,它能以最低的心智负担和机器资源迅速解决文本切分问题。
- 若你需要从复杂句子里抽取出公司名、人名、时间,或需要分析主谓宾句法逻辑:部署 spaCy 并加载对应的语言模型,它的现代化流水线将提供最佳的工程质量和运行速度。
- 若你的目标是系统性理解自然语言处理基础算法的底层演进:通读 NLTK 官方配套书籍与源码,它依然是理解自然语言处理理论最扎实的入门向导。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















