


Python爬虫开发全流程:从请求发送到数据入库
系统讲解Python爬虫开发的完整落地流程,涵盖网络请求构建、异常重试机制、页面与接口数据解析、字段清洗校验以及数据库持久化入库的全生命周期实践。
编写一个爬虫程序的本质,是构建一条模拟客户端向目标服务器发起网络请求、获取响应报文、从中抽取结构化字段并清洗去重,最后写入持久化存储介质的自动化作业流水线。许多初学者能轻松跑通“获取单页打印到控制台”的小脚本,但面对批量采集时的网络抖动、脏数据干扰、重复写入以及目标服务端反爬拦截时,脚本往往会迅速中断或污染数据库。本文将按照标准工程顺序,从请求构建、异常自愈、解析选型、字段治理,直到数据库幂等写入,完整梳理生产级爬虫的开发全流程。
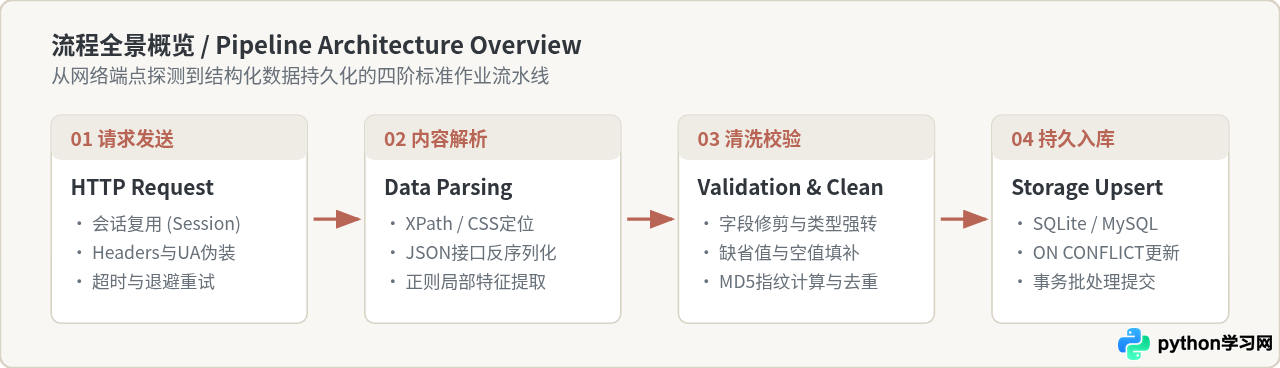
一、发送网络请求:连接池、防封头与退避重试
网络请求是爬虫流水线的最前端。直接调用无修饰的 requests.get(url) 极其脆弱,目标服务器不仅可以通过请求头中的默认标识(例如 python-requests/2.x)瞬间识别并阻断访问,一旦遭遇网络瞬时拥塞,没有显式超时的脚本还会陷入无限挂起状态。
构建稳健的请求层需要满足三个关键要素:
- 使用
requests.Session维持会话:复用底层的 TCP 物理连接池,大幅削减高频握手开销,同时自动保持服务端返回的 Cookie 状态。 - 完整构造 HTTP 标头:至少配置与主流浏览器一致的
User-Agent、Accept-Language与Referer,模拟合法访问上下文。 - 必须设置超时与指数退避:为连接和读取设置上限时间(如
timeout=(5, 12)),遇到 429 限流或 5xx 故障时按 2n 秒递增休眠,防止雪崩。
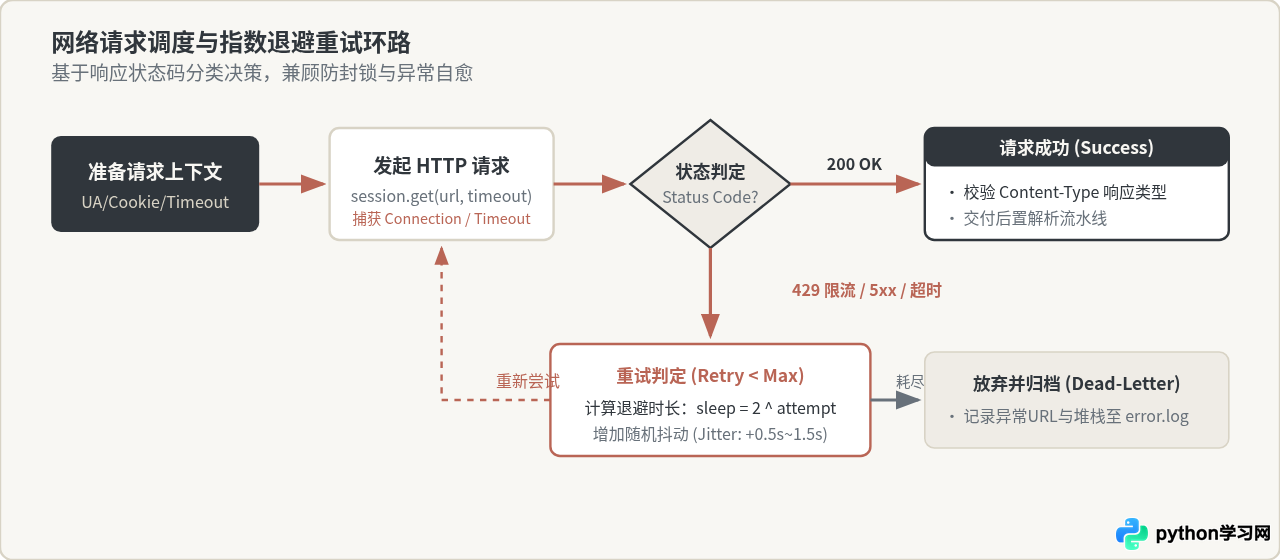
下面是一个封装完备、具备异常自愈能力的请求函数示例:
import time
import random
import logging
import requests

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def create_crawler_session() -> requests.Session:
    """初始化并配置标准爬虫会话"""
    session = requests.Session()
    session.headers.update({
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36",
        "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Referer": "https://example.com/",
    })
    return session

def fetch_url(session: requests.Session, url: str, max_retries: int = 3) -> str:
    """带指数退避机制的稳健请求提取器"""
    for attempt in range(1, max_retries + 1):
        try:
            # 连接超时 5 秒,读取超时 12 秒
            response = session.get(url, timeout=(5, 12))

            # 遭遇频控 429 或服务端瞬时 5xx 错误,主动休眠重试
            if response.status_code in (429, 500, 502, 503, 504):
                sleep_sec = (2 ** attempt) + random.uniform(0.5, 1.5)
                logging.warning(f"状态码 {response.status_code},第 {attempt} 次重试,休眠 {sleep_sec:.2f} 秒: {url}")
                time.sleep(sleep_sec)
                continue

            response.raise_for_status()
            # 解决非 UTF-8 编码导致的中文乱码
            response.encoding = response.apparent_encoding or "utf-8"
            return response.text

        except (requests.exceptions.Timeout, requests.exceptions.ConnectionError) as exc:
            sleep_sec = (2 ** attempt) + random.uniform(0.5, 1.0)
            logging.warning(f"网络异常 ({type(exc).__name__}),第 {attempt} 次重试: {url}")
            time.sleep(sleep_sec)

    logging.error(f"重试 {max_retries} 次仍失败,放弃该 URL: {url}")
    return ""
2026-10-31 18:42:02 [WARNING] 状态码 429,第 1 次重试,休眠 2.84 秒: https://example.com/books/page/1
2026-10-31 18:42:05 [INFO] 请求成功,获取有效 HTML 文档 (字节长度: 48210)
二、响应内容解析:提取策略与工具选型
请求拿到报文后,下一步是把非结构化的 HTML 文本拆解为明确命名的键值字段。在实际开发中,解析方案直接决定了爬虫的执行效率与维护成本。
面对现代 Web 应用,首要判断目标数据是服务端直出(SSR / 静态 HTML)还是前端动态渲染(CSR / AJAX 异步请求)。很多初学者一看到页面就直接写 XPath,而事实上,如果在浏览器的 Network 面板中抓取到了返回 JSON 数据的接口,应当直接请求接口并进行 JSON 反序列化——这既省去了复杂的 DOM 解析,字段也最为干净精准。
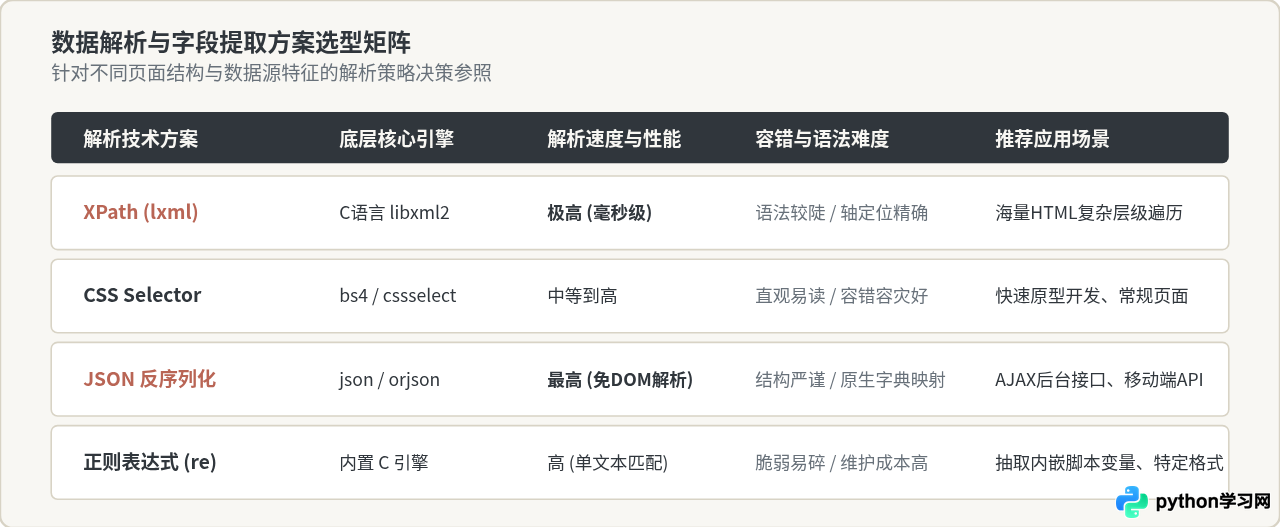
针对常规静态页面,推荐使用 BeautifulSoup 配合 lxml 解析器,兼顾了 C 语言内核的高速与 CSS 选择器的易读性。下面演示从典型的书籍/商品列表页中批量提取目标节点的范式:
from urllib.parse import urljoin
from bs4 import BeautifulSoup
from typing import List, Dict, Any

def parse_book_items(html_doc: str, base_url: str) -> List[Dict[str, Any]]:
    """从 HTML 文本中解析列表项节点"""
    if not html_doc:
        return []

    soup = BeautifulSoup(html_doc, "lxml")
    items = []

    # 定位列表容器中的每一个卡片项
    card_nodes = soup.select("article.product_pod, div.book-card")
    for card in card_nodes:
        # 1. 标题提取 (注意容错判断)
        title_tag = card.select_one("h3 a, .title a")
        title = title_tag.get("title") or title_tag.get_text() if title_tag else ""

        # 2. 详情链接提取 (必须做 URL 绝对路径补全)
        raw_href = title_tag.get("href") if title_tag else ""
        full_url = urljoin(base_url, raw_href) if raw_href else ""

        # 3. 价格提取
        price_tag = card.select_one(".price_color, .product-price")
        price_text = price_tag.get_text(strip=True) if price_tag else ""

        # 4. 评分或库存状态
        avail_tag = card.select_one(".availability, .stock-status")
        availability = avail_tag.get_text(strip=True) if avail_tag else ""

        items.append({
            "raw_title": title,
            "raw_price": price_text,
            "raw_url": full_url,
            "raw_stock": availability
        })

    return items
三、数据清洗、校验与指纹去重
直接从网页提取出来的字段往往充满“杂质”,例如换行符 \n、多余的 HTML 实体符、货币符号、相对时间描述(如“10分钟前”)。绝对不能将未经验证的脏数据直接灌入数据库。
数据清洗阶段的核心任务包括:
- 类型显式转换:价格从
"£51.77"剥离非数字字符后转换为浮点数float(51.77);评论数转为整型int。 - 空值兜底防护:严禁出现
None导致字符串操作抛出AttributeError,赋予安全的缺省值(如空串、0.0)。 - 生成唯一数字指纹(Fingerprint):利用业务唯一字段(如商品唯一 URL 或 标题+发布时间)计算 MD5 哈希值,作为全局去重依据。
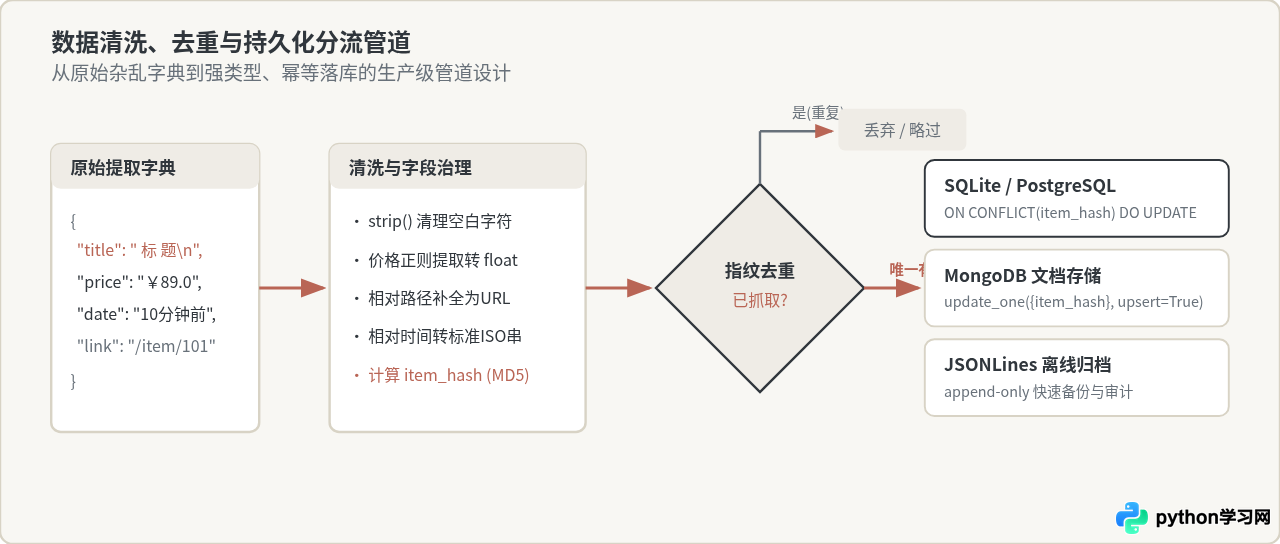
清洗与防重处理的代码实现如下:
import re
import hashlib
from typing import Optional, Dict, Any

def clean_and_validate(raw_item: Dict[str, Any]) -> Optional[Dict[str, Any]]:
    """清洗单条数据,如果不符合最小合法条件则丢弃(返回 None)"""
    raw_title = raw_item.get("raw_title") or ""
    title = re.sub(r"\s+", " ", raw_title).strip()

    url = raw_item.get("raw_url") or ""
    if not title or not url.startswith("http"):
        # 丢弃缺少关键主键或 URL 非法的废弃数据
        return None

    # 提取纯数字价格
    raw_price = raw_item.get("raw_price") or ""
    price_match = re.search(r"\d+(?:\.\d+)?", raw_price)
    price = float(price_match.group(0)) if price_match else 0.0

    # 库存状态布尔化
    raw_stock = raw_item.get("raw_stock") or ""
    in_stock = 1 if "in stock" in raw_stock.lower() or "有货" in raw_stock else 0

    # 计算 MD5 指纹,作为全系统去重主键
    hasher = hashlib.md5()
    hasher.update(url.encode("utf-8"))
    item_fingerprint = hasher.hexdigest()

    return {
        "item_hash": item_fingerprint,
        "title": title,
        "url": url,
        "price": price,
        "in_stock": in_stock,
        "crawled_at": int(time.time())
    }
四、数据持久化入库:幂等设计与事务批量写入
爬虫在长周期运行过程中可能发生异常中断。如果重新启动爬虫导致数据全部重复插入,就会造成数据倾斜和统计失真;反之,若简单忽略异常,则无法同步目标网站的最新价格或状态变更。
成熟的入库设计必须满足幂等性(Idempotence):无论爬虫执行一次还是重复执行十次,数据库中该项数据的状态都应当一致。以关系型数据库(如 SQLite / MySQL / PostgreSQL)为例,实现幂等的标准方式是为 item_hash 设立唯一索引(UNIQUE),并配合 ON CONFLICT DO UPDATE 语法执行“插入或更新(Upsert)”。
import sqlite3
from typing import List, Dict, Any

class StoragePipeline:
    """持久化入库管道管理器 (SQLite 实现)"""
    def __init__(self, db_path: str = "crawler_data.db"):
        self.db_path = db_path
        self._init_db()

    def _init_db(self):
        """建表并设置唯一索引"""
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.execute("""
                CREATE TABLE IF NOT EXISTS scraped_books (
                    id INTEGER PRIMARY KEY AUTOINCREMENT,
                    item_hash TEXT NOT NULL UNIQUE,
                    title TEXT NOT NULL,
                    url TEXT NOT NULL,
                    price REAL NOT NULL,
                    in_stock INTEGER NOT NULL,
                    crawled_at INTEGER NOT NULL
                )
            """)
            cursor.execute("CREATE INDEX IF NOT EXISTS idx_hash ON scraped_books(item_hash)")
            conn.commit()

    def save_batch(self, items: List[Dict[str, Any]]) -> int:
        """批量执行 Upsert 写入,保证事务一致性"""
        if not items:
            return 0

        # SQLite 3.24+ 原生支持 ON CONFLICT DO UPDATE
        upsert_sql = """
            INSERT INTO scraped_books (item_hash, title, url, price, in_stock, crawled_at)
            VALUES (:item_hash, :title, :url, :price, :in_stock, :crawled_at)
            ON CONFLICT(item_hash) DO UPDATE SET
                title = excluded.title,
                price = excluded.price,
                in_stock = excluded.in_stock,
                crawled_at = excluded.crawled_at
        """

        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.executemany(upsert_sql, items)
            conn.commit()
            return cursor.rowcount
五、端到端完整脚本组装
将上述请求发送、页面解析、字段清洗和持久化入库模块组装起来,即可形成一个结构分明、具备高抗扰能力的完整爬虫脚本。代码保持前后变量与契约一致:
import time
import random
import logging
from typing import List

# 依赖先前定义的模块:create_crawler_session, fetch_url, parse_book_items, clean_and_validate, StoragePipeline

def run_spider():
    """主调度循环"""
    target_base = "https://books.toscrape.com/"
    start_urls = [f"{target_base}catalogue/page-{p}.html" for p in range(1, 4)]

    session = create_crawler_session()
    storage = StoragePipeline("books_collection.db")
    total_inserted = 0

    logging.info("=== 爬虫抓取流水线启动 ===")

    for url in start_urls:
        logging.info(f"正在处理分页: {url}")
        html_content = fetch_url(session, url)
        if not html_content:
            logging.error(f"跳过不可用页面: {url}")
            continue

        # 1. 结构提取
        raw_items = parse_book_items(html_content, base_url=url)

        # 2. 数据清洗与过滤
        valid_records = []
        for raw in raw_items:
            cleaned = clean_and_validate(raw)
            if cleaned:
                valid_records.append(cleaned)

        # 3. 事务批量入库
        affected = storage.save_batch(valid_records)
        total_inserted += len(valid_records)
        logging.info(f"页面 {url} 处理完毕,有效记录: {len(valid_records)} 条,影响数据行: {affected}")

        # 礼貌等待:模拟真实人工操作间隔,防止短时突发请求触发服务器防御
        time.sleep(random.uniform(1.2, 2.5))

    logging.info(f"=== 抓取任务完成,累计处理入库: {total_inserted} 条 ===")

if __name__ == "__main__":
    run_spider()
六、生产级运维保障与合规注意事项
当爬虫从单机脚本过渡为日常自动化任务时,系统的重点将转向长期稳定性、反爬规避与法律伦理边界。没有节制的爬虫不仅极易被封禁 IP,还可能对目标站点造成拒绝服务攻击。
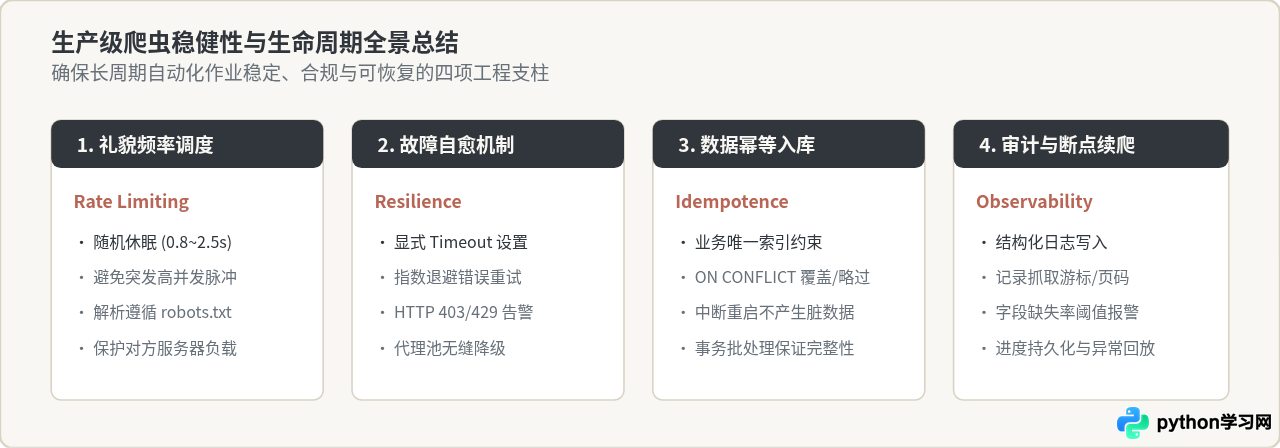
工程规范红线提示:
- 遵守目标站点 robots.txt 协议:在开始爬取前,务必查阅
https://target-domain.com/robots.txt,严格避开声明禁止爬取(Disallow)的私密或管理目录。 - 限制并发与请求频率:设置令牌桶或固定延迟,绝不要对小型站点开启 50+ 以上无限制线程脉冲,保持“礼貌爬取”(Polite Crawling)。
- 不爬取个人隐私与敏感版权内容:不得通过技术绕过付费墙或爬取未公开的用户实名数据;涉及知识产权和商用数据时,应优先采用官方提供的开放 API。
通过“严谨的请求重试机制 + 结构化精准提取 + 字段清洗与唯一指纹 + 数据库幂等写入”的完整链条,开发者就能构建出一条从容应对网络中断、页面变动和重复执行的现代化数据采集流水线。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















