


Python手写工具函数与引入第三方库的选型权衡
深入探讨Python项目中手写内部工具函数与引入第三方开源库的核心权衡准则,涵盖标准库边界、边缘复杂度激增、供应链依赖治理及防腐层落地方案。
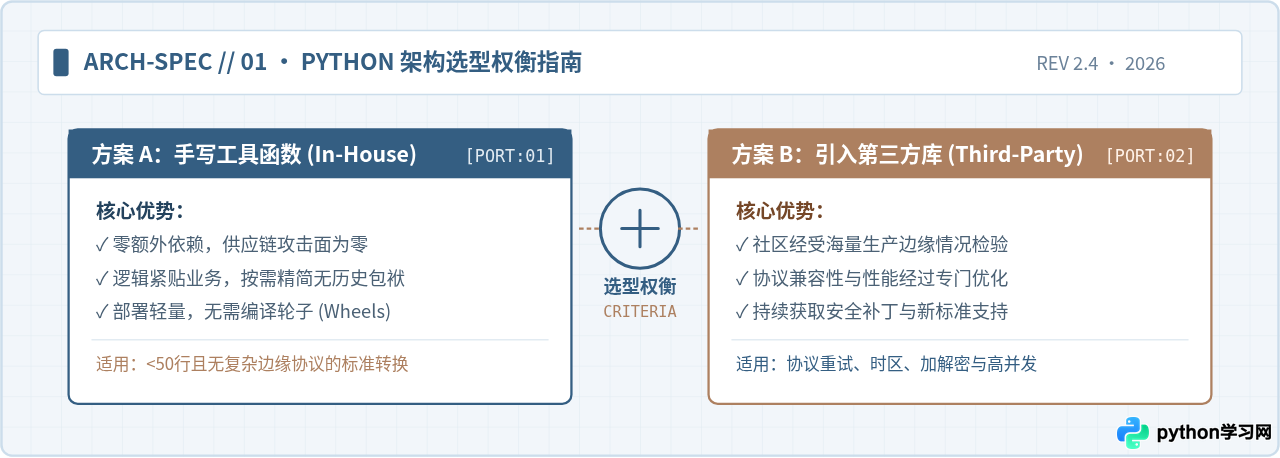
一、维系成本分解:手写与引入的本质差异
许多开发者在面对一个具体需求时(例如批量数据切片、深层字典取值或带退避的 HTTP 请求),往往陷入两个极端:一部分工程师秉持“不要重复造轮子”的信条,哪怕只用一个简单的扁平化方法也要 pip install 一个体量庞大的包;另一部分工程师则倾向于“凡事皆可手写”,坚信自研代码拥有百分之百的掌控力,却忽视了后续潜在的边缘缺陷与维护负担。
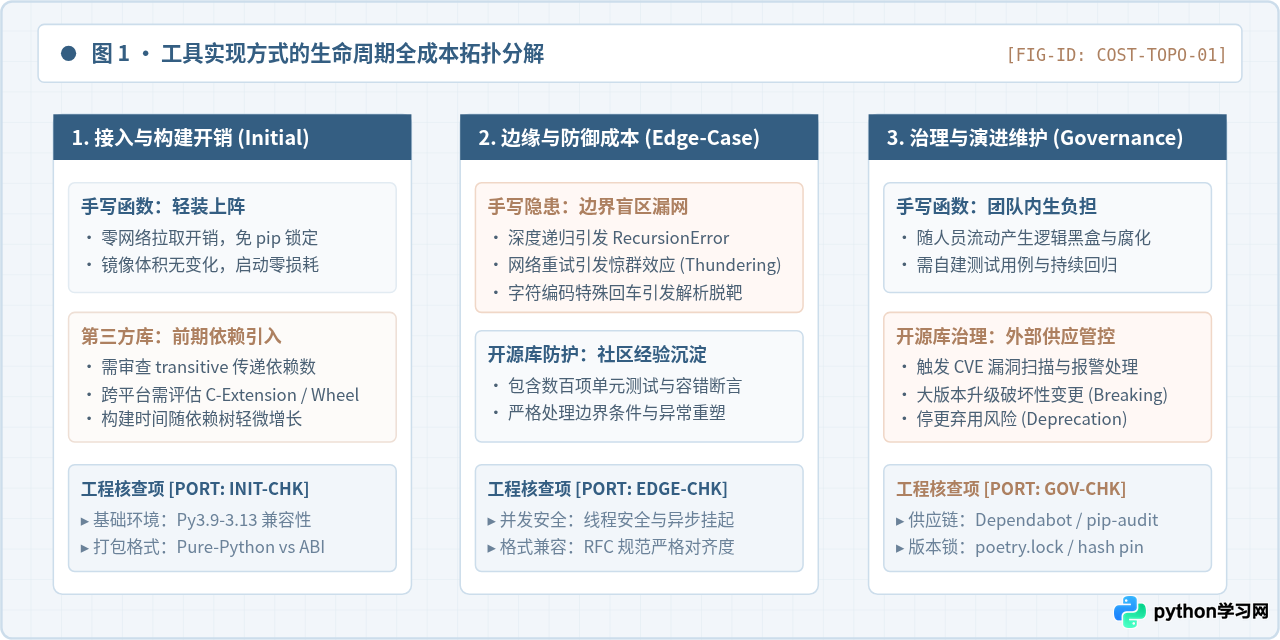
要做出理性的技术选型,必须跳出“写代码耗时”的单一视角,全面审视两种方案在完整软件工程生命周期中的成本构成:
| 评估维度 | 方案 A:手写内部工具函数 (In-House) | 方案 B:引入第三方开源库 (Third-Party) |
|---|---|---|
| 初始集成开销 | 极低。无需修改 pyproject.toml 或 requirements.txt,代码随业务提交即可运行。 |
中等。需要依赖解析、评估 Python 版本与跨平台 ABI 预编译包(Wheels)的兼容性。 |
| 边界缺陷防御 | 脆弱。受限于单人测试视野,易在循环引用、非常规字符集、大并发竞争等边缘场景下崩溃。 | 极强。由数以万计的生产项目共同检验,积累了密集的自动化回归断言与边缘防御。 |
| 持续维护负担 | 团队全权兜底。随团队人员流动容易出现“代码黑盒”,文档缺失时易出现逻辑腐化。 | 外部转移。享受社区持续提供的修复,但伴随 CVE 漏洞告警应对与主版本升级的破坏性变更。 |
| 供应链安全风险 | 零外部攻击面。代码完全私有且受内部审查机制约束。 | 存在依赖投毒、传递依赖失效及锁定漂移风险,必须配备自动化扫描与 Hash 校验。 |
二、四步选型决策流:从标准库检索到防腐封装
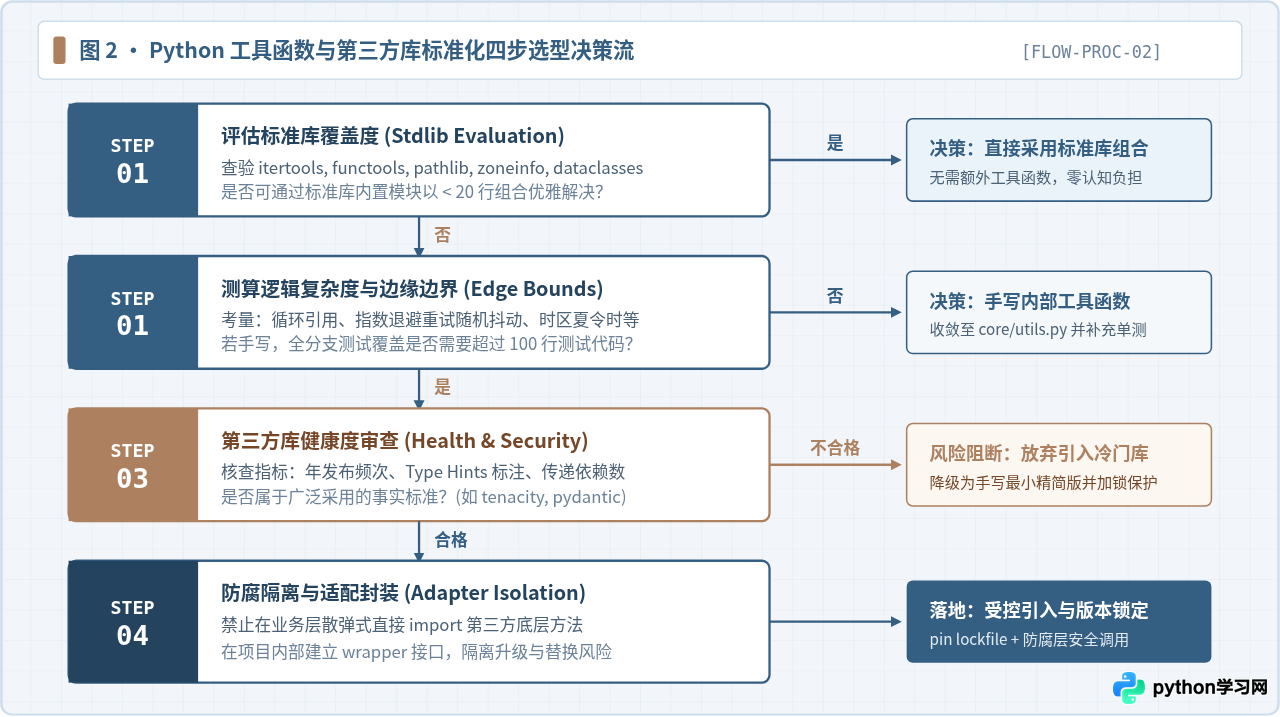
为了避免在日常代码评审(Code Review)中因主观喜好产生争议,建议团队建立标准化的四步选型漏斗。每一个新工具需求的产生,都应当顺次通过这四个关卡的检验:
第 1 步:核查现代化 Python 标准库(Stdlib First)
在 Python 3.9 至 3.13 的现代化演进中,标准库已经内置了极为强大的工具集。许多在早年间必须依赖外部库的操作,如今已经成为语言内置能力:
- 路径与文件操作:优先使用
pathlib.Path,彻底淘汰散落各处的os.path拼接或自定义路径清洗函数。 - 迭代器与函数缓存:利用
itertools.chain、itertools.islice及functools.lru_cache,仅需数行声明即可实现高性能组合。 - 结构化数据模型:优先考虑内置
dataclasses,在不需要复杂运行时校验时,无需强行引入第三方模型库。 - 现代化时区处理:自 Python 3.9 起内置的
zoneinfo模块,完全满足符合 IANA 规范的时区转换,不再需要为了获取 UTC 时间专门引入过时的外部扩展。
第 2 步:测算边缘情况与测试覆盖代价
如果标准库无法直接覆盖需求,下一步需要客观估算手写该逻辑的“真实复杂度”。判定标准是:要让这段代码在生产环境中稳定运行,所需要编写的单元测试与断言行数,是否已经远超函数本身的实现代码?
如果手写仅需 15 行明确代码,且输入输出边界完全封闭(如特定命名规则转换、定制业务字典转换),则毫不犹豫手写;但如果涉及网络抖动规避、指数退避、并发加锁或 RFC 文本解析,表面上的简短实现必定隐藏着巨大的边缘缺陷。
第 3 步:第三方库健康度与依赖深度审查
在决定使用外部库时,必须执行“依赖准入清单”检查,拒绝盲目引入:
- 维护活跃度与更新频次:最近 6 个月内是否有活跃提交?是否支持当前主流的 Python 运行时(如 3.10+)?
- 传递依赖数量(Transitive Dependencies):该库是纯粹的无依赖库(Zero-dependency),还是会连带拉入数十个间接依赖?间接依赖越多,未来的依赖版本冲突(Dependency Hell)概率呈指数级上升。
- 类型注解支持(PEP 561):是否自带
py.typed或提供完整的类型提示?缺失类型支持的库会严重破坏团队的mypy/pyright静态检查链路。
第 4 步:防腐隔离与适配封装(Adapter Pattern)
选型通过并不意味着可以直接在业务逻辑中任意 import。为了防止第三方库未来发生破坏性变更(Breaking Changes)或废弃停更,必须在项目的 core/common/ 目录下建立防腐层适配器(Adapter),统一向业务层暴露项目内部定义的抽象接口。
三、场景实操剖析:简单假象与边缘复杂度激增
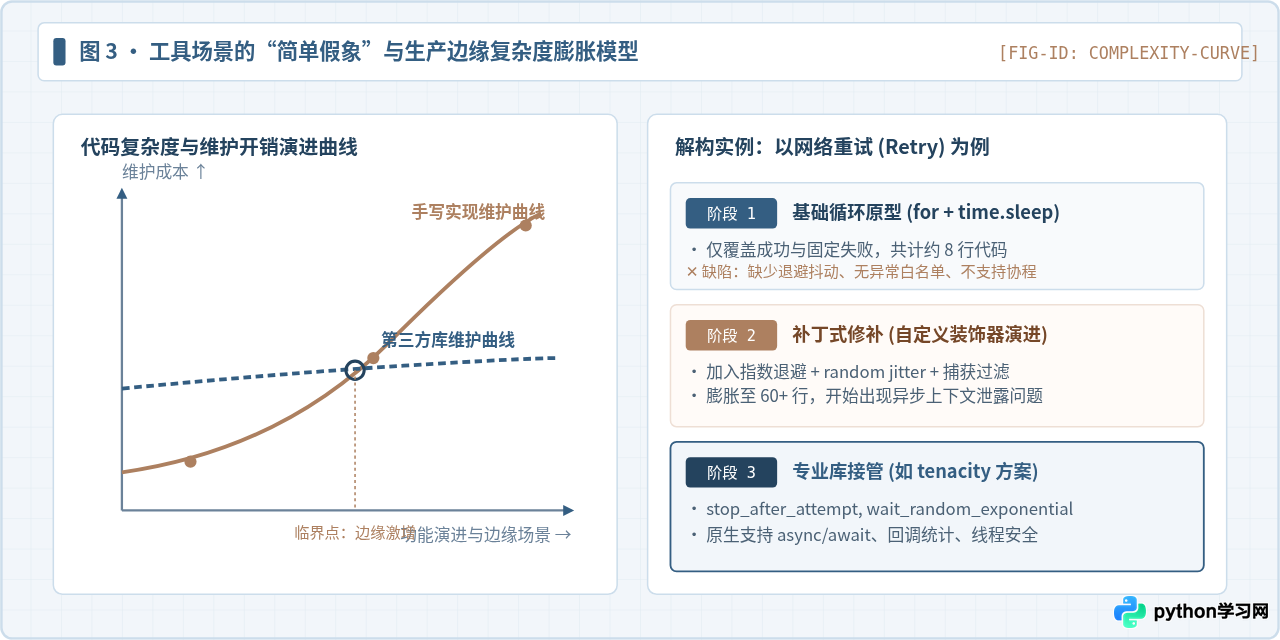
很多手写工具之所以在生产环境中引发故障,往往是因为开发者陷入了“逻辑看似很简单”的初始假象。以下通过两个极其典型的工程案例,展示手写实现向生产级健壮性演进时的膨胀过程。
案例 1:网络重试机制(手写脆弱循环 vs Tenacity 生产级防雪崩)
许多团队为了避免引入外部库,往往在业务层直接手写简单的 for 循环搭配 time.sleep:
import time
import logging

def naive_retry(func, max_attempts=3, delay=1.0):
    """脆弱的手写简单重试:缺少退避算法与异常过滤"""
    for attempt in range(1, max_attempts + 1):
        try:
            return func()
        except Exception as e:  # 盲目捕获所有异常,可能掩盖 KeyboardInterrupt 或致命代码错误
            logging.warning(f"调用失败,重试第 {attempt} 次: {e}")
            if attempt == max_attempts:
                raise
            time.sleep(delay)  # 致命隐患:固定间隔休眠,高并发下导致下游出现惊群效应 (Thundering Herd)
上述简单代码在开发环境下测试往往表现正常,但在高并发微服务场景下会暴露致命隐患:
- 缺少随机抖动(Jitter):当后端服务发生短暂停机恢复时,所有并发请求在同一固定秒数同时重试,瞬间打垮刚重启的下游集群(惊群效应)。
- 异常盲目穿透:捕获了过于宽泛的
Exception,连参数校验错误(如ValueError)这类重试无益的致命错误也进行了无效重试。 - 异步生态割裂:若业务改用
asyncio协程,此同步time.sleep会直接阻塞当前线程的主事件循环。
而若选型引入经过严格验证的开源库 tenacity,并通过内部适配器封装,仅需清晰声明即可具备完整工业级鲁棒性:
from tenacity import (
    retry,
    stop_after_attempt,
    wait_random_exponential,
    retry_if_exception_type,
)
import httpx

# 内部防腐层:集中声明项目级网络调用健壮性规则
network_retry = retry(
    stop=stop_after_attempt(4),
    wait=wait_random_exponential(multiplier=1, max=10), # 指数退避 + 全随机抖动
    retry=retry_if_exception_type((httpx.ConnectTimeout, httpx.NetworkError)),
    reraise=True,
)

@network_retry
def fetch_remote_resource(url: str) -> dict:
    response = httpx.get(url, timeout=5.0)
    response.raise_for_status()
    return response.json()
案例 2:字典深层嵌套更新与数据合并
另一个常见场景是深度合并两个配置字典(Deep Merge)。手写递归版本看似 10 行即可写就,但一旦遇到包含列表、集合合并策略,或数据中存在对象自引用的循环结构时,手写函数极易触发 RecursionError: maximum recursion depth exceeded,造成进程异常崩溃。
针对此类场景:如果只是单层字典浅拷贝,使用 Python 3.9 的字典合并操作符 dict1 | dict2 即可优雅解决;如果涉及高要求的结构解析与校验,直接选用 pydantic 进行模型反序列化,其安全性与报错精准度远超自行编写的深度递归遍历工具。
四、选型规约全景象限与团队落地规范
为了让架构权衡在团队内形成长效机制,可将日常开发中涉及的工具函数归纳为四个象限,作为团队代码评审的硬性规约:
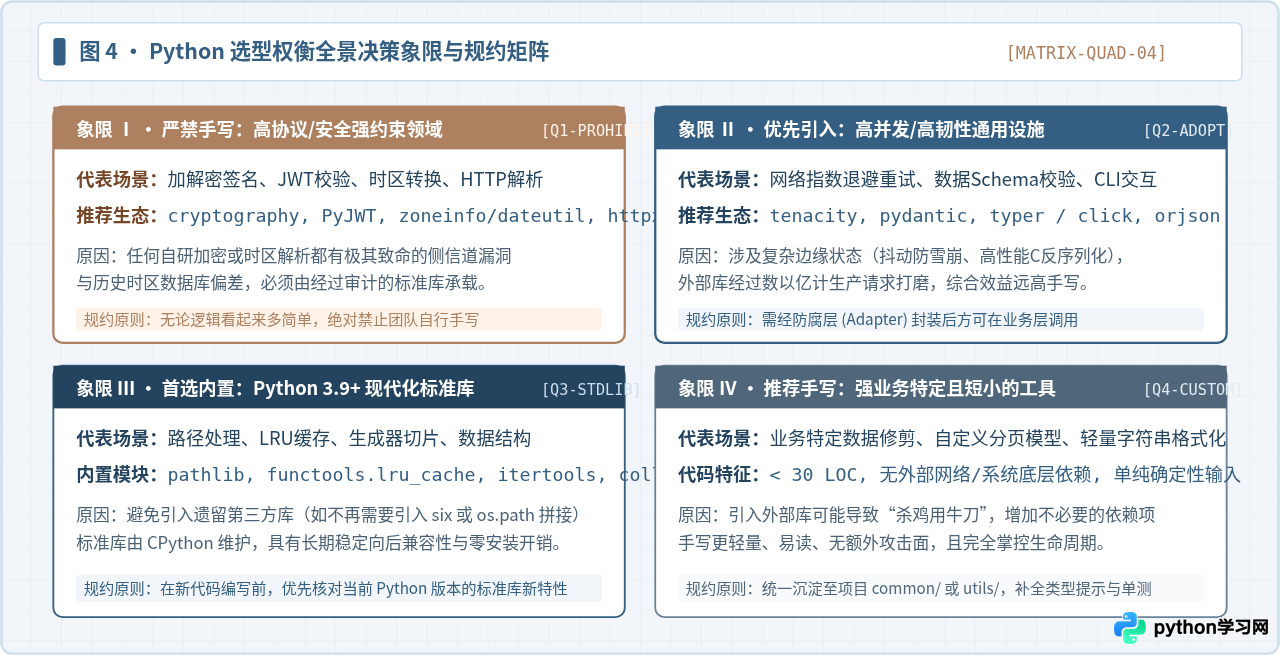
- 拒绝散弹式导入:在业务代码中,严禁在 Controller、Service 或 API 层直接
from third_party_lib import xyz。所有外部通用库必须在项目的core/adapters/或common/中进行一层薄封装,并暴露与业务语义契合的函数名。一旦该第三方库停更或需要切换,团队只需修改适配层单点,无需全项目全局替换。 - 版本锁与确定性构建:生产项目必须使用现代化包管理器(如
poetry、uv或pip-tools)生成带 Hash 校验的锁定文件(如poetry.lock),禁止在生产部署中使用模糊范围约束(如requests>=2.0)。 - 定期自动化依赖体检:在 CI 流水线中集成
pip-audit,持续阻断含有已知 CVE 脆弱性的第三方库流入生产环境。
五、总结:在极简与复用之间寻找动态平衡
Python 语言之所以拥有强大的工程生命力,既得益于其高度凝练、设计优良的标准库,也得益于全球开发者构筑的繁荣开源生态。在手写工具函数与引入第三方库之间,不存在一成不变的万能公式。
优秀的工程实践绝不是盲目追求“零依赖”的极客孤岛,也不是放任依赖树肆意膨胀的臃肿系统。当面对新的工具需求时,始终秉持“先查标准库、再量化复杂度、严审依赖源、封装防腐层”的工程准则,方能在交付效率、运行韧性与长期维护成本之间实现最优的架构平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















