


Python逻辑运算符and/or/not与位运算符&/|/~的区别
深入解析Python中逻辑运算符(and、or、not)与位运算符(&、|、~)的核心差异。从求值原理、短路特性、底层补码到运算符优先级与Pandas实际应用场景,提供系统完整的实用对比指南。
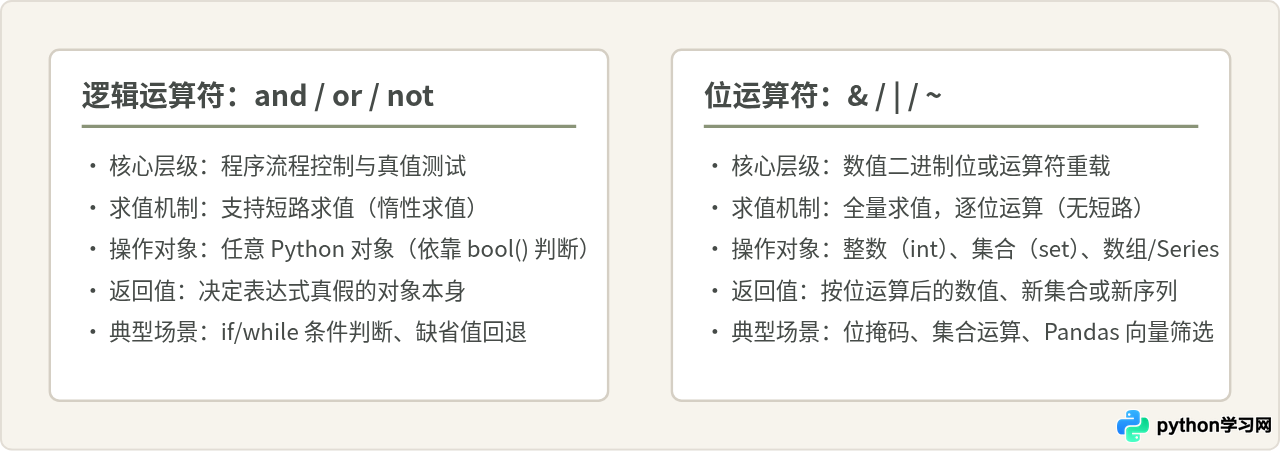
在 Python 中,逻辑运算符(and、or、not)与位运算符(&、|、~)虽然在处理简单的布尔值时常常得出看似一致的结果,但它们在语言底层的设计意图、求值规则、计算层次和运算优先级上存在本质区别。简而言之:逻辑运算符专为“真值测试与分支流程控制”设计,具备短路求值特性,返回决定真假的操作数本身;而位运算符专为“整数二进制位运算或向量化容器”设计,总是全量求值并按位操作。混淆两者的概念,不仅会导致潜在的逻辑漏洞与性能损耗,更会在数据处理(如 Pandas、NumPy)中引发严重的语法或行为错误。
一、为什么两者容易被混淆?
许多初学者乃至有一定开发经验的程序员,最初之所以容易把这两组运算符搞混,主要是因为在最简单的纯布尔运算中,它们表面上的表现完全一致:
print(True and False)   # 逻辑与
print(True & False)     # 按位与
print(True or False)    # 逻辑或
print(True | False) # 按位或这种表面一致性的原因在于:在 Python 中,bool 是 int 的直接子类。在底层,True 对应的整数值是 1,False 对应的整数值是 0。当对 True 和 False 使用位运算符时,实际上是在执行 1 & 0(结果为 0,即 False)或 1 | 0(结果为 1,即 True)。
看似合理并不代表两者可以互换。一旦脱离“孤立的布尔常量”,进入带函数调用的条件分支、整数计算、复杂优先级表达式或第三方数据处理库时,两者的差异会立即显现。
二、求值机制的本质差异:短路求值 vs 全量求值
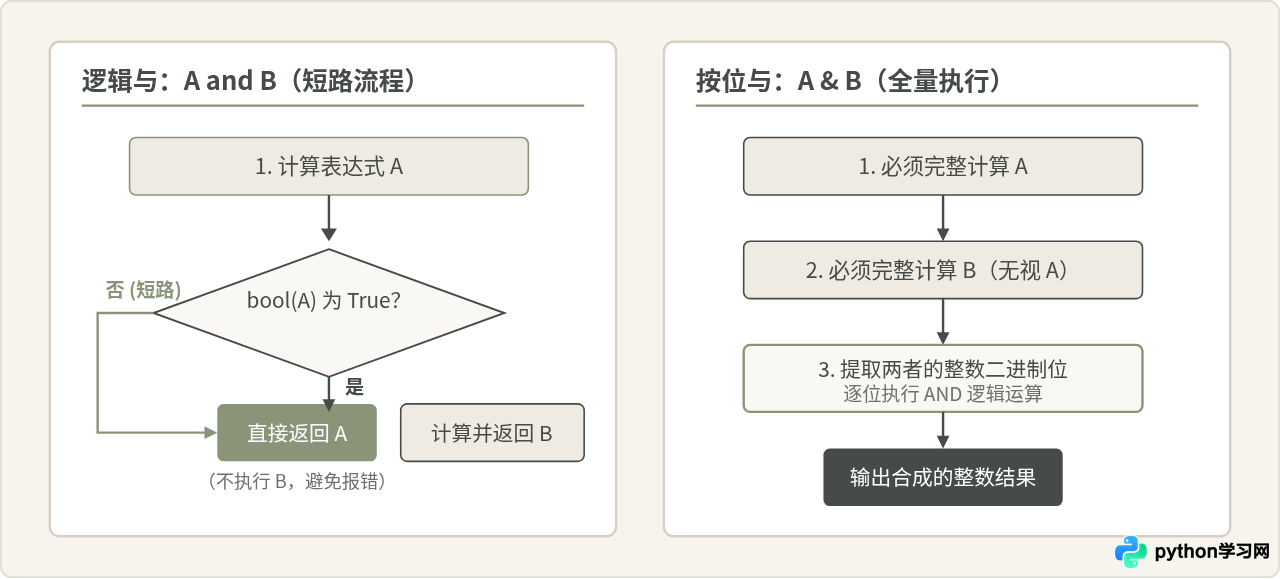
逻辑运算符最显著的特性是短路求值(Short-circuit Evaluation)。Python 解释器在计算逻辑表达式时,一旦已经能确定整个表达式的最终真假,就会立即中断后续子表达式的计算。
A and B:如果A的真值为假(Falsy),整个表达式必定为假,解释器直接返回A,根本不会去计算B。A or B:如果A的真值为真(Truthy),整个表达式必定为真,解释器直接返回A,同样不会去计算B。
相反,位运算符 & 与 | 是常规的算术级别操作符,不支持短路特性。无论左侧操作数是什么,Python 必须先完整计算两端表达式的值,再将它们转换为二进制位逐位比较。
短路特性在日常代码中最经典的用途是防御性空指针检查与避免不必要的昂贵计算。例如下面的例子:
# 场景 1:防御性检查
user_data = None

# 使用逻辑运算符 and:安全
if user_data is not None and user_data["is_active"]:
    print("用户有效")
else:
    print("用户不存在或未激活")

# 如果错误使用位运算符 &:直接崩溃!
try:
    if (user_data is not None) & user_data["is_active"]:
        pass
except TypeError as e:
print(f"发生错误: {e}")在上面的代码中,user_data is not None 为 False。and 在判断出左边为假后立刻停下,不会执行右边的 user_data["is_active"]。但 & 必须同时计算两边,强行对 None 取下标,立刻抛出 TypeError。
三、返回值与底层计算原理
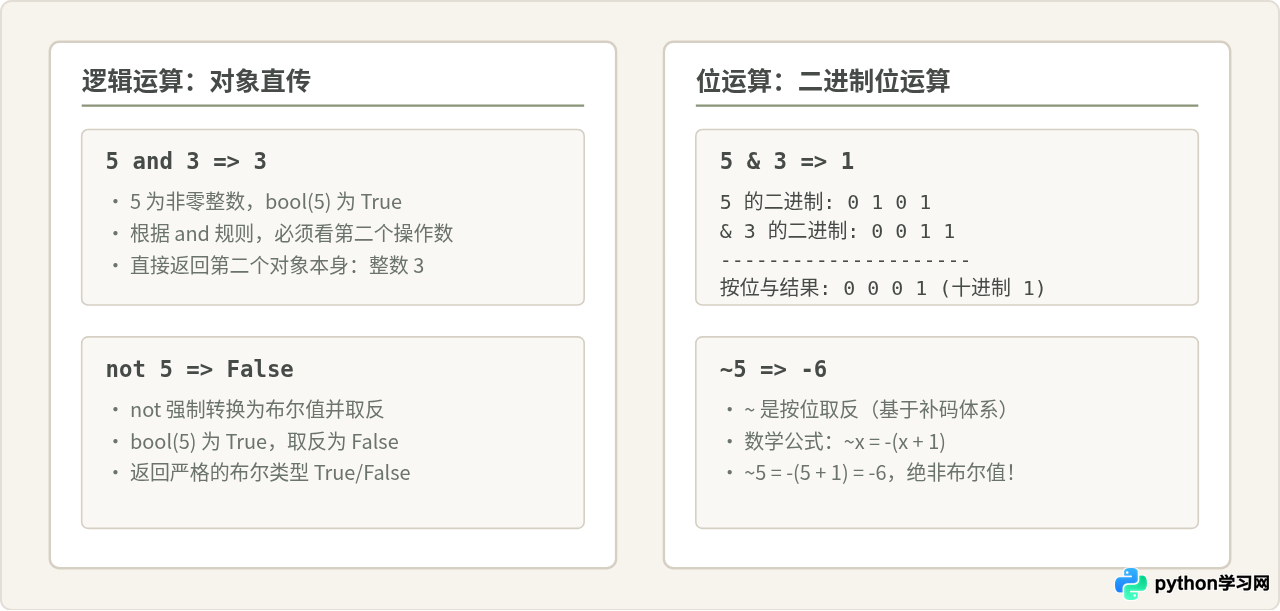
很多人误以为 and 和 or 总是返回布尔值 True 或 False。实际上,Python 逻辑运算符返回的是决定真值结果的操作数对象本身,而位运算符返回的是按位计算后的整数数值。
1. 逻辑与与按位与:5 and 3 与 5 & 3
在 Python 中执行 5 and 3 时,Python 首先计算 bool(5),由于 5 是非零数值,其真值为 True。由于 and 必须确认右侧的真伪,它接着计算 3,并把最后一个表达式的求值结果 3 直接返回。因此 5 and 3 的返回值是数字 3。
而在执行 5 & 3 时,Python 转换为底层二进制补码:0b101 & 0b011。最高位和次高位逐位与,只有最低位同时为 1,得到 0b001,即十进制数字 1。
2. 逻辑非 not 与按位取反 ~
逻辑非 not 总是返回一个严格的布尔值 True 或 False。任何非假对象通过 not 运算后都会变成 False,空对象(如 0、""、[]、None)通过 not 运算后变成 True。
按位取反 ~ 则是纯粹的二进制算术运算。计算机中使用补码表示有符号整数,对整数 x 取反的结果在数学上等价于 -(x + 1):
print(not 5)   # 逻辑非:返回布尔值 False
print(not 0)   # 逻辑非:返回布尔值 True

print(~5)      # 按位取反:-(5 + 1) = -6
print(~0)      # 按位取反:-(0 + 1) = -1
print(~(-1)) # 按位取反:-(-1 + 1) = 0如果在 if 条件语句中误将 not flag 写成 ~flag,即便 flag = True(即 1),~1 的结果是整数 -2。在 Python 的真值判定中,非零整数全部被视为真(True),导致原本期望为假的条件依然通过分支判断!
四、运算符优先级的重大陷阱
在编写组合条件判断时,最隐蔽、最容易导致恶性 Bug 的区别在于运算符优先级。
在 Python 运算符优先级列表中:
- 位运算符(
~、&、^、|)的优先级高于比较运算符(<、<=、>、>=、==、!=)。 - 逻辑运算符(
not、and、or)的优先级低于比较运算符。
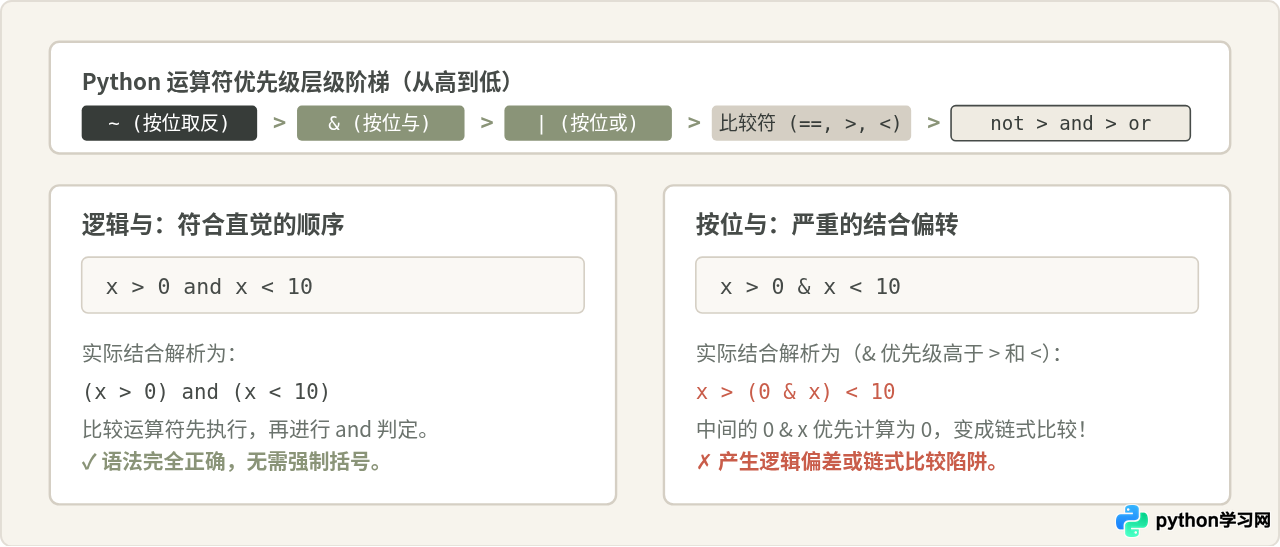
仔细观察上面的解析:当写下 x > 0 & x < 10 时,由于 & 的优先级高于 > 和 <,Python 会优先计算 0 & x,表达式演化为了 x > 0 < 10(即链式比较:x > 0 and 0 < 10)。对于数值 x = 15,它理应落在 0 到 10 之外,但由于 15 > 0 < 10 在数学上两个条件均满足,结果居然返回了 True!
x = 15

# 逻辑与判断:正确识别 15 不在区间内
print(x > 0 and x < 10)  # 输出 False

# 位运算符错误判断:产生了完全错误的结果
print(x > 0 & x < 10) # 等价于 x > (0 & x) < 10,输出 True!五、Pandas 与 NumPy 中的特殊规则:为什么不能用 and/or?
在日常数据科学与工程开发中,一个极为高频的场景是使用 Pandas 或 NumPy 对表格数据进行多条件布尔过滤。几乎所有初学者都会在这里踩坑:
import pandas as pd

df = pd.DataFrame({
    'age': [18, 25, 32, 45],
    'salary': [4000, 9000, 15000, 8000]
})

# 错误写法:直接使用 and
try:
    result = df[df['age'] > 20 and df['salary'] > 5000]
except ValueError as e:
print(f"抛出异常: {e}")为什么 Pandas 必须使用 & / | 并强制加括号?
要深刻理解这个报错,需要明白以下两个底层机制:
- 逻辑运算符无法被重载:Python 语言层面规定,
and、or、not是语言关键字,不允许任何类对其进行重载(Overload)。当执行Series_A and Series_B时,Python 必须把Series_A传入内置的bool()函数以判定其真假。然而一个包含多个布尔值的 Pandas Series 无法直接表示单个真假值(是全部为 True 才算 True,还是只要有一个为 True 就算 True?),因此 Pandas 明确抛出“真值模棱两可(ambiguous)”的异常。 - 位运算符支持特殊方法重载:Python 允许类重载位运算符(如
__and__、__or__、__invert__)。Pandas 和 NumPy 重载了这些魔法方法,将其改造为逐元素的向量化布尔计算(Element-wise Boolean Operation)。 - 必须给每个条件添加圆括号:正如上一节所讲,位运算符优先级高于
>、<等比较运算符。如果不加括号,df['age'] > 20 & df['salary'] > 5000会优先计算20 & df['salary'],导致位运算类型不匹配报错。
# 正确写法:使用位运算符,且每个比较条件都必须用括号包裹
filtered_df = df[(df['age'] > 20) & (df['salary'] > 5000)]
print(filtered_df)六、集合(Set)中的位运算符含义
除了整数和 Pandas/NumPy 数组,Python 内置的集合(set)也重载了位运算符。在这里,位运算符被用作直观的集合代数运算:
set_a & set_b:交集(Intersection),等同于set_a.intersection(set_b)set_a | set_b:并集(Union),等同于set_a.union(set_b)set_a ^ set_b:对称差集(Symmetric Difference,在 A 或 B 中但不同时在两者中)set_a - set_b:差集(Difference)
而在集合上使用 and 或 or,依然只遵循真值测试与短路规则:如果非空则为真,直接返回后一个或前一个集合对象,绝不会产生交集或并集。
七、总结与选型指南
为了在实际编码中迅速准确地选择合适的运算符,可以参考以下决策流程:
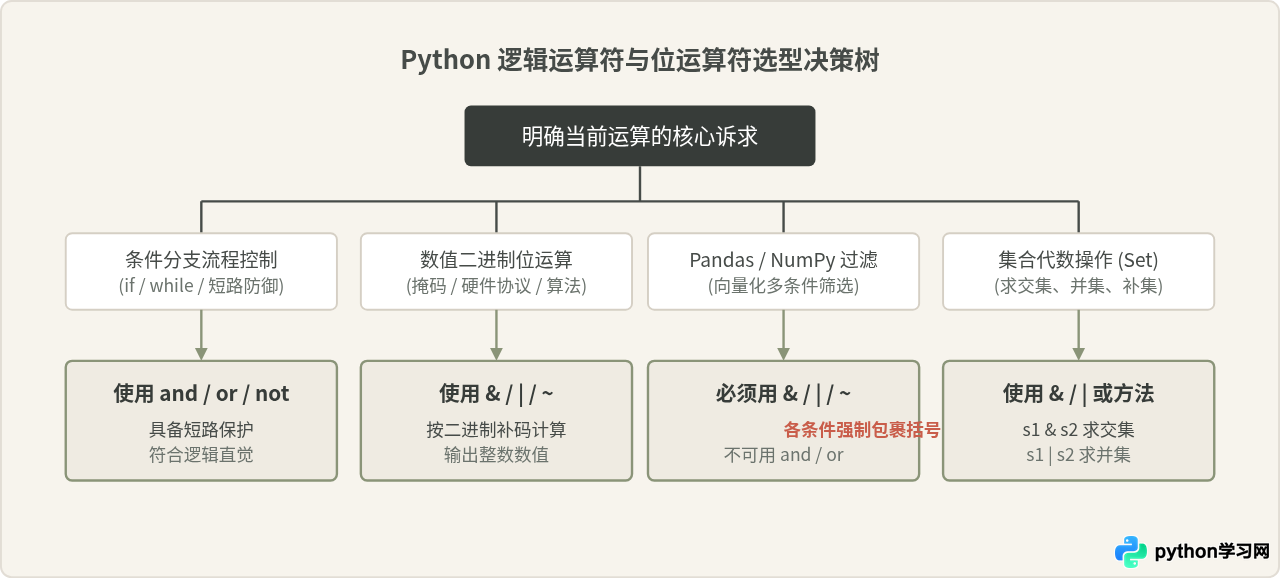
下表综合概括了两类运算符的关键技术特性对照:
| 特性维度 | 逻辑运算符(and / or / not) | 位运算符(& / | / ~) |
|---|---|---|
| 本质功能 | 真值测试(Truth Testing)与逻辑分支控制 | 整数二进制位运算或自定义类型重载操作 |
| 短路特性 | 支持(左侧决定结果时跳过右侧求值) | 不支持(左右两端操作数均完整求值) |
| 运算符优先级 | 低(低于比较运算符 <、>、==) |
较高(高于比较运算符) |
| 返回值类型 | 决定整个表达式真伪的操作数对象本身 | 整数(int)、布尔序列(Series/ndarray)或集合(set) |
| 魔法方法重载 | 不可重载(Python 语言保留关键字) | 可重载(__and__, __or__, __invert__) |
| Pandas 筛选适用 | 抛出 ValueError 异常,无法使用 |
必须使用,且每个子条件必须加小括号 |
掌握这两组运算符的本质区别,能够帮助我们在日常编码中自然避开运算符结合陷阱、空指针短路疏漏以及数据处理时的语法误用,写出既健壮又符合 Pythonic 规范的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















