


影响Python自学速度的关键因素有哪些
深入剖析影响Python自学速度的五大关键因素:明确的目标导向、动手编码与即时反馈、错误排查与调试能力、学习资料的系统收敛,以及核心语言机制的透彻理解,帮助自学者走出低效困境。
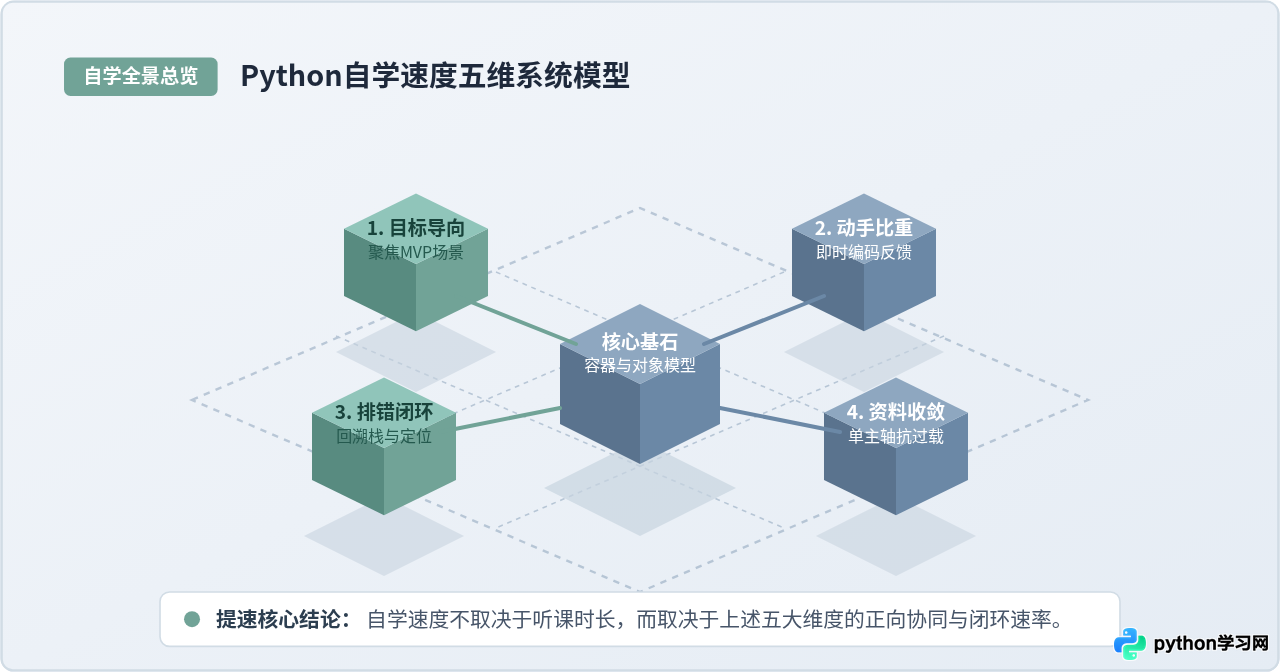
一、学习目标的具体程度:场景驱动还是宽泛泛学
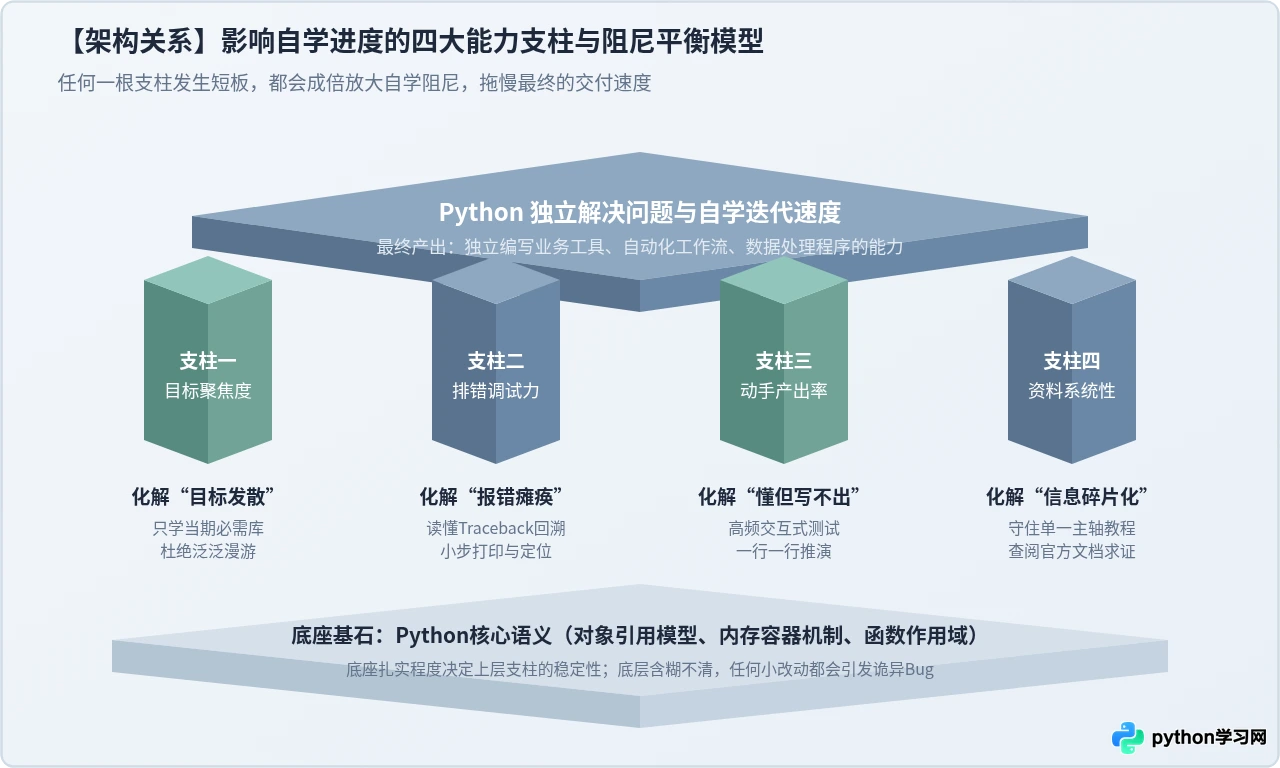
绝大多数初学者自学Python时的第一个阻碍,是制定了“学好Python”或“通读Python教程”这样过于宽泛的目标。Python是一门通用编程语言,应用领域涵盖自动化办公、网络爬虫、数据分析、Web开发、运维脚本以及人工智能等。如果目标仅仅是“学习语法”,学习者就必须同时面对庞杂的概念集合,容易在无尽的知识点中迷失方向,进而产生迟迟无法做出成果的挫败感。
真正能带来高自学速度的,是场景驱动的具体目标。当目标具体到“写一个脚本自动合并当月所有的销售Excel报表”,或者“定时抓取某个技术论坛的热门讨论帖子”时,所需掌握的知识范围瞬间被压缩到了最小可行集(MVP)。此时不需要提前去钻研类继承、元编程或异步协程,只需要聚焦掌握文件IO、循环遍历、字符串处理以及特定的第三方库(如 openpyxl 或 requests)。
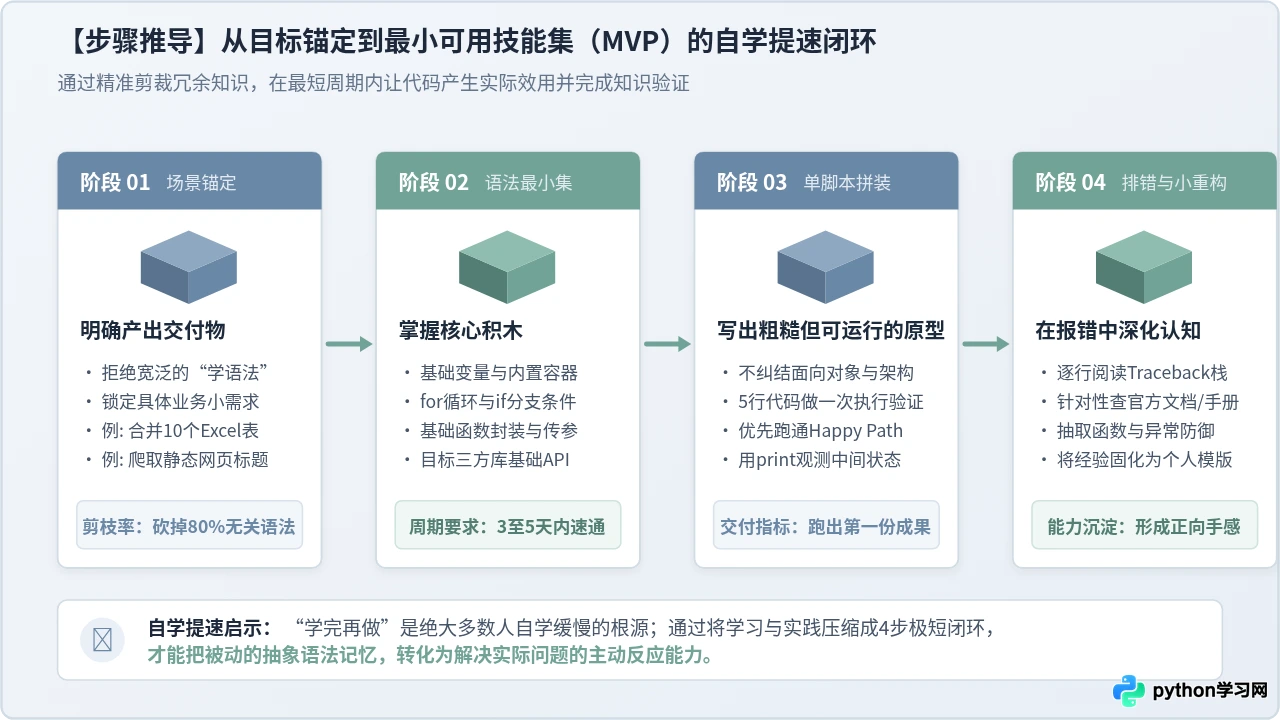
建立高效目标的判定标准非常简单:你的目标能否在两到三周内产出一个能帮自己解决现实问题的小程序?如果能,你的语法学习就会紧紧围绕这个交付物展开,每一段刚学会的代码都能立刻产生效用,自学进度自然显著加快。
二、动手编码与即时反馈的比重:克服“看懂了”的理解假象
在自学Python的过程中,最容易让人产生进展错觉的行为就是连续数天“看视频教程”或“手抄现成代码”。在观看视频或阅读书籍时,讲解者已经梳理好了上下文和逻辑分支,读者的大脑只负责接收信息,这种状态会让人误以为自己“已经掌握”。一旦关闭教程面对空白的代码编辑器,往往一个最简单的字典取值循环都写不出来。
自学速度本质上是由有效代码行数和测试反馈频率决定的。看懂100行代码的吸收效率,远不如自己敲完5行代码并在终端运行、观察输出并尝试修改一个参数来得深刻。
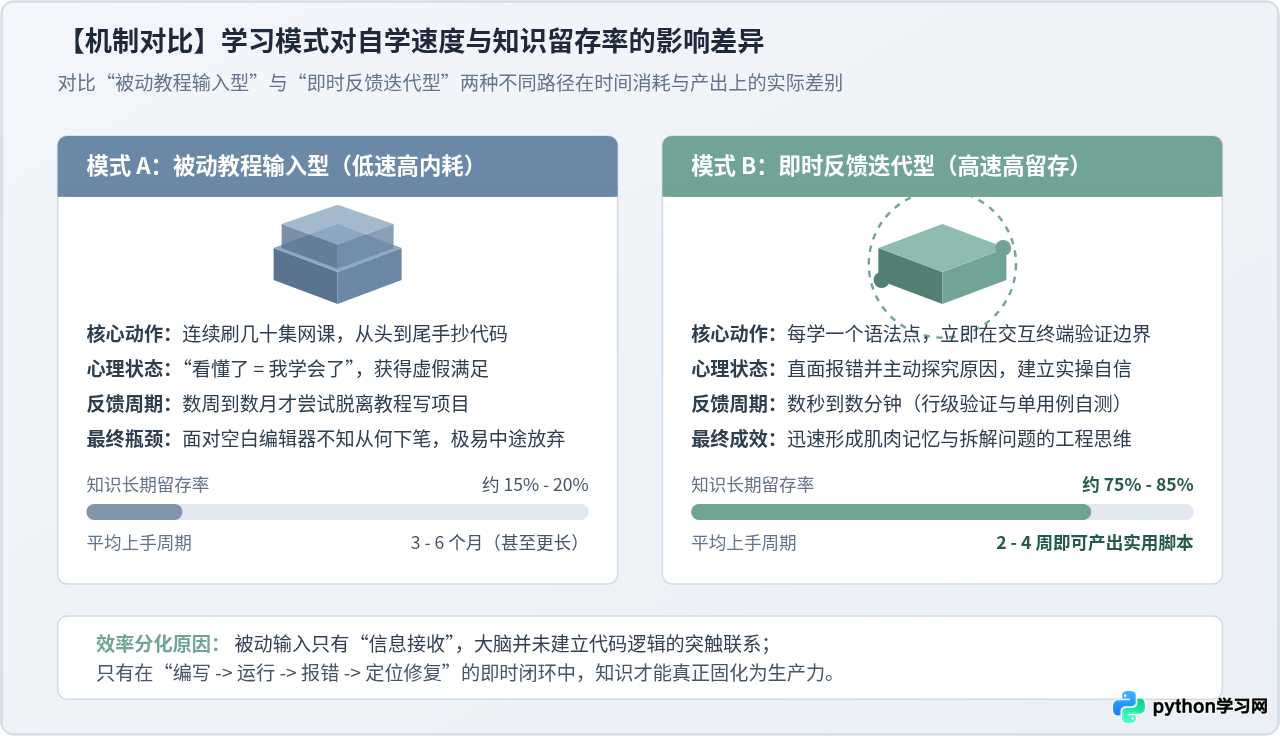
推荐的高效实践方法是使用 IPython 或 Jupyter Notebook 这样的交互式环境。初学者不要试图一口气写完几十行脚本再运行,而是应当把逻辑拆碎成最小单元进行即时验证。
# 示例:通过交互式小步验证,快速理解列表推导式与数据提取
raw_data = ["  item_A: 102  ", "item_B: 88", "  item_C: 215  "]

# 第一步:先验证单条字符串的处理方法,观察中间结果
test_item = raw_data[0].strip()
print("清理空格结果:", test_item)  # 输出示例: 清理空格结果: item_A: 102

# 第二步:验证字符串切分与数值提取
name, val = test_item.split(":")
print("解析键值对:", name.strip(), int(val.strip()))  # 输出示例: 解析键值对: item_A 102

# 第三步:验证无误后,再组织成完整的字典解析逻辑
clean_dict = {
    item.split(":")[0].strip(): int(item.split(":")[1].strip())
    for item in raw_data
}
print("最终汇总字典:", clean_dict)
# 输出示例: 最终汇总字典: {'item_A': 102, 'item_B': 88, 'item_C': 215}三、排查报错与调试的能力:打破卡顿时间的杠杆
如果统计初学者在自学过程中消耗的时间,会发现超过60%的时间并非用于吸收新知识,而是耗费在面对报错信息时的不知所措与漫无目的的盲目试错上。一个缩进错误、一个拼写失误或类型不匹配,在缺乏排查技能的初学者手里可能耗费数小时甚至数天,从而彻底打乱学习节奏。
自学速度快的人,通常很早就建立了对Python回溯栈(Traceback)的阅读习惯。Python的报错信息是非常清晰和规范的,只要掌握了三步排查法,绝大多数问题都可以在两分钟内定位:
- 看最后一行:确认错误的具体类型与描述(例如
KeyError: 'count'或TypeError: unsupported operand type(s))。 - 看倒数第二行:定位报错发生的具体文件名和代码行号,直接跳到对应位置。
- 就地输出变量真实状态:在报错发生的代码行之前,使用
print()打印传入变量的真实值和类型(type(var)),比对实际值是否与你的设想一致。
| 常见异常类型 | 典型发生原因 | 极速排查与验证手段 |
|---|---|---|
NameError |
变量名或函数名拼写错误、变量定义在使用之后、作用域访问越界 | 检查标识符拼写,确认是否在执行赋值语句前就调用了该变量 |
TypeError |
对不合适的对象类型执行了操作(如字符串与整数相加、传参个数不符) | 在操作前加入 print(type(x), type(y)) 确认参与运算的数据类型 |
IndexError / KeyError |
列表索引超出当前长度,或访问了字典中不存在的键 | 检查列表的 len(),字典取值改用安全的 dict.get(key, default) |
AttributeError |
尝试调用的方法或属性在当前对象上不存在(常见于变量为 None) |
打印变量确认是否为 None,用 dir(obj) 检查对象支持的所有属性 |
四、学习资料的聚焦与收敛:抵御信息碎片化过载
随着互联网学习资源的极大丰富,许多自学者的瓶颈已经从“找不到资料”变成了“资料严重过剩”。很多初学者的硬盘里存了四五套不同机构的视频课程、关注了十几个编程公众号、收藏了几十篇语法速查。遇到一个问题换一个教程,结果前三章的“变量与环境安装”看了五遍,后面的实战章节从未完整走完。
自学速度的快慢与资料的数量成反比,与主干资料的专注度成正比。高效的自学者通常遵循“单主轴 + 官方文档查漏”的精简模式:
- 选定单一主轴教程:选择一本口碑扎实、体例严谨的经典书籍(例如面向实践的经典入门教材)或官方入门指南(Python Official Tutorial),以其章节为唯一进度标尺,不轻易中途更换。
- 善用官方权威文档求证:遇到第三方博客讲不清的内置函数细节,直接打开 Python 官方标准库文档(docs.python.org)查阅规范说明与示例,避免被过时或错误的二手文章误导。
- 推迟非必要的高级概念:不要在入门初期去啃复杂的元类编程、深层装饰器封装、描述符协议或过度设计的设计模式。这些语法有其适用场景,但在解决现实业务问题前强行引入,只会徒增认知负荷。
五、底层核心机制的掌握深度:避免后续频繁掉坑
Python以语法平易近人著称,初学者往往很容易写出能运行的代码。但如果完全不理解Python的核心底层语义,后续在复杂数据处理或编写函数时,就会频繁遭遇各种“不可思议”的隐蔽Bug,导致进阶阶段的速度断崖式下跌。
决定自学速度能否平稳持续的底层核心概念主要包括:
1. 对象引用模型与可变/不可变类型
在Python中,一切皆为对象,变量本质上只是指向对象的标签(引用)。不可变类型(如 int, str, tuple)在修改时会创建新对象,而可变类型(如 list, dict, set)则是在原地修改。如果对这一机制缺乏理解,极易写出包含严重副作用的代码。
# 常见隐蔽陷阱示例:将可变对象作为函数默认参数
def append_item(val, container=[]):  # 危险操作!默认参数在函数定义时仅被求值一次
    container.append(val)
    return container

# 预期两次调用各自返回独立列表,实际却共享了同一内存对象
print(append_item(1))  # 输出示例: [1]
print(append_item(2))  # 输出示例: [1, 2] (产生了非预期的状态污染)

# 正确推荐写法:使用 None 作为占位符
def safe_append_item(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container

print(safe_append_item(1))  # 输出示例: [1]
print(safe_append_item(2))  # 输出示例: [2] (行为符合直觉预期)
2. 基础容器的特性与选取依据
列表是顺序存储的连续数组,查询特定元素是否存在需要线性扫描(时间复杂度为 \(O(n)\));而集合(set)和字典(dict)底层基于哈希表实现,成员检查与键检索的平均时间复杂度为 \(O(1)\)。 如果需要对数万条数据进行排重与高频查找,使用列表会导致程序运行极其缓慢,而换用集合就能瞬间完成。理解这些特性,能让初学者在设计逻辑时少走弯路。
六、自学卡点自查与提速决策复盘
在自学Python的长跑中,感到迷茫或进度停滞是完全正常的生理与心理反应。关键在于不要把停滞归咎于“自己不是学编程的料”,而是要建立理性的自查机制,通过系统化的决策诊断找出阻尼来源并快速纠偏。
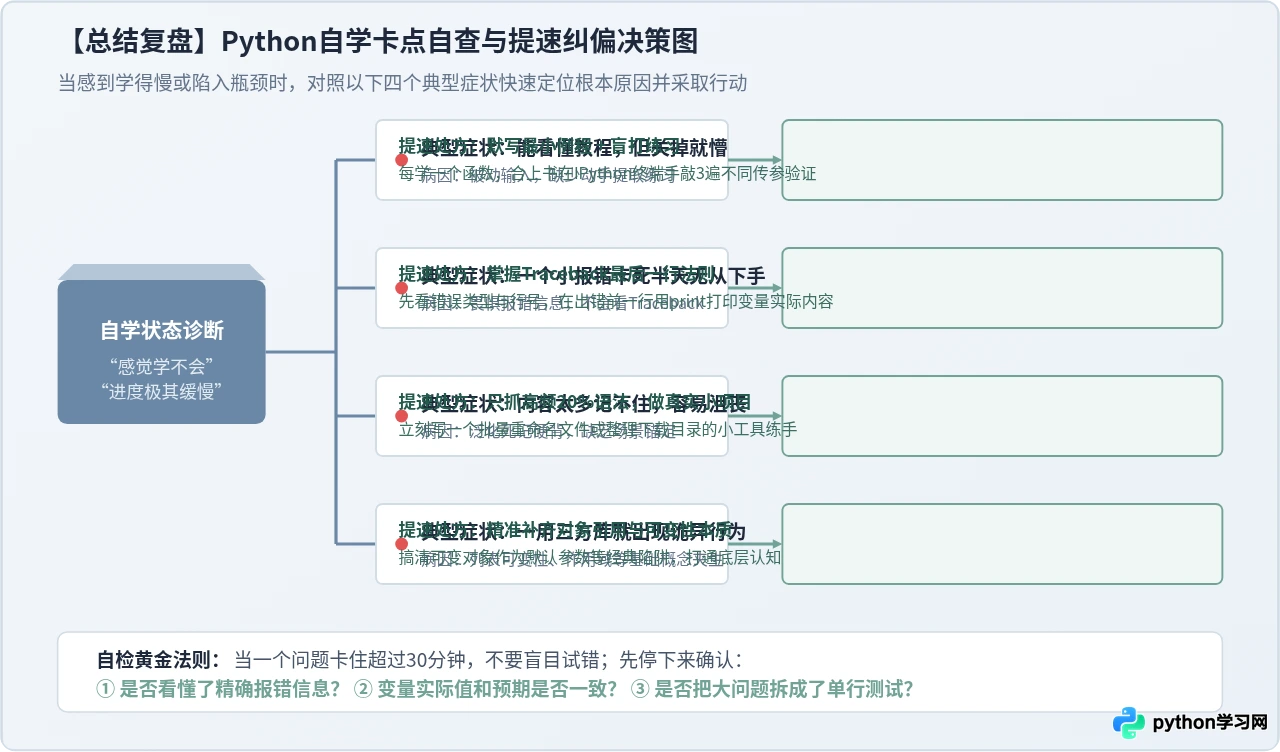
当发现自己的自学进度明显落后于预期时,可以按照以下三个动作进行复盘:
- 检查近3天的代码产出:是不是大部分时间都在被动阅读、看视频或收藏文章?如果是,立刻强迫自己关闭教程,手写一个50行以内的独立小功能。
- 检查报错排查记录:是不是一遇到Traceback就直接去群里提问或盲目重装软件?重新审视报错末行的具体信息,用print把输入输出参数打在屏幕上。
- 检查学习目标切分:是不是试图同时啃下Web全栈、数据挖掘和爬虫多个大方向?退回单一路线,先专注完成一个小工具的端到端交付。
归根结底,Python自学速度从来不是由记忆了多少条语法规则决定的,而是由你在真实场景中运用核心语法、独立调试报错以及持续将小反馈串联成实际产出的效率所决定的。把握住这几个关键因素,自学过程就会从被动苦熬转化为高效、有成就感的正向循环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















