


Matplotlib、Seaborn还是Plotly?Python绘图库选型与代码对比
深入对比Python三大核心绘图库Matplotlib、Seaborn与Plotly的技术架构、选型决策依据与真实代码实现,帮助你在学术出版、统计分析与Web交付中精准选型。
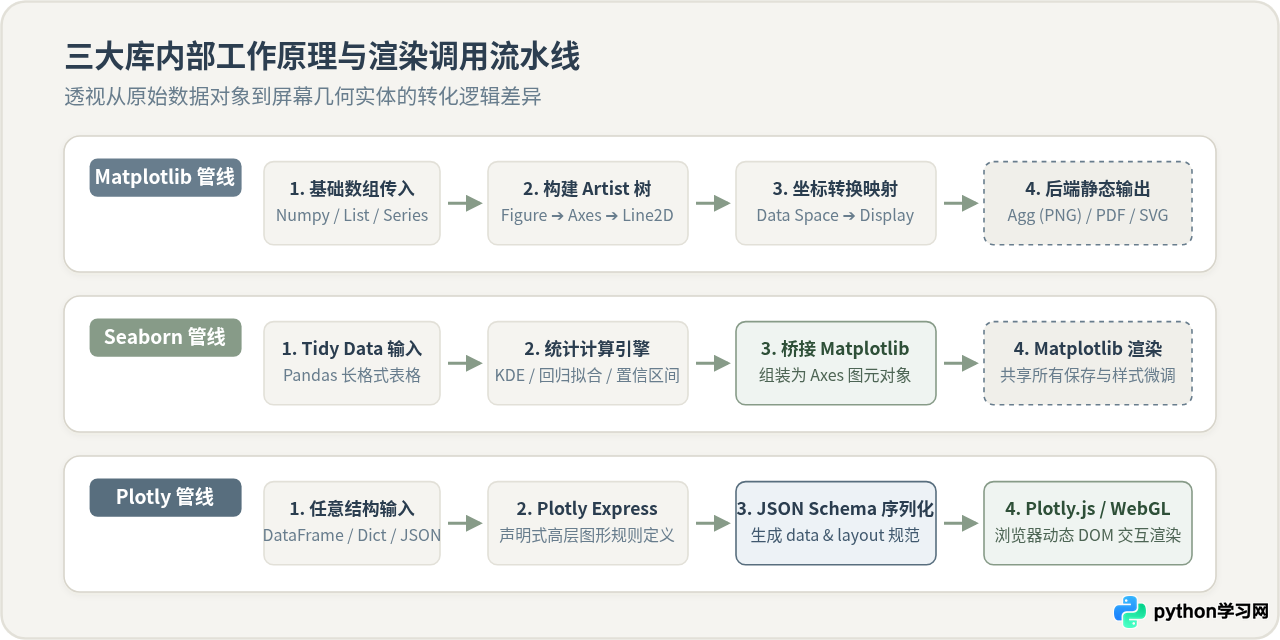
Python 绘图库选型的核心是在控制粒度、统计分析效率与交互交付能力之间进行权衡。对于期刊论文与精密印刷品,具备像素级控制力的 Matplotlib 是事实标准;对于日常数据探索(EDA)与基于 Pandas DataFrame 的统计假设检验,Seaborn 能以极少代码自动完成分组计算与分面排版;而面对 Web 端仪表盘交付、业务汇报或需要悬停、框选下钻的场景,基于 Web 技术的 Plotly 则是首选。本文在一致的数据场景下横向对比三者的代码实现与渲染逻辑,提供明确的选型路径。
一、三大核心绘图库的生态定位与技术架构
很多开发者在初学 Python 可视化时常陷入“工具选择困难”:既然 Matplotlib 能画所有图,为什么还要学 Seaborn?既然 Plotly 的交互效果出色,是否可以直接取代前两者?要理清这些问题,首先需要理解它们在技术架构与生态位上的根本分工。
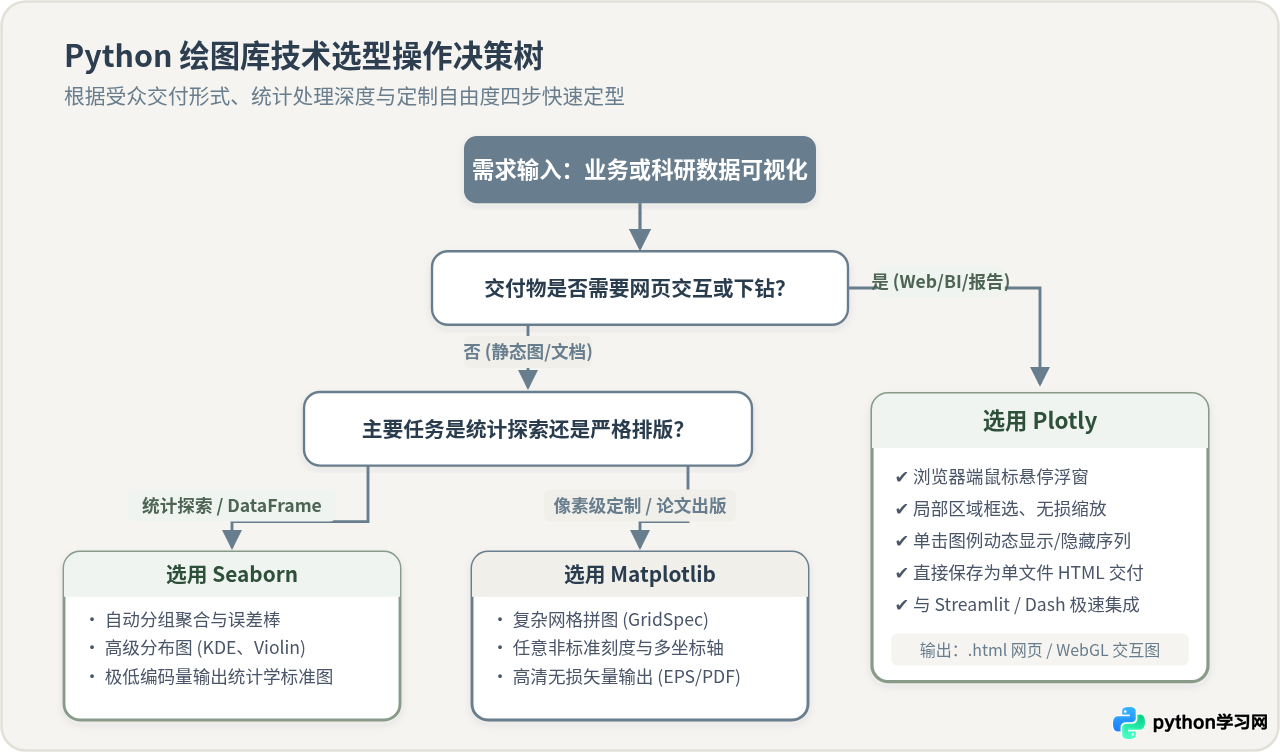
Matplotlib 诞生于 2003 年,其最初设计哲学是“让简单的图表变简单,让复杂的图表变可能”。它是一个面向对象的底层绘图引擎,将图表拆解为 Figure(画布)、Axes(子图轴域)、Axis(刻度轴)和各类 Artist(几何图元)。在 Matplotlib 中,一切视觉要素(哪怕是线段末端的标记或刻度线的外凸长度)都可以被精确定位与修改。这种绝对掌控力使其成为学术出版的基石,但也导致在绘制多分类统计聚合图时,开发者需要手动编写大量的分组、循环与位置偏移计算代码。
Seaborn 并非独立的绘图引擎,而是基于 Matplotlib 的高层统计抽象库。它的核心设计围绕“整洁数据(Tidy Data)”展开,深度契合 Pandas 的 DataFrame 结构。在 Seaborn 中,开发者无需关心图元的坐标位移,只需声明“X 轴是销售额、Y 轴是利润、颜色区分类别”,Seaborn 会在底层调用 Scipy 计算置信区间、拟合核密度估计(KDE),并自动将计算结果映射到底层的 Matplotlib Axes 上。它大幅降低了统计分析的代码量,并提供了符合现代出版美学的默认配色。
Plotly 则代表了现代 Web 数据可视化的另一条路线。Plotly 的 Python 库(特别是常用的 plotly.express)本质上是一个声明式描述生成器。它将 Python 数据结构解析并序列化为标准 JSON 格式,随后交由底层的 plotly.js(基于 D3.js 与 WebGL)在浏览器环境中完成最终渲染。正因如此,Plotly 原生自带缩放、平移、悬停数据提示(Tooltip)以及图例点击隐藏等交互特性,且能天然无缝地嵌入 Web 应用或直接导出为独立的单文件 HTML。
二、技术选型操作决策树
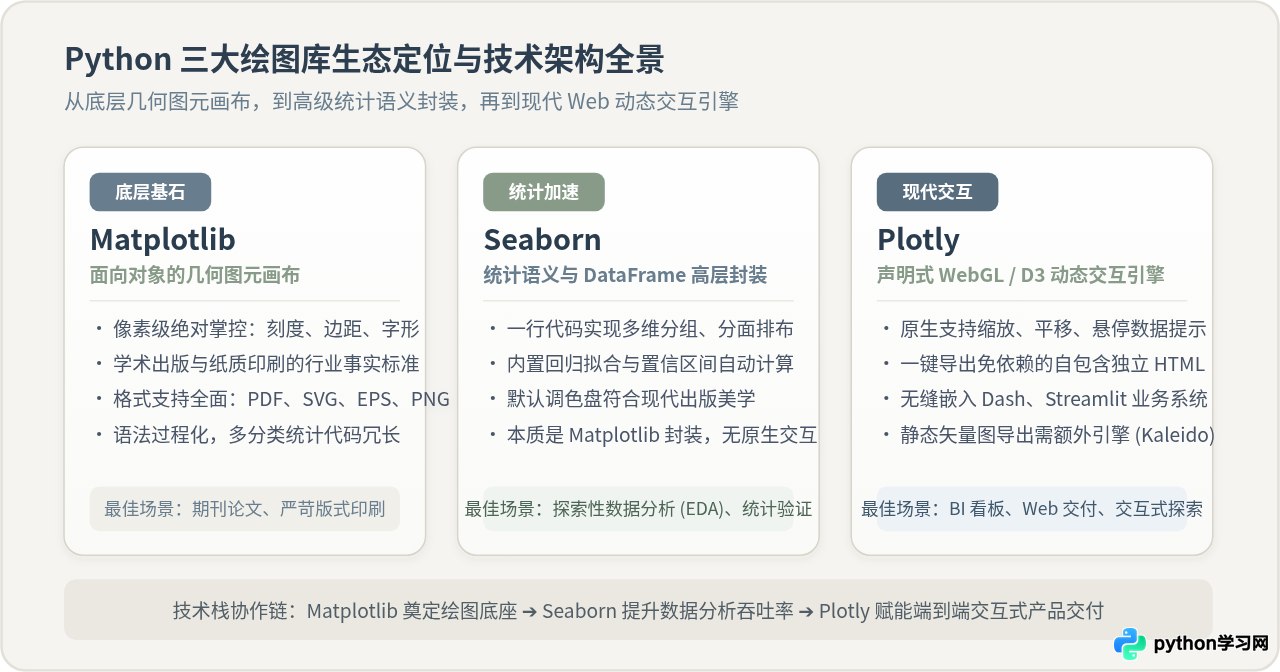
选择绘图库并不取决于“谁更先进”,而取决于你的图表最终向谁交付以及数据探索的阶段。以下是技术选型时推荐的判断流程:
- 第一步:审视交付终端与交互需求。 如果图表需要交付给业务管理层、嵌入 Web 应用系统(如 Streamlit、Dash、Django),或者需要用户通过鼠标悬停查看明细、框选局部缩放,应直接选择 Plotly。为静态图片附加交互脚本在工程上成本极高,而 Plotly 原生开箱即用。
- 第二步:若交付物为静态文档,审视统计分析复杂度。 如果你的主要工作是探索性数据分析(EDA)、观察变量间分布规律(如箱线图、小提琴图、双变量 KDE、回归趋势),且数据以 Pandas DataFrame 组织,应首选 Seaborn。它能将数十行 Matplotlib 统计处理代码压缩至 1 至 2 行。
-
第三步:若涉及非标准排版或出版级矢量交付,坚守 Matplotlib。
当需要向顶级期刊投稿、印刷书籍,或者需要拼接复杂不对称的网格布局(如
GridSpec跨行跨列)、绘制双 Y 轴/断裂坐标轴、对字体与线条进行毫米级校准时,Matplotlib 是唯一能够提供完全确定性结果的工具。
三、统一基准下的代码实现对比
为了客观展示三者的语法风格与抽象差异,我们设定一个统一的业务分析场景:生成一份包含 300 条销售记录的测试数据集,字段包含商品类别(category)、销售渠道(channel)、销售额(sales)和利润(profit)。
# 统一环境与基准测试数据准备
import numpy as np
import pandas as pd

np.random.seed(42)
n_samples = 300
categories = np.random.choice(["电子数码", "日用百货", "办公用品"], size=n_samples)
channels = np.random.choice(["线上直营", "经销商分销"], size=n_samples)
sales = np.random.gamma(shape=3.0, scale=400.0, size=n_samples) + 200
profit_margin = np.random.normal(loc=0.18, scale=0.06, size=n_samples)
profit = sales * profit_margin + np.random.normal(0, 20, size=n_samples)

df = pd.DataFrame({
    "category": categories,
    "channel": channels,
    "sales": np.round(sales, 2),
    "profit": np.round(profit, 2)
})
场景 1:多分类分组分布对比(分组箱线图)
任务目标:比较不同商品类别在不同销售渠道下的利润分布情况,观察中位数、四分位距与异常值。
1. Matplotlib 实现:
import matplotlib.pyplot as plt

# Matplotlib 需要手动管理分类坐标偏移与循环绘制
fig, ax = plt.subplots(figsize=(8, 5), dpi=100)

cats = df["category"].unique()
channels_list = df["channel"].unique()
width = 0.35
positions_base = np.arange(len(cats))

colors = {"线上直营": "#687D8D", "经销商分销": "#879B88"}

for idx, ch in enumerate(channels_list):
    group_data = [df[(df["category"] == c) & (df["channel"] == ch)]["profit"].values for c in cats]
    pos = positions_base + (idx - 0.5) * width
    bp = ax.boxplot(
        group_data, positions=pos, widths=width * 0.85, patch_artist=True,
        boxprops=dict(facecolor=colors[ch], color="#2C3E50", alpha=0.8),
        medianprops=dict(color="#B22222", linewidth=1.5),
        flierprops=dict(marker="o", markersize=4, markerfacecolor="#718096")
    )

ax.set_xticks(positions_base)
ax.set_xticklabels(cats, fontfamily="PingFang SC")
ax.set_title("利润分布对比 (Matplotlib 手动分组)", fontsize=13, fontfamily="PingFang SC")
ax.set_xlabel("产品品类", fontfamily="PingFang SC")
ax.set_ylabel("利润 (元)", fontfamily="PingFang SC")
ax.grid(axis="y", linestyle="--", alpha=0.5)

# 手动构造图例
from matplotlib.patches import Patch
legend_handles = [Patch(facecolor=colors[ch], label=ch) for ch in channels_list]
ax.legend(handles=legend_handles, title="渠道")

plt.tight_layout()
plt.show()
代码特点分析:在 Matplotlib 中,ax.boxplot 本身不理解 DataFrame 的分类语义,无法通过 hue 参数直接区分渠道。开发者必须先手动筛选子数据集,精确计算每个箱体在 X 轴上的绝对位置偏移量(positions_base + (idx - 0.5) * width),并手动创建 Patch 组装图例。虽然控制度极高,但在日常分析中开发成本显著增加。
2. Seaborn 实现:
import seaborn as sns
import matplotlib.pyplot as plt

# 设置字体支持中文与现代网格风格
sns.set_theme(style="whitegrid", font="PingFang SC")

plt.figure(figsize=(8, 5), dpi=100)
ax = sns.boxplot(
    data=df,
    x="category",
    y="profit",
    hue="channel",
    palette=["#687D8D", "#879B88"],
    width=0.6,
    fliersize=4
)
ax.set_title("利润分布对比 (Seaborn 语义化声明)", fontsize=13)
ax.set_xlabel("产品品类")
ax.set_ylabel("利润 (元)")

plt.tight_layout()
plt.show()
代码特点分析:Seaborn 将整个统计流程浓缩为声明式调用:通过 x、y、hue 三个参数绑定字段,函数内部自动完成多重子集切片、间距排布与图例构建。代码行数缩减超过 60%,且箱体边框与异常点样式经过美学微调,直接满足工作报告水准。
3. Plotly 实现:
import plotly.express as px

fig = px.box(
    df,
    x="category",
    y="profit",
    color="channel",
    color_discrete_sequence=["#687D8D", "#879B88"],
    title="利润分布对比 (Plotly 交互式呈现)",
    points="outliers",  # 显式标出异常值
    labels={"category": "产品品类", "profit": "利润 (元)", "channel": "销售渠道"}
)

# 微调交互界面布局
fig.update_layout(
    template="plotly_white",
    font=dict(family="PingFang SC, sans-serif"),
    boxmode="group"  # 并列分组
)

# 在 Jupyter 中直接渲染,或保存为独立 HTML
fig.write_html("profit_distribution_plotly.html")
# fig.show()
代码特点分析:Plotly Express 的代码简洁度与 Seaborn 处于同一水平,但生成的产物是完全动态的:当鼠标悬停在箱线上时,会即时弹出包含“上四分位数、中位数、下四分位数、极大值”的浮窗;双击右侧图例可以单独隔离某一渠道;还可以直接利用工具栏框选放大指定区间的异常点。
场景 2:多维特征关联与回归趋势(带置信区间的散点回归)
任务目标:分析销售额(sales)与利润(profit)之间的相关性,按渠道着色,并拟合回归趋势线与不确定性置信区间。
1. Matplotlib 做法:需要手动调用 numpy.polyfit 分组拟合一元一次方程,计算标准误差方程绘制区间阴影,再组合 ax.scatter 与 ax.plot,代码量通常在 30 行以上。
2. Seaborn 做法:一行 sns.lmplot 即可同时完成分组散点、线性拟合以及 95% Bootstrap 置信区间阴影绘制:
import seaborn as sns
import matplotlib.pyplot as plt

g = sns.lmplot(
    data=df,
    x="sales",
    y="profit",
    hue="channel",
    palette=["#687D8D", "#879B88"],
    col="category",      # 自动按品类进行分面网格绘制
    height=3.8,
    aspect=0.95,
    scatter_kws={"alpha": 0.6, "s": 30}
)
g.set_axis_labels("销售额 (元)", "利润 (元)")
g.set_titles(col_template="品类: {col_name}")
plt.show()
关键优势:Seaborn 的 lmplot 原生整合了统计推断能力与分面绘图系统(Faceting),在探索多变量交互作用时效率远超底层库。
3. Plotly 做法:
import plotly.express as px

# 需确保安装 statsmodels: pip install statsmodels
fig = px.scatter(
    df,
    x="sales",
    y="profit",
    color="channel",
    facet_col="category",
    trendline="ols",      # 调用内部 OLS 普通最小二乘回归拟合
    color_discrete_sequence=["#687D8D", "#879B88"],
    title="销售额与利润多维关联分析 (带 OLS 趋势拟合)",
    labels={"sales": "销售额", "profit": "利润", "category": "品类"}
)
fig.update_layout(template="plotly_white")
fig.show()
关键优势:Plotly 的趋势线不仅可视化绘制,鼠标悬停在回归线上时还会直接显示拟合方程斜率、截距以及 R² 确定系数,极大提升了业务汇报中数据讲解的便利度。
四、关键差异与工程边界:为什么不能用一套库通吃?
理解了语法层面的差异后,在实际工程选型中,还必须注意以下三个维度的技术边界:
1. 输出产物与运行时依赖
- Matplotlib / Seaborn:产物是纯粹的栅格图像(PNG、JPEG)或矢量图文件(PDF、SVG、EPS)。生成图表是在 Python 服务端完成所有像素或矢量坐标计算,客户端不需要任何额外的 JavaScript 运行时环境。
-
Plotly:产物本质是带有包含图表描述 JSON 与
plotly.js脚本标签的 HTML DOM 节点。这使得它能与现代前端轻松集成,但若要导出为高质量的印刷用矢量 PDF 或静态高分辨率 PNG,必须依赖额外的静态渲染服务(如安装kaleido库)。
在无头服务器(Headless Linux)或自动化报告脚本中,调用 fig.write_image("chart.png") 需要预先执行 pip install -U kaleido。若缺少底层渲染引擎支持,脚本将直接抛出运行时异常。
2. 数据吞吐量与性能瓶颈
当数据量达到数十万点甚至数百万点时,三者的表现截然不同:
-
Matplotlib:在处理 100 万点散点图时,虽然渲染耗时可能需要数秒,但一旦绘制完成并栅格化为位图,内存即可释放,导出文件体积固定。同时可通过
rasterized=True实现“坐标轴矢量、内部百万散点栅格化”的混合高效导出。 - Seaborn:由于内置了置信区间等复杂的统计核算(如大量 Bootstrap 重采样),在面对超大样本时统计计算阶段会出现显著耗时,建议先对数据进行下采样(Downsampling)或预聚合。
-
Plotly:标准
px.scatter会为每个数据点生成 DOM 节点与事件绑定。当点数超过 5 万点时,浏览器页面将出现明显的卡顿甚至崩溃。对于十万级别以上的大数据,必须切换为 WebGL 硬件加速 API:使用go.Scattergl替代默认的go.Scatter。
3. 实战策略:Seaborn 与 Matplotlib 的混合协作
在实际生产中,Seaborn 与 Matplotlib 并非互斥关系。由于 Seaborn 的绘图函数均接受一个 ax 参数,并返回当前的 Matplotlib Axes 实例,最推荐的实战模式是:“用 Seaborn 负责数据统计与高层着色,用 Matplotlib 原生 API 完成后续的精细刻度与文字标注微调”。
# Seaborn + Matplotlib 联合开发示例
fig, ax = plt.subplots(figsize=(7, 4.5), dpi=120)

# 1. 由 Seaborn 完成复杂的统计核密度与直方图绘制
sns.histplot(
    data=df, x="profit", hue="category", kde=True,
    palette="Set2", ax=ax, element="step"
)

# 2. 借助 Matplotlib 原生能力做精细排版微调
ax.set_title("利润分布与核密度曲线", fontsize=12, pad=12)
ax.axvline(df["profit"].median(), color="#B22222", linestyle="--", linewidth=1.2)
ax.text(
    df["profit"].median() + 5, ax.get_ylim()[1] * 0.85,
    f"中位数: {df['profit'].median():.1f} 元",
    color="#B22222", fontsize=10, fontfamily="PingFang SC"
)
ax.spines["top"].set_visible(False)
ax.spines["right"].set_visible(False)

plt.tight_layout()
plt.show()
五、综合选型建议总结
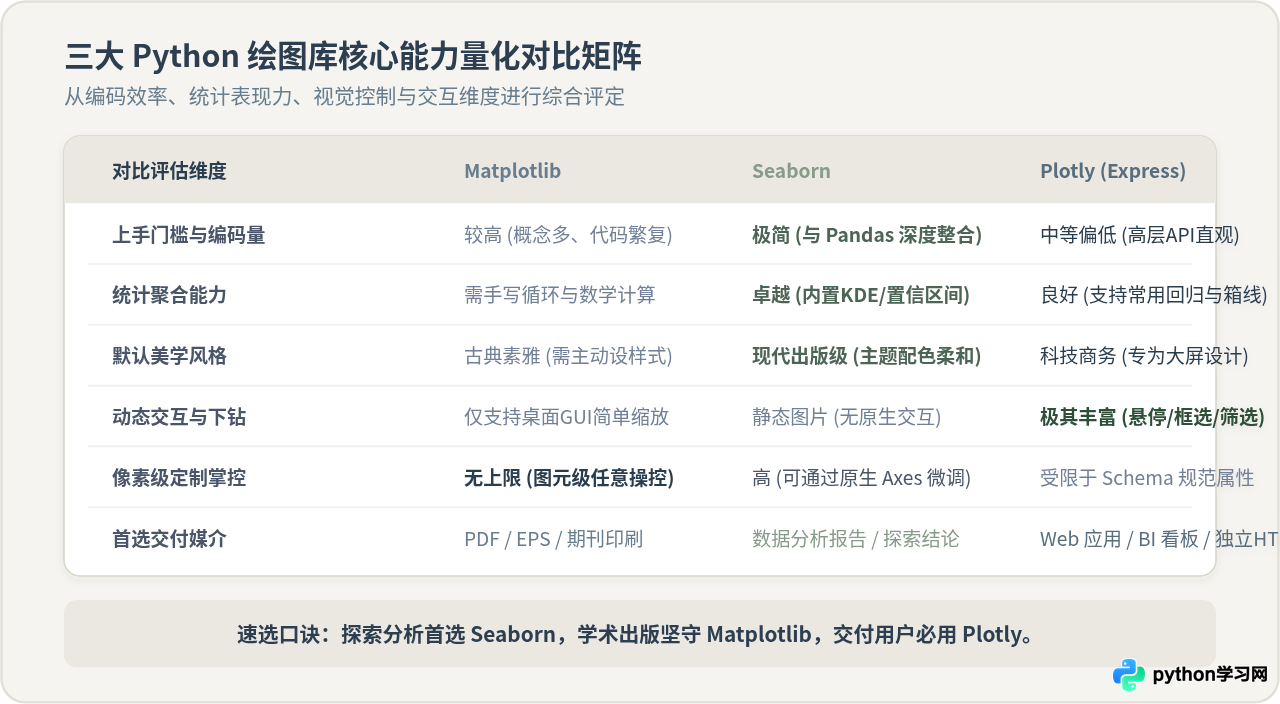
| 评估项目 | Matplotlib | Seaborn | Plotly |
|---|---|---|---|
| 核心设计哲学 | 低级图元装配画布 | 统计语义与长表映射 | 声明式规范与Web交互 |
| 最强优势 | 版面控制力极高、排版严苛 | 一行代码出统计多变量图 | 开箱即用的悬停/缩放交互 |
| 主要局限 | 分类统计编码极其繁琐 | 无法直接生成动态交互图 | 矢量离线导出需配置环境 |
| 典型交付载体 | 学术论文 (PDF)、图书出版物 | Jupyter Notebook、分析结论总结 | 商业 BI、Streamlit/Dash 平台 |
| 学习与使用建议 | 掌握面向对象 API 备用微调 | 日常数据分析与建模探索主力 | 需向他人展示与业务交付首选 |
归纳而言,工具的选择始终服务于最终的目标受众:如果你的读者是审稿人或纸质书读者,Matplotlib 能确保版面无可挑剔;如果你的任务是在探索期快速洞察特征规律,Seaborn 能让你把精力集中在数据本身而非绘图代码上;而如果你的受众是业务伙伴、决策层或需要自助探索的终端用户,Plotly 提供的沉浸式交互则是无出其右的最佳媒介。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















