


怎么解决Python中文NLP中的乱码与编码错误问题
深入解析Python中文自然语言处理(NLP)中的乱码与编码错误成因,提供基于Unicode三明治模型的全流程排查步骤、代码规范与编码标准对比方案。
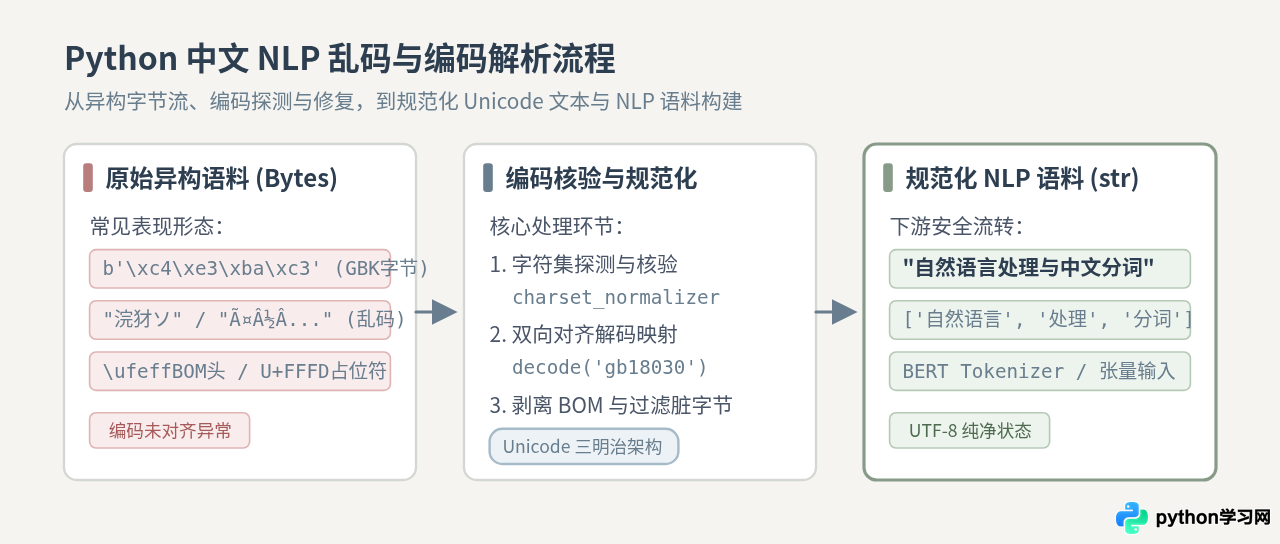
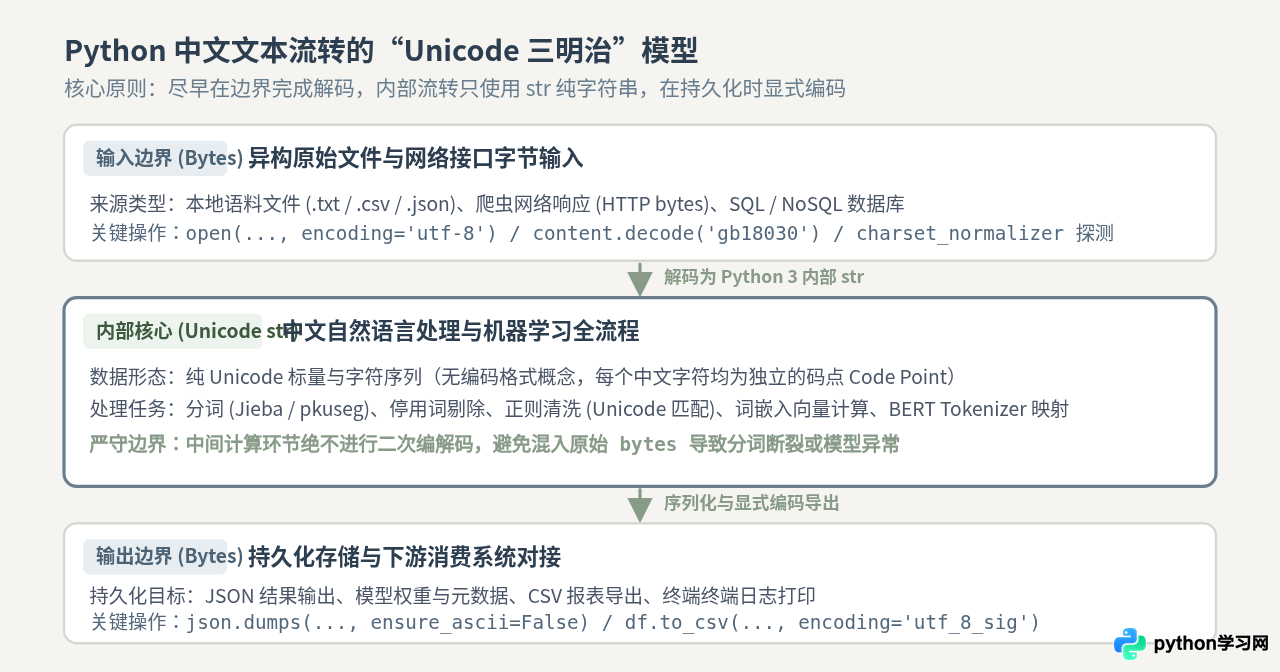
Python 3 内存中的所有字符串均为纯 Unicode(str 类型),中文 NLP 中的乱码与编码错误并非算法缺陷,而是在程序 I/O 边界发生了“字节序列(bytes)与字符(str)解码映射不对齐”。解决这一问题的通用路径是践行“Unicode 三明治”模型:在语料读取与采集的第一时间,显式识别并完成从原始字节到 Unicode 字符串的解码;在分词、清洗与建模等中间计算环节,保持纯 str 流转;在导出与持久化时,统一采用标准的 utf-8 或兼顾办公软件的 utf-8-sig 显式编码写出。
搞清乱码本质:Unicode 字符串与字节流的转换断层
在中文自然语言处理任务中,语料往往来自异构数据源:历史网页存档、论坛爬虫、Windows 办公导出的 CSV 报表、不同版本数据库以及团队成员协作传递的文本文件。这些数据在磁盘或网络上传输时,本质上只是一串串由十六进制组成的字节序列(bytes)。Python 解释器本身并不知道这些字节代表什么,必须依靠开发者指定的“字符编码映射表”来把字节解释为对应的字符。
很多初学者容易混淆 str 与 bytes 的分界线。在 Python 3 中,str 是抽象的字符序列,具有唯一的 Unicode 码点(Code Point,如汉字“中”的码点为 U+4E2D),并不存在所谓“GBK 格式的 str”或“UTF-8 格式的 str”;只有当它被序列化为 bytes 时,才具体体现为 b'ÖÐ'(GBK 编码,2 字节)或 b'ä¸'(UTF-8 编码,3 字节)。一旦读取文件时给定了错误的解码方案,字节序列就会被映射到错误的字符码点上,产生“乱码(Mojibake)”;若该字节序列在目标编码表中根本不存在合法对应,解释器便会立即抛出 UnicodeDecodeError。
常见报错特征与逆向诊断排查
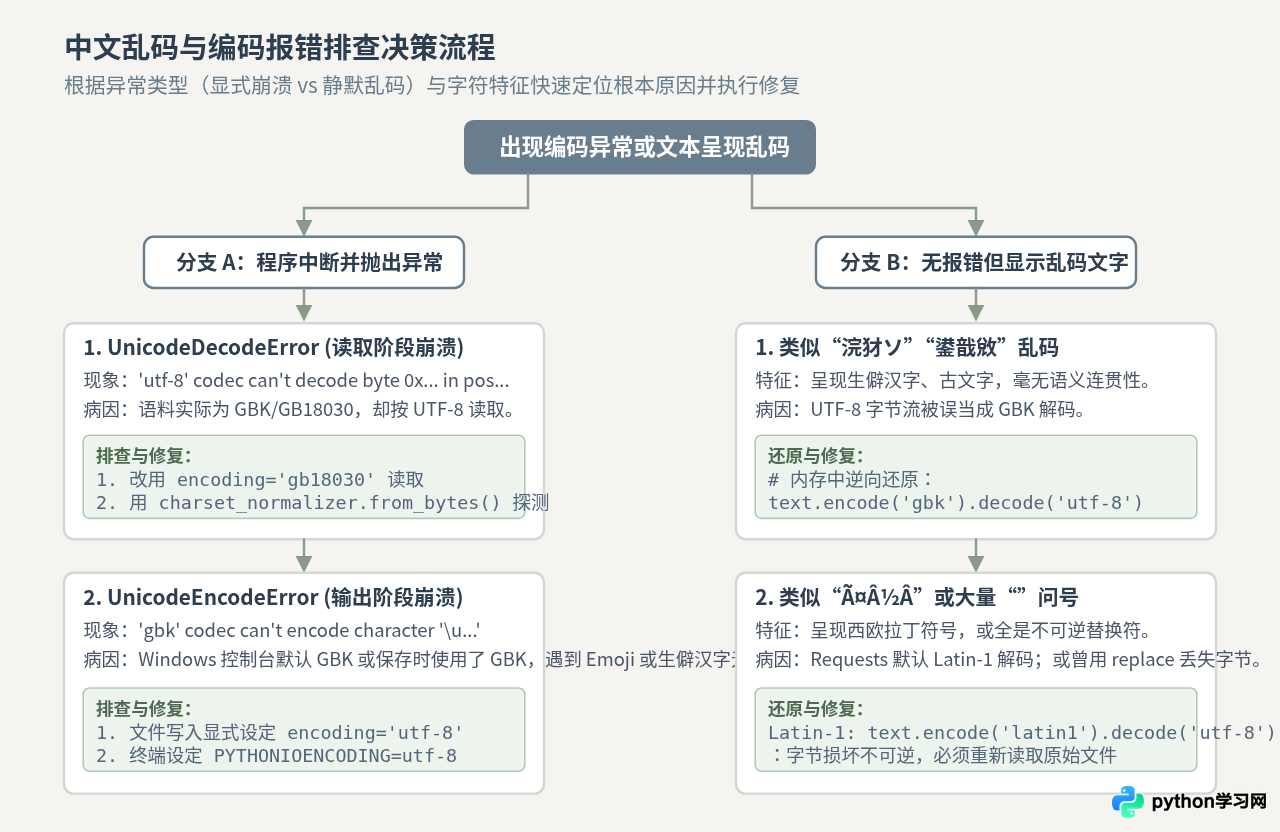
排查中文编码故障,应先区分是“程序崩溃抛出异常”还是“程序正常运行但文字呈现视觉乱码”。两类现象指向不同的排查节点。
1. 程序抛出异常:UnicodeDecodeError 与 UnicodeEncodeError
UnicodeDecodeError(读取阶段失败):典型报错形如 UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc4 in position 0: invalid start byte。这表明代码正在使用 UTF-8 规则去解析一段并非 UTF-8 格式的字节流(通常是 GBK、GB2312 或 GB18030 语料)。UTF-8 规定多字节序列的首字节必须符合特定前导位规则,当遇到如 0xc4 这种不合法的起始字节时,解码器便立即中断。
UnicodeEncodeError(写入或控制台输出失败):典型报错形如 UnicodeEncodeError: 'gbk' codec can't encode character '' in position 15: illegal multibyte sequence。这发生在将内存中的 Unicode 字符串写出为特定字节流的阶段。例如,在 Windows 默认 GBK 编码的代码页终端执行 print() 含有零宽空格、Emoji 表情或特殊冷僻汉字的文本时,由于 GBK 字符集没有收录这些码点,转换器无法映射而触发异常。
2. 静默视觉乱码特征与其修复可行性
如果读取时没有抛错,但文本输出呈现出怪异符号,通常是编码与解码规则发生了交叉错位。以下是中文处理中最常见的三种静默乱码特征:
- “浣犲ソ”型乱码(UTF-8 误按 GBK 解码):当原本以 UTF-8 编码保存的“你好”(字节序列为
e4 bd a0 e5 a5 bd,共 6 字节),被错误地以双字节的 GBK 编码进行两两解析时,每两个字节被拼成了一个生僻汉字,呈现为“浣犲ソ”。这种乱码在内存中可以通过逆向转码无损恢复。 - “ä½Â...”型乱码(UTF-8 误按 Latin-1 解码):常出现在网络爬虫未指定编码时。Requests 库根据 HTTP 协议标准,在服务端未显式声明
charset时默认采用 ISO-8859-1(即 Latin-1)解码。由于 Latin-1 是一对一单字节映射,UTF-8 的多字节会被逐字节转为西欧重音字符。这种乱码同样可以通过逆向转码完整还原。 - “”型乱码(字节丢弃或不可逆替换):文本中充斥着黑色菱形问号字符(Unicode 替换字符
�)或纯问号?。这通常是因为前序处理代码中滥用了errors='replace'或errors='ignore'。原始字节已被破坏或丢弃,此种情况在内存中属于不可逆损坏,必须回到磁盘原始文件重新读取。
核心实操:中文语料读取与清洗的标准解决规范
1. 消除平台差异:严禁隐式 open()
在 Python 中,调用 open('corpus.txt') 而不传递 encoding 参数属于严重的代码隐患。此时 Python 会调用 locale.getpreferredencoding(False) 获取操作系统默认编码。在 Linux 和 macOS 下通常默认为 UTF-8,而在简体中文 Windows 下则默认为 GBK(代码页 CP936)。这会导致同一份代码在本地开发环境运行正常,部署到不同操作系统的服务器上时立即崩溃。标准做法是任何文件 I/O 均显式声明编码:
# 正确规范:显式声明编码
with open("raw_corpus.txt", mode="r", encoding="utf-8") as f:
    text = f.read()
2. 识别与剥离 Windows BOM(Byte Order Mark)
使用 Windows 记事本或部分软件保存 UTF-8 文本时,常会在文件开头写入 3 个隐藏字节 (称为 UTF-8 BOM)。如果直接使用 encoding='utf-8' 读取,Python 会将这 3 个字节解析为 Unicode 零宽无断空格字符 ,留在字符串开头:
# 环境:Python 3.8+ 标准库
# 示例:直接使用 utf-8 读取带 BOM 文件
with open("corpus_with_bom.txt", "r", encoding="utf-8") as f:
    line = f.readline()
    print("首字符 Unicode 码点:", repr(line[0]))
# 示例输出:首字符 Unicode 码点: ''首字符 Unicode 码点: ''
这个看不见的字符会导致字典键值匹配失效,或者使中文分词器将首个词汇切错(例如将“中国”切分为 ['中', '国'])。解决方案是直接使用 Python 内置的 utf-8-sig 解码器。该解码器在读取时会自动检测并跳过开头的 BOM 标记;在写入时若指定 utf-8-sig,则会在开头写入 BOM 供 Excel 识别:
# 规范做法:读取可能包含 BOM 的中文文本
with open("corpus_with_bom.txt", "r", encoding="utf-8-sig") as f:
    clean_text = f.read()
    # 此时开头不会含有 ''
3. 未知语料探测:charset_normalizer 与 chardet 的关键差异
面对海量未标记来源的历史语料,不能盲目猜测编码,而需要借助字节探测工具。在传统教程中常推荐 chardet,但在现代 Python(尤其是 Python 3.7+ 及 Requests 2.26+ 之后),官方已将底层探测引擎全面替换为 charset_normalizer。两者在中文场景下的关键差异直接影响 NLP 数据流水线的稳定性:
| 对比维度 | charset_normalizer(推荐) | chardet(传统遗留) |
|---|---|---|
| 探测准确度 | 基于 Unicode 语言连贯性与字符混杂度评分,能区分多种中文字符集 | 基于字符频次统计模型,对短文本极易误报为 ISO-8859 系列或匈牙利语 |
| 生僻字支持 | 良好支持 GB18030 多字节超集,优先推荐可用编码 | 常将包含生僻字的 GB18030 文件判定为 GB2312 导致后续读取报错 |
| 运行性能 | 纯 Python 实现且算法优化,探测效率显著提升 | 大规模语料批处理时速度较慢,容易成为流水线瓶颈 |
以下是使用 charset_normalizer 批量安全解码未知中文语料的生产级函数示例:
# 依赖安装:pip install charset-normalizer
import charset_normalizer

def safe_read_corpus(file_path: str) -> str:
    """安全读取未知编码的中文语料,优先保证字符完整性"""
    with open(file_path, "rb") as f:
        raw_bytes = f.read()

    # 优先尝试现代标准 UTF-8
    try:
        return raw_bytes.decode("utf-8")
    except UnicodeDecodeError:
        pass

    # 尝试覆盖范围最广的中国国家标准 GB18030
    try:
        return raw_bytes.decode("gb18030")
    except UnicodeDecodeError:
        pass

    # 若以上规则均失败,启用语义探测算法
    results = charset_normalizer.from_bytes(raw_bytes)
    best_match = results.best()

    if best_match is not None:
        return str(best_match)

    # 终极兜底策略:以 gb18030 解码并替换非法字节,记录警报
    return raw_bytes.decode("gb18030", errors="replace")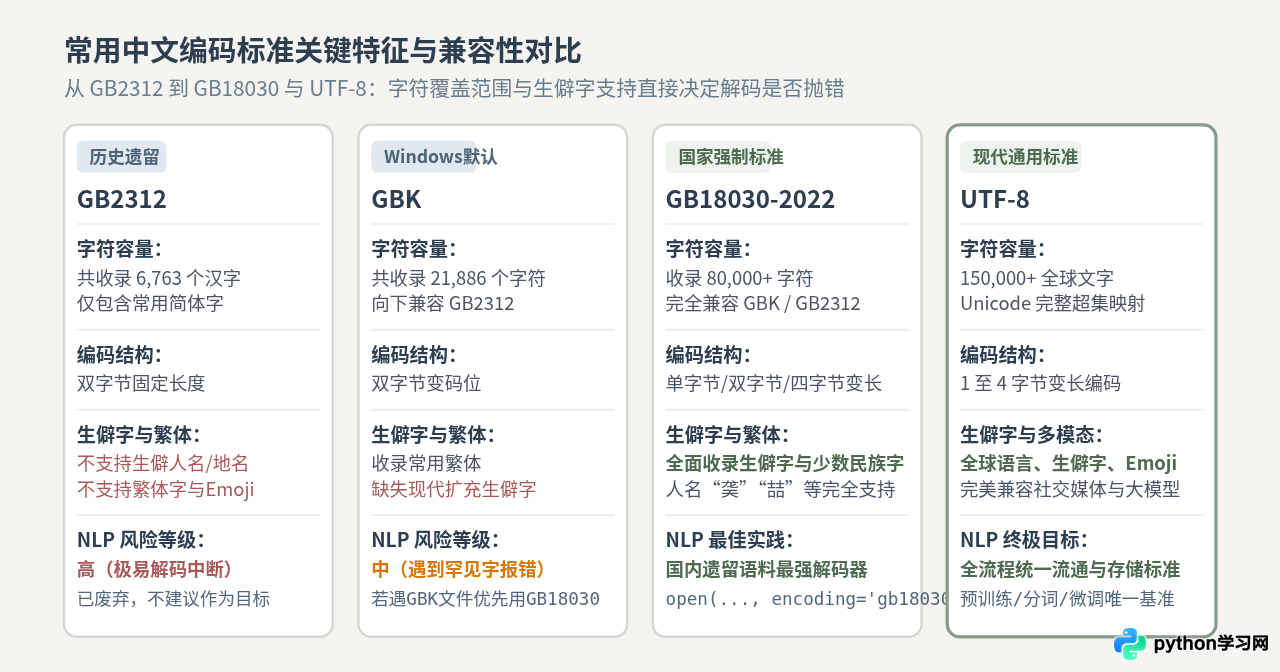
gb18030 而非 gbk 进行解码。GB18030 是我国现行强制标准,在字节结构上完全向下兼容 GBK 和 GB2312,且收录了 8 万余个汉字及少数民族文字。如果语料中包含“䶮”、“喆”等生僻人名或罕见地名,使用 gbk 会抛出 UnicodeDecodeError,而 gb18030 则能顺利解析。
4. 网络爬虫中的编码对齐规范
使用 requests 爬取中文网页时,若直接调用 response.text,极易遭遇前文所述的 Latin-1 乱码。这是因为 HTTP 规范约定在无显式响应头时默认 ISO-8859-1。规范的爬虫读取方式应先提取 response.content(纯字节),再结合解析或探测进行转码:
import requests
import charset_normalizer

url = "https://example.com/chinese-news"
resp = requests.get(url, timeout=10)

# 方式一:如果明确目标站点为 UTF-8,直接基于原始字节解码
html_text = resp.content.decode("utf-8", errors="replace")

# 方式二:根据响应头及 HTML meta 内容自适应识别
if resp.encoding.lower() == "iso-8859-1":
    # 丢弃 requests 猜错的 Latin-1,使用 apparent_encoding 或从内容探测
    resp.encoding = resp.apparent_encoding
correct_text = resp.text
NLP 处理流程中的特殊编码陷阱与防御
1. errors 参数的选择:strict、replace 与 ignore 的关键差异
在调用 decode() 或 open() 时,errors 参数控制了解码器遇到非法字节时的行为。初学者常因不想看到程序抛错,而习惯性加入 errors='ignore'。在中文 NLP 任务中,这种做法存在严重副作用:
errors='strict'(默认):遇到任何不符合规范的字节立即抛出UnicodeDecodeError。适用场景:基准语料清洗与质量核验阶段,强制暴露编码不一致问题,防止脏数据潜入训练集。errors='replace':将无法识别的字节替换为�(呈现为 )。适用场景:网络实时抓取或容错流式处理。它保留了文本原本的长度结构和上下文位置,后续可通过正则表达式剔除异常字符。errors='ignore':直接静默丢弃无法解析的字节。严重风险:中文字符通常占 2 到 4 个字节。如果文本被非预期切断(如截断了半个汉字),ignore会把残留的半个字节静默吃掉,导致后续所有字节的对齐相位错位,甚至使整句汉字发生大面积连环乱码或语素缺失,极难在后期定位。
2. 内存清洗与中文分词防护
在进入分词器(如 Jieba、HanLP 或 Hugging Face Tokenizer)前,必须对 Unicode 字符串进行归一化清洗。除了清除前文提到的 ,还应利用 Unicode 标准化(unicodedata.normalize)统一全角半角符号,并确保正则表达式匹配中文时开启 Unicode 模式:
import unicodedata
import re
import jieba

raw_text = "自然语言处理:Python 3.8 深度学习!"

# 步骤 1:剥离不可见字符与 BOM
text = raw_text.replace("", "").strip()

# 步骤 2:全角字符标准化为半角规范字符(NFKC 标准)
text = unicodedata.normalize("NFKC", text)

# 步骤 3:正则表达式过滤非中文字符(匹配中文字符、字母与常用标点)
chinese_only = re.sub(r"[^一-龥a-zA-Z0-9,。!?]", "", text)

# 步骤 4:安全分词
tokens = jieba.lcut(chinese_only)
print("清洗后分词结果:", tokens)清洗后分词结果: ['自然语言', '处理', 'Python', '3.8', '深度', '学习', '!']
3. 持久化与数据导出:防 ASCII 转义与 Excel 乱码
在导出清洗后的语料或模型预测结果时,最常遇到的问题有两个:JSON 汉字被转义为 中文,以及导出的 CSV 在 Windows Excel 中打开显示为乱码。
JSON 导出防转义:Python 的 json.dump() 默认设置 ensure_ascii=True,会将所有非 ASCII 字符转义为十六进制表示。这虽然能在任何 ASCII 环境传输,但导致文件体积膨胀且失去肉眼可读性。在中文 NLP 中应始终显式设置 ensure_ascii=False:
import json

results = {"corpus_id": 1001, "tokens": ["自然语言", "处理"], "status": "完成"}

# 正确规范:禁止 ASCII 转义,显式采用 utf-8
with open("result.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
CSV 导出兼顾 Excel:Windows 版本的 Microsoft Excel 在打开没有 BOM 的 UTF-8 编码 CSV 文件时,默认会尝试使用系统 ANSI 代码页(即 GBK)进行解析,从而再次出现视觉乱码。解决办法是在使用 Pandas 或内置 csv 模块导出时,显式指定编码为 utf-8-sig:
import pandas as pd

df = pd.DataFrame({
    "id": [1, 2],
    "content": ["语料样本一:自然语言处理", "语料样本二:字符编码规范"]
})

# 正确规范:导出带有 BOM 头的 UTF-8 文件,确保 Windows Excel 双击直接正常显示
df.to_csv("exported_corpus.csv", index=False, encoding="utf-8-sig")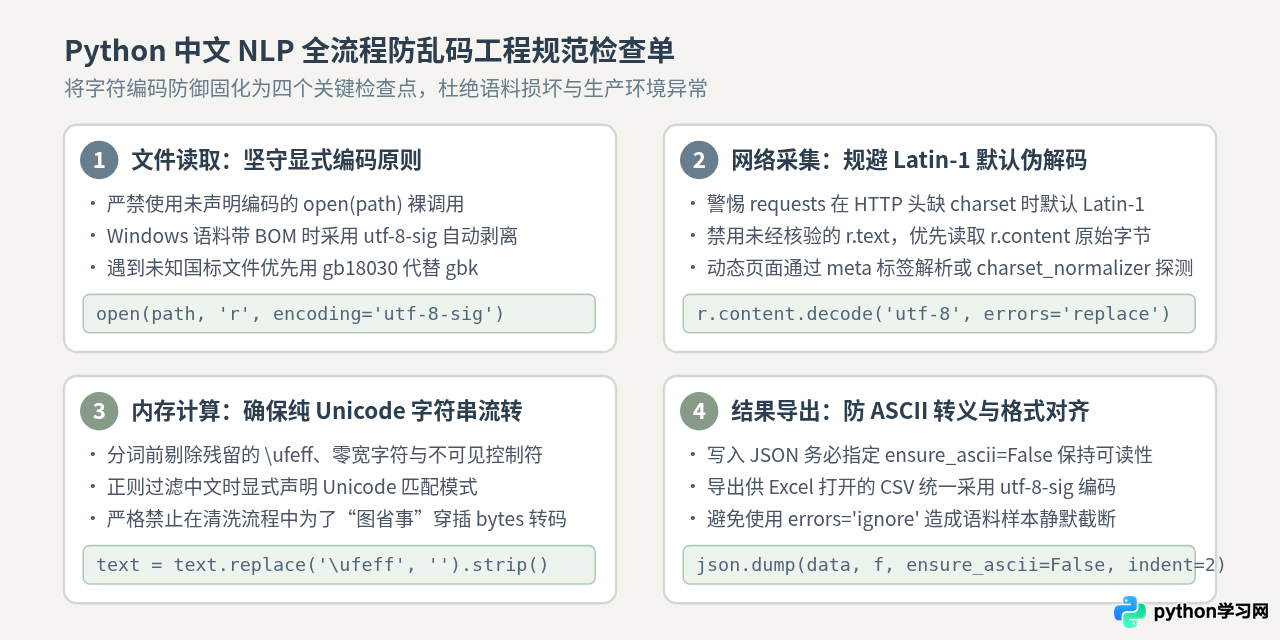
全流程防乱码规范总结
解决 Python 中文 NLP 中的乱码问题,核心在于建立系统化的防线,而不是在每个报错处临时碰运气换编码。归纳起来,可以在工程中落实以下四项防御准则:
- 输入边界严把关:任何打开文件的操作必须显式附带
encoding参数;凡遇到老旧系统的国标文件,优先采用gb18030进行超集兼容读取;遇到未知来源文件使用charset_normalizer辅助判断,严禁在初筛阶段使用errors='ignore'。 - 网络采集抓字节:爬虫抓取务必优先基于
response.content原始字节处理,避开 HTTP 协议默认的 ISO-8859-1 伪解码陷阱。 - 内部流转纯文本:分词、清洗、正则替换及特征抽取全程只对 Unicode
str对象进行操作,入库第一时间清除及异常控制符,中间环节绝不穿插二进制编解码。 - 输出持久化对齐标准:JSON 导出必须声明
ensure_ascii=False;需要提供给业务人员使用 Excel 查看的 CSV 报表,统一采用utf-8-sig格式保存。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















