


Python嵌套循环实现九九乘法表与矩阵处理
深入讲解Python嵌套循环的工作原理,通过九九乘法表和二维矩阵遍历、转置及变换等经典实例,系统拆解双重循环的时序控制、格式对齐与常见内存陷阱。
一、嵌套循环的执行机制与时序步进
所谓嵌套循环(Nested Loop),本质上就是在已有循环结构的循环体内部,再次放入另一个循环结构。在最常用的双重 for 循环中,理解程序执行流程的核心在于把握内外层变量的时序关系:外层循环每推进单步(执行一次迭代),内层循环都会完整经历从起始初始化、全量推进到条件终止的完整生命周期。
假设外层循环执行 \(M\) 次,内层循环在每次外层迭代中执行 \(N\) 次,那么位于内层循环体内部的操作语句将被累计执行 \(M imes N\) 次。在整个执行过程中,外层循环变量在某一个数值保持静止时,内层循环变量会像钟表的分针相对于时针一样,完成一整圈步进。
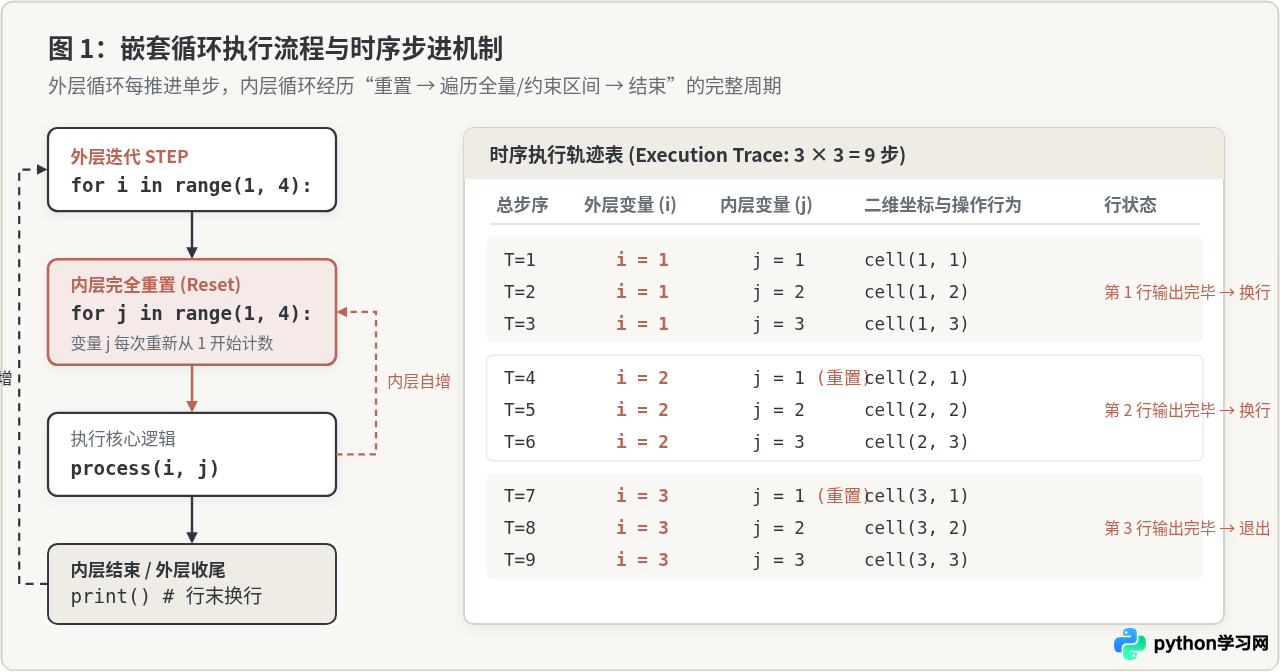
以下为一个基础的时序跟踪示例。通过打印计数状态,可以直观观察到内层循环变量 j 是如何在每次外层循环 i 切换时重新被重置为初始值的:
# 时序步进跟踪演示
for i in range(1, 4):
    print(f"--- 外层循环第 {i} 轮开始 ---")
    for j in range(1, 4):
        print(f"  [内层执行] 坐标: (i={i}, j={j})")
print(f"--- 外层循环第 {i} 轮结束 ---\n")[内层执行] 坐标: (i=1, j=1)
[内层执行] 坐标: (i=1, j=2)
[内层执行] 坐标: (i=1, j=3)
--- 外层循环第 1 轮结束 ---
--- 外层循环第 2 轮开始 ---
[内层执行] 坐标: (i=2, j=1)
[内层执行] 坐标: (i=2, j=2)
[内层执行] 坐标: (i=2, j=3)
--- 外层循环第 2 轮结束 ---
--- 外层循环第 3 轮开始 ---
[内层执行] 坐标: (i=3, j=1)
[内层执行] 坐标: (i=3, j=2)
[内层执行] 坐标: (i=3, j=3)
--- 外层循环第 3 轮结束 ---
这种“外层慢变、内层快变”的特性,天然映射了现实生活中网格排版、二维坐标系扫描以及表格按行渲染的物理模型。
二、实战一:九九乘法表的下三角生成与排版控制
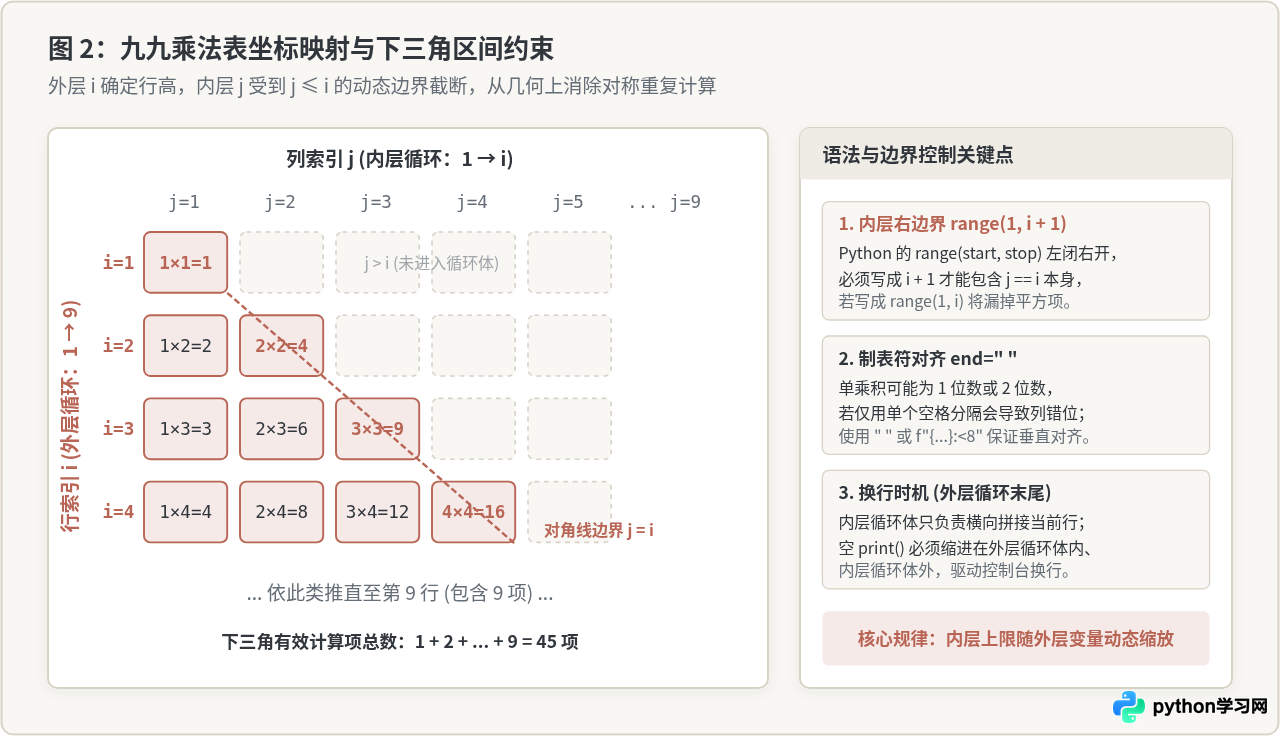
九九乘法表是检验嵌套循环掌握程度的经典案例。许多初学者最初写出的乘法表往往是 \(9 imes 9\) 的矩形方阵,或者因为未处理换行符导致乘法项全部垂直纵向排列。要生成规整的“下三角”乘法表,必须妥善解决以下两个关键技术点:
- 动态边界截断(生成下三角形):第
i行只打印前i个乘积项,消除因乘法交换律产生的重复项(例如2×3=6与3×2=6)。因此,内层循环的终止边界不能是固定数值 9,而必须动态绑定外层当前行号i。 - 行内拼接与行尾换行(排版对齐):Python 的
print()函数默认以换行符end=" "阻止自动换行并实现制表符对齐;在当行内层循环完全结束后,在外层循环中调用一次无参的print()触发真正的换行。
1. 完整实现代码
基于上述分析,九九乘法表的标准 Python 实现代码如下:
# 九九乘法表标准实现
for i in range(1, 10):  # 外层循环:控制行号 i 从 1 到 9
    for j in range(1, i + 1):  # 内层循环:控制列号 j 从 1 到 i
        # 使用格式化字符串输出算式,end="	" 保持行内制表符对齐
        print(f"{j}×{i}={i * j}", end="	")
    # 当前行所有列打印完毕,执行一次换行
print()1×2=2 2×2=4
1×3=3 2×3=6 3×3=9
1×4=4 2×4=8 3×4=12 4×4=16
1×5=5 2×5=10 3×5=15 4×5=20 5×5=25
1×6=6 2×6=12 3×6=18 4×6=24 5×6=30 6×6=36
1×7=7 2×7=14 3×7=21 4×7=28 5×7=35 6×7=42 7×7=49
1×8=8 2×8=16 3×8=24 4×8=32 5×8=40 6×8=48 7×8=56 8×8=64
1×9=9 2×9=18 3×9=27 4×9=36 5×9=45 6×9=54 7×9=63 8×9=72 9×9=81
range(start, stop) 生成序列时具有“左闭右开”特性,即包含起始值 start,但不包含终止值 stop。若误写为 range(1, i),当 i=1 时区间为 range(1, 1),内层循环将直接不执行;当 i=2 时只打印 j=1,会漏掉所有诸如 2×2=4、3×3=9 的自乘项。
三、实战二:二维列表与矩阵的基础遍历与提取
在 Python 中,标准数据结构并没有原生的 Matrix 类型,通常使用嵌套列表(List of Lists)来表示二维矩阵。外层列表中的每一个元素本身是一个独立的列表,对应矩阵的一整行。
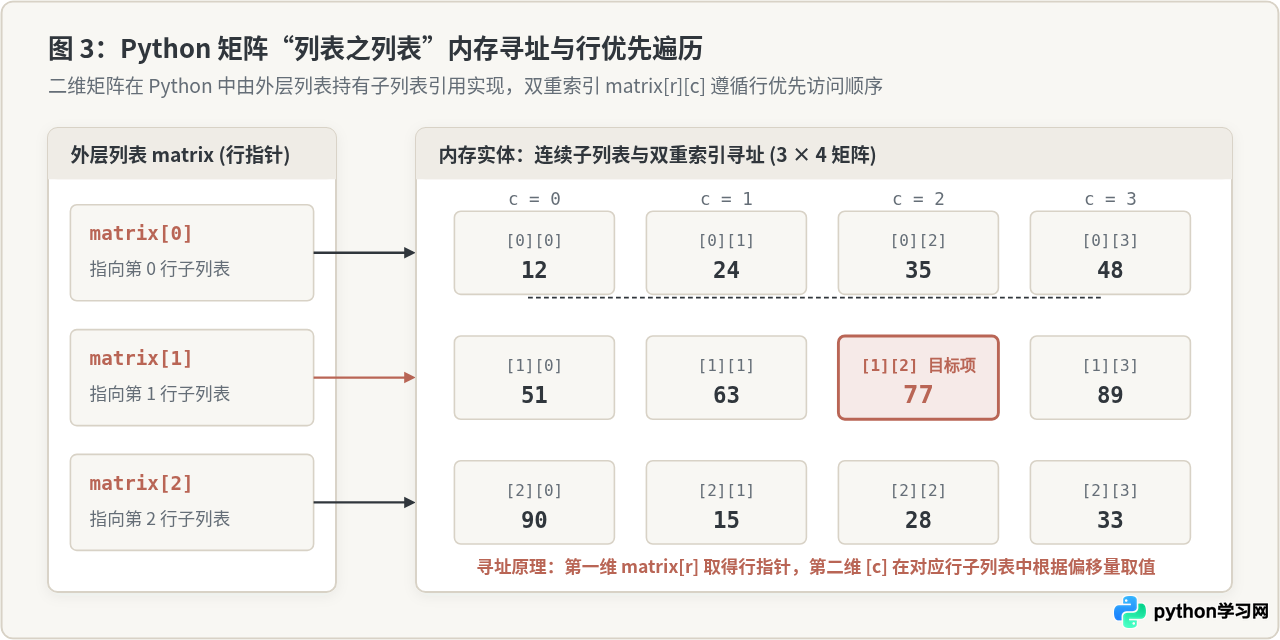
1. 两种常用遍历方式对比
针对二维矩阵,Python 提供了两种主流的嵌套循环遍历策略,分别适用于不同的工程诉求:
| 遍历模式 | 典型代码形式 | 适用场景 | 局限性 |
|---|---|---|---|
| 直接元素遍历 (Direct Value) |
for row in matrix: |
只读统计场景:如矩阵求和、元素查找、极值计算。代码最简洁 Pythonic。 | 无法得知当前元素的行列坐标索引,无法直接原地修改原矩阵。 |
| 双重索引遍历 (Index-based) |
for r in range(len(matrix)): |
坐标敏感场景:按位置就地修改、访问邻居单元格、判断主副对角线。 | 需要进行长度计算与切片索引,语法稍显繁琐。 |
2. 矩阵基础统计与元素寻址示例
以下代码演示如何在一个 \(3 imes 4\) 的矩阵中,同时完成全矩阵求和、最大值搜寻以及特定行列条件的过滤:
# 定义一个 3行 4列 的二维矩阵
matrix = [
    [12, 24, 35, 48],
    [51, 63, 77, 89],
    [90, 15, 28, 33]
]

rows = len(matrix)        # 行数: 3
cols = len(matrix[0])     # 列数: 4

total_sum = 0
max_val = matrix[0][0]
max_pos = (0, 0)

# 使用双重索引遍历整个矩阵
for r in range(rows):
    for c in range(cols):
        current_val = matrix[r][c]
        total_sum += current_val
        if current_val > max_val:
            max_val = current_val
            max_pos = (r, c)

print(f"矩阵维度: {rows}行 × {cols}列")
print(f"矩阵全部元素累加和: {total_sum}")
print(f"最大值: {max_val}, 位于坐标: 行{max_pos[0]} 列{max_pos[1]}")矩阵全部元素累加和: 565
最大值: 90, 位于坐标: 行2 列0
四、实战三:高频矩阵算法(转置、对角线与矩阵加法)
熟练运用嵌套循环不仅在于读取数据,更在于按照特定的数学规则对二维结构进行重构与变换。在面试与日常算法处理中,矩阵转置、对角线扫描和多矩阵相加是最具代表性的操作。
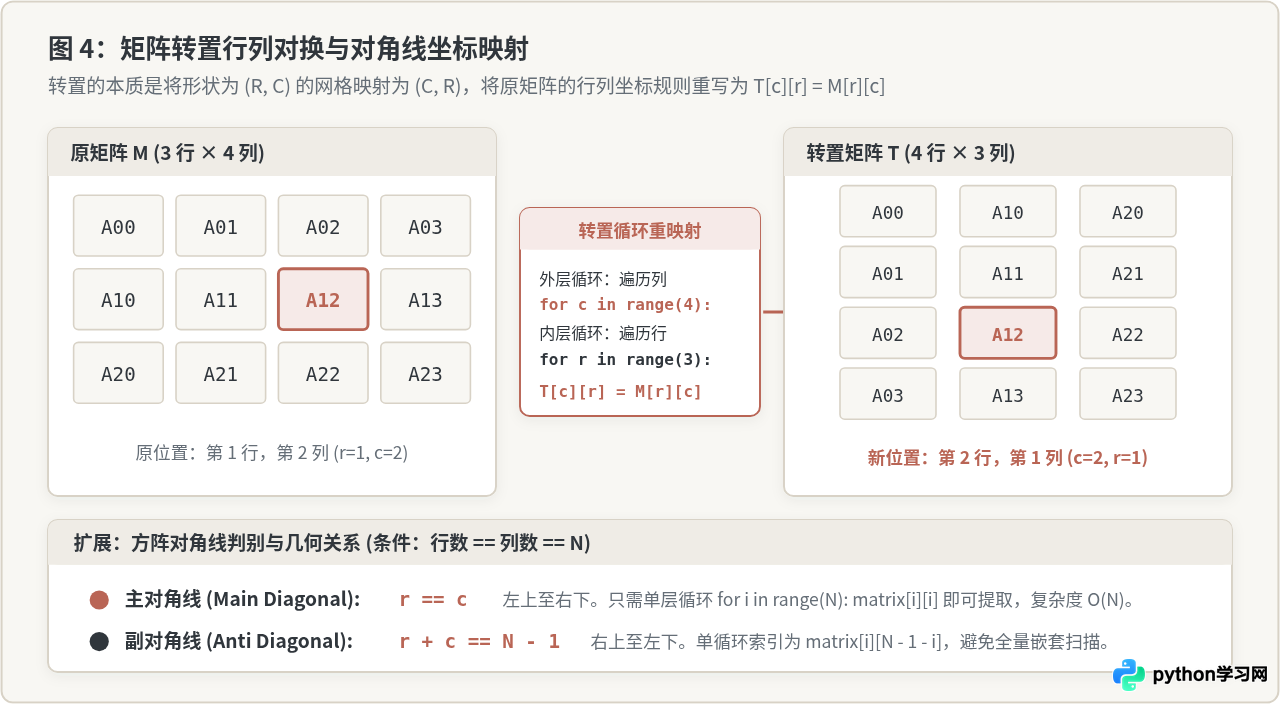
1. 矩阵转置算法(Transpose)
矩阵转置是将矩阵的行和列互换。若原矩阵 \(M\) 的维度是 \(R imes C\),转置后的矩阵 \(T\) 维度必然是 \(C imes R\),且数学映射规则为:T[c][r] = M[r][c]。
在编写传统嵌套循环时,外层循环必须遍历新矩阵的行数(即原矩阵的列数 cols),内层循环遍历原矩阵的行数 rows:
# 原矩阵 M (3 x 4)
original_matrix = [
    [1,  2,  3,  4],
    [5,  6,  7,  8],
    [9, 10, 11, 12]
]

num_rows = len(original_matrix)
num_cols = len(original_matrix[0])

# 方法 A:传统嵌套循环构建转置矩阵
transposed_matrix = []
for c in range(num_cols):  # 外层循环遍历列 (0 到 3)
    new_row = []
    for r in range(num_rows):  # 内层循环遍历行 (0 到 2)
        new_row.append(original_matrix[r][c])
    transposed_matrix.append(new_row)

# 方法 B:嵌套列表推导式 (等价单行写法)
transposed_comprehension = [
    [original_matrix[r][c] for r in range(num_rows)]
    for c in range(num_cols)
]

print("转置后矩阵 (4行 × 3列):")
for row in transposed_matrix:
print(row)[1, 5, 9]
[2, 6, 10]
[3, 7, 11]
[4, 8, 12]
2. 方阵主对角线与副对角线遍历技巧
当矩阵行数等于列数(即方阵 \(N imes N\))时,对角线元素具备明确的代数特征:
- 主对角线(从左上到右下):行索引等于列索引,即
r == c。如果直接使用双重循环遍历判断,时间复杂度是 \(O(N^2)\)。由于坐标恒等,在实际工程中应直接退化为单层循环for i in range(N): matrix[i][i],将复杂度降为 \(O(N)\)。 - 副对角线(从右上到左下):行列索引满足
r + c == N - 1。同理,单层循环只需读取matrix[i][N - 1 - i]。
3. 矩阵元素对应位置相加
同型矩阵(维度完全相同的两个矩阵)相加,本质上是对两个矩阵中处于相同坐标 (r, c) 的数值进行相加,并写入新矩阵对应的单元格:
# 两个 2x3 矩阵相加
mat_a = [
    [1, 3, 5],
    [7, 9, 11]
]
mat_b = [
    [2, 4, 6],
    [8, 10, 12]
]

mat_sum = []
for r in range(len(mat_a)):
    row_result = []
    for c in range(len(mat_a[0])):
        row_result.append(mat_a[r][c] + mat_b[r][c])
    mat_sum.append(row_result)

print("矩阵相加结果:", mat_sum)
# 结果: [[3, 7, 11], [15, 19, 23]]
五、关键避坑指南与工程选型边界
在使用 Python 处理嵌套循环与矩阵结构时,由于 Python 动态对象机制与引用的特性,存在几个极其隐蔽但破坏力极大的典型陷阱:
bad_matrix = [[0] * 3] * 3千万不要这样做!乘法操作符
* 3 复制的不是独立的列表对象,而是同一个列表对象的引用指针。如果你执行 bad_matrix[0][0] = 99,你会惊讶地发现第 1 行、第 2 行、第 3 行的第 0 列全部变成了 99!正确写法:必须通过列表推导式让 Python 为每一行独立分配内存对象:
safe_matrix = [[0] * cols for _ in range(rows)]
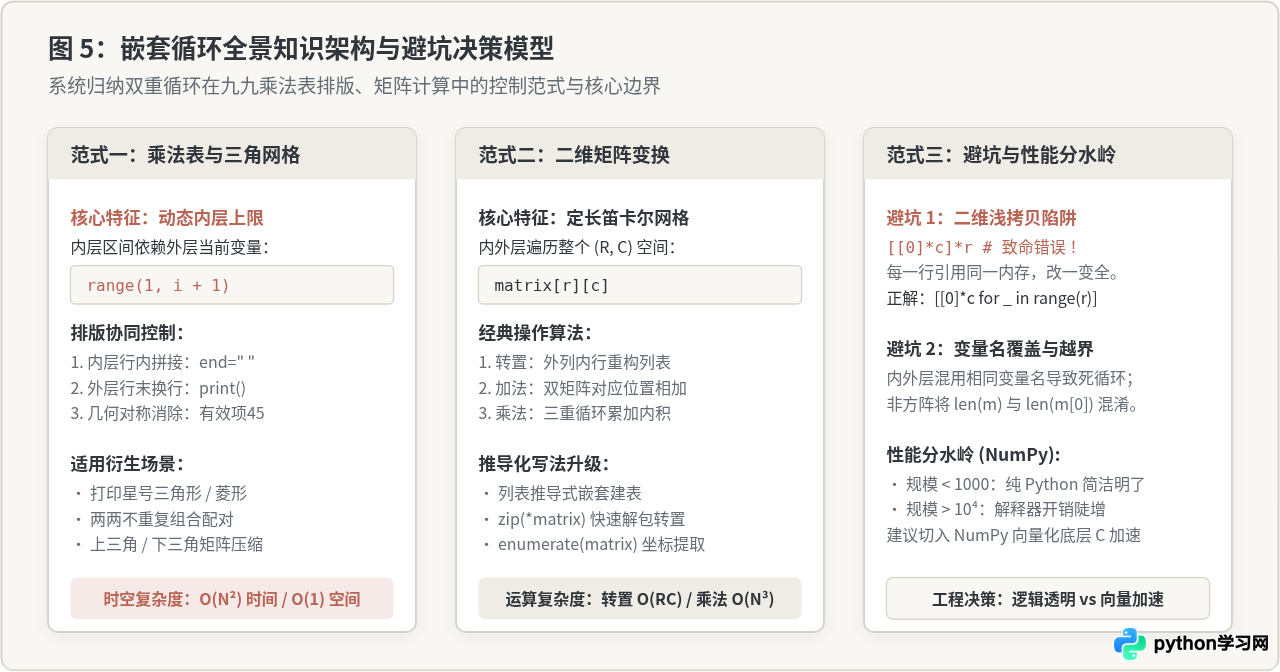
1. 命名与变量覆盖风险
在编写多层嵌套循环时,切记为内外层循环使用明确区分的变量名。在通用索引遍历中,建议使用 r(Row)和 c(Column),或者 i 和 j。绝不能在内层循环中再次使用与外层相同的变量名(例如外层用 i,内层又用 i),否则内层迭代会直接覆盖外层状态,导致外层逻辑失控或无限死循环。
2. 原生嵌套循环与科学计算库(NumPy)的选型边界
最后,从工程落地角度来看,Python 原生嵌套循环拥有极佳的可读性,且不需要依赖任何第三方库,非常适合教学理解、小规模自定义业务规则以及格式化排版任务。然而:
- 时间复杂度门槛:双重循环的耗时与数据规模呈二次方关系 \(O(N^2)\)。当矩阵规模增长到 \(1000 imes 1000\)(百万级元素)时,Python 解释器的循环指令开销和装箱拆箱操作将显著拖慢执行速度。
- 工业级选型:在科学计算、机器学习或大规模图像矩阵处理场景中,应果断选用底层以 C 语言实现的 NumPy 库。通过向量化广播机制(Vectorized Operations),计算速度通常可以提升数十倍甚至数百倍,同时矩阵转置只需简单的
matrix.T即可完成。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















