


Python输入多行数据并存入二维列表的方法
系统讲解在Python中接收多行控制台或流输入并构建二维列表的实用方法,涵盖已知行数、空行结束及EOF终止等典型场景与性能选型。
一、核心原理:从标准输入流到二维列表结构
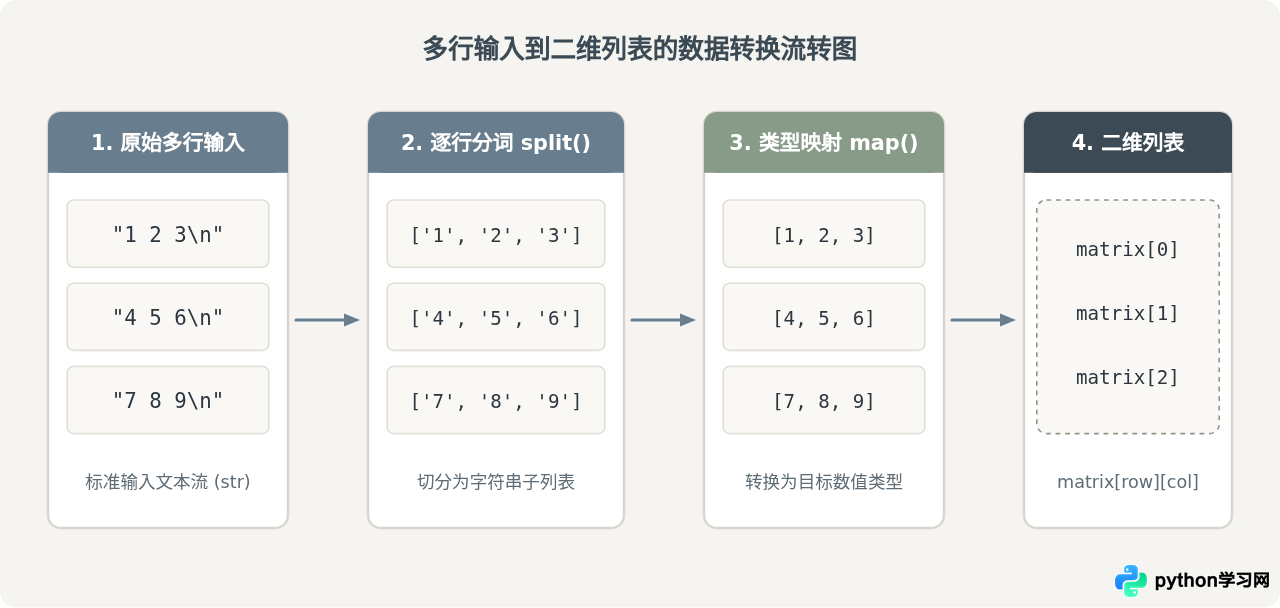
二维列表在 Python 中本质上是由多个子列表构成的嵌套列表(List of Lists)。控制台输入的原始数据统一表现为以换行符分隔的纯字符串文本流。将多行输入转化为形如 matrix[row][col] 的结构,需要完成以下转换链条:
- 行捕获(Row Acquisition):通过
input()或输入流迭代器捕获包含换行符的单行字符串。 - 行清洗与拆解(Tokenization):利用
strip()剔除首尾空白字符,再通过split()依据指定分隔符(默认任意空格或制表符)拆分为字符串子列表。 - 类型投射(Type Conversion):利用
map()函数或内层推导式将字符串转换为整数、浮点数或所需数据类型。 - 外层组装(Aggregation):将每行生成的列表逐个存入外层空列表,完成二维结构的定型。
二、标准操作步骤与基础代码范式
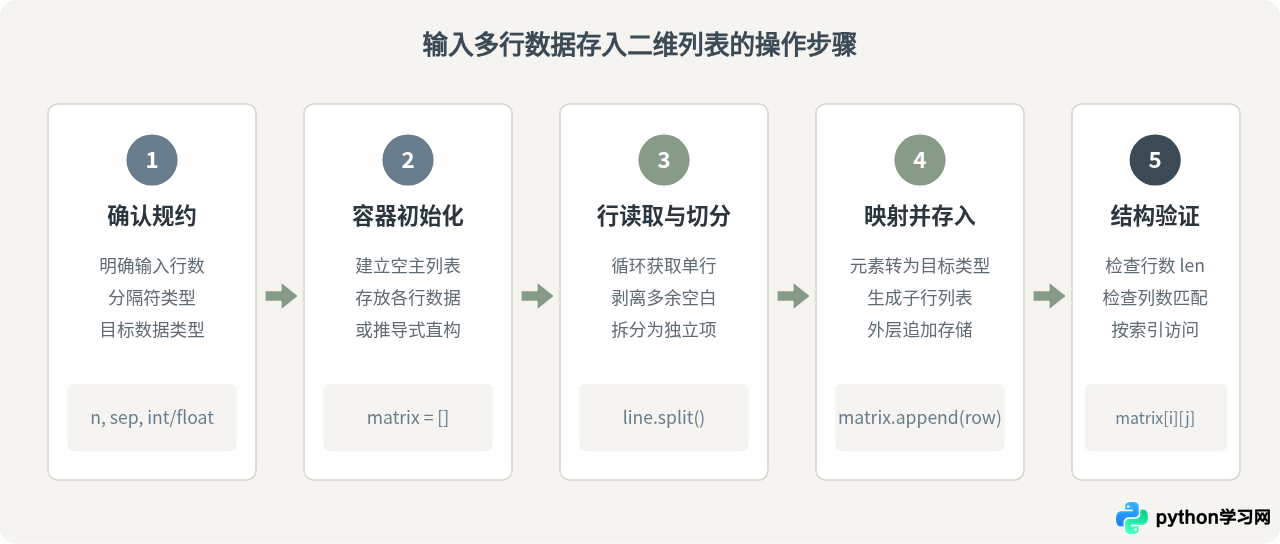
在编写处理逻辑时,建议遵循标准操作步骤,以确保逻辑闭环并便于后续定位异常输入。
基础循序写法(适合初学与需要调试中间过程)
最清晰的写法是显式定义外层列表,在循环内部逐步完成切分、转换与追加:
# 设定行数(例如需要录入 3 行数据)
row_count = 3
matrix = []

for _ in range(row_count):
    raw_line = input()
    # 切分为字符串列表并映射为整型
    row = list(map(int, raw_line.split()))
    matrix.append(row)

print("生成的结果:", matrix)10 20 30
40 50 60
70 80 90
示例输出:
生成的结果: [[10, 20, 30], [40, 50, 60], [70, 80, 90]]
三、三种典型输入场景与对应解法
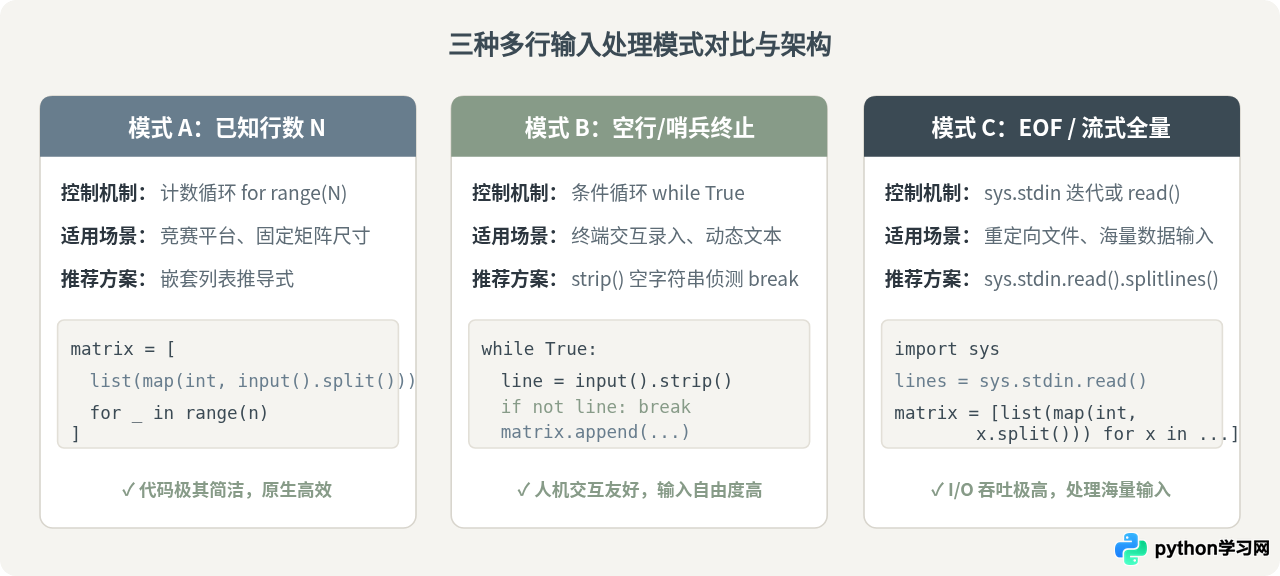
在实际开发与算法求解中,多行输入的结束条件通常分为三类:明确告知总行数、以空行或特定字符结束录入、以及以流文件结束符(EOF)终止。必须针对具体场景选用对应结构。
场景 1:已知行数 N 的列表推导式写法
许多算法题目会在首行给出矩阵的行数 n(甚至包括列数 m)。对于此类情况,使用一行列表推导式即可完成整体创建:
# 首行输入整数 n,表示后续有 n 行数据
n = int(input())

# 单行推导式构建二维整型列表
matrix = [list(map(int, input().split())) for _ in range(n)]

print("结果矩阵:", matrix)3
1 0 5
2 4 8
3 9 7
示例输出:
结果矩阵: [[1, 0, 5], [2, 4, 8], [3, 9, 7]]
场景 2:未知行数,用户敲击回车(空行)结束
在命令行工具开发中,通常需要用户连续粘贴或输入多行,最后直接按回车(产生空字符串)结束输入:
matrix = []

while True:
    line = input().strip()
    # 当读取到空字符串时,退出循环
    if not line:
        break
    matrix.append(list(map(int, line.split())))

print("录入完成:", matrix)
场景 3:未知行数,读取到文件末尾(EOF)结束
当通过管道重定向输入(例如 python script.py < data.txt)或在线评测平台未明确指定行数时,需要读取直到流终止:
import sys

matrix = []
# 直接迭代 sys.stdin,每一行自带换行符
for raw_line in sys.stdin:
    clean_line = raw_line.strip()
    if clean_line:  # 忽略可能存在的空白杂行
        matrix.append(list(map(int, clean_line.split())))

print("读取总行数:", len(matrix))
四、关键差异与技术选型分析
在实现多行输入时,最常见的技术抉择集中在两处:input() 逐行获取与 sys.stdin 批量获取的差异,以及列表推导式与显式 append 循环的权衡。
| 对比维度 | input() 逐行读取 | sys.stdin 批量/迭代流 |
|---|---|---|
| 核心机制 | 每次调用执行一次系统底层调用,自动剥离末尾换行符 | 通过 Python 缓冲区批量拉取输入,保留原始换行符 |
| 性能表现 | 数据量达到 10^5 行以上时,频繁系统调用导致显著耗时 | I/O 耗时通常仅为前者的 1/3 至 1/5,性能优势显著 |
| 交互体验 | 适合人机交互,可实时提示用户输入 | 通常一次性等待流结束或缓冲填满,交互反馈感较弱 |
| 异常控制 | 读到文件结尾抛出 EOFError |
自然结束循环,不会触发 EOFError |
推导式与传统循环的选择:
- 列表推导式:字节码层面直接由 CPython 虚拟机优化执行,省去了
append方法的属性查找与函数调用开销,运行更快且语法紧凑。 - 显式循环:若输入中夹杂非法字符、格式不规则或需要对各列进行分支检验(例如判断某些列是否缺失、某些值是否越界),显式
for循环更容易添加try...except错误处理逻辑。
五、常见边界问题与防御处理
在真实输入场景中,文本格式往往不够规整,必须警惕以下三个常见陷阱:
1. split() 与 split(' ') 的重要区别
请务必优先使用无参的 split(),而不是传参空格 split(' ')。无参模式会将连续的多个空格、制表符(\t)视作单一分隔符,并自动忽略首尾多余空格;而 split(' ') 在遇到两个连续空格时会切分出空字符串 "",随后传给 int() 会直接引发 ValueError: invalid literal for int() with base 10: ''。
2. 数据元素含非数值字符的安全转换
若外部输入可能含有非纯数字内容,直接调用 map(int, ...) 会中断程序。可通过列表推导式配合条件判断增强健壮性:
# 仅将能够构成数字的字符转为整数
row = [int(x) for x in raw_line.split() if x.lstrip('-').isdigit()]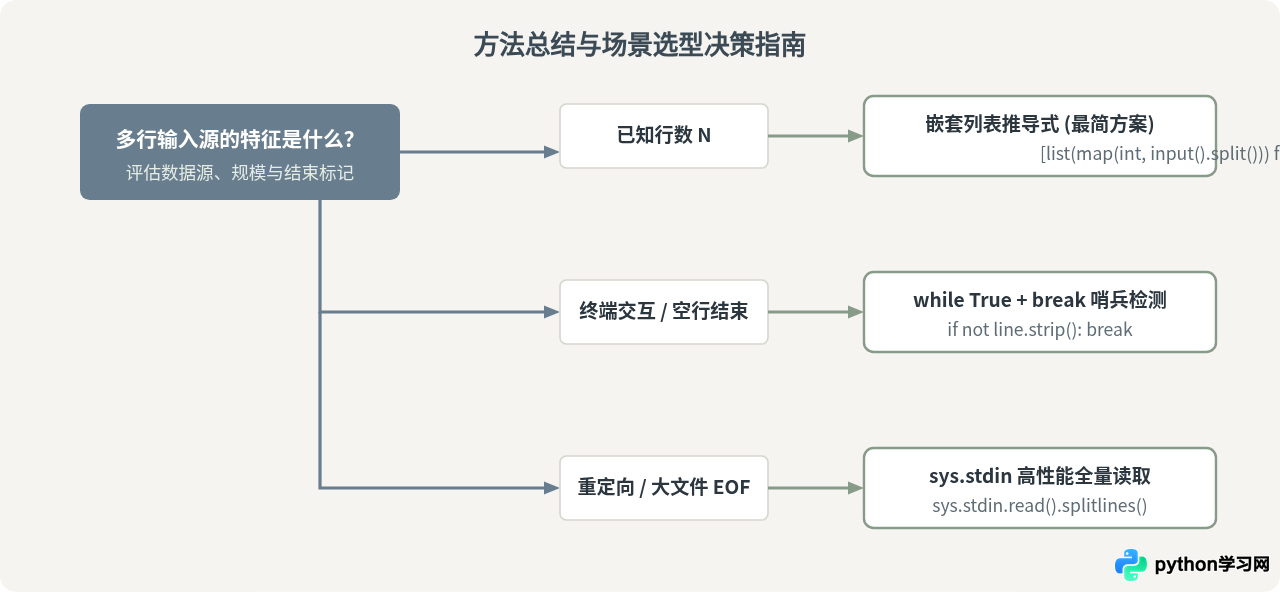
六、总结
掌握 Python 多行数据存入二维列表的核心,在于熟练组合“行循环”与“列分词映射”两个处理维度:
- 常规考试与练习场景:优先采用
[list(map(int, input().split())) for _ in range(n)],不仅行数少,且运行效率高。 - 交互式程序:使用
while True搭配strip()检测空行,提供符合人类操作直觉的退出机制。 - 处理大规模输入:直接借助
sys.stdin缓冲管道,大幅缩短 I/O 耗时,避免性能瓶颈。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















