


Python Oracle连接池配置教程:提升高并发查询性能
针对高并发场景下频繁创建Oracle连接导致的延迟与资源耗尽问题,本文提供完整的Python Oracle连接池配置实战教程。详解python-oracledb连接池的核心参数、多线程并发查询实现、连接生命周期管理与异常排查,有效提升数据库访问吞吐量。
在构建高并发数据查询服务时,如果每次接收到用户请求都临时调用 oracledb.connect() 创建数据库连接,数据库服务器会迅速出现 CPU 飙升、响应延迟显著上升,甚至抛出 ORA-12516 或 ORA-12519 监听器资源耗尽错误。解决该问题的核心路径是在应用层维护一个高效的 Oracle 连接池,让多个业务线程复用预先建立的长连接,从而消除重复的 TCP 三次握手、身份认证和 Oracle PGA 内存分配开销。本文将基于官方推荐的 python-oracledb 驱动,详细介绍连接池的完整配置流程、多线程查询调用方式以及关键参数调优方法。
一、高并发下为何必须使用连接池
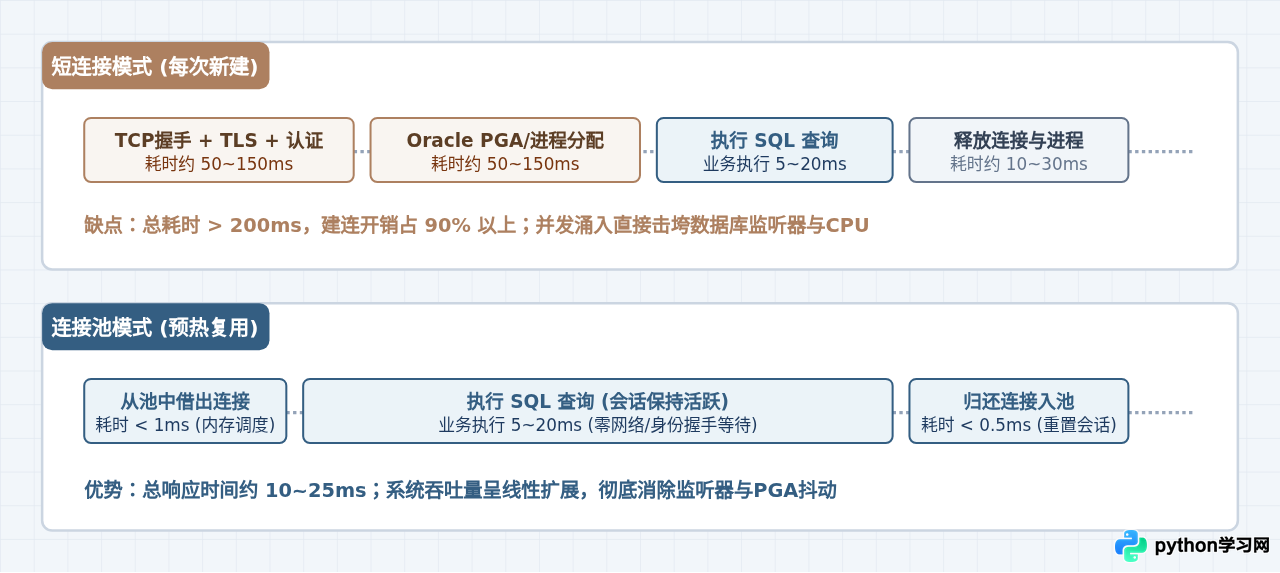
Oracle 数据库的连接建立属于典型的重开销操作。当客户端发起一次物理连接请求时,Oracle 监听器(TNS Listener)需要验证网络协议、协商加密信道、校验用户密码,并在专用服务器模式(Dedicated Server)下为该连接在操作系统中派生(fork)一个独立的服务器进程,同时分配程序全局区(PGA)内存。整个建连过程通常耗时 50 至 300 毫秒,且消耗大量的系统 CPU 资源。
若在高并发环境下采用“随用随连、用完即断”的短连接模式,大量线程在同一瞬间发起建连请求,Oracle 监听器的处理队列会被迅速填满,导致后续连接请求被拒绝或发生超时。引入连接池(Connection Pool)后,应用程序在启动时预先与数据库建立一定数量的物理长连接并放入池中托管。当多线程处理查询请求时,只需直接从池中借出一个已就绪的连接,查询完成后再将连接归还回池,连接获取耗时可降至 1 毫秒以内。
二、环境依赖与驱动选型
在 Python 生态中,目前官方唯一推荐的 Oracle 驱动是 python-oracledb,它是历史版本 cx_Oracle 的升级替代者。python-oracledb 具备两种运行模式:
- Thin 模式(轻量瘦客户端模式,默认):由纯 Python 编写,直接实现 Oracle Net 协议。无需在本地或服务器操作系统安装 Oracle Instant Client,直接
pip install oracledb即可使用,部署极其便捷。 - Thick 模式(厚客户端模式):通过调用底层 C 语言编写的 Oracle Client 动态库工作,当需要支持一些特定的高级特性(如外部认证、高级队列 AQ、Oracle Database 11.2 的旧版服务端通信等)时,通过
oracledb.init_oracle_client()切换开启。
针对常见的高并发读写与查询业务,Thin 模式提供的连接池性能足以胜任。请先在终端中执行驱动安装命令:
import cx_Oracle,可直接在模块最顶部执行兼容导入映射:
import oracledb; oracledb.upgrade_to_cx_oracle(),现有代码无需改动即可享受新驱动的优化。
三、核心操作步骤:创建与配置连接池
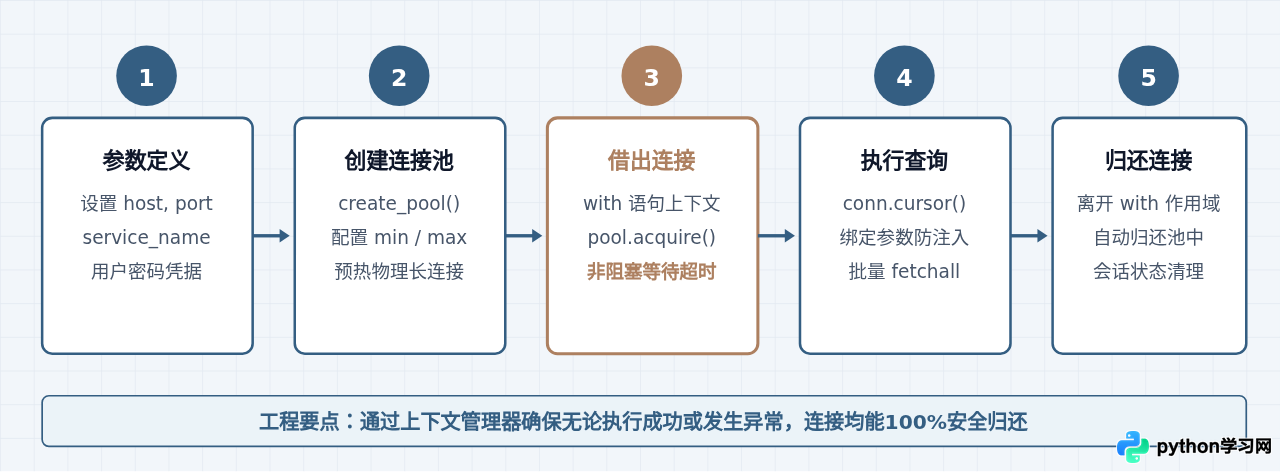
配置 Oracle 连接池分为五个规范步骤:导入模块与定义认证信息、配置连接池参数、初始化连接池单例、在工作线程中借出并执行查询、安全释放连接回池。
3.1 完整可运行代码示例
以下示例演示了如何使用 oracledb.create_pool 初始化连接池,并借助 ThreadPoolExecutor 模拟高并发多线程查询场景:
# -*- coding: utf-8 -*-
import concurrent.futures
import time
import oracledb

# 1. 数据库基础连接凭据 (建议从环境变量或配置文件读取)
DB_USER = "app_query_user"
DB_PASSWORD = "YourSecurePassword123"
DB_HOST = "192.168.10.20"
DB_PORT = 1521
DB_SERVICE_NAME = "orclpdb1"

# 构建 Easy Connect 格式的 DSN (数据源名称)
DSN_STRING = f"{DB_HOST}:{DB_PORT}/{DB_SERVICE_NAME}"

def init_connection_pool():
    # 初始化全局连接池
    pool = oracledb.create_pool(
        user=DB_USER,
        password=DB_PASSWORD,
        dsn=DSN_STRING,
        min=5,               # 连接池启动时创建的初始最小连接数
        max=20,              # 连接池允许创建的最大物理连接上限
        increment=2,        # 资源紧张时单次递增创建的连接数
        homogeneous=True,   # 声明池内所有连接使用相同认证凭据
        timeout=300,        # 空闲连接超时时间(秒),超时后多余连接将被自动收回至 min
        wait_timeout=3000,  # 借出连接等待超时(毫秒),池满时等待获取的最长时间
        ping_interval=60    # 借出前探活检测间隔(秒),自动剔除防火墙超时的僵死会话
    )
    print(f"[初始化完成] Oracle 连接池建立,初始连接: {pool.min},最大连接: {pool.max}")
    return pool

def execute_query_worker(pool, query_id):
    # 模拟业务线程从池中借出连接并执行高并发查询
    start_time = time.perf_counter()
    # 使用 with pool.acquire() 确保连接必定归还,不会造成池资源泄露
    with pool.acquire() as connection:
        acquire_cost = (time.perf_counter() - start_time) * 1000
        with connection.cursor() as cursor:
            # 开启预取调优 (arraysize),提升批量记录返回性能
            cursor.arraysize = 100
            sql = "SELECT employee_id, first_name, department_id FROM employees WHERE department_id = :dept_id"
            cursor.execute(sql, dept_id=60)
            rows = cursor.fetchall()
            total_cost = (time.perf_counter() - start_time) * 1000
            print(f"[任务 {query_id}] 获取连接耗时: {acquire_cost:.2f}ms | 总执行耗时: {total_cost:.2f}ms | 返回记录: {len(rows)}")
            return len(rows)

if __name__ == "__main__":
    global_pool = init_connection_pool()

    # 使用多线程模拟 50 个高并发业务查询并发打入
    print("--- 开始高并发压力测试 ---")
    with concurrent.futures.ThreadPoolExecutor(max_workers=25) as executor:
        futures = [executor.submit(execute_query_worker, global_pool, i) for i in range(50)]
        concurrent.futures.wait(futures)

    # 在应用关闭钩子中关闭连接池
    global_pool.close()
    print("--- 连接池已安全关闭 ---")
3.2 控制台运行示例输出
执行上述脚本后,终端会打印如下输出(实际数值视网络延时与数据库负载而定):
--- 开始高并发压力测试 ---
[任务 0] 获取连接耗时: 0.28ms | 总执行耗时: 8.64ms | 返回记录: 5
[任务 1] 获取连接耗时: 0.31ms | 总执行耗时: 9.12ms | 返回记录: 5
[任务 2] 获取连接耗时: 0.25ms | 总执行耗时: 8.45ms | 返回记录: 5
...
[任务 49] 获取连接耗时: 0.33ms | 总执行耗时: 8.91ms | 返回记录: 5
--- 连接池已安全关闭 ---
可以看到,除了初次握手由池预热完成外,工作线程从池中借出连接的耗时稳定在 0.2 ~ 0.4 毫秒 之间,整体查询响应时间被极大压缩。
四、关键参数深度解析与容量估算
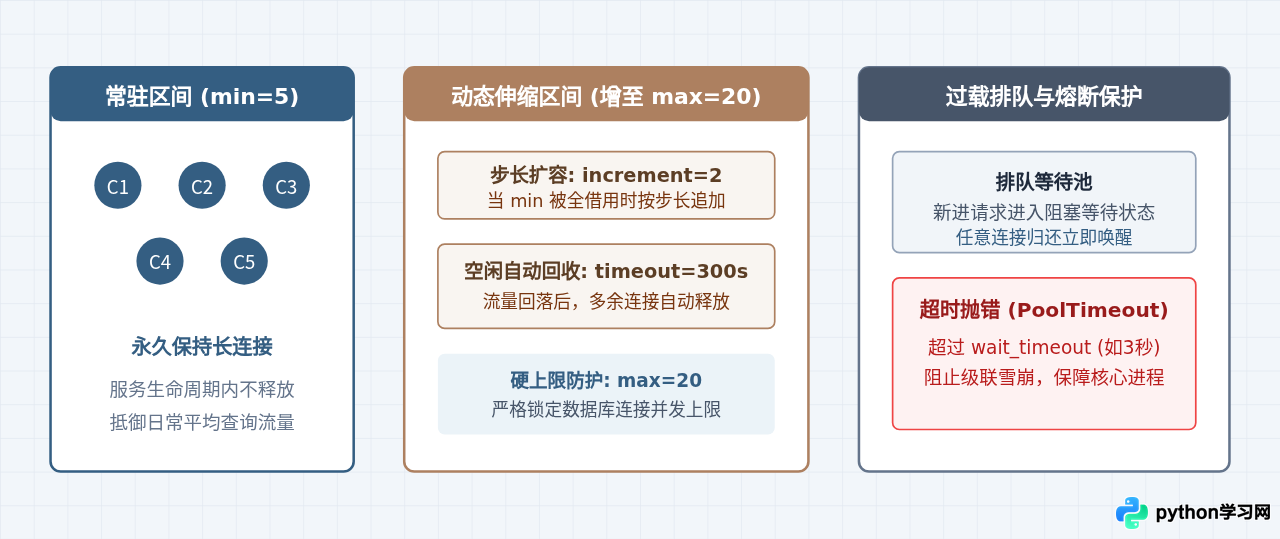
合理配置连接池参数是兼顾系统高吞吐与数据库负载安全的关键。设置过小会导致应用层请求排队超时,设置过大则会耗尽数据库主机内存与线程资源。
| 参数名称 | 推荐取值 | 配置作用与机理解释 |
|---|---|---|
min |
CPU核心数 × 2 | 连接池维持的最小长连接数。服务启动时会立即与数据库建立这些连接并常驻内存,保证基础吞吐平稳。 |
max |
(核心数 × 4) ~ 50 | 连接池允许创建的物理连接上限。这是保护 Oracle 数据库防止被大并发流量打垮的“熔断边界”。 |
increment |
2 ~ 4 | 当所有连接均处于借出状态且有新请求到来时,池一次性向数据库申请新建连接的步长。不宜设为1,避免频繁触发出库请求。 |
wait_timeout |
3000 ~ 5000 (ms) | 当池内连接已达 max 且全部在忙时,新请求挂起等待的最长时间。超时未获得连接则抛出 oracledb.PoolTimeout,实现快速失败保护。 |
timeout |
300 (秒) | 空闲连接生命周期。当瞬时峰值退去,数量超过 min 的空闲连接若在该时间内未被借用,将被自动断开并释放。 |
ping_interval |
60 (秒) | 借出连接前的健康探测周期。网络若经过防火墙,经常会发生空闲连接被防火墙静默 RST 丢弃的问题,开启此参数可自动剔除失效连接。 |
五、高并发查询实践中的四个核心优化
1. 规范连接借用作用域,严防连接泄露
连接泄露是连接池运行中最严重的隐患。如果开发人员直接调用 conn = pool.acquire(),且在执行查询中发生未捕获的业务异常,导致代码跳过了 conn.close(),该物理连接将永远被判定为“在忙”,无法归还池中。当泄露达到 max 次数时,整个连接池将彻底枯竭瘫痪。永远使用 with pool.acquire() as conn: 上下文管理器,这样无论内部发生何种异常或返回,Python 都会在退出代码块时自动执行底层 close()(实际是将连接标记为空闲并归还给池,绝不会切断 TCP 通道)。
2. 设置合理的游标批量预取大小 (arraysize)
默认情况下,Oracle 游标在获取数据时每次网络往返拉取的记录行数较小。对于高并发批量查询场景,在执行 SQL 前显式指定 cursor.arraysize = 100 或更大(根据单行记录字节数调整),可以让底层网络驱动每次拉取 100 条数据,成倍降低客户端与数据库之间的网络通信往返(Round-Trip)次数,显著缩短查询等待时间。
3. 严格使用绑定变量 (Bind Variables)
绝不要在 SQL 字符串中通过拼串或 f-string 传入查询条件。使用绑定变量(如 cursor.execute("SELECT ... WHERE dept_id = :1", [dept_id]))不仅能彻底防范 SQL 注入,更能让 Oracle 的 SGA 共享池复用执行计划(软解析 Soft Parse),避免频繁触发高开销的硬解析(Hard Parse),大幅降低高并发下的数据库 CPU 开销。
4. 连接探活与断线重连
许多企业内网环境中存在防火墙或代理中间件。当连接在池中空闲超过防火墙的闲置超时时间(例如 30 分钟)后,防火墙会静默切断连接而不通知客户端。如果此时应用从池中借出该连接并执行查询,将抛出 ORA-03113: end-of-file on communication channel。通过配置 ping_interval=60,驱动在借出前如果发现该连接闲置超过 60 秒,会自动发送一次轻量级心跳包探活,若已失效则自动重建,杜绝脏连接报错。
六、总结与运维检查清单
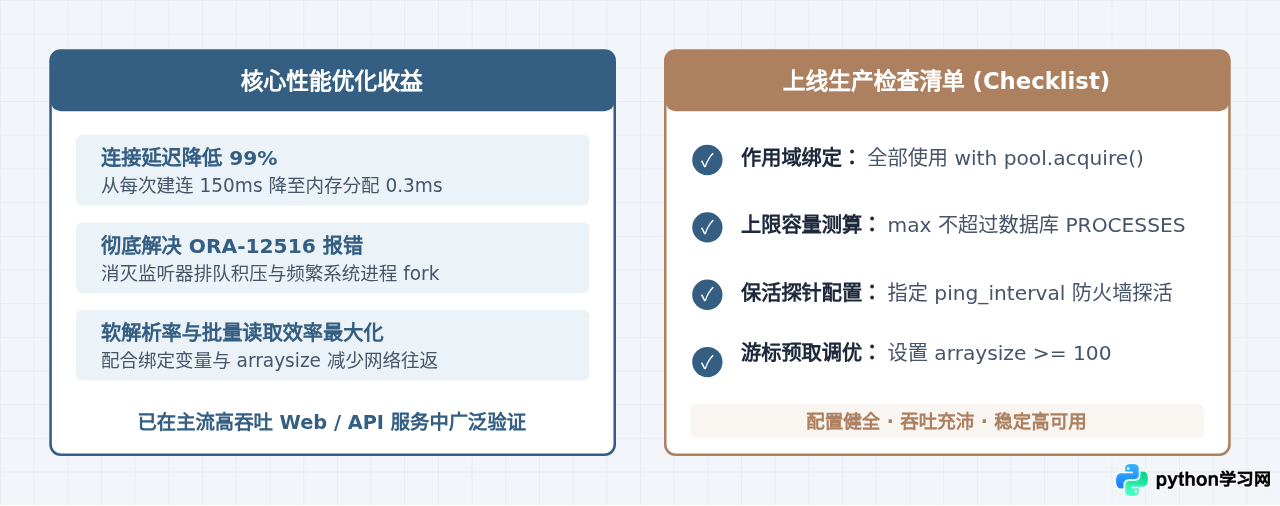
合理配置与使用 Oracle 连接池,能够将 Python 高并发数据查询服务的吞吐能力提升数倍,并有效控制数据库主机的资源开销。下方的架构总结与运维检查卡片归纳了在生产部署时必须核对的关键要点:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















