


Python中os.path与pathlib获取文件名哪个更好用
在Python中获取文件名,os.path与pathlib哪个更好用?本文深入对比两种模块在获取完整文件名、纯文件名主干、文件后缀及多重后缀时的语法表达、边界行为、性能差异与选型建议。
pathlib。pathlib 将路径封装为面向对象实例,直接通过 .name、.stem、.suffix 即可提取完整文件名、无后缀主干和扩展名,语义清晰且避免了多层函数嵌套。而 os.path 基于纯字符串拆分,代码稍显冗长,但在处理超高频纯字符串路径的极致性能场景或维护旧版本代码时仍有一席之地。
一、核心语法与常见场景对比
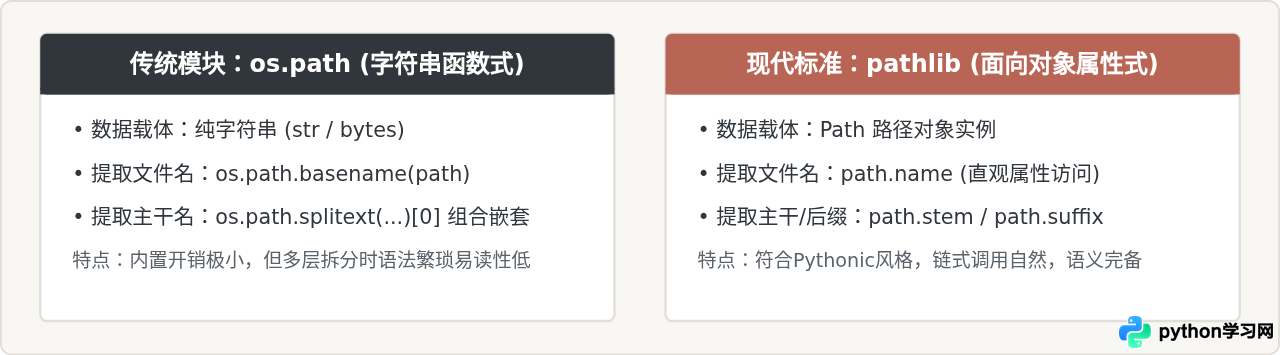
在日常脚本和项目开发中,从完整路径中提取文件名通常分为三类需求:获取“带后缀的完整文件名”、获取“不带后缀的文件名主干”、以及获取“文件扩展名”。两者在实现直观度上有显著差异。
| 需求场景 | os.path 实现方式 | pathlib 实现方式 | 易用性对比 |
|---|---|---|---|
| 完整文件名(如 report.csv) | os.path.basename(p) |
Path(p).name |
两者均单步完成,pathlib属性更平直 |
| 无后缀主干名(如 report) | os.path.splitext(os.path.basename(p))[0] |
Path(p).stem |
pathlib显著优于os.path的双重嵌套 |
| 扩展后缀名(如 .csv) | os.path.splitext(p)[1] |
Path(p).suffix |
pathlib无需索引元组切片,直接表达意图 |
| 复合后缀名(如 .tar.gz) | 需要自行循环 splitext 处理 |
Path(p).suffixes(返回列表) |
pathlib原生支持多重后缀解析 |
| 替换文件名/后缀 | os.path.join(os.path.dirname(p), 'new.txt') |
p.with_name('new.txt') / p.with_suffix('.txt') |
pathlib支持链式替换,无需拼装目录 |
1. 提取完整文件名(Basename)
如果只需要路径末尾的文件名本身,两者的差距还不算巨大:
import os
from pathlib import Path

file_path = "/home/project/data/monthly_report_2026.xlsx"

# 方式一:os.path
name_os = os.path.basename(file_path)
# 示例输出: 'monthly_report_2026.xlsx'

# 方式二:pathlib
name_pathlib = Path(file_path).name
# 示例输出: 'monthly_report_2026.xlsx'
os.path.basename 将路径当作字符串,从最后一个斜杠处截断;而 Path(file_path).name 访问的是该路径对象预置的属性,代码更贴近人类直觉。
2. 提取不含扩展名的主干名(Stem)
当需要重命名文件或生成输出文件名时,最常需要获取“纯文件名”。此时差异立现:
# 方式一:os.path 必须先剥离目录,再用 splitext 拆出元组,取第0个元素
pure_name_os = os.path.splitext(os.path.basename(file_path))[0]
# 示例输出: 'monthly_report_2026'

# 方式二:pathlib 直接读取 stem 属性
pure_name_pathlib = Path(file_path).stem
# 示例输出: 'monthly_report_2026'
在 os.path 中,splitext 接收完整路径返回 ('/home/.../monthly_report_2026', '.xlsx'),如果忘了先调用 os.path.basename,直接取 [0] 就会得到带完整父目录的前缀。这一隐蔽细节让不少初学者产生逻辑错误。而在 pathlib 中,Path.stem 明确定义为“无后缀的文件名”,语义专一明确。
二、从路径到文件名的完整操作流程
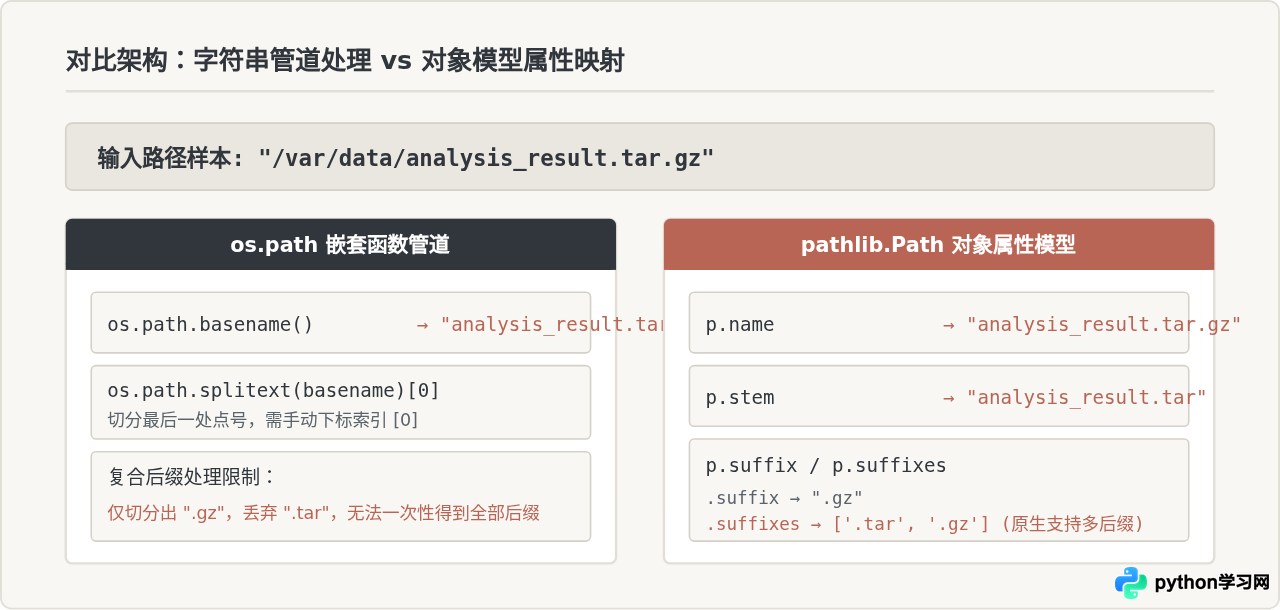
在编写实际程序时,路径输入可能是外部传入的字符串、用户表单或配置文件。理解从字符串输入到最终提取目标属性的标准操作步骤,能有效防止异常和类型不一致问题。
三、核心陷阱与边界情况分析
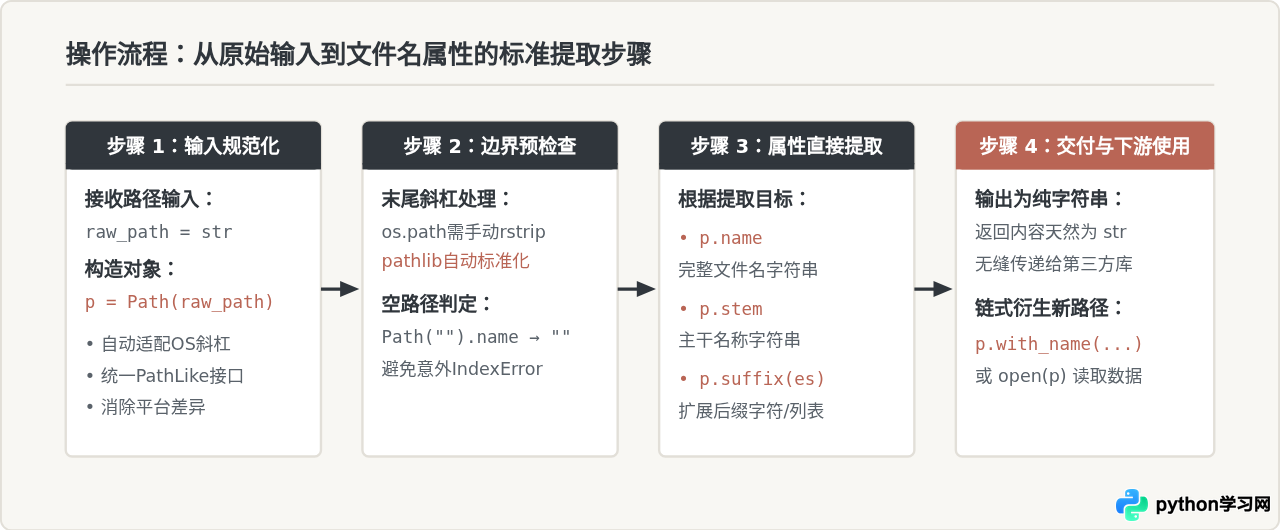
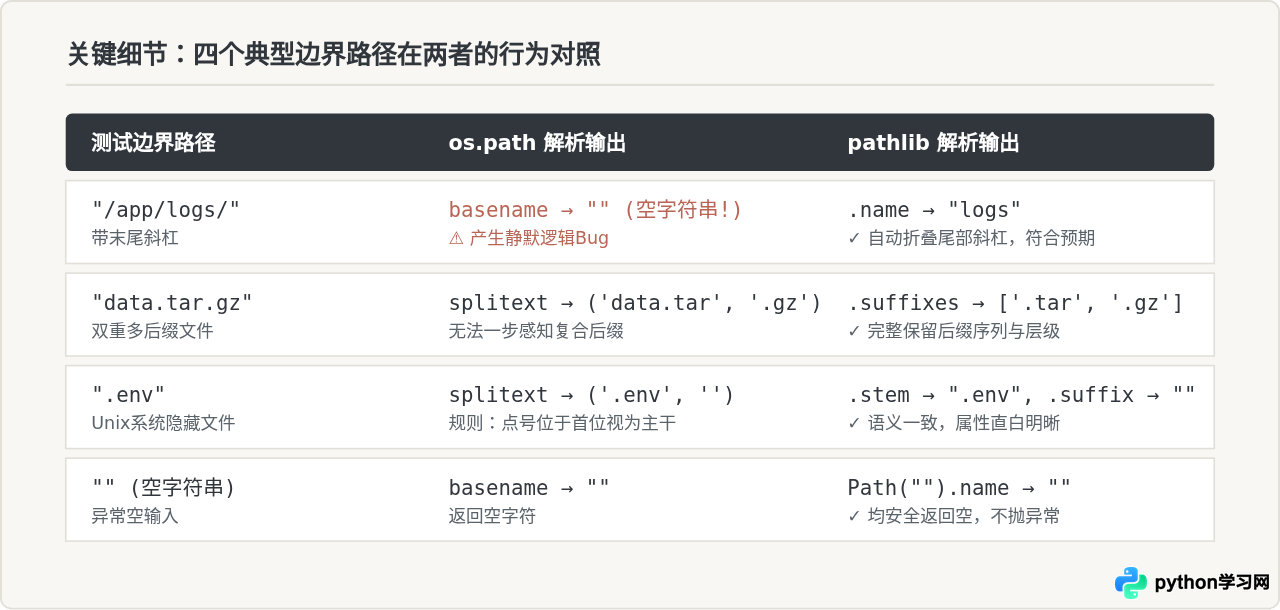
在简单路径下,二者看起来只是写法的区别;但在遇到尾部斜杠、Unix隐藏文件或复合多级后缀等特殊路径时,两者的底层行为差异往往会导致严重缺陷。
1. 尾部斜杠(Trailing Slash)陷阱
在Web框架、用户输入或爬虫抓取到的路径中,经常会出现末尾带有斜杠的情况(如 /data/backup/)。
import os
from pathlib import Path

path_with_slash = "/var/log/nginx/"

# 陷阱表现:os.path.basename 返回空字符串!
print(repr(os.path.basename(path_with_slash)))
# 示例输出: ''

# 预期表现:pathlib 自动规整路径,返回末级目录/文件名
print(repr(Path(path_with_slash).name))
# 示例输出: 'nginx'原因剖析:os.path.basename 是纯粹通过文本切割实现的。当路径以 / 结尾时,切分得到的最后一个片段就是空字符串。如果使用 os.path,必须先手动执行 os.path.basename(path.rstrip('/\\')),这极大增加了防御性编码的负担。而 pathlib.Path 在初始化阶段就会执行路径规范化(Normalization),天然规避了此问题。
2. Unix 隐藏文件的解析差异
在 Linux 和 macOS 环境下,以点开头的隐藏文件(如 .gitignore、.env)经常出现在开发脚本中:
hidden_file = ".gitignore"

# os.path 的拆分规则
print(os.path.splitext(hidden_file))
# 示例输出: ('.gitignore', '')

# pathlib 的拆分规则
p = Path(hidden_file)
print(f"stem: {p.stem}, suffix: {p.suffix}")
# 示例输出: stem: .gitignore, suffix:
对于单点开头的隐藏文件,Python 官方约定将 .gitignore 视为主干名而非扩展名。两者的处理逻辑在此场景下保持了一致,但 pathlib 将其清晰地体现在 .stem 属性上,不需要像处理元组那样去思考 [0] 存的到底是不是后缀。
四、性能对比与开销真相
很多开发者在选择时会问:pathlib 作为一个面向对象系统,会不会比 os.path 慢很多?
在底层实现上,os.path 的大部分函数是高度优化的纯 C 语言字符串操作函数(如 str.rfind 和底层字符串截取)。而 pathlib.Path(...) 涉及到 Python 类实例的创建、路径段的切分及初始化钩子。
os.path.basename 耗时通常在 0.1 ~ 0.2 微秒,而 Path(p).name(包含实例化过程)耗时在 1.5 ~ 3.0 微秒 左右。虽然倍数上看 os.path 明显更快,但在实际业务中,10,000 次操作的总耗时差异也仅在数十毫秒级别。
因此,性能差异的适用边界非常明确:
- 常规业务代码、Web服务、脚本工具:
pathlib的开销完全可以忽略不计。代码的可读性、可维护性和健壮性远比微秒级的差异更有价值。 - 数百万级循环的批处理引擎、高频热路径:如果你在一个极其紧凑的循环中仅仅提取数百万个纯字符串路径的文件名,并且不需要后续的对象功能,此时使用
os.path.basename可以减少对象分配的垃圾回收开销。
五、选型结论与决策指南
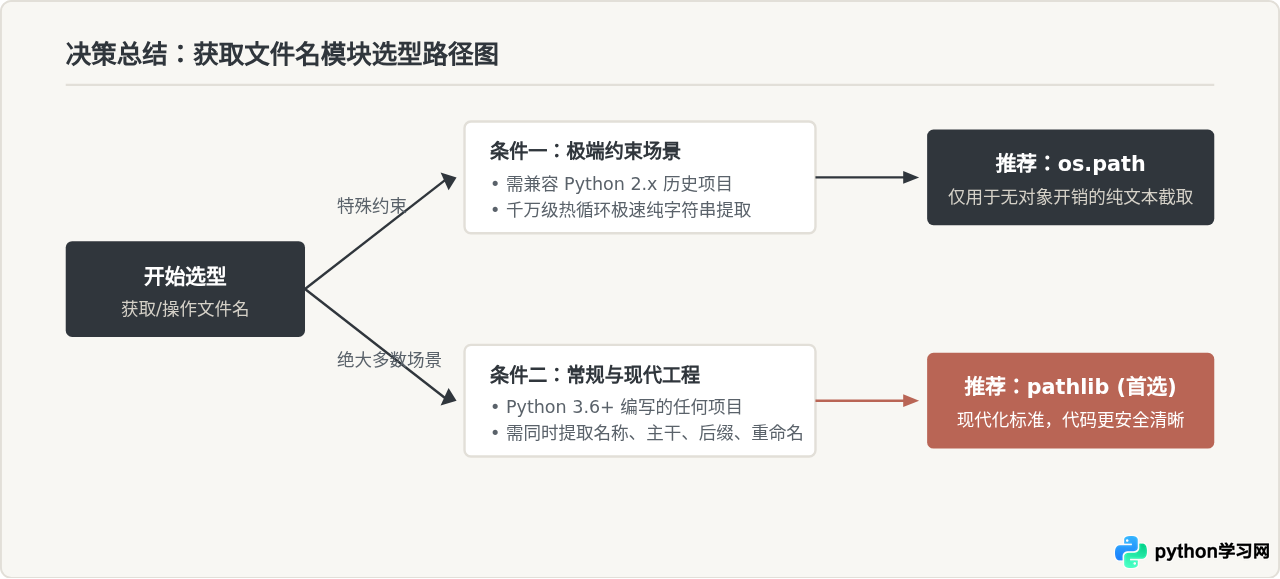
综合代码可读性、边界安全性、API丰富度及长期维护成本,给出以下明确的选型规则:
最终结论
- 好用度首推
pathlib:其面向对象的接口消除了os.path.basename与os.path.splitext的嵌套与切片语法,属性.name、.stem、.suffix语义清晰直观,且原生避免末尾斜杠导致的逻辑异常。 - 生态兼容无须担忧:自 Python 3.6 引入 PEP 519 协议之后,标准库(如
open())及主流第三方库(如pandas、numpy)均直接支持接收Path对象。 - 平稳过渡建议:新编写的代码和模块推荐全面采用
pathlib;老项目中运行良好的os.path代码无需刻意大规模重构,但在新增包含复杂后缀或频繁重命名逻辑时,应逐步切换到pathlib。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















