


Python自学路线图:从环境搭建到项目实战的完整学习路径
本文梳理了一套从零开始高效自学Python的完整工程路径,覆盖开发环境配置、基础语法核心、面向对象机制、阶梯式项目演进与高频避坑防线。
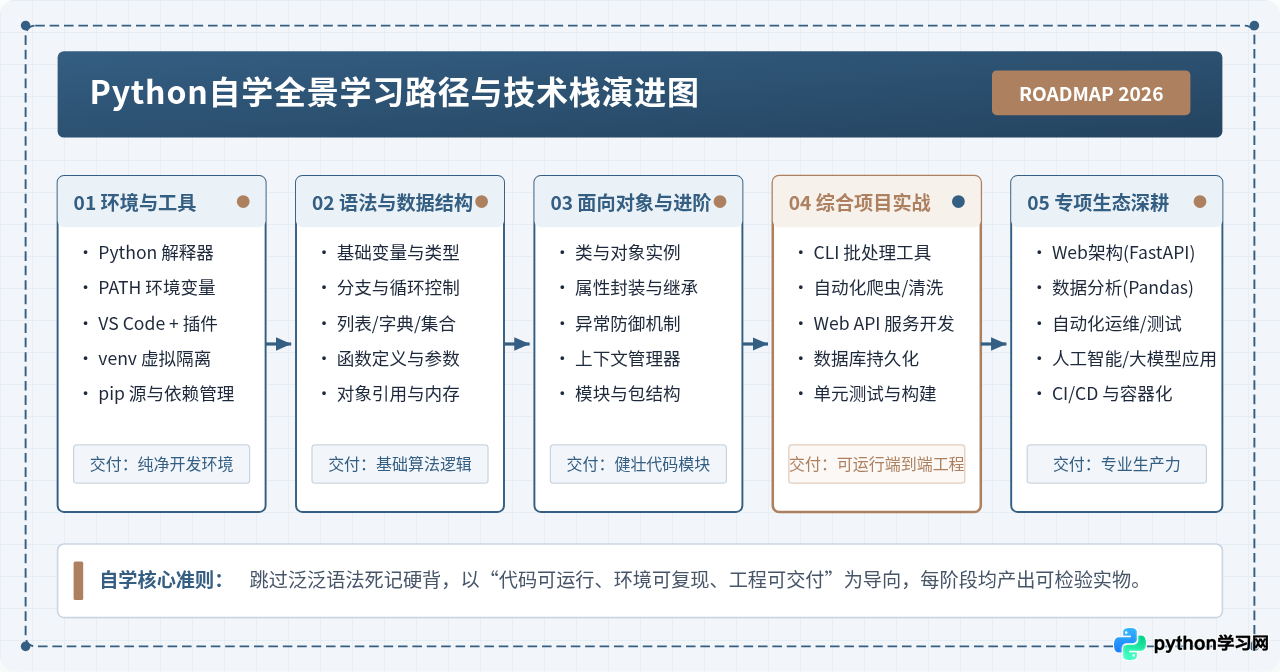
一、标准开发环境搭建与工具链配置
自学Python的第一步并非直接写代码,而是搭建一套隔离、规范且不易出错的本地工程环境。许多初学者由于跳过这一阶段,直接在全局环境中混装各类依赖,导致后续在不同项目间频繁遭遇包版本冲突与路径找不到等隐蔽问题。
1. 解释器下载与安装要点
前往Python官方网站(python.org)下载最新的稳定版本(建议选择Python 3.11或3.12稳定维护版)。在安装过程中,Windows用户务必在安装引导的第一页勾选 Add python.exe to PATH,这一步会将解释器和包管理工具自动注册到系统环境变量中。若未勾选,后续在终端输入 python 命令将会提示命令未找到。
macOS或Linux用户推荐直接使用系统的包管理器(如Homebrew)或 pyenv 进行多版本管理。在系统自带Python环境的基础上,保持独立安装的用户版解释器与系统工具解耦。
2. 编辑器与工程插件集成
初学者推荐使用轻量且工程支持完善的 Visual Studio Code。安装完成后,需在扩展市场中补充以下核心插件:
- Python(Microsoft官方出品):提供代码提示、运行调试及测试运行器支持。
- Pylance:基于类型推断的高性能语言服务,负责静态语法检查与跳转定义。
- Ruff 或 Black Formatter:用于代码格式化与质量检测,强制遵循PEP 8行业编码规范。
3. 虚拟环境(Virtualenv)的创建与管理
在Python工程实践中,“永远不要向系统全局Python环境中随意安装第三方库”。每一个自学项目都应当拥有自己专属的独立运行环境。通过Python内置的 venv 模块即可零额外依赖完成隔离:
# 1. 创建并进入项目专用工作目录
mkdir my_project && cd my_project

# 2. 在当前目录下创建名为 .venv 的虚拟环境目录
python -m venv .venv

# 3. 激活虚拟环境
# macOS / Linux 平台执行:
source .venv/bin/activate
# Windows PowerShell 平台执行:
.venv\Scripts\Activate.ps1
# Windows CMD 平台执行:
.venv\Scriptsctivate.bat(.venv) 标识时,说明环境已成功激活。此时执行 which python(Windows下为 where python),输出的绝对路径必定指向当前项目目录下的 .venv 文件夹,而非系统全局路径。
二、核心语法掌握与运行机制理解
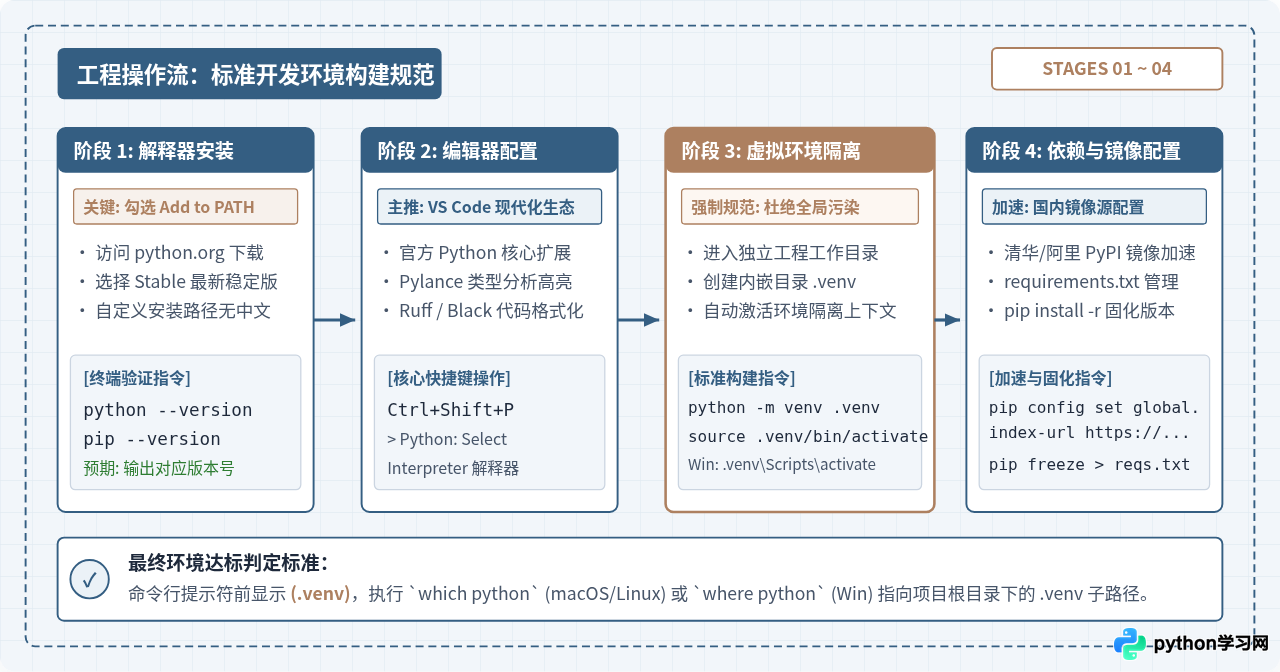
完成环境搭建后,进入基础语法学习阶段。学习语法时不建议通读厚重的手册,而应把注意力集中在核心概念与Python独有的运行机制上,重点搞清“内存中到底发生了什么”。
1. 必备基础语法清单
初学者应在1至2周内集中突破以下关键知识点:
- 基本数据类型:整数(
int)、浮点数(float)、字符串(str)、布尔值(bool)的运算与格式化(推荐使用f-string)。 - 容器结构:列表(
list,有序可变)、元组(tuple,有序不可变)、字典(dict,键值对映射)、集合(set,无序去重)。熟练掌握列表推导式与字典解析。 - 控制流与函数:条件分支
if/elif/else,遍历循环for...in与while,函数的定义、位置参数、默认参数、以及*args与**kwargs的解包语法。
2. 对象引用与可变/不可变机制
Python是一门面向对象的动态语言,其底层变量机制与C/C++等语言存在本质区别。在Python中,“变量名只是贴在对象上的标签”,赋值操作本质上是建立引用绑定,而非在内存中开辟新空间复制数据。
# 易混淆场景示例:列表的可变性与引用传递
list_a = [1, 2, 3]
list_b = list_a  # 仅仅复制了内存引用,未创建新列表

list_b.append(4)
print(list_a)  # 示例输出:[1, 2, 3, 4]!list_a 受到影响

# 正确的独立克隆方式
import copy
list_c = copy.deepcopy(list_a)
list_c.append(99)
print(list_a)  # 示例输出:[1, 2, 3, 4],不受 list_c 影响
理解不可变对象(如数字、字符串、元组)与可变对象(如列表、字典、集合)在内存中的表现,是避免在函数默认参数与数据传递中出现严重逻辑Bug的关键。
三、面向对象编程、模块化与工程基础
编写超过100行代码的程序时,过程式脚本便会开始出现函数命名混乱、状态难以维护的问题。此时必须引入面向对象编程(OOP)与模块化设计思维。
1. 类与对象的封装
类是对象的蓝图。在定义类时,通过 __init__ 构造方法初始化内部属性,使用私有属性前缀(如 _protected_field 或 __private_field)控制访问边界。配合内置特殊方法(如 __str__、__repr__、__len__),使自定义对象能够自然融入Python的内置语法生态中。
2. 异常防护与上下文管理器
在涉及网络请求、文件读写和数据库连接时,必须使用结构化异常捕获。坚决杜绝书写裸 except: pass,以免隐藏不可预期的致命错误。同时,通过上下文管理器(with 语句)确保系统资源在使用后被稳定释放:
# 规范的上下文管理与异常处理范式
from typing import Optional

class DatabaseSession:
    def __init__(self, db_name: str) -> None:
        self.db_name = db_name
        self.is_connected = False

    def __enter__(self):
        print(f"正在建立连接: {self.db_name}")
        self.is_connected = True
        return self

    def __exit__(self, exc_type, exc_val, exc_tb):
        print("执行连接清理与事务释放")
        self.is_connected = False
        # 返回 False 允许外部捕获异常,若返回 True 则会静默吞掉异常
        return False

# 实际调用示例
try:
    with DatabaseSession("analytics.db") as session:
        # 执行业务操作
        print(f"执行数据库操作,连接状态: {session.is_connected}")
except Exception as err:
    print(f"捕获执行期异常: {err}")
3. 标准库与项目分包结构
不要在未了解标准库的前提下盲目安装外部依赖。Python自带的“内置电池”包含丰富的高质量模块:文件路径处理优先使用 pathlib 替代老旧的 os.path;时间处理使用 datetime;格式化数据使用 json 与 csv;命令行参数使用 argparse。
四、阶梯式项目实战演进
许多自学者在看完语法视频后出现“大脑懂了但手写不出代码”的断层,原因在于缺乏阶梯式的工程演练。切忌初学完语法就直接挑战大型商城或复杂机器学习项目,而应按照由浅入深的三个阶段逐步建立工程信心。
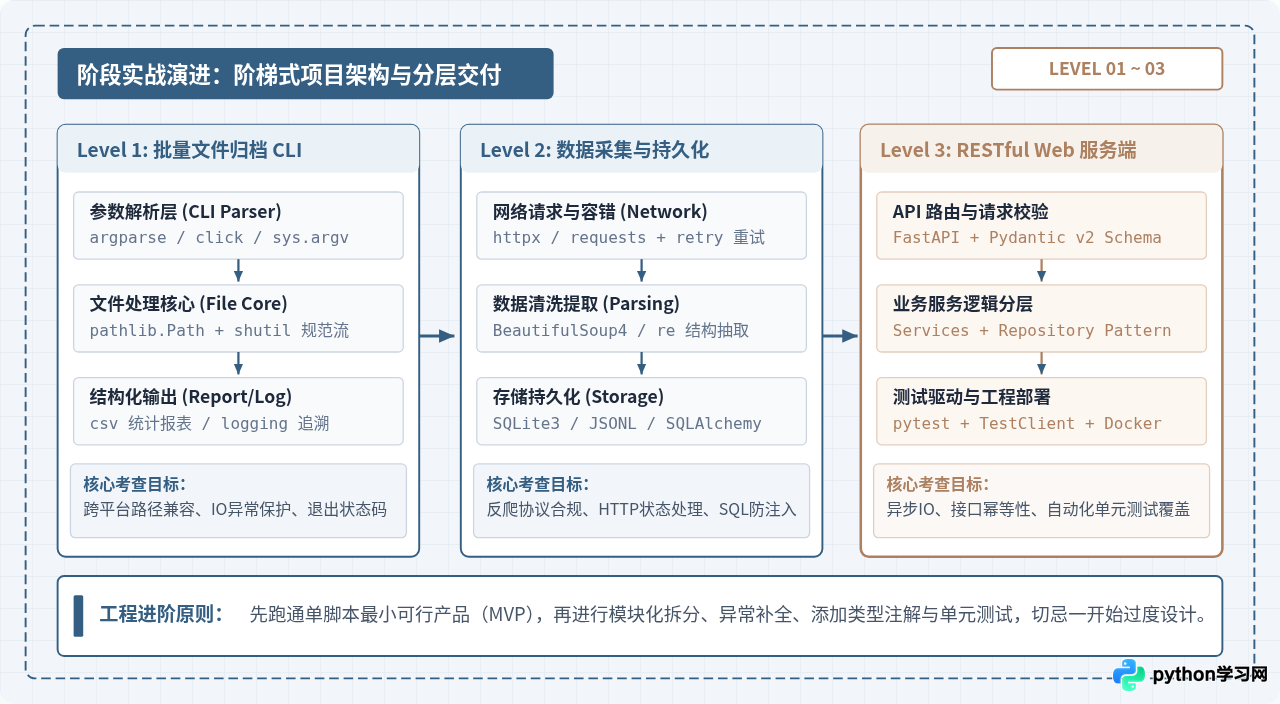
Level 1 实战:命令行批量文件归档工具
项目目标:编写一个能够扫描指定目录,根据文件后缀名与修改日期自动将杂乱文件分类整理归档到不同子目录的CLI工具,并输出操作统计报表。
运用技术栈:pathlib.Path、shutil、argparse、logging。
成果要求:支持 --source 与 --target 命令行参数;遇到同名文件时提供重命名策略;支持模拟运行(Dry-Run)模式,在不实际移动文件的情况下预览结果。
Level 2 实战:自动化数据采集与持久化系统
项目目标:针对公开的资讯或电商价格页面,定时抓取目标字段,进行数据清洗并持久化存储到本地数据库中,具备重试与防阻塞机制。
运用技术栈:httpx 或 requests(HTTP交互)、BeautifulSoup4(HTML解析)、sqlite3 或 SQLAlchemy(数据库存储)。
关键工程点:添加自定义 User-Agent 标头;针对 429 和 5xx 状态码加入指数退避重试(Exponential Backoff);使用参数化SQL语句杜绝SQL注入漏洞。
Level 3 实战:RESTful API 服务端接口设计
项目目标:搭建一套结构清晰的待办事项或资产管理后端接口,实现标准的 CRUD 操作、数据有效性校验与自动化单元测试。
运用技术栈:FastAPI(现代高性能Web框架)、Pydantic v2(数据模型校验)、pytest(自动化测试框架)。
# FastAPI 核心接口设计示例
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from typing import List

app = FastAPI(title="任务管理服务", version="1.0.0")

class TaskCreate(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=3, description="优先级:1低 2中 3高")

class TaskResponse(TaskCreate):
    id: int
    completed: bool = False

# 模拟内存数据库
_db = []

@app.post("/tasks", response_model=TaskResponse, status_code=201)
def create_task(task_in: TaskCreate):
    new_task = TaskResponse(
        id=len(_db) + 1,
        title=task_in.title,
        priority=task_in.priority,
        completed=False
    )
    _db.append(new_task)
    return new_task

@app.get("/tasks", response_model=List[TaskResponse])
def get_tasks():
    return _db
五、自学能力矩阵检验与高频踩坑防御雷达
自学过程中最宝贵的资源是时间与精力。通过建立客观的检验标准,能够精准判断自己当前处于哪个发展阶段,并提早避开自学过程中常见的负面循环。
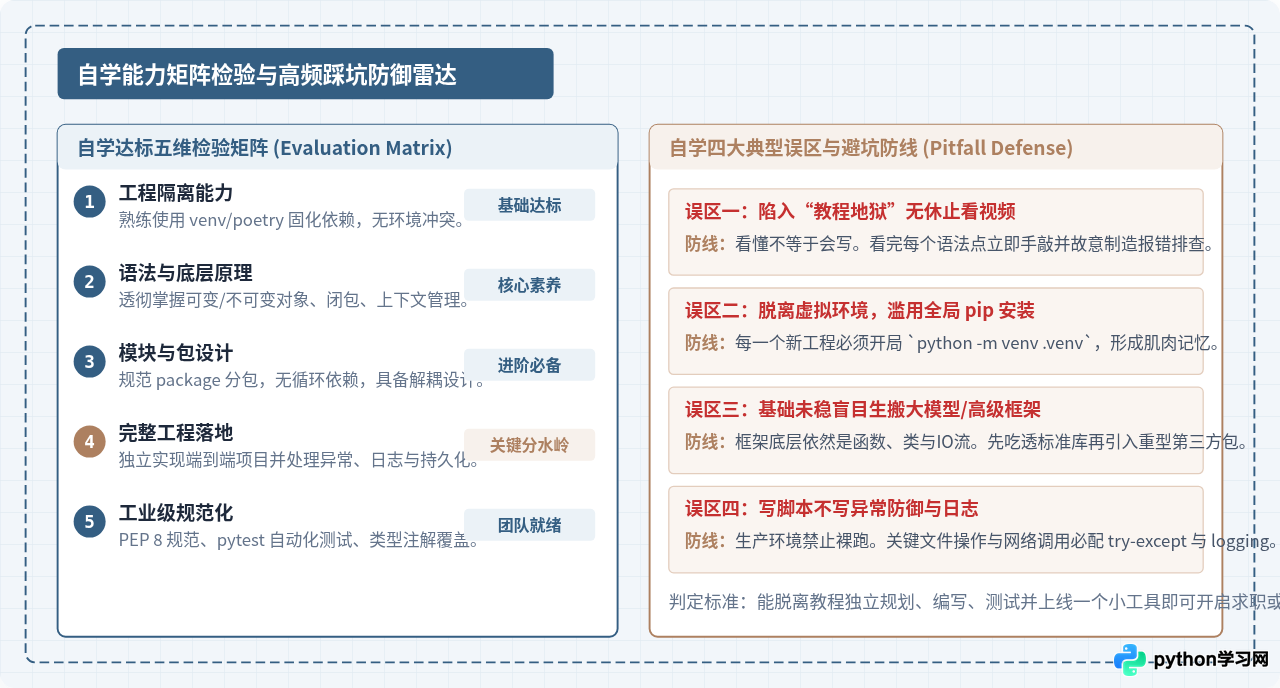
1. 自学者极易陷入的四大误区
- 陷入“教程地狱”(Tutorial Hell):长期停留在看视频、买网课的被动接受状态,看到讲师敲代码觉得自己全懂,关掉视频面对空白文件却敲不出前十行。化解方法:坚持“看两成、写八成”原则,每看完一个小章节必须关闭参考代码,凭记忆在终端中独立复现并修改测试。
- 全局混装与依赖污染:图省事不建虚拟环境,所有
pip install均装在全局。半年后遇到不同开源项目依赖相互冲突的库版本时,导致全局环境彻底瘫痪。化解方法:每个项目第一件事就是python -m venv .venv。 - 跳过底层直接套用大模型生成代码:在尚未理解基础数据结构与函数作用域时,过度依赖AI辅助生成大段代码,当程序发生隐蔽逻辑错误或类型异常时完全无从下手排查。化解方法:初期阶段坚持手敲核心逻辑,将AI作为语法报错解释器与代码重构评审员,而非直接抄袭盲盒。
- 缺乏版本控制与测试意识:项目代码不使用 Git 进行版本提交,修改错误后只能反复
Ctrl+Z;测试全凭肉眼在终端打print。化解方法:自学到项目阶段时,主动学习基础 Git 命令(add,commit,branch),并为关键业务函数编写至少一个pytest断言用例。
2. 阶段达成与求职准备的客观标准
如何判断自己是否已经达到合格的初级Python工程师水平?可以参考以下三项客观检验指标:
- 环境可复现性:任意将你的项目代码打包发送给他人,只需执行
pip install -r requirements.txt并在同版本解释器下即可一次性运行成功,无缺失文件或绝对路径硬编码问题。 - 独立排错能力:遇到 Traceback 报错栈时,能迅速定位到底层出错文件名与具体行号,准确区分
TypeError、AttributeError与KeyError并自主修复。 - 端到端交付:拥有至少一个脱离教程、自行设计需求、实现功能、编写测试并编写了清晰
README.md使用文档的开源项目。
循序渐进地沿着“搭建隔离环境 → 掌握核心语法与对象模型 → 编写模块化与稳健代码 → 完成阶梯式实战交付”的路线稳步实践,便能扎实建立属于自己的Python工程化核心能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















