


Python在线编译器代码超时怎么办
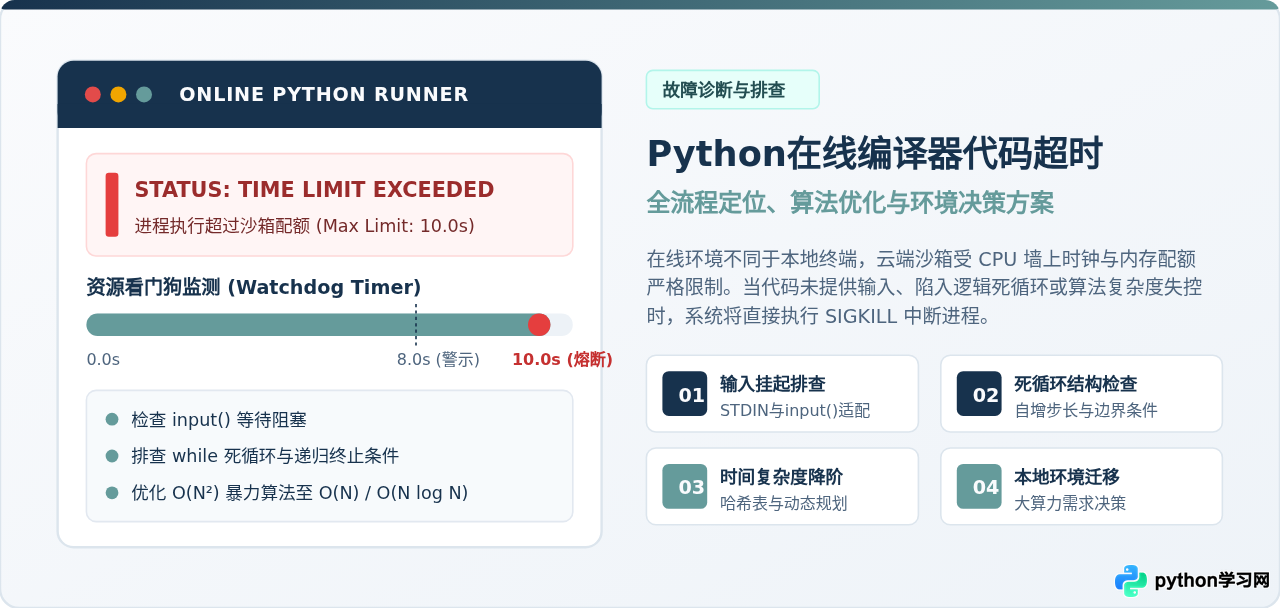
针对Python在线编译器运行报超时(Time Limit Exceeded/Execution Timed Out)的问题,详细剖析沙箱资源配额机制,提供检查输入挂起、排查死循环、算法复杂度优化及环境迁移的完整排查步骤与可运行示例。
input() 导致进程在无交互环境下永久等待输入;其次检查 while 循环和递归函数是否缺少有效的退出条件从而陷入死循环;接着评估算法时间复杂度是否过高;若任务本身涉及海量数据计算或大型文件批处理,则应果断将代码迁移至本地独立Python环境中执行。
一、在线编译器超时的背后机制:为什么本地能跑在线却超时?
不少初学者在遇到超时报错时常常感到困惑:同样的代码在自己的电脑终端里明明可以正常运行并打印出结果,为什么复制到在线编译器就直接报错?要有效解决超时,首先需要理解在线编译器的运行原理。
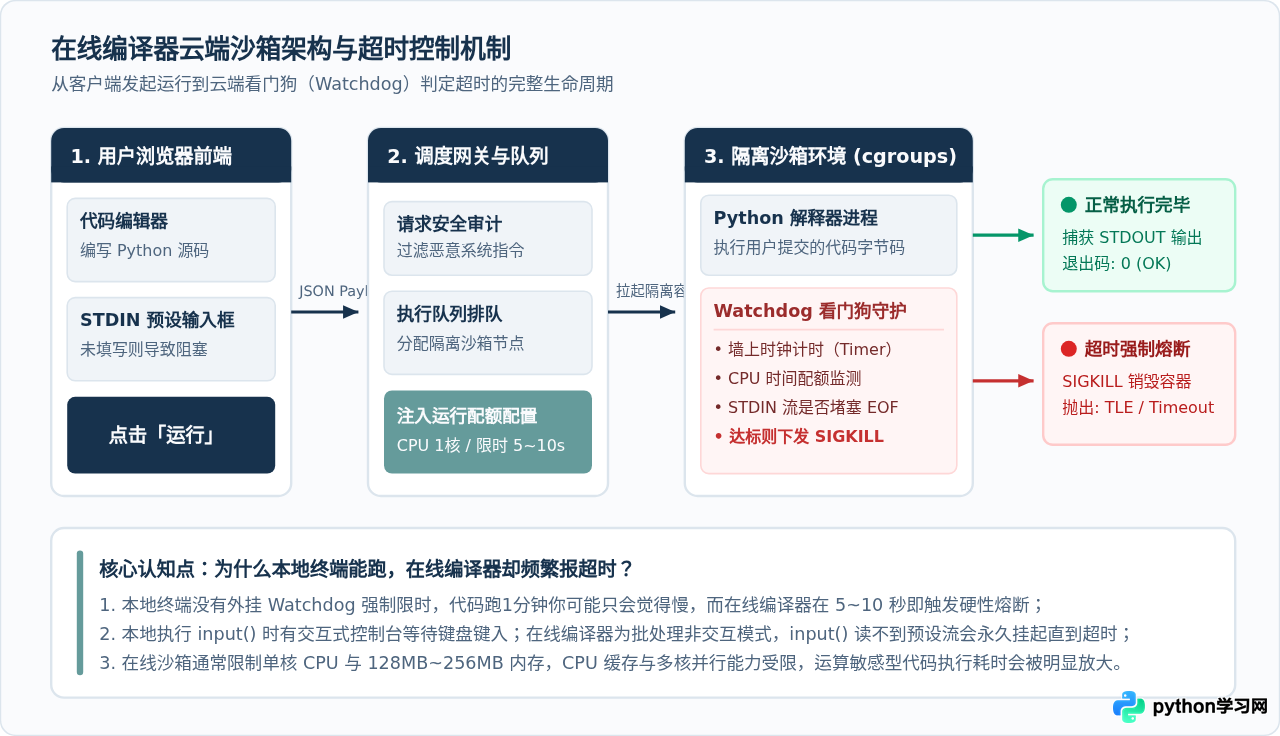
本地计算机运行Python代码时,系统会将全部硬件资源按需分配给解释器,并且只要用户不手动按下快捷键中断(如 Ctrl+C),进程可以持续运行几分钟甚至几小时。而在浏览器中使用的在线编译器(如菜鸟教程工具、Replit、LeetCode在线执行器等),本质上是由云端服务器动态创建的隔离沙箱容器(基于Docker、gVisor或Linux cgroups隔离技术)。
为了防止单个用户的耗时任务或恶意脚本耗尽服务器的CPU与内存资源,平台运维系统会在沙箱外挂载一个看门狗守护进程(Watchdog Timer)。看门狗对每一次代码执行施加了三道硬性限制:
- 墙上时钟限制(Wall-clock Time Limit):不论CPU是否在高速运算,从点击运行按钮起算,若总体耗时超过预设阈值(绝大多数平台设定为5秒至10秒),看门狗会立即向Python解释器发送
SIGKILL信号强行销毁容器。 - 计算核数与CPU限额:沙箱通常被严格限制在单核(甚至0.5核)CPU配额内运行,无法享受本地多核处理器的并发缓存加速。
- 输入输出(I/O)缓冲限制:在线环境多为无控制台的批处理模式,缺乏持久的双向交互终端。如果代码发起等待输入的系统调用而外部没有输入流,进程就会在等待中直接耗尽时间。
二、逐步排查与修复流程
当屏幕上出现超时提示时,无需盲目重写全部代码,建议按照以下由快到慢的四个步骤依次排查。
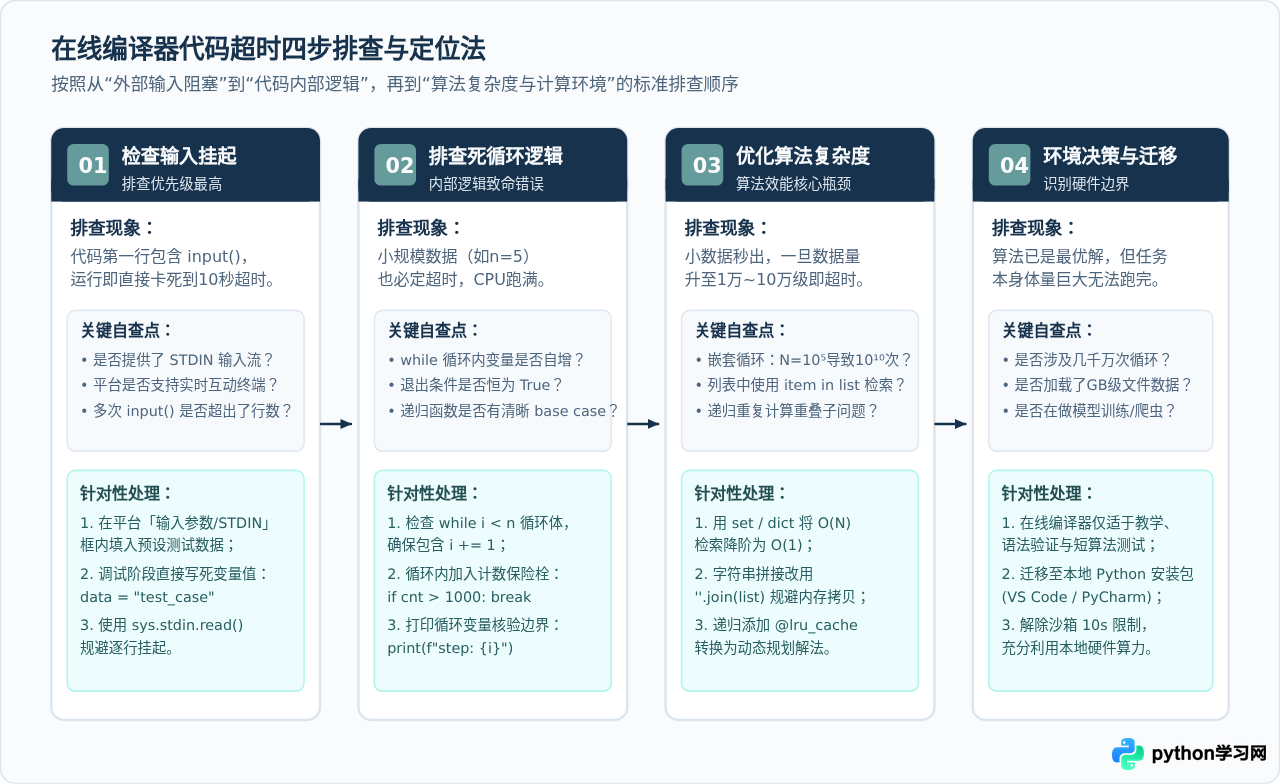
第一步:排查 input() 交互输入阻塞(优先级最高)
这是在线编译器中最常见、也最容易被忽视的超时诱因。许多初学者写完如下包含交互提示的代码直接点击运行:
# 容易在在线编译器中引发超时的写法
name = input("请输入你的姓名:")
age = int(input("请输入你的年龄:"))
print(f"你好 {name},你的年龄是 {age}")
在本地运行这段代码时,终端会停下来等待用户敲击键盘输入并回车。但在绝大多数简易在线编译器中,并没有实时交互终端,解释器执行到 input() 时便挂起等待标准输入(STDIN)。由于云端始终没有接收到字符流,看门狗在达到10秒限制后判定超时并报错。
- 使用平台的STDIN预设输入区:检查在线网页中是否有“输入参数”、“STDIN”或“自定义输入”文本框,在运行前将所需输入的内容按行填入(例如第一行填
张三,第二行填20)。 - 调试期间改用静态变量赋值:若只是验证后续处理逻辑,先注释掉
input(),直接将测试数据写死在代码中:# 调试适配写法 name = "张三" age = 20 print(f"你好 {name},你的年龄是 {age}")
第二步:排查死循环与递归基底缺失
如果代码中并没有 input(),且即便输入规模非常小(例如处理只有3个元素的列表)也会立即超时,问题通常出在逻辑死循环或递归无法收敛上。
检查 while 循环时,重点确认循环体内是否遗漏了改变循环条件的计数步长。例如以下典型笔误:
# 错误示例:遗漏自增导致死循环
i = 0
total = 0
while i < 10:
    total += i
    # 忘记编写 i += 1,变量 i 永远为 0,循环永不终止
print(total)
在递归函数中,必须确认“递归基底(Base Case)”是否完备。若终止分支的判断条件永远无法满足,或者递归调用的参数没有向基底逼近,就会导致递归深度持续向下延伸,在耗尽调用栈之前往往就先触发了执行超时。
在调试疑似死循环的代码块时,可在循环内临时放置一个计数器,当迭代次数超过合理上限时强制
break 并打印调试信息:
debug_counter = 0
while condition:
    # 业务逻辑...
    debug_counter += 1
    if debug_counter > 5000:
        print("警告:循环已达5000次,可能存在死循环!")
        break
第三步:分析算法复杂度与运算量规模
如果小规模数据可以顺利出结果,而只要输入数据量上升(例如从 100 增加到 50,000)就会超时,这表明代码不存在死循环,而是算法时间复杂度过高,算力开销超过了云端单核沙箱的承载上限。
在Python单核执行环境下,通常每秒能够完成的基本运算次数大约在 10^7(一千万次)量级左右。如果给定的数据规模为 N = 100,000:
- O(N) 算法:大约执行 10 万次运算,耗时约 0.01 秒,轻松通过;
- O(N log N) 算法:大约执行 170 万次运算,耗时约 0.1 秒,安全通过;
- O(N²) 算法:双重嵌套循环需要执行
100,000 × 100,000 = 10^10(一百亿次)运算,即便在高性能电脑上也需要十几秒甚至数分钟,在限制10秒的在线编译器中必定超时。
第四步:检查海量终端打印输出(I/O瓶颈)
不少读者习惯在循环体内部使用 print() 观察变量变化:
# 隐蔽的超时诱因:频繁终端输出
for i in range(100000):
    print(f"正在处理第 {i} 项")  # 频繁引发I/O中断与网络传输开销
在计算机底层,标准输出 sys.stdout 属于耗时较长的I/O操作。当循环执行数十万次 print() 时,Python需要频繁调用操作系统内核将字符写入管道,在线沙箱还需要将大量文本打包为WebSocket或HTTP响应推送到前端。过量的打印不仅会产生巨大的时间延迟导致超时,还可能直接触发浏览器的渲染卡死。
if i % 10000 == 0: print(...))输出进度。
三、典型超时场景与优化重构示例
针对算法引起的超时,将低效代码重构为高阶时间复杂度的写法即可迎刃而解。以下展示三个最普遍的实战场景对照。
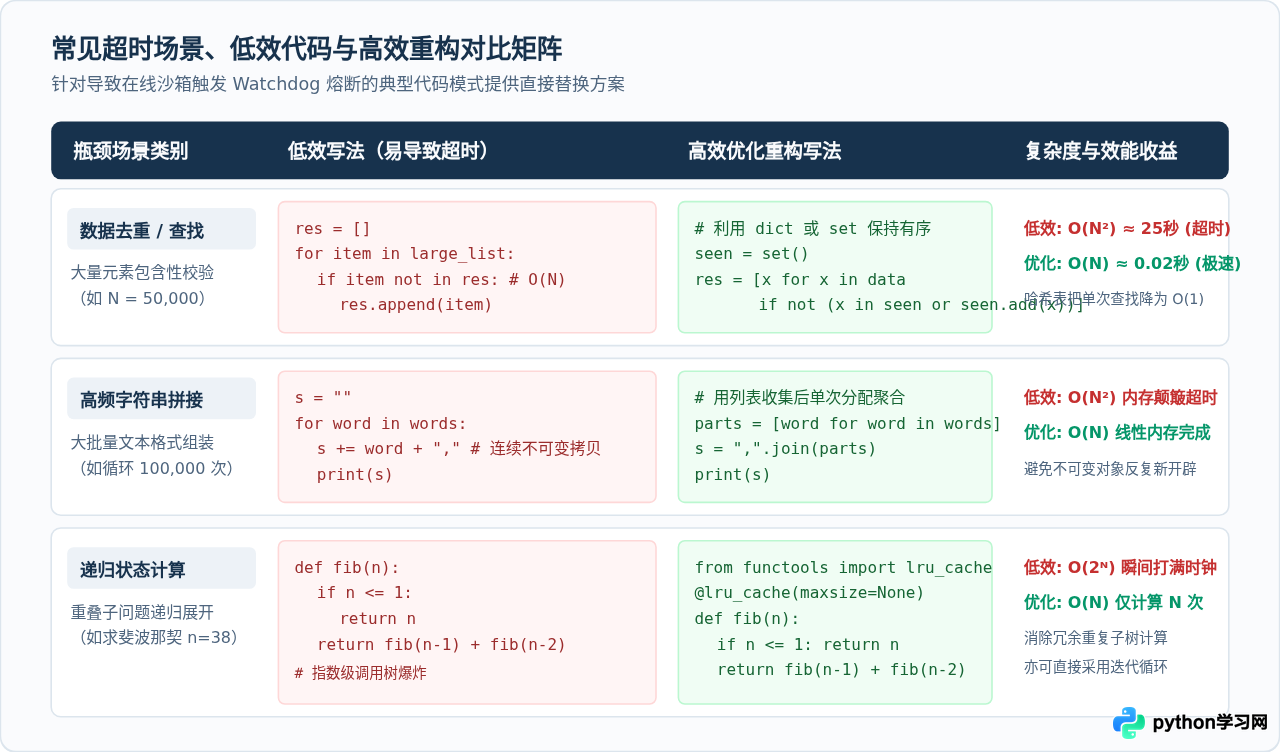
场景 1:列表线性查找去重 vs 哈希集合查找
需求:给定一个包含重复元素的列表,要求在保留原有相对顺序的前提下完成去重。
# 低效写法:列表 in 操作耗时为 O(N),嵌套在循环中总体为 O(N²)
def deduplicate_slow(items):
    unique_items = []
    for item in items:
        # 每次判断 item not in unique_items 都会遍历 unique_items
        if item not in unique_items:
            unique_items.append(item)
    return unique_items

# 高效重构:使用 set 实现 O(1) 瞬时哈希检索,总体复杂度降为 O(N)
def deduplicate_fast(items):
    seen = set()
    unique_items = []
    for item in items:
        if item not in seen:
            seen.add(item)
            unique_items.append(item)
    return unique_items
当 items 长度为 50,000 时,低效写法在在线编译器中会耗时 15 秒以上直接被强杀;而优化后的哈希表版本仅需 0.015 秒即可完成,效率提升千倍以上。
场景 2:字符串循环 += 拼接 vs 列表 join() 聚合
在Python中,字符串属于不可变对象(Immutable)。每次执行 s += chunk,底层解释器都必须在内存中重新申请一块更大的空间,并将旧字符串和新字符依次复制过去。随着字符串长度增长,内存分配与数据拷贝的开销会呈二次方递增。
# 低效写法:频繁开辟新字符串内存
def build_report_slow(tokens):
    content = ""
    for token in tokens:
        content += token + "\n"
    return content

# 高效重构:利用列表存储,最后一次性调用 join 单次分配内存
def build_report_fast(tokens):
    return "\n".join(tokens) + "\n"
场景 3:重叠子问题递归 vs 记忆化缓存(动态规划)
以经典的斐波那契数列计算为例,未加优化的朴素递归会产生巨大的重复计算二叉树,时间复杂度高达 O(2^N)。在在线编译器中,计算到第35项左右就会发生明显的等待,到第40项时便会无可挽回地超时。
# 低效写法:O(2^N) 递归树爆炸
def fib_slow(n):
    if n <= 1:
        return n
    return fib_slow(n - 1) + fib_slow(n - 2)

# 高效重构方案一:使用内置 lru_cache 自动记忆化中间状态,降为 O(N)
from functools import lru_cache

@lru_cache(maxsize=None)
def fib_memo(n):
    if n <= 1:
        return n
    return fib_memo(n - 1) + fib_memo(n - 2)

# 高效重构方案二:迭代循环递推(空间复杂度 O(1),时间复杂度 O(N))
def fib_iterative(n):
    if n <= 1:
        return n
    a, b = 0, 1
    for _ in range(2, n + 1):
        a, b = b, a + b
    return b
四、如何验证代码已彻底解决超时
在修改了代码后,不要仅凭感觉判断是否解决,可以通过内置的高精度计时器在在线环境中实测执行时间。
Python标准库提供的 time.perf_counter() 能够以纳秒级的精度测量代码执行的实际耗时。将核心逻辑包裹在计时代码之间,能够直接量化优化效果:
import time

start_time = time.perf_counter()

# 执行你的核心业务函数
result = deduplicate_fast(test_data)

elapsed = time.perf_counter() - start_time
print(f"数据处理完成,耗时: {elapsed:.4f} 秒")五、何时应当放弃在线编译器转用本地环境?
在线编译器非常适合学习基础语法、快速验证轻量代码片段以及面试答题。但当任务本身具有特定的工业级特征时,继续花费时间在在线编译器上“抠性能”是不符合工程现实的。
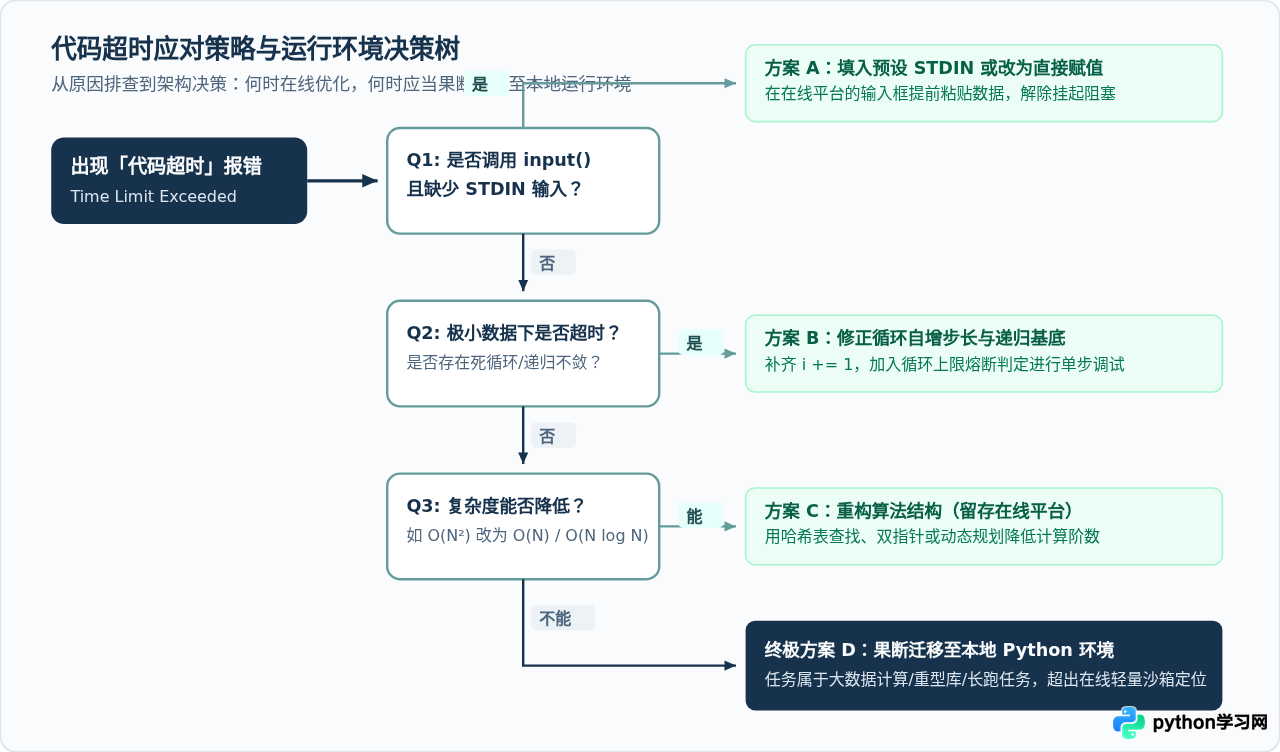
如果你的程序属于以下任意一种情形,建议直接切换到本地安装的 Python(配合 VS Code、PyCharm 或 Jupyter Notebook):
| 任务类型 | 在线编译器瓶颈 | 本地环境优势 |
|---|---|---|
| 海量数据处理与科学计算(如千万行级 Pandas/NumPy 操作) | 沙箱内存通常限制在 128MB~256MB,CPU核数单核受限,无法发挥并行优势。 | 可完全调用本地大内存与多核 CPU,支持磁盘虚拟内存交换,运行无时间上限。 |
| 深度学习与模型推理(如 PyTorch、TensorFlow) | 普通在线编译器无 GPU 硬件加速,大模型加载即打满内存与时钟。 | 可直接调度本地独显(Nvidia CUDA / Apple Silicon MPS)加速张量运算。 |
| 网络爬虫与并发下载 | 多数在线平台出于安全考虑,沙箱容器内部禁止对外发起 Socket 连接。 | 无网络沙盒限制,可自由使用 aiohttp、requests 调度并发请求。 |
| 图形界面(GUI)与音视频处理 | 无本地显卡渲染环境与显示服务(X11/Wayland),窗口组件无法弹出。 | 原生调用系统窗口渲染,支持实时交互与音视频流播放。 |
总结
遇到 Python 在线编译器代码超时,牢记“先查外部交互,再看内部循环,后查算法复杂度”的三步铁律。确保 input() 拥有预设输入流、确保循环变量具备收敛退出条件、用哈希表与动态规划消除 O(N²) 冗余计算,绝大多数在线超时问题都能在数分钟内得到解决。当计算任务确实超出沙箱定位时,果断迁移至本地开发环境才是最高效的技术选择。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















