


学术文献AI翻译怎么选:准确率与专业性对比
针对学术研究场景,本文指出不能盲目依赖通用“准确率”排名。通过解析限定条件丢失、文档解析错误等核心风险,提出将文本翻译与整篇阅读分离的选型策略。建议建立个人小样本测试集,区分含义错误与表达润色,并在隐私合规前提下,结合术语表与人工复核构建可靠工作流。
选学术文献AI翻译,先比较关键结论是否保真,再比较中文是否顺畅。没有同一学科、同一语种和人工判定标准,就不能把某个“准确率”当作跨论文通用排名。读摘要筛选文献,与据此复现实验,需要的可靠程度也不同。
译文读起来顺,为什么仍会误导判断
学术翻译最容易隐藏的错误,是限定条件被改写了。例如下面是用于说明的自拟句子,并非某篇论文原文:
“The treatment was associated with improvement, but causality was not established.”
译成“该治疗改善了结果”就丢掉了相关性与因果性的区别。更完整的表达应是“该治疗与改善存在关联,但尚未确立因果关系”。文字更短不等于信息更准。
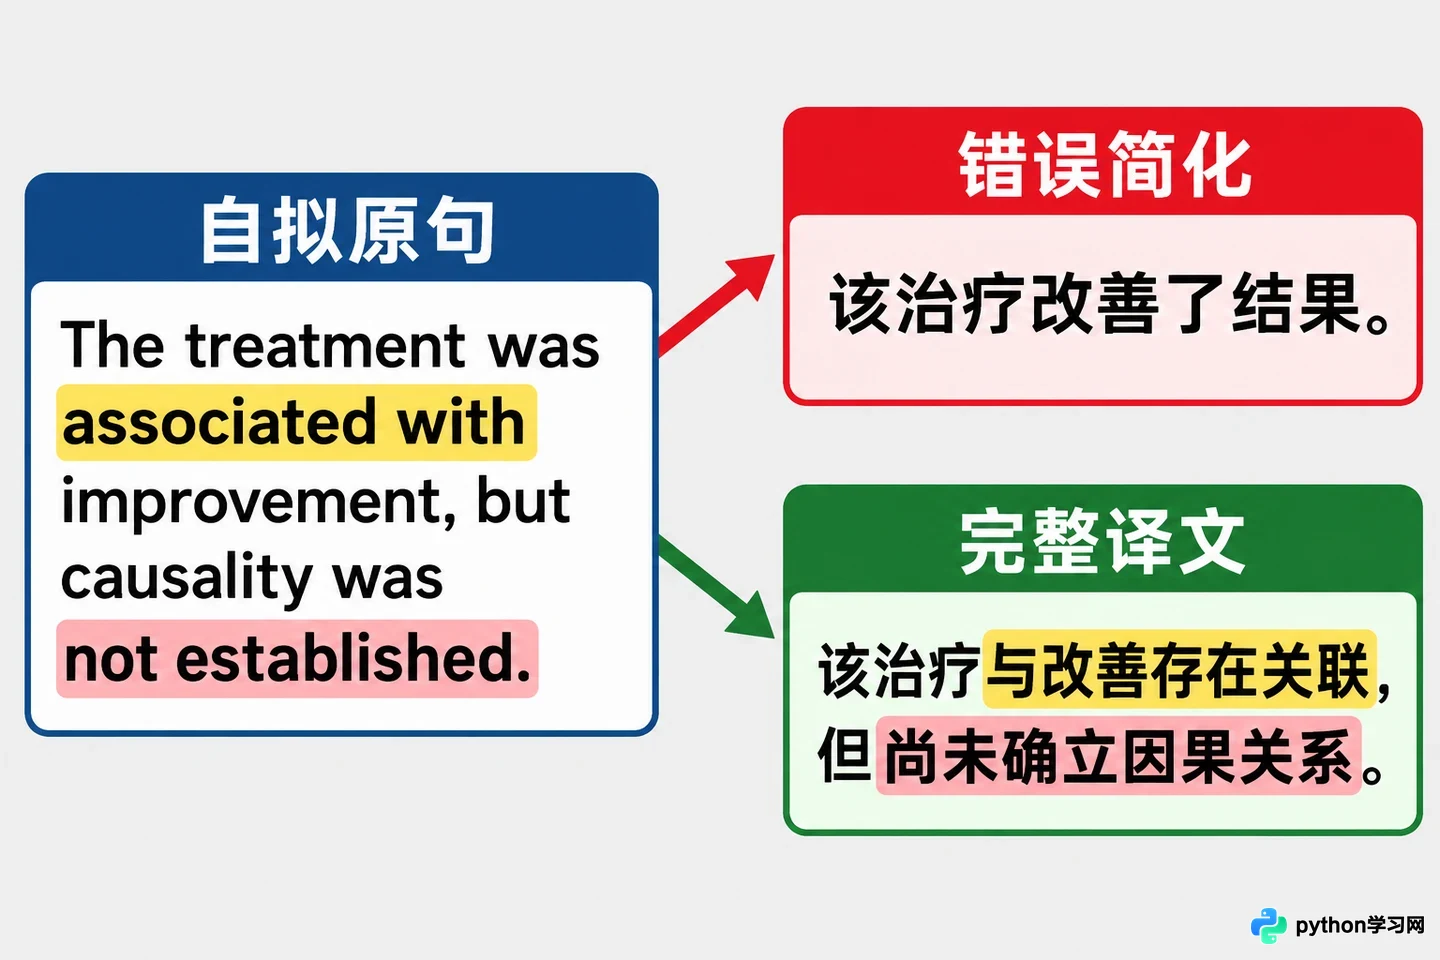
左侧展示包含“associated with”和“not established”的英文原句,右侧展示错误简化译文与准确完整译文的对比,突出相关性而非因果性的逻辑差异。
比较工具时,至少检查术语、否定、数量、条件和论证强度。may、suggest、not significant 之类表达影响作者到底做出了多强的判断。把“可能”改成“证明”,后续文献综述就可能高估证据。
文件处理也会引入另一层错误。双栏PDF的复制顺序、跨页断句和上下标识别可能已经破坏输入。此时更换翻译模型未必奏效。先把一个段落复制出来,对照原页面检查阅读顺序;遇到扫描件,再检查文字识别结果。公式、单位和图表编号应保留原文核对,不能靠译文的自然程度推断正确。
比较工具,要把文本翻译和整篇阅读分开
DeepL提供文件翻译及在支持条件下应用术语表的功能,适合把术语统一纳入工作流程。Google Cloud Translation也提供文档翻译,但它是云服务接口体系,不能把其文档处理能力直接当作普通Google翻译网页的能力。两者是否适合自己的论文,仍需用目标学科片段验证,不能从功能说明推导出准确率冠军。
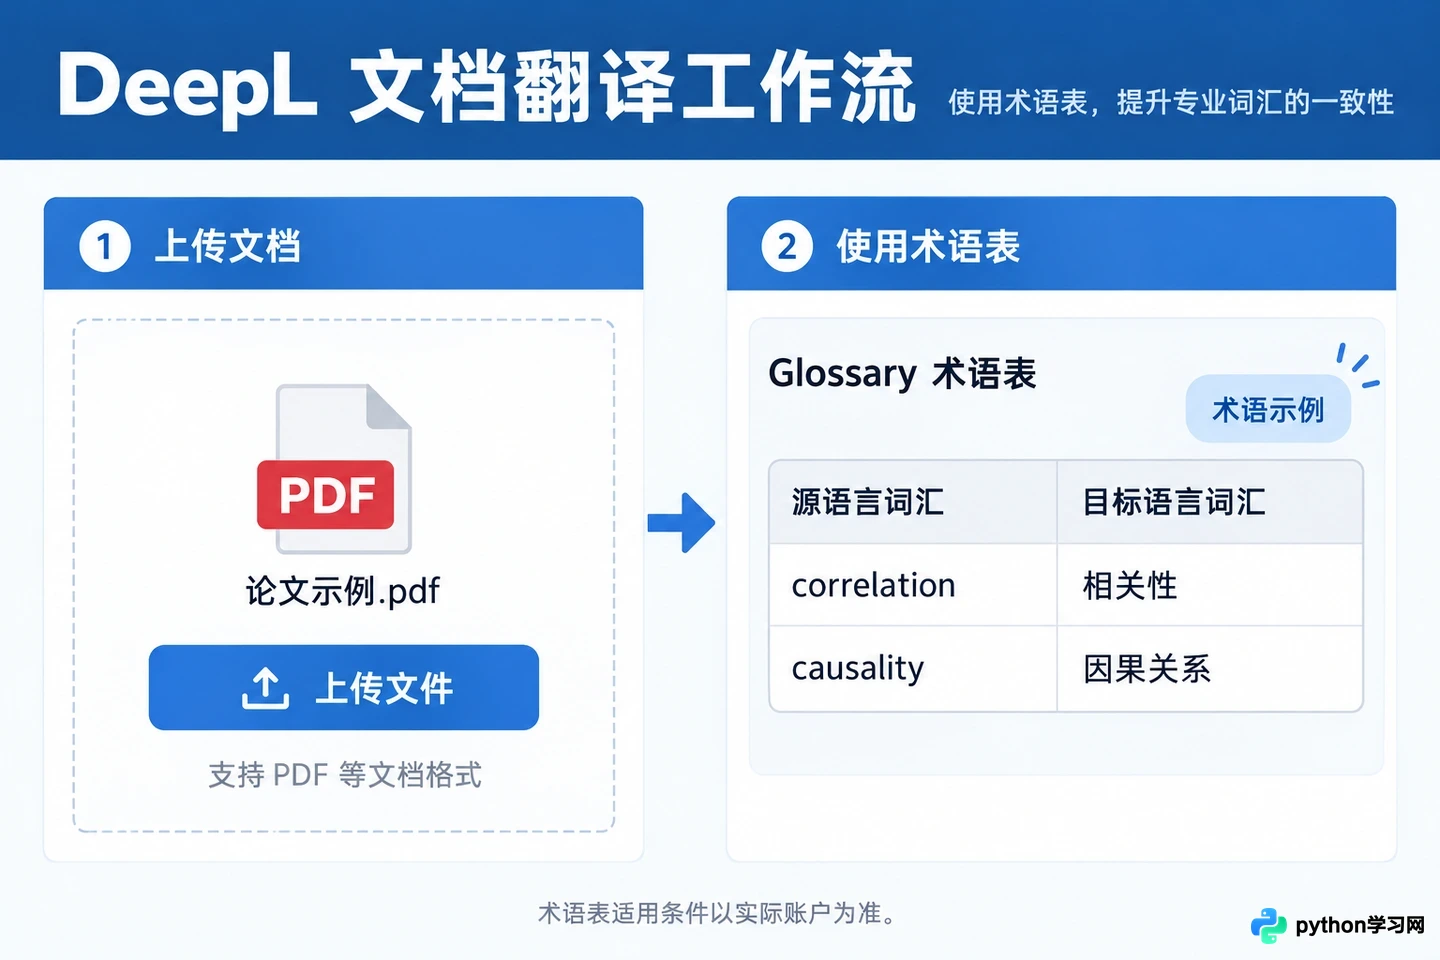
展示DeepL文档翻译功能界面,突出上传PDF区域及术语表设置选项,体现专业工作流整合能力。
通用对话式AI则适合补充语境:给出研究领域、缩写表和前后段落,要求逐句对应翻译。它也可能顺手解释、补全甚至改写原文,因此应明确区分“忠实翻译”和“另外解释”。让工具写得像中文综述,通常不适合作为逐句核对的第一步。
整篇阅读还要考察译文与原文能否方便对应。若只能得到一段流畅摘要,即使摘要大体正确,也不能替代方法、结果和补充材料的翻译。保留双语对照、能够定位到具体段落,往往比一次输出更多字更有用。文件大小、可用语种、术语表资格和隐私条款应以实际账户及官方说明为准,不把某个套餐限制写成永久结论。
用自己的小样本决定,而不是套用总榜单
选三到五段有代表性的材料即可开始:一段摘要、一段方法、一段结果,另加领域术语密集或句法复杂的段落。所有候选工具使用同一版本原文和相同术语要求,先独立翻译,再由熟悉领域的人对照评判。这个小样本只能帮助个人选型,不是产品总体性能评测。
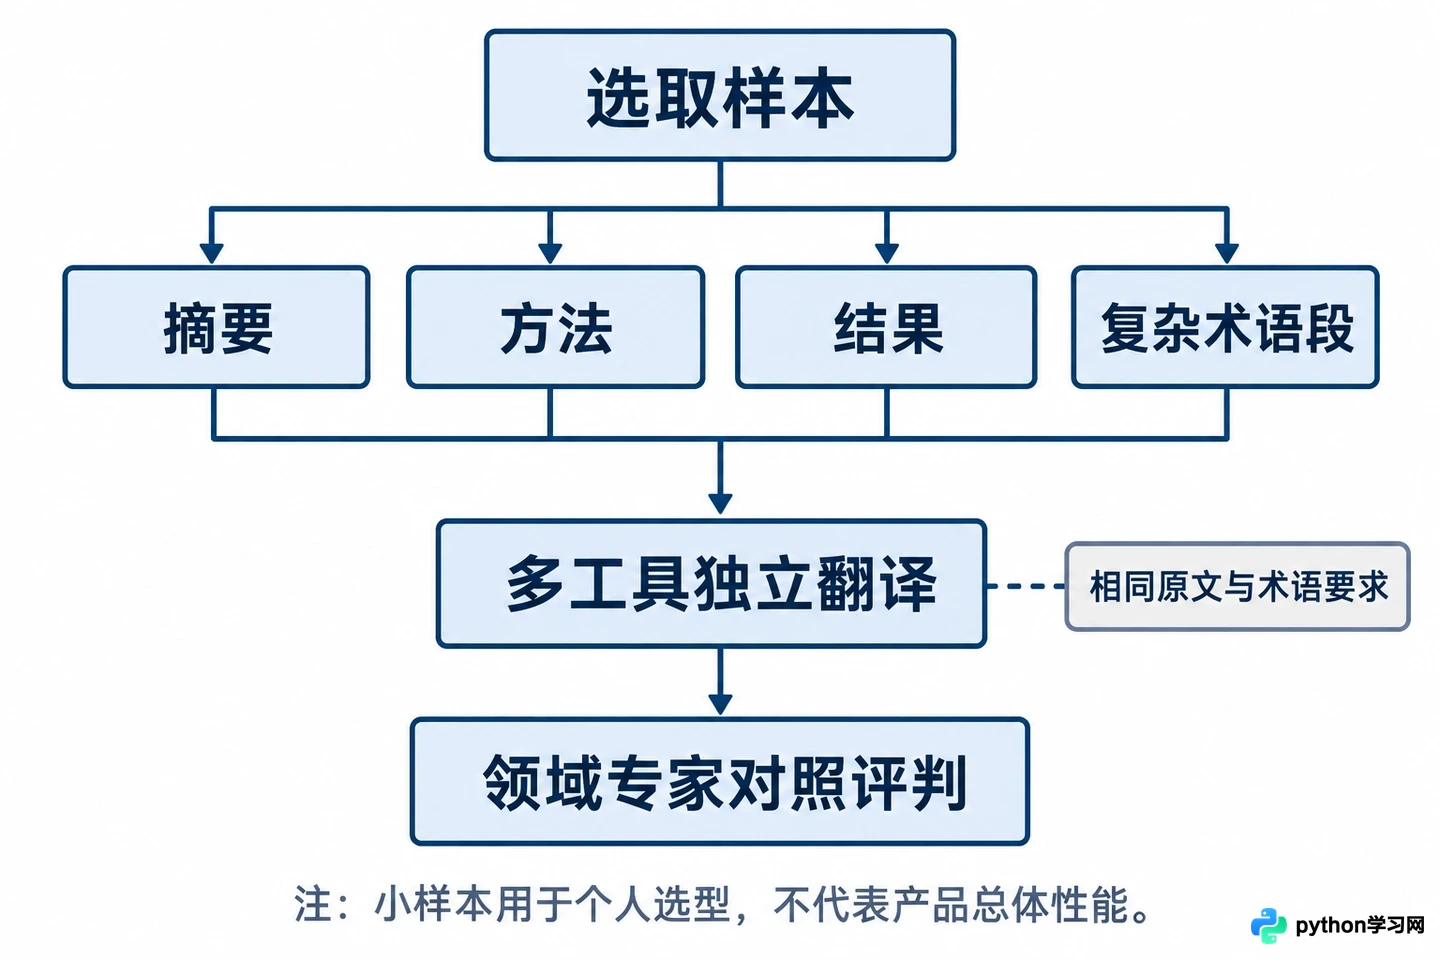
展示从选取代表性段落到独立翻译、人工对照评判的选型测试流程。
记录错误时,把“改变研究含义”与“中文不够自然”分开。前者包括漏掉否定、混淆实验组、改错数值、把相关写成因果;后者可以在含义确认后润色。若一定要计算比例,必须先固定判定单位,例如按句统计是否存在关键含义错误,并同时报告样本数。不同单位算出的百分比不能直接比较。
术语不统一时,先建立本篇词表,列出英文、采用的中文和上下文含义,再复查全文;长句关系错误时,带上前后文重新核对该句;输入文字已经错乱时,先修复提取结果。每一步都针对错误来源,避免整篇反复翻译后失去对照依据。
对于未公开手稿、受保密约束的数据或合作材料,先确认上传权限及服务的数据处理约定。用于正式引用、关键实验设计或高风险结论时,保留原文并进行人工专业复核。AI译文可以降低阅读门槛,最终判断仍应能够逐句回到原文。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















