


解决Python通配符匹配的大小写敏感问题
深入剖析Python通配符匹配在Windows与Linux/macOS下大小写敏感性分歧的底层机制,提供基于fnmatchcase、正则表达式转换与pathlib的高性能跨平台统一解决方案。
在 Python 中使用通配符(如 *.csv、data_??.log)匹配字符串或文件时,最直接的工具是标准库中的 fnmatch 和 glob 模块。许多开发者会发现同一段代码在 Windows 上运行正常,一旦部署到 Linux 服务器或 macOS 上,原本能匹配到的文件却离奇失效。解决这一问题的根本途径在于明确匹配载体并切断对系统规范化函数的隐式依赖:对于内存字符串匹配,使用 str.casefold() 统一大小写后传入 fnmatch.fnmatchcase(),或通过 fnmatch.translate() 结合正则标志 re.IGNORECASE 进行预编译;对于磁盘文件检索,直接利用 Python 3.12+ 的 pathlib.Path.glob(pattern, case_sensitive=False),或在低版本中通过目录枚举配合显式过滤器实现行为一致性。
一、大小写敏感问题从何而来:底层机制剖析
很多初学者以为通配符匹配规则属于 Python 语言层面的语法规范,但标准库中的 fnmatch.fnmatch(name, pat) 实际上是一个“平台相关(Platform-dependent)”的函数。其源码实现极为精简:
# Python 标准库 fnmatch.py 核心源码片段
def fnmatch(name, pat):
    name = os.path.normcase(name)
    pat = os.path.normcase(pat)
return fnmatchcase(name, pat)从代码中可以看出,fnmatch() 会在执行匹配前先将目标名称和通配符表达式传入 os.path.normcase()。这个函数的作用是“根据操作系统的文件名大小写规范进行归一化”:
- Windows 平台(ntpath 模块):Windows 文件系统通常不区分大小写,因此
ntpath.normcase()会将所有英文字符强制转换为小写,并将正斜杠/转为反斜杠\。在此环境下,fnmatch('Test.TXT', '*.txt')两端都被转换为小写,最终比较结果为True。 - Linux 与 POSIX 平台(posixpath 模块):Linux 文件系统区分大小写,因此
posixpath.normcase()是一个不做任何修改的直通操作(No-op)。fnmatch('Test.TXT', '*.txt')保持原样送入比较,结果为False。 - macOS 平台的特殊性:macOS 默认的文件系统(APFS 或 HFS+)大多不区分大小写,但 macOS 在底层属于 POSIX 系统,其 Python 使用的是
posixpath模块。这意味着在 macOS 上os.path.normcase()同样不转小写,导致fnmatch()默认区分大小写,与 Windows 的表现截然不同。
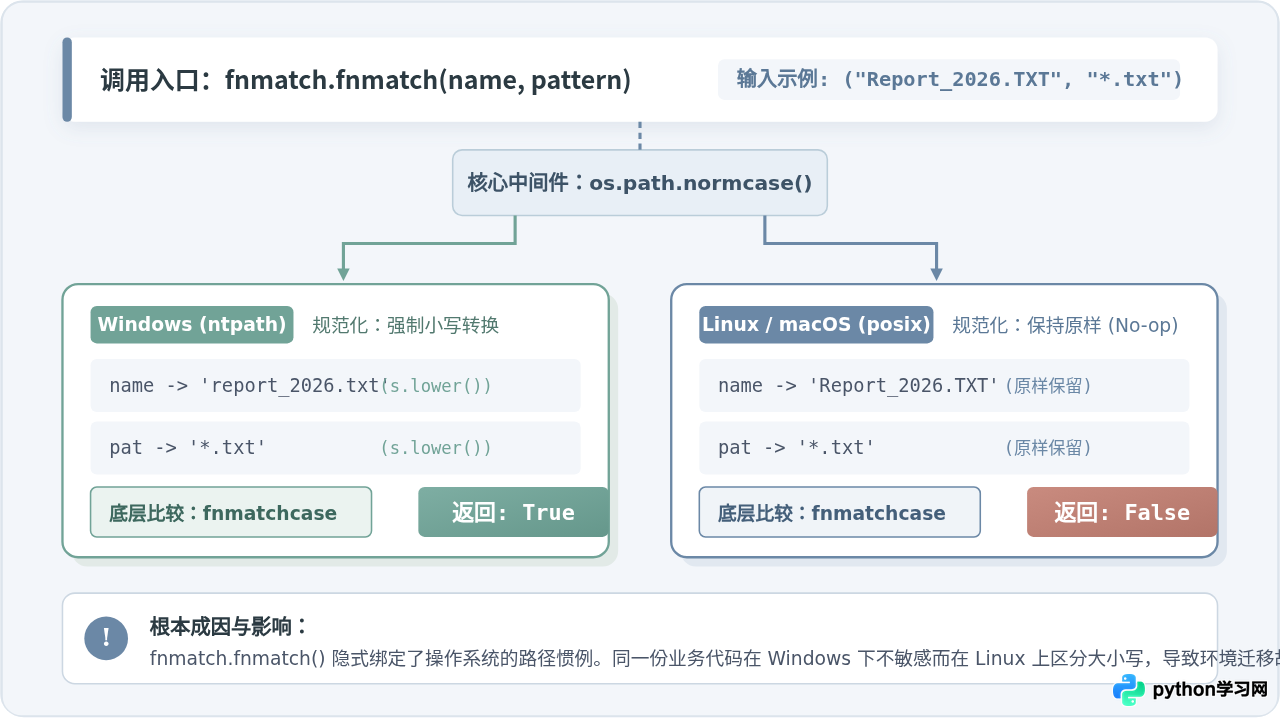
标准库虽然同时提供了 fnmatch.fnmatchcase(),但该函数只做严格区分大小写的字面匹配。当业务需求需要“在任何操作系统下都必须忽略大小写”时,标准库并没有现成的单一函数可直接调用,这就需要开发者采用针对性的工程方案。
二、方案决策与解决流程
在着手编写代码前,必须先理清当前的运行场景。通配符匹配分为两大类:一类是在内存中对纯字符串列表、字典键或配置名称进行模式匹配;另一类是在物理磁盘中枚举并筛选文件。根据匹配目标与性能要求的不同,选型路径如下所示:
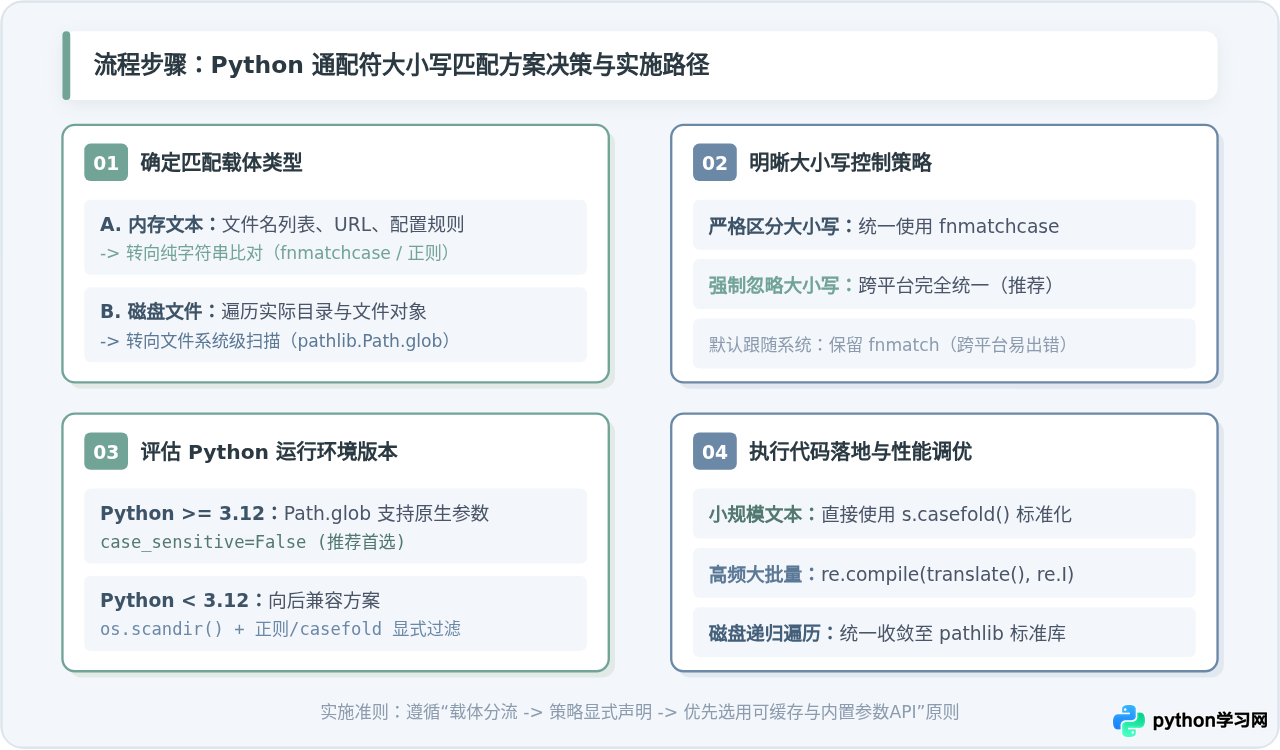
整个处理流程遵循四个明确步骤:第一步确定数据源究竟是内存字符串还是磁盘文件;第二步在业务层面显式声明大小写敏感策略(是强制严格区分、强制跨平台忽略,还是动态配置);第三步根据生产环境的 Python 解释器版本选择对应接口;第四步完成代码封装与性能调优。
三、内存字符串的跨平台忽略大小写方案
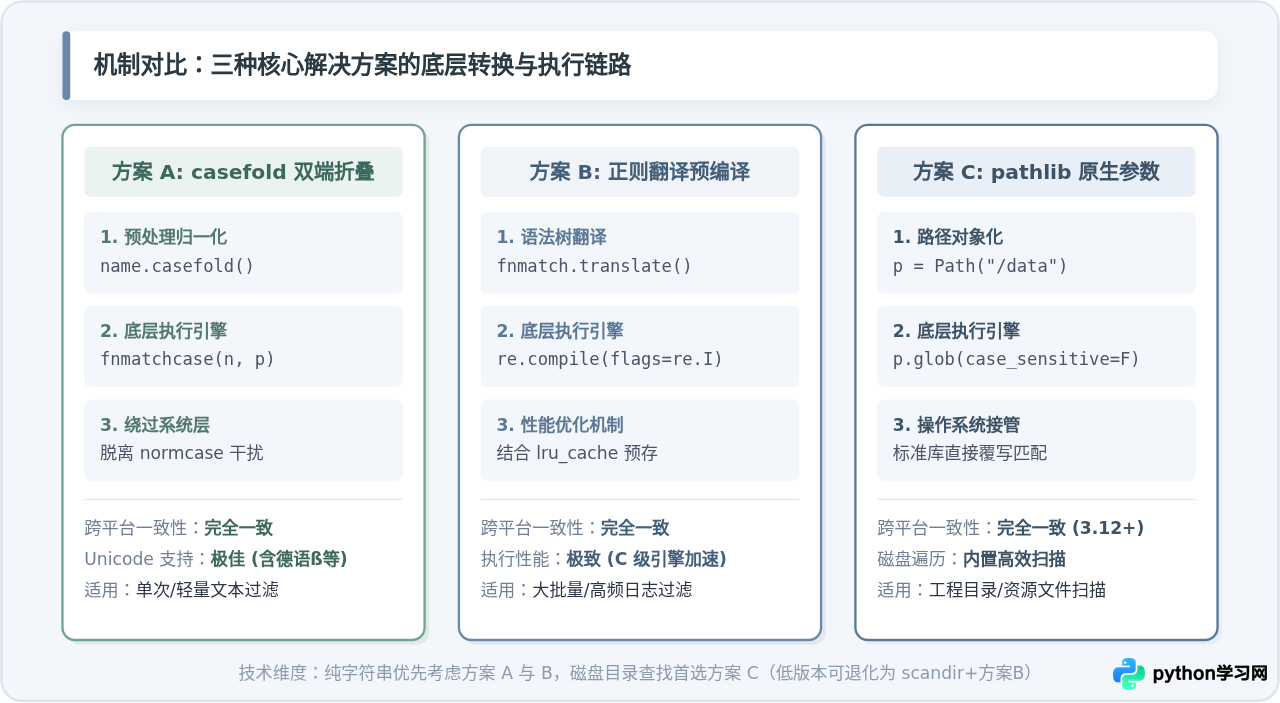
1. 方案一:casefold 归一化与 fnmatchcase 组合
对于单次或小批量的文件名列表筛选,最直接且安全的做法是:将待匹配字符串与通配符模式均进行大小写折叠,再交给平台无关且严格敏感的 fnmatch.fnmatchcase() 执行判定。
import fnmatch

def match_wildcard_nocase(name: str, pattern: str) -> bool:
    """跨平台绝对忽略大小写的通配符匹配函数。"""
    return fnmatch.fnmatchcase(name.casefold(), pattern.casefold())

# 跨平台测试示例(在 Windows、Linux、macOS 下表现 100% 一致)
file_list = ["Report_2026.TXT", "data_01.csv", "SCHEMA.JSON", "README.md"]
matched = [f for f in file_list if match_wildcard_nocase(f, "*.txt")]

# 输出结果:['Report_2026.TXT']
print("匹配结果:", matched)在处理纯 ASCII 字符时 lower() 和 casefold() 表现一致。但对于包含扩展 Unicode 字符的多语言环境(例如德语的小写字母 ß 折叠为 ss),casefold() 遵循 Unicode 标准进行全字符折叠,能够彻底避免因区域语言引起的匹配遗漏。
2. 方案二:正则翻译预编译法(适合大批量高频匹配)
如果需要在循环中处理成千上万个文件名,或者每秒有高并发请求需要过滤,每次调用 casefold() 和 fnmatchcase() 会涉及重复的模式解析。此时可以利用 fnmatch.translate() 将通配符模式转换为标准正则表达式,利用 Python 底层 C 实现的 re 引擎并注入 re.IGNORECASE 标志。
import re
import fnmatch
from functools import lru_cache

@lru_cache(maxsize=512)
def get_wildcard_regex(pattern: str, case_sensitive: bool = False) -> re.Pattern:
    """将通配符模式编译为带有大小写控制的正则对象,并加入 LRU 缓存。"""
    regex_str = fnmatch.translate(pattern)
    flags = 0 if case_sensitive else re.IGNORECASE
    return re.compile(regex_str, flags)

def match_wildcard_fast(name: str, pattern: str, case_sensitive: bool = False) -> bool:
    """利用编译后的正则对象执行快速匹配。"""
    compiled_re = get_wildcard_regex(pattern, case_sensitive)
    return bool(compiled_re.match(name))

# 批量过滤示例
items = ["order_101.json", "ORDER_102.JSON", "order_103.xml"]
json_matcher = get_wildcard_regex("order_*.json", case_sensitive=False)
result = [item for item in items if json_matcher.match(item)]

# 输出结果:['order_101.json', 'ORDER_102.JSON']
print("高性能过滤输出:", result)
fnmatch.translate() 会将例如 *.json 正确转换为类似 (?s:.*\.json)\Z 的精确正则表达式。通过 @lru_cache 装饰器,重复传入相同模式时可直接复用内存中的字节码对象,将匹配开销降低数倍。
四、文件系统磁盘扫描的大小写兼容方案
在以往的 Python 版本中,使用 glob.glob('*.jpg') 或 pathlib.Path('.').glob('*.jpg') 同样受制于宿主文件系统:在 Linux 的 EXT4/XFS 上无法匹配大写扩展名,而在 Windows 上却能匹配。针对文件系统级的查找需求,解决方案依 Python 版本而定。
1. Python 3.12+ 官方推荐:原生 case_sensitive 参数
自 Python 3.12 起,面向对象的 pathlib.Path.glob() 和 Path.rglob() 正式加入了 case_sensitive 关键字参数,允许开发者显式指定是否区分大小写:
from pathlib import Path

# 针对当前目录进行非敏感扫描(需要 Python 3.12+)
data_dir = Path("./workspace_files")

# 强制不区分大小写,能够同时匹配 report.pdf、Report.PDF、data.Pdf
pdf_files = list(data_dir.glob("*.pdf", case_sensitive=False))

# 递归子目录搜索同样支持
all_csvs = list(data_dir.rglob("data_*.csv", case_sensitive=False))
将 case_sensitive 设为 False 后,pathlib 会在目录遍历阶段自行对读取到的目录项名称进行大小写折叠对比,不再依赖宿主操作系统的底层比对规则,真正实现了跨平台行为统一。
2. Python 3.11 及更早版本的向下兼容方案
如果项目需要运行在旧版本 Python 运行时中,直接给 glob() 传递该参数会抛出 TypeError: glob() got an unexpected keyword argument 'case_sensitive'。此时可以通过 os.scandir() 手动枚举并结合前面封装的正则匹配器:
import os
from pathlib import Path
from typing import List

def scan_files_nocase(root_dir: str, pattern: str, recursive: bool = False) -> List[Path]:
    """兼容旧版 Python 的跨平台非敏感文件扫描器。"""
    matcher = get_wildcard_regex(pattern, case_sensitive=False)
    matched_paths = []

    if recursive:
        for current_root, _, filenames in os.walk(root_dir):
            for name in filenames:
                if matcher.match(name):
                    matched_paths.append(Path(current_root) / name)
    else:
        with os.scandir(root_dir) as entries:
            for entry in entries:
                if entry.is_file() and matcher.match(entry.name):
                    matched_paths.append(Path(entry.path))

    return matched_paths
该实现使用 os.scandir() 代替旧式的 os.listdir(),在获取文件属性时避免了额外的 stat 系统调用,保证了在大型目录树下的检索速度。
五、容易混淆的边界陷阱与工程排错
在解决大小写敏感问题的过程中,有三个容易被忽略的细节陷阱:
1. 字符范围通配符 [a-z] 与大小写折叠的冲突
通配符语法中支持 [a-z] 或 [A-Z] 的字符范围匹配。如果采用 casefold() 双端转换法:
pattern = "log_[A-Z].txt"
# 错误的做法:
fnmatch.fnmatchcase("log_b.txt".casefold(), pattern.casefold())
# 此时 pattern.casefold() 变成了 "log_[a-z].txt"(在多数情况下),
# 但如果是 "[A-Z]" 且原意是严格要求必须是原文本的大写,大小写转换会改变规则意图。
如果模式表达式中明确包含了针对大小写字母区间的限定范围,不应使用简单的大小写折叠,而应使用方案二的 fnmatch.translate() 配合原始模式,并根据实际逻辑决定是否开启 re.IGNORECASE。
2. CI/CD 流水线与开发机的环境不对等
常见的故障模式是:开发工程师在 Windows 或 macOS 办公机上编写脚本,通配符匹配测试全部通过;推送到基于 Ubuntu 或 Alpine Linux 的 Docker 容器构建机后,构建流程报错“找不到文件”。
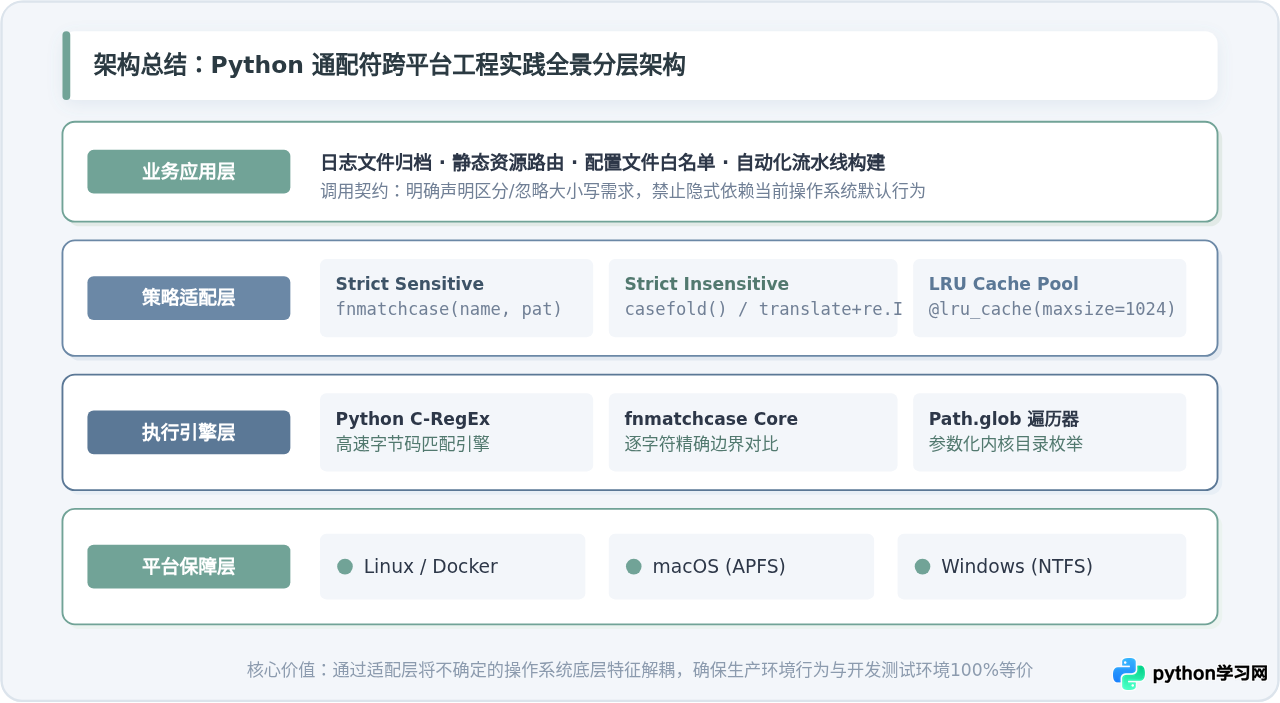
防范此类故障的有效办法是在代码库的工具库中彻底禁用裸调 fnmatch.fnmatch(),统一封装适配器,并在 CI 自动化测试中加入不同大小写组合的单元测试(如 test.CSV、test.csv、TEST.csv)。
六、不同方案综合选型对照表
为了在实际工程中快速确定最佳方案,下表总结了各 API 在大小写控制、跨平台一致性及性能维度的差异:
| 接口方法 | 大小写行为 | 跨平台一致性 | 适用版本 | 建议使用场景 |
|---|---|---|---|---|
fnmatch.fnmatch |
跟随操作系统(Win忽略,Linux区分) | 差(随系统变化) | 所有版本 | 仅用于模仿宿主系统默认行为 |
fnmatch.fnmatchcase |
严格区分大小写 | 完全一致 | 所有版本 | 明确需要严格区分大小写的内存匹配 |
casefold() + fnmatchcase |
强制忽略大小写 | 完全一致 | 所有版本 | 轻量、单次或少量的内存字符串判断 |
translate() + re.compile(re.I) |
显式受控(可通过标志位开关) | 完全一致 | 所有版本 | 高并发、大批量数据过滤、配置规则引擎 |
Path.glob(..., case_sensitive=False) |
显式受控(强制忽略大小写) | 完全一致 | Python >= 3.12 | 现代 Python 磁盘目录文件检索(首选) |
scandir() + 正则过滤 |
显式受控 | 完全一致 | Python < 3.12 | 旧版本 Python 磁盘文件跨平台检索兼容 |
七、总结
Python 中通配符匹配大小写问题的根源,是标准库为兼容各操作系统历史习惯而引入的 os.path.normcase() 规范化机制。要写出可靠的跨平台代码,关键在于杜绝无意识的隐式继承。
在涉及内存文本匹配时,简单的场景采用 str.casefold() 消除差异后调用 fnmatch.fnmatchcase();高性能场景采用 fnmatch.translate() 结合带有 re.IGNORECASE 标志的正则表达式对象;在涉及文件系统遍历时,优先使用 Python 3.12+ 的 pathlib.Path.glob(case_sensitive=False)。通过将大小写策略收敛为显式声明,即可彻底消除跨平台部署中的匹配隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















