


Python中通配符与正则表达式re的区别及选择

在Python开发中,当我们需要筛选文件、检查字符串是否符合某种规则或从文本中提取关键字段时,经常会遇到“通配符”与“正则表达式”这两种模式匹配机制。简单来说:通配符(Wildcards,常用模块为 glob 和 fnmatch)专为文件系统路径和简单名称过滤设计,语法简单直观;正则表达式(Regular Expressions,模块为 re)则是通用的复杂文本处理工具,能够完成深度的文本搜索、格式校验与分组提取。理解两者的核心差异,有助于在实际编码中以最小的代码代价选择最契合的工具。
一、同名符号的不同语义:通配符与re的本质差异
许多初学者容易将通配符与正则表达式混淆,最主要的原因在于它们使用了相同的特殊字符(如 *、?、[]),但背后的匹配逻辑却完全不同。
在通配符规则中,星号 * 代表“任意长度的任意字符序列”,问号 ? 代表“恰好一个任意字符”;而在正则表达式中,* 与 ? 本身并不指代字符,而是修饰前导字符的量词——* 表示前导表达式出现零次或多次,? 表示前导表达式出现零次或一次。要在正则表达式中表达“任意字符”,必须显式写出点号 .,因此通配符中的 * 对应于正则中的 .*。
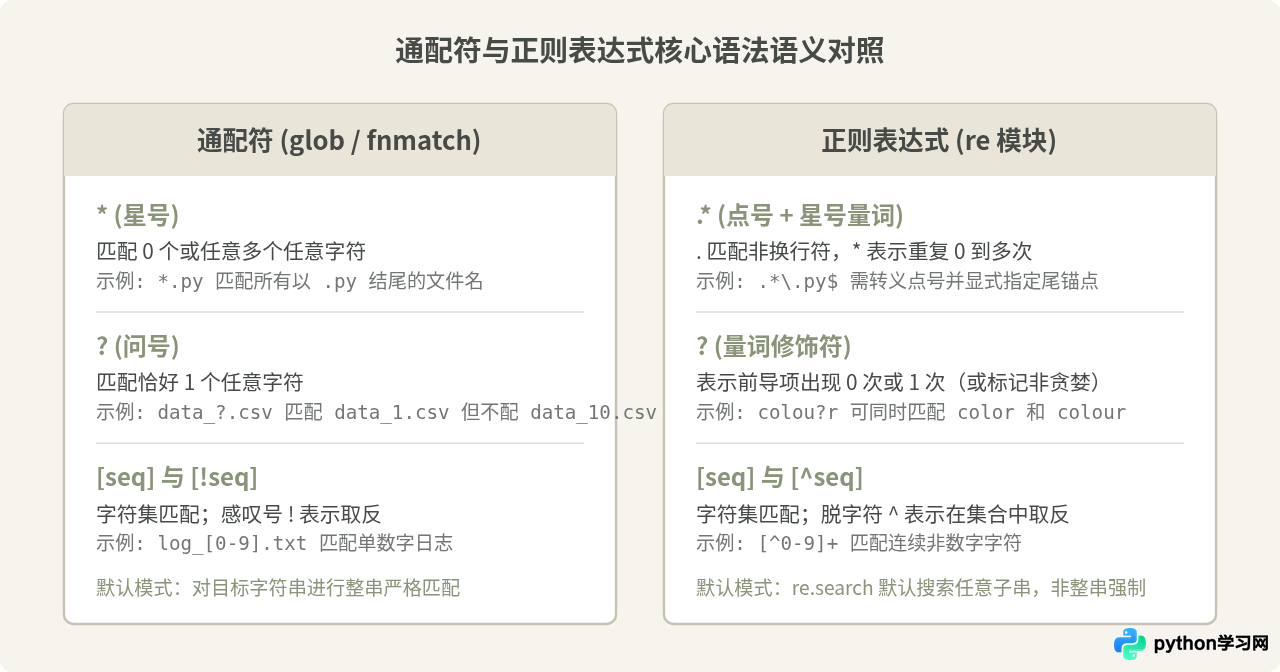
另一个容易被忽略的差异是点号(.)的处理。在通配符规则中,点号只是一个普通字符,例如 *.txt 中的点号就字面表示文件名里的点;但在正则表达式中,未转义的点号 . 会匹配任意除换行外的单字符,若要严格匹配文件后缀的点号,必须写成 \.。
二、底层实现剖析:Python中通配符与re的内在联系
有一种常见的认知误区认为:“通配符和正则表达式是两套完全独立且毫无交集的底层引擎”。在底层实现上,这种说法并不准确。
在Python标准库中,处理通配符匹配的核心模块是 fnmatch。当你调用 fnmatch.fnmatch('app.py', '*.py') 时,Python实际上并不是使用单独的有限状态机去比对字符串,而是通过内部的 fnmatch.translate() 函数,先将通配符模式翻译为等效的正则表达式,再调用 re 模块进行编译和匹配。
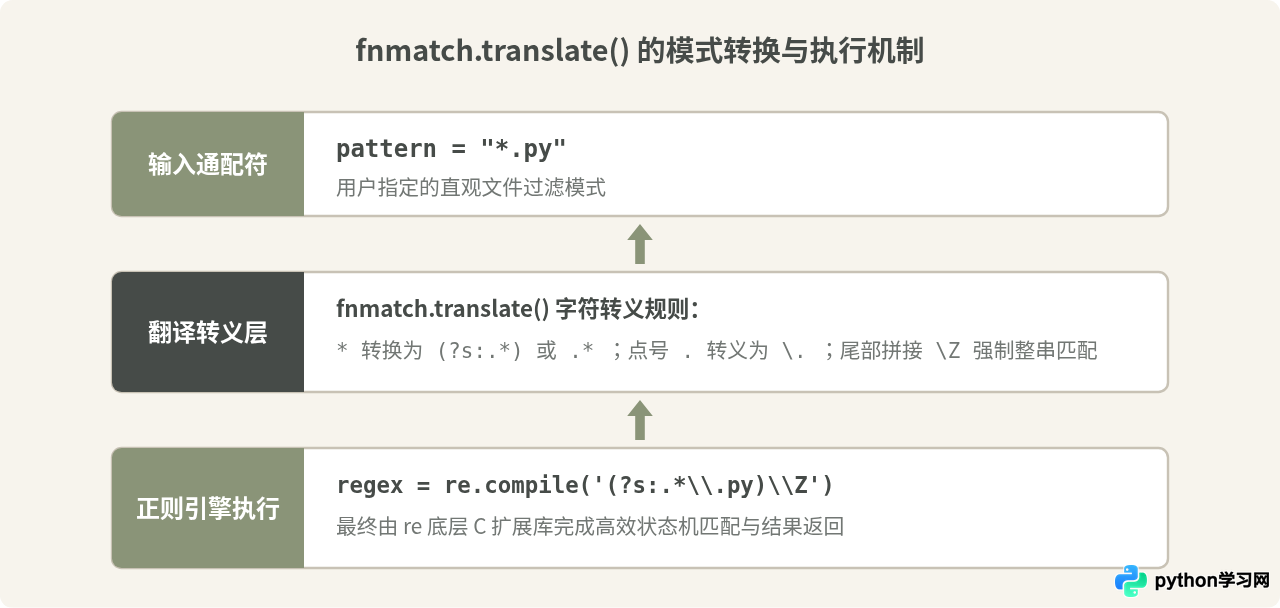
我们可以通过一段简短的代码直接观察这一翻译过程:
import fnmatch

wildcard_pattern = "*.py"
regex_pattern = fnmatch.translate(wildcard_pattern)

print("原始通配符:", wildcard_pattern)
print("转译后的正则:", regex_pattern)
# 在 Python 3.8+ 中,输出结果为:
# 转译后的正则: (?s:.*\.py)\Z由此可见:通配符在Python中可以看作是建立在正则表达式之上的一种“面向文件与简单名称匹配的高阶语法糖”。它隐藏了复杂的元字符转义与锚点逻辑,让开发者能够用极低的认知成本快速书写常见的文件查找规则。
三、选型指南:如何根据实际需求做出决策
在了解原理后,面对具体业务场景,我们应该如何选择?决策的核心依据在于两个维度:操作对象是什么以及匹配规则的复杂度如何。
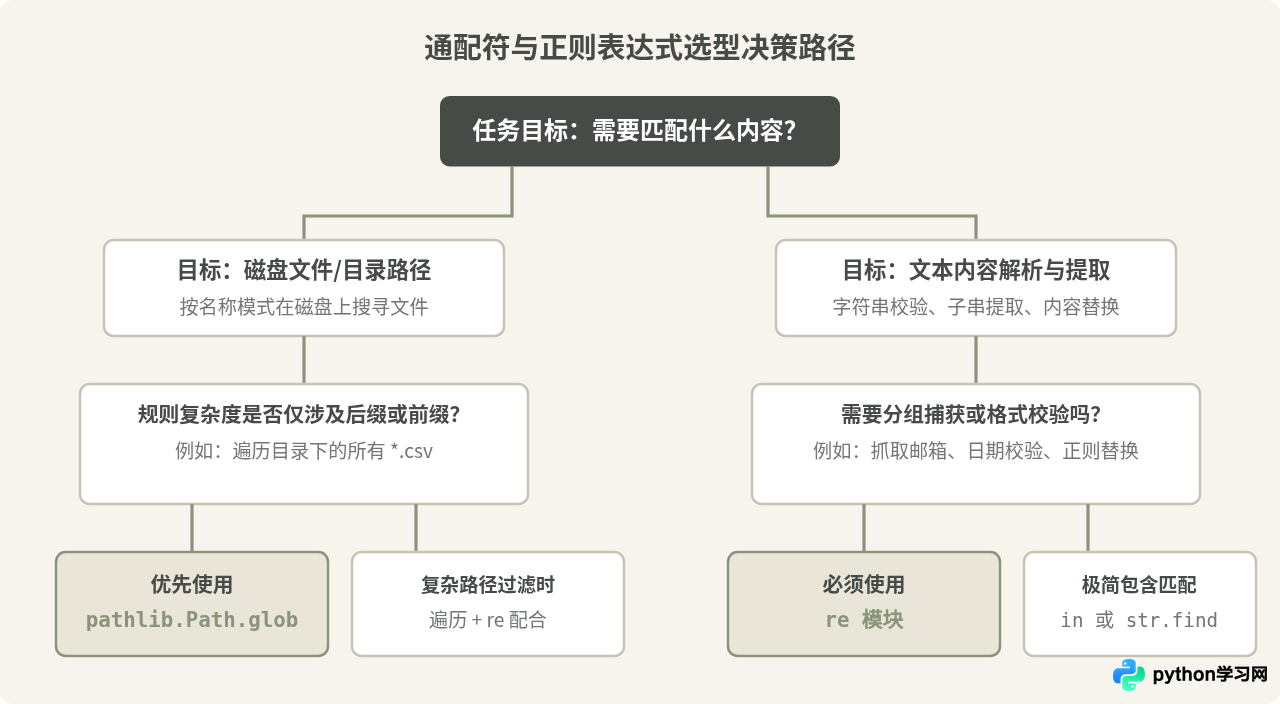
根据上述路径,我们可以建立清晰的选型原则:
- 首选通配符的场景:在本地目录中递归搜索特定扩展名的文件(如
pathlib.Path(".").rglob("*.json")),或者按简易命名规则批量处理日志。通配符代码可读性极高,无须担心转义符号带来的排版混乱。 - 必须使用正则表达式的场景:需要从非结构化文本中抽取手机号、邮箱、IP地址;需要断言(Lookahead/Lookbehind);需要捕获命名分组;需要复杂的模式替换(如将特定格式日期标准化)。
- 优先使用原生字符串方法的场景:如果只是判断字符串是否以某固定字符开头或结尾,直接使用
str.startswith()或str.endswith()性能最佳,无须动用glob或re。
四、典型代码实践对比
通过以下两个对比示例,可以直观感受到两类工具在不同场景下的代码表达与适用性。
场景1:查找并统计指定目录下的数据文件
对于文件系统操作,使用 pathlib 结合通配符语法最为简洁直观:
from pathlib import Path

# 使用通配符递归遍历当前目录下所有的 csv 文件
data_dir = Path("./reports")
csv_files = list(data_dir.rglob("2026_Q[1-4]_*.csv"))

print(f"找到符合条件的文件数量: {len(csv_files)}")
for file_path in csv_files:
    print(file_path.name)
场景2:从文件名或文本中精准提取业务信息
如果文件名中包含业务参数(如用户ID、时间戳、状态码),且需要将它们单独提取出来,通配符便无能为力,必须使用 re 模块的捕获组功能:
import re

filenames = [
    "export_user1024_20261020_success.log",
    "export_user2048_20261021_failed.log",
    "invalid_name.tmp"
]

# 定义提取规则:通过命名捕获组提取用户ID、日期与执行状态
pattern = re.compile(r"^export_user(?P<uid>\d+)_(?P<date>\d{8})_(?P<status>[a-z]+)\.log$")

for name in filenames:
    match = pattern.match(name)
    if match:
        data = match.groupdict()
        print(f"用户ID: {data['uid']}, 日期: {data['date']}, 状态: {data['status']}")
    else:
        print(f"跳过不匹配文件: {name}")
五、综合对照与总结
为了便于查阅与日常开发选型,下表及图4对两者的特性进行了全方位总结:
| 特性维度 | 通配符 (glob / fnmatch / Path.glob) | 正则表达式 (re 模块) |
|---|---|---|
| 核心定位 | 文件系统路径查找、简单文件名模式匹配 | 通用文本解析、模式搜索、校验与替换 |
| 常用模块 | glob, fnmatch, pathlib.Path |
re |
| 语法复杂度 | 极低(主要字符为 *, ?, []) |
高(支持分支、非贪婪、分组、断言等) |
| 匹配边界 | 默认对整串进行全量匹配 | search 匹配子串,match 匹配开头,可用 ^/$ 锚定 |
| 子串提取能力 | 不支持提取匹配片段(只能得到布尔结果) | 支持位置组 ( ) 与命名捕获组 (?P<name>...) |
| 性能开销 | 轻量,无复杂回溯风险 | 强大但需警惕复杂正则导致的灾难性回溯 |
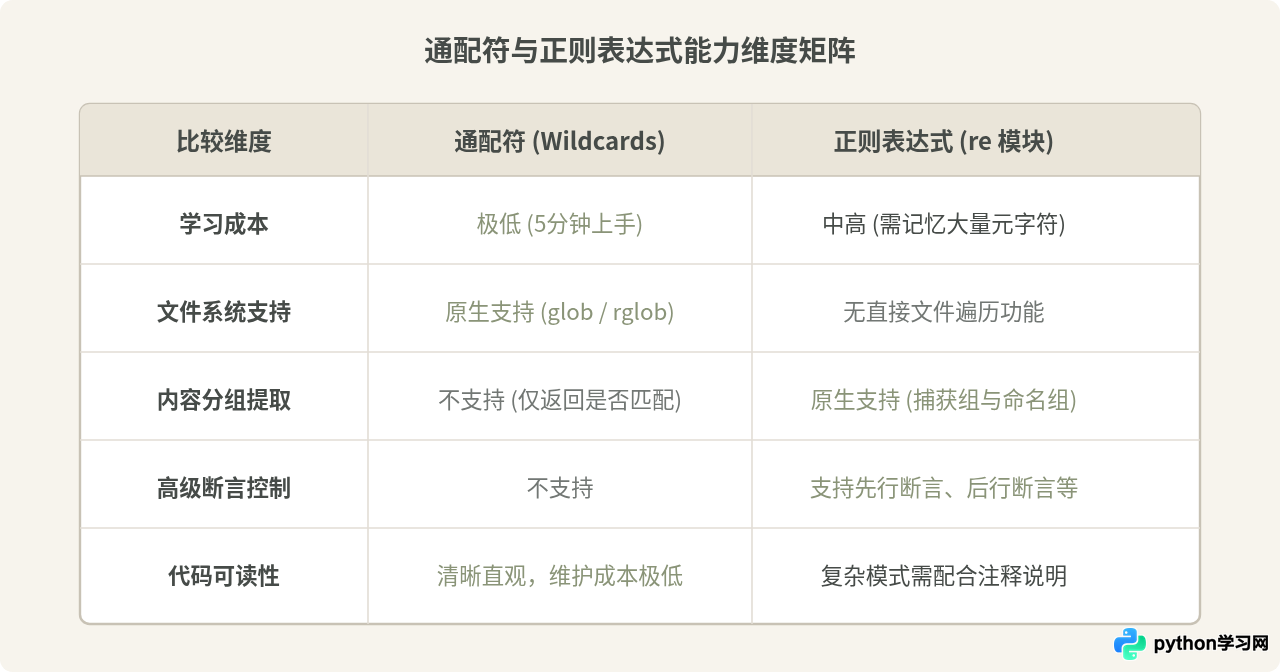
总结:开发时不要为了“展示技术”而在简单的文件查找中使用复杂的正则表达式,也不要试图用通配符去硬抗复杂的文本解析需求。文件搜寻交给 pathlib.Path.glob(),复杂字符串处理与字段抽取交给 re,这就是Python工程实践中最优雅、最高效的选择方案。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















