


Python列表与字典的常用操作方法及区别
深入解析Python列表(list)与字典(dict)的常用操作方法、底层存储原理、检索性能差异及适用场景选型建议,包含完整的代码示例与直观的SVG架构图示。
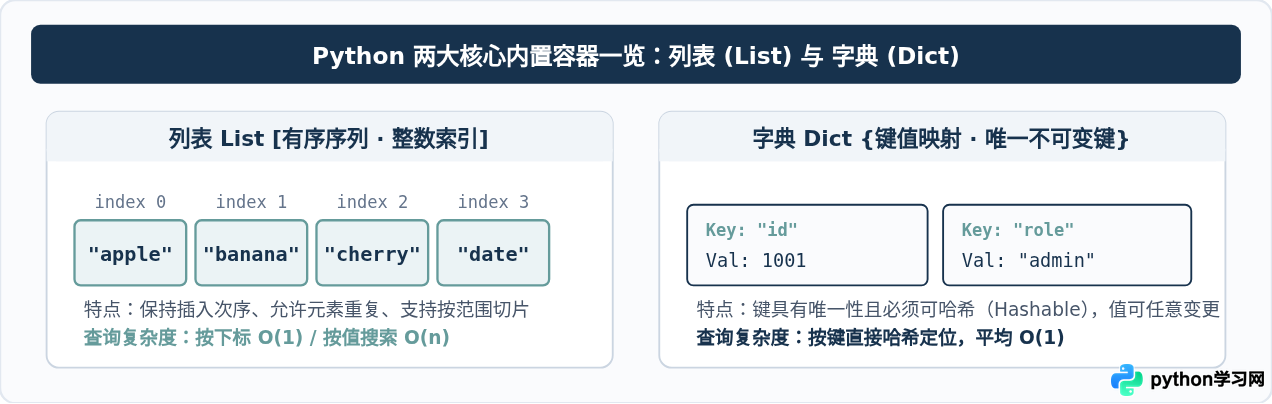
在 Python 编程中,列表(List)和字典(Dictionary)是最核心的两种内置复合数据容器。简单来说,列表是有序、通过连续整数下标索引的元素序列;字典则是基于键值对(Key-Value)存储、通过哈希表实现高速精准查找的映射集合。掌握它们各自的增删改查方法、时间复杂度以及底层机制,是写出健壮高效 Python 代码的基础。
一、存储结构与底层原理剖析
要深入掌握列表和字典的操作差异,首先必须理解它们在 CPython 解释器中的底层实现逻辑。两者的内存组织形式直接决定了各自在增、删、改、查等不同操作下的执行效率与内存开销。
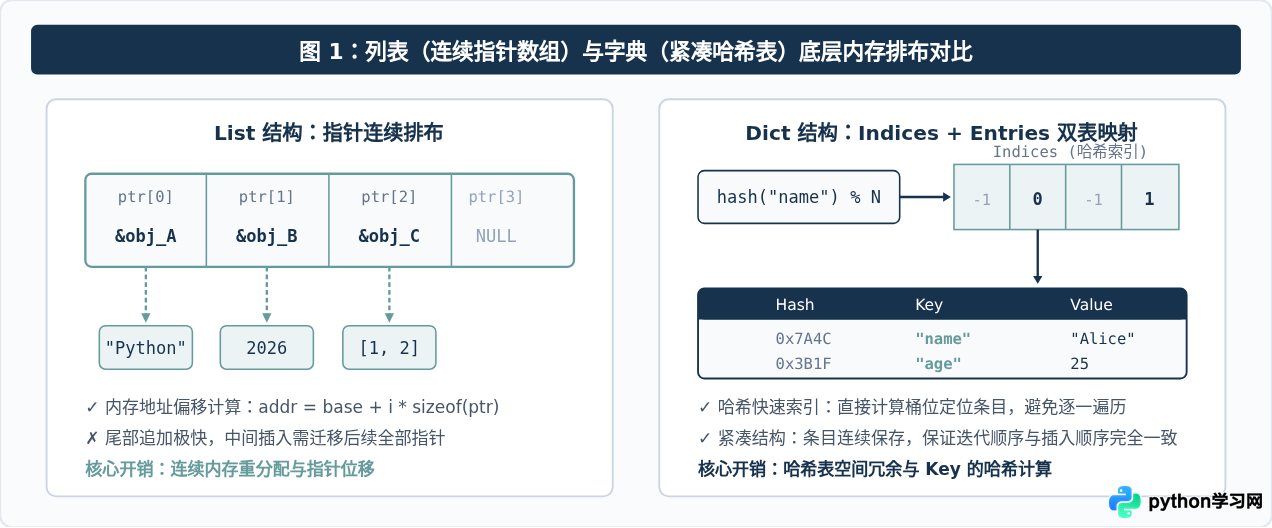
列表(List):连续指针数组。在底层实现中,Python 列表本质上是一个动态的指针数组(PyListObject)。列表中存放的并不是对象本身,而是指向各个对象的指针引用。由于这些指针在内存中是紧密相邻、按索引连续排布的,因此只要知道元素的下标 $i$,系统就能直接通过偏移公式计算出目标指针的内存地址,实现秒级的常数时间 $O(1)$ 下标随机访问。但这也带来一个代价:如果在列表的头部或中间插入/删除元素,其后方所有元素的指针都必须整体向前或向后挪动位置,带来 $O(n)$ 的移动成本。
字典(Dict):紧凑型哈希表(Hash Table)。自 Python 3.6 起,字典采用了紧凑哈希表实现(PyDictObject)。它由一个轻量级的稀疏哈希索引表(Indices Table)和一个按插入顺序紧密排列的条目表(Entries Table)组成。当用户存入一个键值对时,Python 首先调用内置的 hash() 函数计算 Key 的哈希码,再将哈希码映射到索引表中对应槽位,最后在条目表中记录实际的 Key、Value 及其哈希值。这种结构保证了即使字典中包含数百万个元素,按键查询依然能在常数时间 $O(1)$ 内直接完成定位。
二、常用操作方法与代码实战
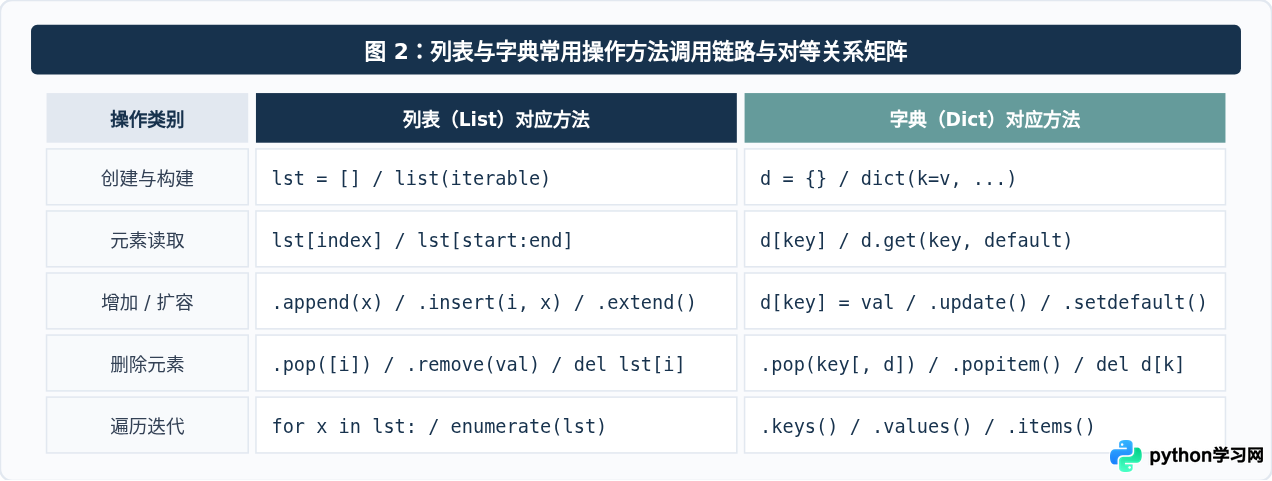
为了让读者在实际编写代码时能够快速选择正确的方法,下文按照创建、访问、添加、修改、删除、遍历六个核心动作,分别对列表与字典的常见 API 进行详细讲解与代码对照。
1. 元素的创建与初始化
创建列表与字典最常用的是字面量语法([] 与 {}),也可以通过工厂函数或推导式生成:
# 列表的创建方式
numbers = [1, 2, 3, 4]
char_list = list("Python")              # ['P', 'y', 't', 'h', 'o', 'n']
evens = [x for x in range(10) if x % 2 == 0] # 列表推导式

# 字典的创建方式
user = {"name": "Alice", "age": 28, "role": "engineer"}
info = dict(city="Beijing", code=100000)
squares_map = {x: x**2 for x in range(4)} # 字典推导式 {0: 0, 1: 1, 2: 4, 3: 9}
2. 元素的读取与安全访问
在数据访问方面,两者的容错机制存在显著差别:
- 列表按索引访问:使用
lst[i]。支持负数索引(如-1表示最后一个元素)以及切片操作(如lst[1:3])。若索引超出len(lst) - 1,将抛出IndexError。 - 字典按键访问:使用
d[key]。若键不存在,会抛出KeyError。在生产代码中,更推荐使用d.get(key, default),当键不存在时返回默认值而不引发异常;若需要在键不存在时自动初始化并插入默认值,可使用d.setdefault(key, default)。
fruits = ["apple", "banana", "orange"]
print(fruits[0])      # 示例输出: 'apple'
print(fruits[-1])     # 示例输出: 'orange'
print(fruits[0:2])    # 示例输出: ['apple', 'banana'](切片产生新列表)

user_profile = {"id": 402, "status": "active"}
print(user_profile["id"])                  # 示例输出: 402
print(user_profile.get("email", "未提供"))  # 示例输出: '未提供'(安全访问,不抛异常)
3. 添加与修改元素
列表增加元素有三种核心途径:在末尾追加、在指定位置插入、批量扩容。而字典则通过键赋值、批量合并或预设机制完成:
lst.append(item):将元素添加到列表末尾,时间复杂度为摊销 $O(1)$。lst.insert(index, item):在指定索引前插入元素,后序所有元素需向后移位,时间复杂度为 $O(n)$。lst.extend(iterable)或lst += [item]:将另一可迭代对象中的全部元素追加至末尾。d[key] = value:当key存在时修改其对应的值,不存在时新增该键值对。d.update(other_dict):将另一个字典或键值对序列批量合并入当前字典,同名键将被覆盖。
# 列表添加示例
colors = ["red", "green"]
colors.append("blue")           # ['red', 'green', 'blue']
colors.insert(1, "yellow")      # ['red', 'yellow', 'green', 'blue']
colors.extend(["purple", "cyan"])# ['red', 'yellow', 'green', 'blue', 'purple', 'cyan']

# 字典添加与修改示例
server = {"ip": "192.168.1.1", "port": 80}
server["port"] = 8080           # 修改已有键的值
server["protocol"] = "https"   # 新增键值对
server.update({"timeout": 30, "retry": 3}) # 批量更新
4. 删除元素与清空
删除操作在列表中分为“按位置删”与“按内容删”,在字典中主要按键移除:
lst.pop([index]):移除并返回指定索引处的元素(缺省为最后一个,末尾弹出为 $O(1)$,中间或头部弹出为 $O(n)$)。lst.remove(value):从左至右扫描列表,移除首个与value相等的元素。若不存在则抛出ValueError。复杂度为 $O(n)$。del lst[i]/del lst[start:end]:按索引或切片销毁元素。d.pop(key[, default]):移除指定的key并返回其value。若键不存在且未指定默认值,抛出KeyError。d.popitem():按后进先出(LIFO)顺序弹出并返回字典最后一个键值对二元组(key, value)。lst.clear()/d.clear():清空容器内所有元素。
nums = [10, 20, 30, 20, 40]
val = nums.pop()       # 弹出末尾 40,nums 变为 [10, 20, 30, 20]
nums.remove(20)         # 移除首个 20,nums 变为 [10, 30, 20]

cache = {"token": "abc", "expire": 3600, "tag": "auth"}
tok = cache.pop("token")             # 移除并返回 'abc'
last_pair = cache.popitem()          # 移除并返回 ('tag', 'auth')
del cache["expire"]                  # 删除 'expire' 键
5. 遍历与迭代方法
列表遍历通常获取元素本身或带下标;字典遍历则可以灵活选取仅键、仅值或键值对:
items = ["A", "B", "C"]
for idx, val in enumerate(items):
    print(idx, val) # 示例输出: 0 A
 1 B
 2 C

stats = {"cpu": 45, "memory": 72, "disk": 58}
# 遍历键值对(最常用)
for k, v in stats.items():
    print(f"{k} => {v}%")

# 仅遍历键: for k in stats.keys(): 或直接 for k in stats:
# 仅遍历值: for v in stats.values():
三、检索机制与时间复杂度深度对比
日常开发中最常出现性能瓶颈的操作就是元素成员判断(item in container)。为什么在海量数据下,字典的 in 查询能做到纳秒级响应,而列表却可能导致程序严重卡顿?这源于两者的检索机制完全不同。
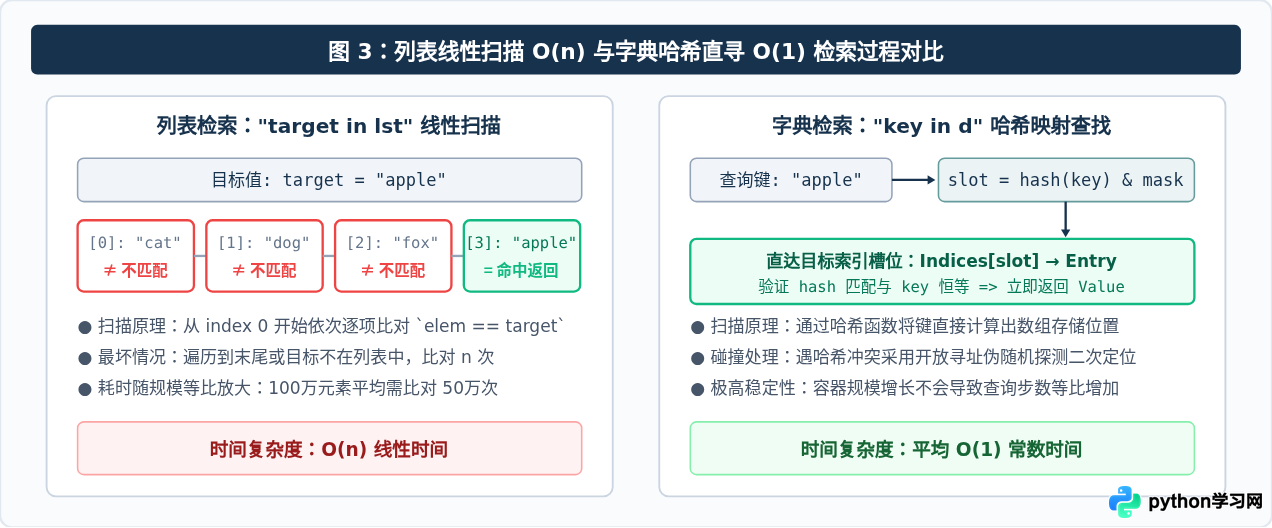
hash(key) 计算存储槽位,所以字典的键必须是可哈希(Hashable)且不可变(Immutable)的对象。例如整数、浮点数、字符串、元组(内含不可变对象)均可作为键;而列表(list)、集合(set)以及字典(dict)本身因为内容可变,无法计算固定哈希值,绝对不能作为字典的 Key,否则会直接引发 TypeError: unhashable type: 'list'。相对地,列表中的元素可以是任何类型,没有任何限制。
四、核心特性对比与选型维度表
为了直观掌握两者的本质差异,下表总结了列表与字典在底层结构、索引机制、修改约束及资源消耗上的关键指标:
| 对比维度 | 列表 List | 字典 Dict |
|---|---|---|
| 底层核心结构 | 连续指针数组(连续内存块) | 紧凑哈希表(Indices 数组 + Entries 数组) |
| 索引 / 定位方式 | 从 0 开始的非负连续整数索引,支持负向下标 | 自定义不可变键(Key),支持字符串、数字、元组等 |
| 键 / 元素限制 | 元素可为任何类型(支持嵌套、包含可变对象) | 键必须可哈希(不可变);值可为任何类型 |
| 元素唯一性 | 允许元素值重复出现 | 键(Key)严格全局唯一,后写入覆盖先写入;值允许重复 |
| 内部元素顺序 | 严格保证元素插入及排列顺序 | Python 3.7+ 语言规范正式保证维持元素插入顺序 |
| 按索引/键读取 | $O(1)$(通过基地址偏移直接计算指针) | $O(1)$(通过哈希码计算槽位定位) |
| 成员检索 (in) | $O(n)$(必须逐项比对,元素越多越慢) | 平均 $O(1)$(哈希计算,与容量几乎无关) |
| 中间位置插入 | $O(n)$(后续指针全部位移) | 字典无“中间插入”概念,新增键平均 $O(1)$ |
| 内存占用 | 内存利用率高,除预分配余量外结构紧凑 | 因维护哈希索引表及哈希碰撞稀疏槽,内存占用通常较高 |
五、场景化选型决策与实践建议
在面对具体业务需求时,究竟应该使用列表还是字典?可以通过以下决策树来清晰判断:
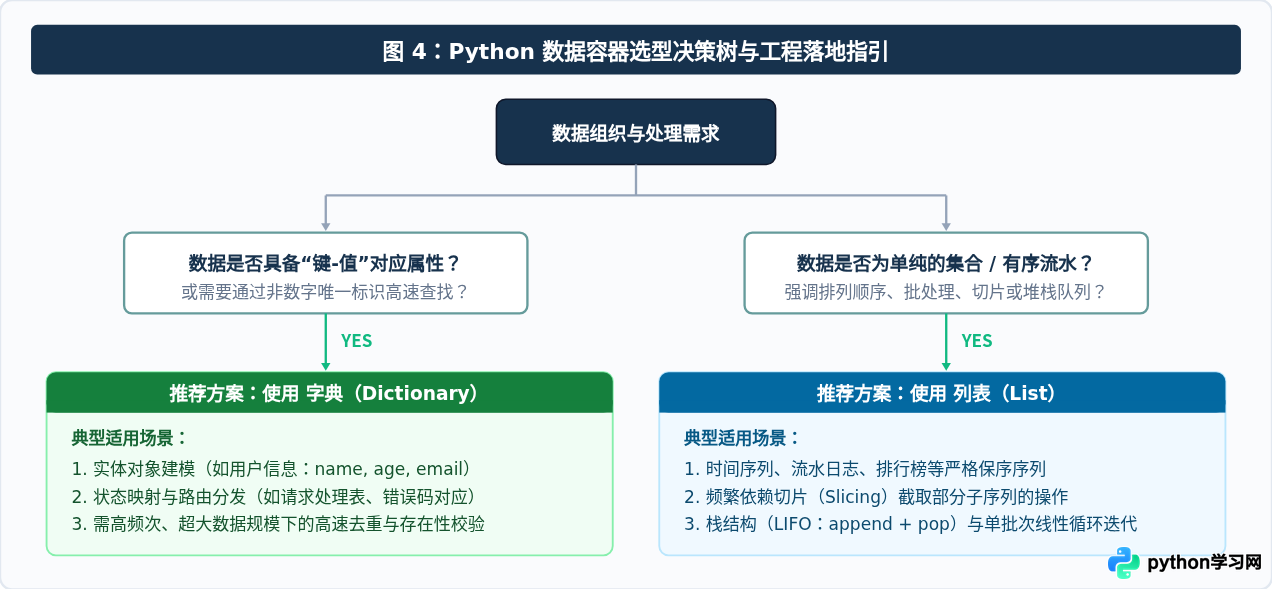
常见避坑要点:
- 切勿在循环遍历列表时直接
remove()或pop()元素:这会导致迭代器内部索引偏移错位,进而跳过后续某些元素的检查。如果需要过滤元素,应使用列表推导式[x for x in lst if condition]创建新列表。 - 避免对超大列表进行高频
in查找:若业务中需要对几万至几百万级别的数据频繁判断是否存在,务必将列表转换为set或dict,查询效率可从数秒瞬间降低至毫秒以下。 - 优先使用
dict.get()防御KeyError:直接使用d[key]容易在字典缺少键时导致程序崩溃。在无法 100% 确定键存在时,善用get(key, 默认值)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















