


适合Python新手的3个练手小项目:从猜数字到简单爬虫
专为Python初学者设计的3个阶梯式实战小项目:从控制台逻辑练习猜数字,到涉及数据持久化的待办事项清单,再到基于requests和BeautifulSoup的静态网页数据爬虫,逐步打通从语法到实际应用的工程路径。
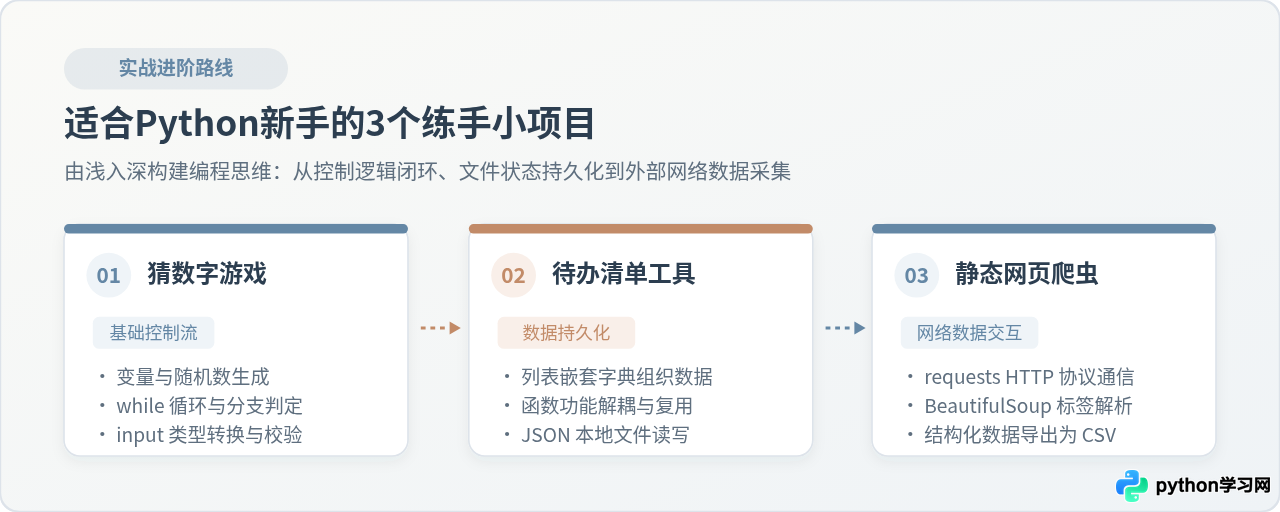
掌握了 Python 的变量赋值、条件分支、循环语句以及函数定义之后,初学者常会陷入“语法规则看得懂,但面对空白文件不知道能写什么”的停滞期。摆脱这种困境的直接做法,是通过完成具有清晰输入输出和实用价值的微型项目,将离散的语法拼接为完整的执行逻辑。本文挑选了 3 个难度层层递进的练习项目:首先是通过“猜数字游戏”掌握控制流与容错机制,接着通过“待办事项清单”理解复杂数据结构与本地文件持久化,最后通过“静态网页简单爬虫”学习第三方库调用与网络数据清洗导出。
一、练手项目的选择逻辑与能力递进
很多学习者在找练手项目时容易走向两个极端:要么停留在单行计算或打印九九乘法表等片段练习,无法体会软件的整体状态流转;要么过早挑战 Django 网站、图形界面或多线程复杂应用,因语法与框架双重受阻而丧失信心。
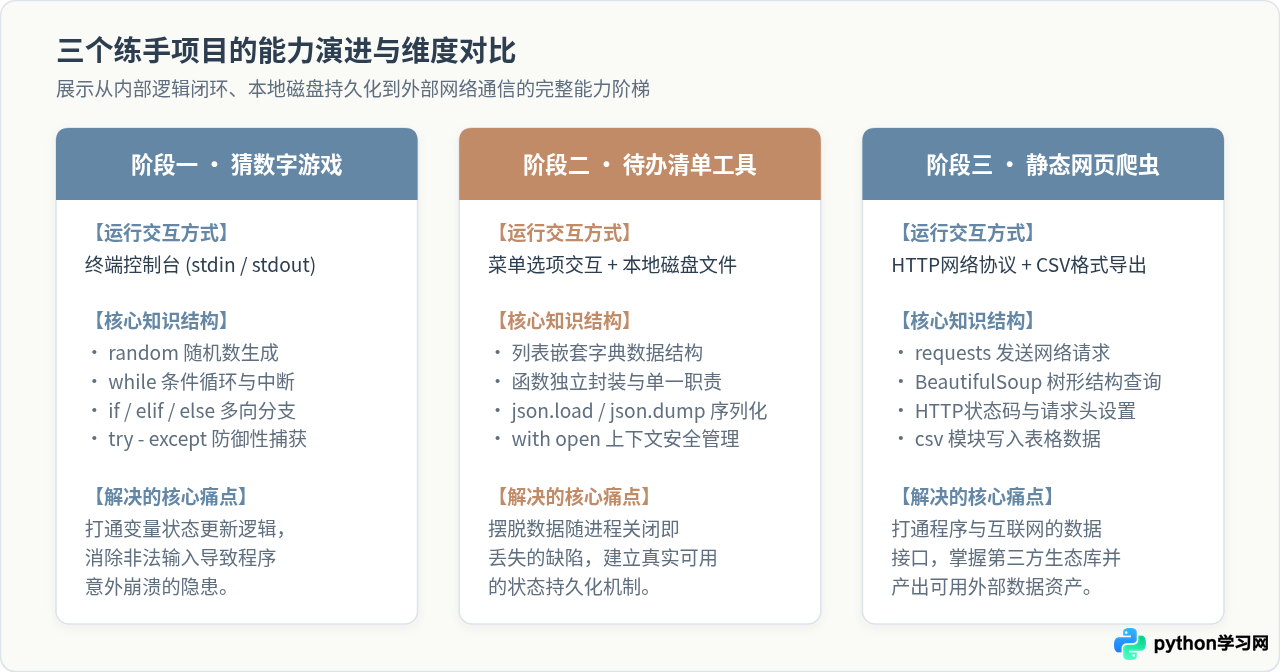
合理的项目梯次应当逐步引入核心计算机概念:
- 第一阶段(猜数字游戏):解决“程序内部运行与控制流”问题。重点掌握循环的启动与终止、随机数状态维护、
input()类型转换,以及对非法输入的防御性捕获。 - 第二阶段(待办清单管理器):解决“数据状态保存与模块划分”问题。程序不再是一次性跑完就消失的脚本,而是需要组织内存中的列表与字典,并通过读写本地 JSON 文件,实现数据的持久化保存。
- 第三阶段(静态网页简单爬虫):解决“与外部世界进行协议通信与数据交付”问题。学习使用行业主流的第三方库(
requests与BeautifulSoup),理解 HTTP 请求机制与 DOM 树解析,并将抓取到的数据导出为标准 CSV 表格。
二、项目一:控制台猜数字游戏(夯实基础控制流)
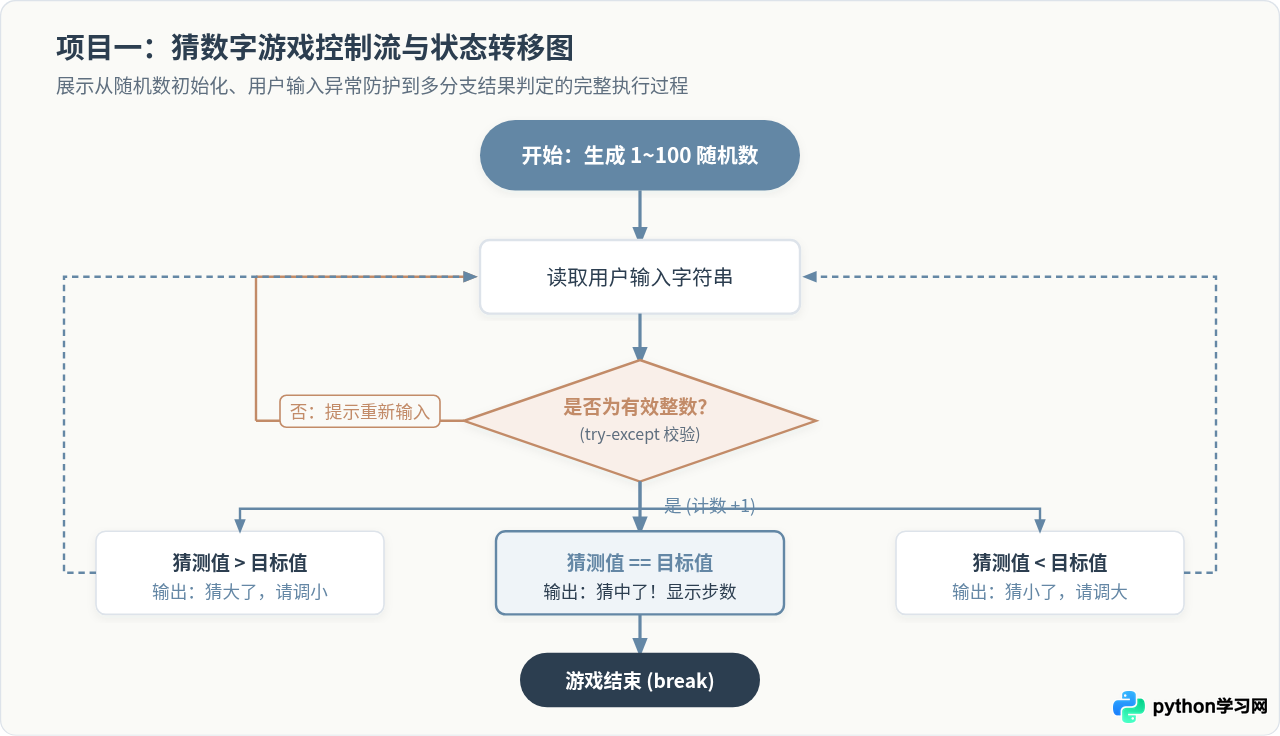
猜数字游戏虽然规则直观,但它涵盖了一个交互式程序的核心骨架:初始化状态、等待用户输入、校验有效性、根据条件分支给出反馈,并在满足终止条件时平稳退出。
1. 完整实现源码
以下代码保存为 guess_number.py。代码中增加了完整的输入类型防御机制,避免用户输入非数字字符时程序崩溃退出。
# guess_number.py
import random

def main():
    target = random.randint(1, 100)
    attempts = 0
    print("=== 欢迎来到猜数字游戏 ===")
    print("系统已在 1 到 100 之间生成了一个神秘整数,请开始猜测。")

    while True:
        user_input = input("请输入你猜的数字 (输入 q 退出):").strip()

        # 允许用户中途主动退出
        if user_input.lower() == 'q':
            print(f"游戏已提前结束,神秘数字其实是:{target}")
            break

        # 输入防御性校验:防止因非数字导致 int() 转换异常崩溃
        try:
            guess = int(user_input)
        except ValueError:
            print("【提示】输入无效!请输入纯整数数字。")
            continue

        # 数值边界检查
        if guess < 1 or guess > 100:
            print("【提示】数字超出范围,请输入 1 到 100 之间的整数。")
            continue

        attempts += 1

        # 核心多分支逻辑判定
        if guess > target:
            print(f"太大了!再往小猜一点。(已尝试 {attempts} 次)")
        elif guess < target:
            print(f"太小了!再往大猜一点。(已尝试 {attempts} 次)")
        else:
            print(f"恭喜你,猜中了!正确数字正是 {target}。")
            print(f"你总共花费了 {attempts} 次尝试。")
            break

if __name__ == "__main__":
    main()
2. 运行示例与测试
在终端中执行命令 python3 guess_number.py,观察各种输入场景下的响应:
系统已在 1 到 100 之间生成了一个神秘整数,请开始猜测。
请输入你猜的数字 (输入 q 退出):hello
【提示】输入无效!请输入纯整数数字。
请输入你猜的数字 (输入 q 退出):120
【提示】数字超出范围,请输入 1 到 100 之间的整数。
请输入你猜的数字 (输入 q 退出):50
太大了!再往小猜一点。(已尝试 1 次)
请输入你猜的数字 (输入 q 退出):25
太小了!再往大猜一点。(已尝试 2 次)
请输入你猜的数字 (输入 q 退出):37
恭喜你,猜中了!正确数字正是 37。
你总共花费了 3 次尝试。
新手常犯的错误是直接写 guess = int(input()) 且不加 try-except 保护。一旦用户无意间按了回车或输入了字母,程序便会立刻抛出 ValueError 异常而闪退。编写任何交互式程序时,把所有用户输入当成“不可信字符串”并做好异常隔离是良好的工程习惯。
三、项目二:本地待办清单管理器(掌握数据结构与文件持久化)
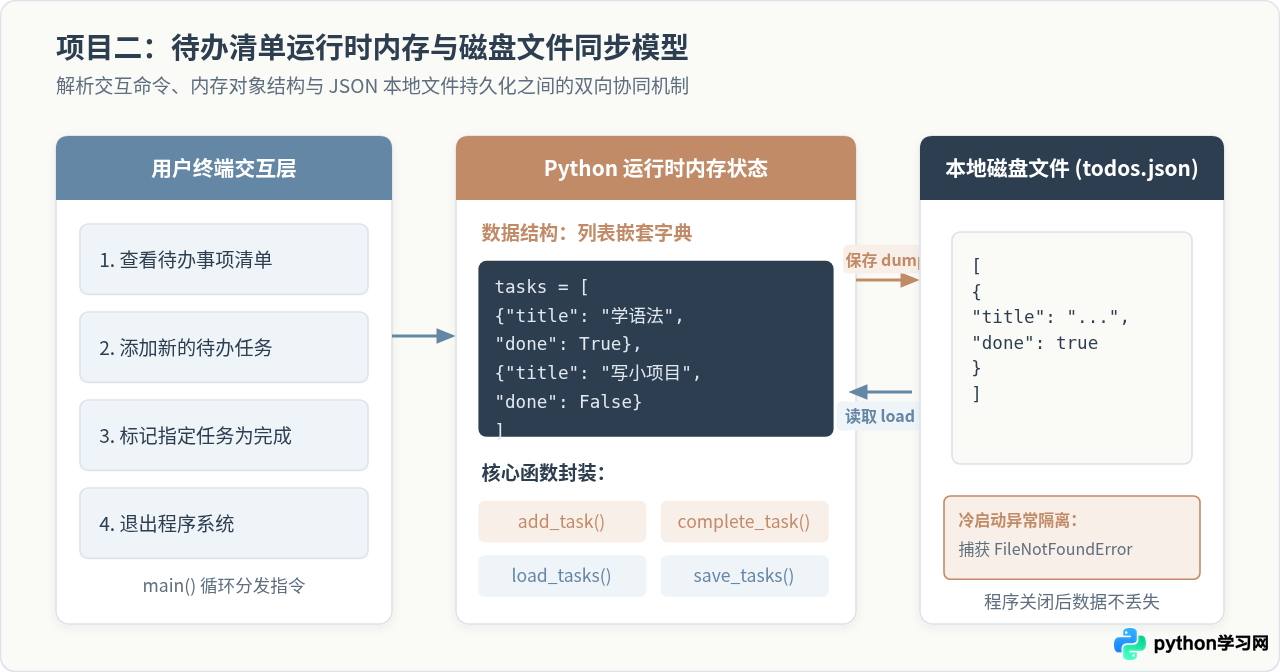
仅在内存中运行的脚本只要终端窗口关闭,所有的状态与计算结果都会清空。待办清单(To-Do List)项目引导新手进入“持久化存储”领域:学习用 Python 内置的 json 模块将内存中的复合数据(列表嵌套字典)以结构化形式保存至磁盘,并在下次启动时恢复。
1. 完整实现源码
以下代码保存为 todo_manager.py。程序将所有任务项保存在同目录下的 todos.json 文件中,具备完整的查看、新增、完成与错误防范功能。
# todo_manager.py
import json
import os

DATA_FILE = "todos.json"

def load_tasks():
    """从磁盘 JSON 文件加载任务列表,如果文件不存在或为空则返回空列表"""
    if not os.path.exists(DATA_FILE):
        return []
    try:
        with open(DATA_FILE, "r", encoding="utf-8") as f:
            return json.load(f)
    except (json.JSONDecodeError, IOError):
        print("【警告】数据文件损坏或读取失败,已初始化为空列表。")
        return []

def save_tasks(tasks):
    """将内存中的任务列表保存到磁盘 JSON 文件"""
    with open(DATA_FILE, "w", encoding="utf-8") as f:
        json.dump(tasks, f, ensure_ascii=False, indent=2)

def list_tasks(tasks):
    """打印当前所有任务状态"""
    if not tasks:
        print("
当前没有待办任务,清单为空。")
        return
    print("
--- 待办事项清单 ---")
    for idx, item in enumerate(tasks, start=1):
        status = "[已完成]" if item["done"] else "[待处理]"
        print(f"{idx}. {status} {item['title']}")
    print("--------------------")

def add_task(tasks):
    """向任务列表添加新事项并立即持久化"""
    title = input("请输入新任务内容:").strip()
    if not title:
        print("【提示】任务内容不能为空!")
        return
    tasks.append({"title": title, "done": False})
    save_tasks(tasks)
    print(f"已成功添加任务:'{title}'")

def complete_task(tasks):
    """根据用户输入的任务编号将对应任务标记为已完成"""
    list_tasks(tasks)
    if not tasks:
        return
    user_input = input("请输入要标记为完成的任务编号:").strip()
    try:
        task_num = int(user_input)
        if 1 <= task_num <= len(tasks):
            target_item = tasks[task_num - 1]
            if target_item["done"]:
                print(f"任务 '{target_item['title']}' 原本就已经是完成状态。")
            else:
                target_item["done"] = True
                save_tasks(tasks)
                print(f"已将任务 {task_num} '{target_item['title']}' 标记为已完成!")
        else:
            print("【提示】任务编号不存在,超出有效范围。")
    except ValueError:
        print("【提示】请输入有效的数字编号。")

def main():
    tasks = load_tasks()
    while True:
        print("
=== 待办事项管理器 ===")
        print("1. 查看任务列表")
        print("2. 添加新任务")
        print("3. 完成任务")
        print("4. 退出程序")
        choice = input("请选择操作 (1-4):").strip()

        if choice == "1":
            list_tasks(tasks)
        elif choice == "2":
            add_task(tasks)
        elif choice == "3":
            complete_task(tasks)
        elif choice == "4":
            print("程序已退出,数据已安全保存在 todos.json。")
            break
        else:
            print("【提示】无效选项,请输入数字 1 到 4。")

if __name__ == "__main__":
    main()
2. 运行示例与磁盘文件验证
在终端中执行命令 python3 todo_manager.py:
1. 查看任务列表
2. 添加新任务
3. 完成任务
4. 退出程序
请选择操作 (1-4):2
请输入新任务内容:复习 Python 基础语法
已成功添加任务:'复习 Python 基础语法'
=== 待办事项管理器 ===
1. 查看任务列表
2. 添加新任务
3. 完成任务
4. 退出程序
请选择操作 (1-4):1
--- 待办事项清单 ---
1. [待处理] 复习 Python 基础语法
--------------------
请选择操作 (1-4):3
请输入要标记为完成的任务编号:1
已将任务 1 '复习 Python 基础语法' 标记为已完成!
此时可以在同一目录下查看自动生成的 todos.json 文件:
[
  {
    "title": "复习 Python 基础语法",
    "done": true
  }
]打开文件时始终使用 with open(...) 上下文管理器,它能确保在任何异常情况下文件句柄都能被及时关闭;指定 encoding="utf-8" 能防止在 Windows 系统默认的 GBK 环境下发生中文字符乱码;在 json.dump() 中传入 ensure_ascii=False,可以保留直观的中文字符,避免中文被转义为 中文 形式的 Unicode 码点。
四、项目三:静态网页简单爬虫(初探第三方库与外部数据获取)
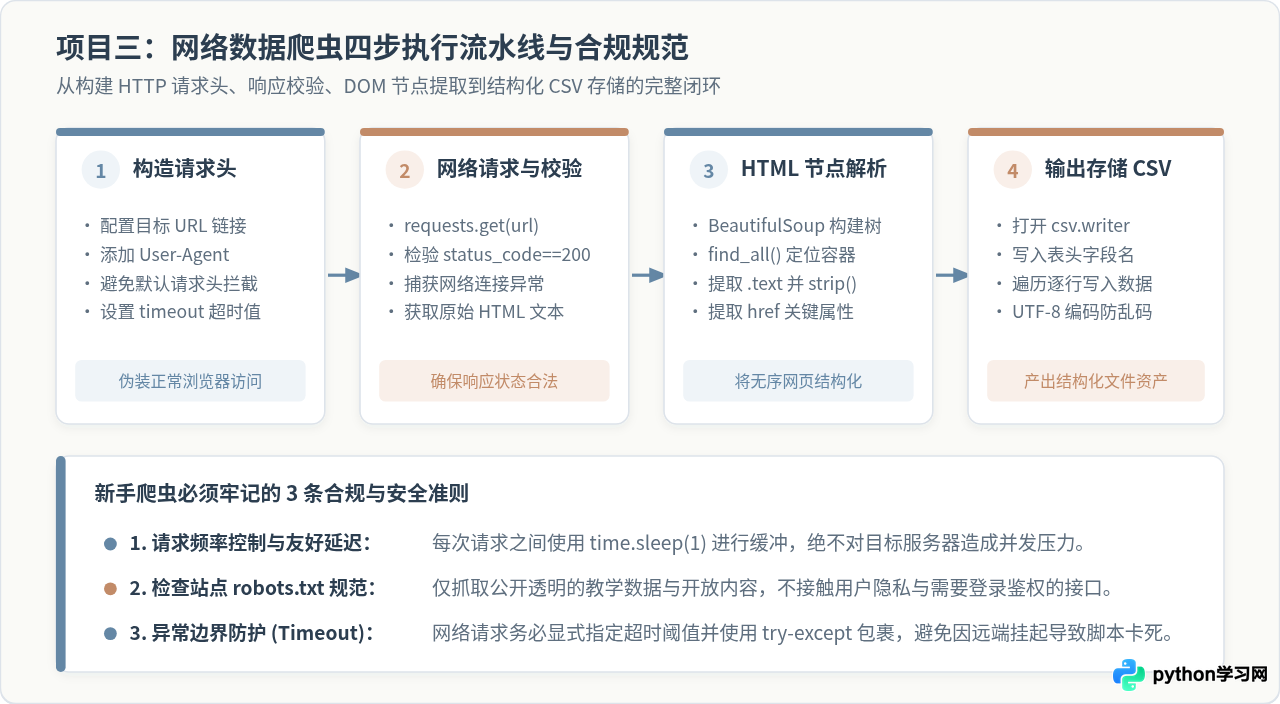
前两个项目都在本地运行。网络爬虫项目将带你跨越本地环境,与互联网真实服务通信。我们将使用 Python 生态中广泛应用的两个第三方库:用于发起 HTTP 请求的 requests 和用于解析 HTML 文档的 BeautifulSoup4,完成“抓取网页内容 → 提取结构化数据 → 输出为 CSV 表格”的典型流水线。
1. 环境准备
该项目需要安装第三方扩展库。在系统终端中运行以下命令:
pip install requests beautifulsoup42. 抓取目标与完整实现源码
我们将以网络爬虫公共练习站点 http://quotes.toscrape.com/ 为例。该网站结构清晰、完全公开,专门用于爬虫学习与测试。我们的目标是抓取页面中的“名言文本(quote)”、“作者姓名(author)”以及“标签分类(tags)”,并将它们清洗后保存到本地的 quotes.csv 文件中。
以下代码保存为 simple_scraper.py:
# simple_scraper.py
import requests
from bs4 import BeautifulSoup
import csv
import time

TARGET_URL = "http://quotes.toscrape.com/"
OUTPUT_CSV = "quotes.csv"

# 伪装 User-Agent,避免使用 requests 默认头被部分服务器拒绝
HEADERS = {
    "User-Agent": (
        "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/120.0.0.0 Safari/537.36"
    )
}

def fetch_page_content(url):
    """发起 HTTP GET 请求并返回网页 HTML 文本"""
    try:
        print(f"正在请求目标网页:{url} ...")
        response = requests.get(url, headers=HEADERS, timeout=10)
        # 严格检查 HTTP 状态码,如果不是 200 会抛出 HTTPError 异常
        response.raise_for_status()
        response.encoding = response.apparent_encoding
        return response.text
    except requests.RequestException as e:
        print(f"【网络错误】请求失败:{e}")
        return None

def parse_quotes(html_content):
    """解析 HTML 文档,提取结构化的名言、作者与标签列表"""
    soup = BeautifulSoup(html_content, "html.parser")
    # 定位所有包含名言信息的容器区块
    quote_blocks = soup.find_all("div", class_="quote")

    extracted_data = []
    for block in quote_blocks:
        # 提取名言文本并去掉多余空白字符
        text_elem = block.find("span", class_="text")
        text = text_elem.get_text(strip=True) if text_elem else ""

        # 提取作者名字
        author_elem = block.find("small", class_="author")
        author = author_elem.get_text(strip=True) if author_elem else ""

        # 提取所有标签,用逗号连接
        tag_elems = block.find_all("a", class_="tag")
        tags = [tag.get_text(strip=True) for tag in tag_elems]
        tags_str = ", ".join(tags)

        extracted_data.append({"quote": text, "author": author, "tags": tags_str})

    return extracted_data

def save_to_csv(data, filename):
    """将提取到的字典列表保存为标准 CSV 表格"""
    if not data:
        print("未提取到有效数据,跳过文件写入。")
        return

    with open(filename, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=["quote", "author", "tags"])
        writer.writeheader()
        writer.writerows(data)

    print(f"成功保存 {len(data)} 条数据到本地文件:{filename}")

def main():
    html = fetch_page_content(TARGET_URL)
    if not html:
        print("未能获取页面内容,爬取流程终止。")
        return

    quotes = parse_quotes(html)
    print(f"解析完成,成功定位到 {len(quotes)} 条名言数据。")
    save_to_csv(quotes, OUTPUT_CSV)

    # 模拟礼貌延迟:若在循环爬取多页时,务必加上休眠
    time.sleep(1)

if __name__ == "__main__":
    main()
3. 运行测试与结果验证
在终端中执行命令 python3 simple_scraper.py:
解析完成,成功定位到 10 条名言数据。
成功保存 10 条数据到本地文件:quotes.csv
在当前目录下打开生成的 quotes.csv,内容格式如下:
quote,author,tags
"“The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”",Albert Einstein,"change, deep-thoughts, thinking, world"
"“It is our choices, Harry, that show what we truly are, far more than our abilities.”",J.K. Rowling,"abilities, choices"
"“There are only two ways to live your life. One is as though nothing is a miracle. The other is as though everything is a miracle.”",Albert Einstein,"inspirational, life, live, miracle, miracles"- 必须设置请求头(User-Agent):默认的
requests请求头中包含python-requests/...,绝大多数现代网站的 WAF 会直接拦截并返回 403 Forbidden 错误。 - 严格限制抓取频率:编写循环爬取多页的脚本时,务必在每次循环中加入
time.sleep(1)或time.sleep(2)。无间隔的高频发包不仅容易造成对方服务器负载过高,也会导致个人 IP 被永久封禁。 - 尊重网站 robots.txt 与版权:在抓取前查看
域名/robots.txt,只爬取允许收录的公开内容,绝不尝试绕过登录接口爬取用户私密信息或商业数据。
五、总结:从练手项目到独立编写的过渡建议
完成上述 3 个项目后,初学者已经实际跨越了“纯语法练习 → 模块化持久化应用 → 外部协议与数据采集”的三个阶段。为了真正把这套技能内化为自己的编程本能,建议按照以下步骤进行复盘与二次扩展:
| 项目名称 | 核心涉及语法与库 | 掌握标准 | 推荐自主扩展练习 |
|---|---|---|---|
| 1. 猜数字游戏 | random、while、if-elif-else、try-except |
能独立写出具备容错能力的输入分支判定闭环 | 增加“猜测次数上限(如限定 7 次)”或“双人轮流对战模式” |
| 2. 待办清单工具 | json、with open、函数封装、列表/字典操作 |
理解程序运行时内存与本地磁盘文件的数据同步关系 | 增加“删除指定任务”功能与“按优先级或截止日期排序”功能 |
| 3. 静态网页爬虫 | requests、BeautifulSoup、csv、HTTP请求头 |
能定位 HTML 节点并清洗导出为规整的结构化文件 | 编写 while 循环实现点击“下一页”自动分页连续爬取 |
学习编程的关键不是“把代码抄一遍并让它跑通”,而是在它跑通之后,主动去修改其中的某些逻辑并观察它的变化。例如尝试把猜数字的范围动态化、让待办清单支持分类标签、或者让爬虫抓取其他公开图书榜单。通过这种小步迭代,你便能从代码的阅读者真正转变为能够用代码解决实际问题的开发者。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















