


Python设置环境变量有什么用:控制模块路径与程序行为
深入解析Python环境变量的核心作用,详解PYTHONPATH如何影响模块导入路径、系统内置变量如何调控解释器底层行为,以及在工程实践中安全解耦业务配置的具体方法与避坑指南。
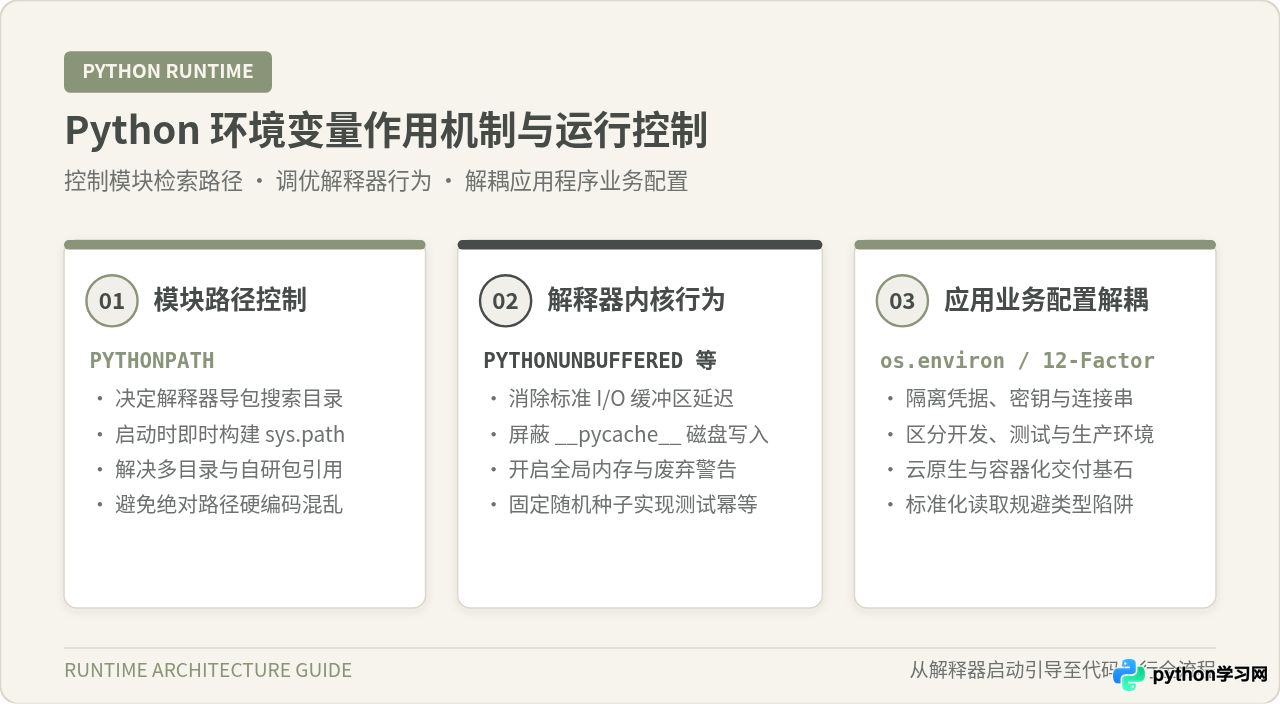
PYTHONPATH),彻底解决多目录和自研包的导入问题;二是向底层解释器传递全局运行开关(如关闭输出缓冲的 PYTHONUNBUFFERED、禁用字节码生成的 PYTHONDONTWRITEBYTECODE、开启开发诊断的 PYTHONDEVMODE 等),在不修改任何业务代码的前提下精细控制程序的运行时状态。本文将围绕这两个核心维度,梳理环境变量在解释器启动阶段的生效原理、标准配置步骤、关键疑难辨析及工程化落地方案。
一、环境变量在 Python 中的角色与生效分流
环境变量(Environment Variables)是操作系统提供给进程的键值对集合。当我们在终端、脚本或容器中执行 python main.py 时,操作系统内核会把当前环境块完整传递给新启动的 Python 解释器进程。
与其他需要在代码执行时解析的动态配置不同,Python 对环境变量的消费发生在解释器引导启动(Interpreter Bootstrap)的早期阶段。在这个极短的毫秒级初始化期间,C 语言层面的解释器内核根据变量名将其分流到三个不同的内部处理管道:
- 路径初始化分流:读取以
PYTHONPATH为代表的路径变量,将其拆解并插入到解释器的全局导入检索列表sys.path中。 - 内核标志位分流:检测以
PYTHON*开头的系统级环境变量,将其转换为内部配置结构体(PyConfig)中的标志位,从而决定是否开启标准输出缓冲、是否生成字节码文件等。 - 应用环境映射分流:将当前进程继承到的所有普通环境变量,以字符串字典的形式封装在标准库
os.environ中,供业务代码在需要时查询使用。
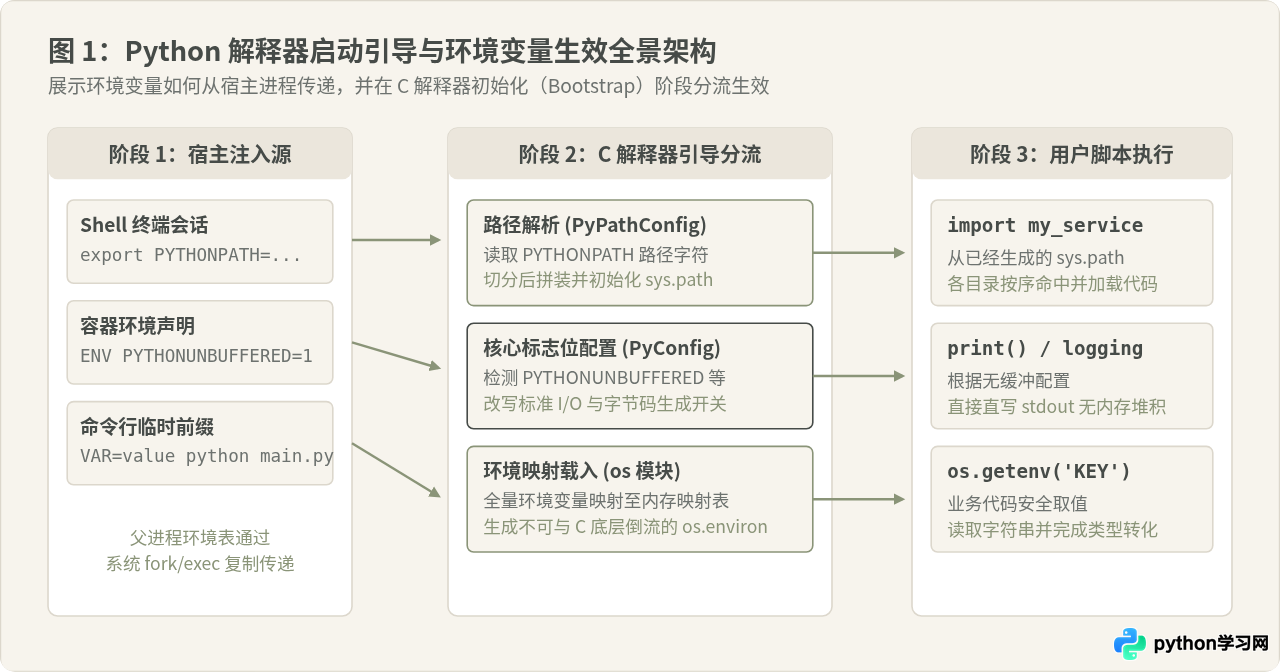
理解这个分流机制至关重要:环境变量不仅是业务代码中获取数据库密码或服务地址的载体,更在 Python 解释器尚未执行第一行用户代码之前,就已经锁定了当前进程的依赖搜索范围与 I/O 运行规则。
二、核心用处一:控制模块搜索路径(PYTHONPATH 与 sys.path)
在日常开发或自动化测试时,最常遇到的报错莫过于 ModuleNotFoundError: No module named '...'。这通常并非依赖未安装,而是该模块所在的目录没有被列入 Python 解释器的检索名单。
1. Python 是如何寻找模块的
每次执行 import xxx 时,Python 会遍历标准库列表 sys.path。这个列表在解释器启动时由以下几个部分按严格顺序组装而成:
- 当前入口目录:被运行脚本所在的绝对目录(交互式终端中为空字符串
'')。 - 环境变量注入目录:由环境变量
PYTHONPATH中声明的一个或多个路径。 - 标准库与扩展库目录:Python 安装目录下的
lib/以及第三方依赖集中的site-packages/。
如果你的项目包含多个并列的服务目录(例如 src/、common/、tests/),而业务脚本试图跨层级引用公共模块,仅仅依靠脚本自身目录将无法检索到目标。此时设置 PYTHONPATH,就能在无需侵入性修改代码的前提下,为解释器提供明确的寻径指引。
2. 实操步骤:跨平台配置 PYTHONPATH
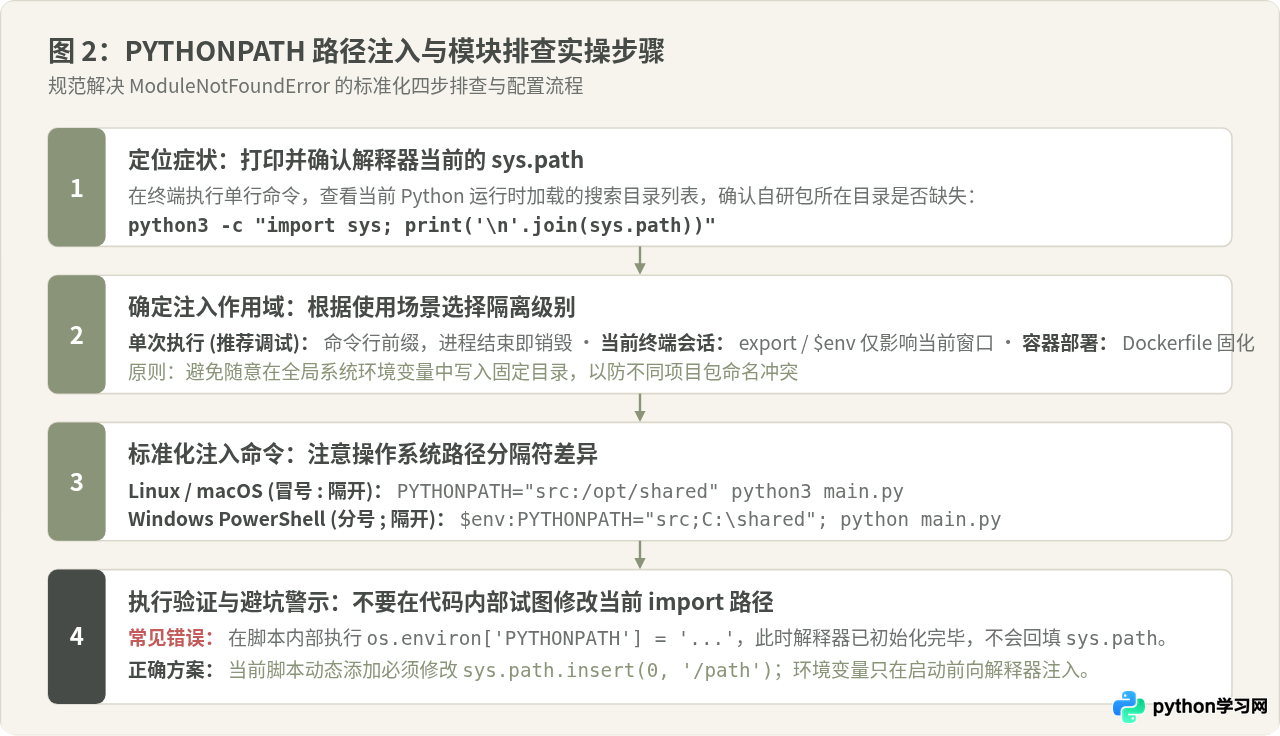
在实际操作中,推荐按以下四个步骤进行诊断与配置:
第一步:验证当前搜索路径
在目标运行环境下执行单行命令,打印真实的 sys.path:
python3 -c "import sys; print('\n'.join(sys.path))"观察输出列表中是否包含你希望引用的模块根目录。如果缺失,确认该目录的绝对或相对路径。
第二步:选择配置作用域并执行注入
根据使用场景选择隔离级别,注意 Linux/macOS 与 Windows 在路径分隔符上的差异(类 Unix 使用冒号 :,Windows 使用分号 ;):
Linux / macOS 终端
单次运行注入(推荐调试):
PYTHONPATH=./src:./common python3 main.py当前终端会话生效:
export PYTHONPATH="$(pwd)/src:$PYTHONPATH"
python3 main.py
Windows PowerShell / CMD
PowerShell 当前会话:
$env:PYTHONPATH = "src;C:\project\common"
python main.py
经典 CMD 窗口:
set PYTHONPATH=src;C:\project\common
python main.py
第三步:Docker 容器中的标准固化
在编写微服务 Dockerfile 时,常将工作目录设为 /app,并通过 ENV 固化模块搜索路径:
WORKDIR /app
COPY . /app
ENV PYTHONPATH=/app/src:/appos.environ['PYTHONPATH'] = '/path' 为什么不能影响当前 import?
为什么这种写法看似很合理?
初学者往往会觉得:“既然 PYTHONPATH 是用来指定模块路径的,os.environ 又能读写环境变量,那我在脚本最上方修改 os.environ['PYTHONPATH'],紧接着 import 不就起效了吗?”
真实机制与修正说明:
这种操作对当前脚本随后的 import 完全无效。正如前文图 1 所示,Python 解释器在 C 语言层面的引导阶段就已经读取完毕宿主环境变量,并且生成了内存中的 sys.path 列表。当你的 Python 脚本开始运行并执行到 os.environ['PYTHONPATH'] = ... 时,初始化的时机早已过去,Python 绝不会在脚本执行中去自动重新扫描环境变量并倒流修改 sys.path。
那为什么有人误以为它生效了?
因为对 os.environ 的修改会被保存在当前进程的 C 级环境块中。如果你的脚本随后通过 subprocess.run(["python", "worker.py"]) 派生了一个新的 Python 子进程,这个全新的子进程在启动时会继承更新后的环境变量,并在其自身的引导阶段正确读取到新的 PYTHONPATH!
结论与正确做法:
如果需要在同一个 Python 脚本内部动态临时扩充搜索目录,正确的做法是直接操作 sys.path:
import sys
from pathlib import Path

# 将目标目录插入到搜索列表首位
extra_dir = str(Path(__file__).resolve().parent / "custom_pkg")
if extra_dir not in sys.path:
    sys.path.insert(0, extra_dir)

# 此时导入便能正常生效
import custom_pkg
三、核心用处二:精准调控 Python 解释器的底层运行时行为
除了路径管理,Python 内部内置了一批前缀为 PYTHON* 的专用环境变量。这类变量的用途是全局调节解释器的底层执行特征。在容器化运行、生产日志采集、性能排查及持续集成测试中,合理使用它们能解决许多隐蔽的运行隐患。
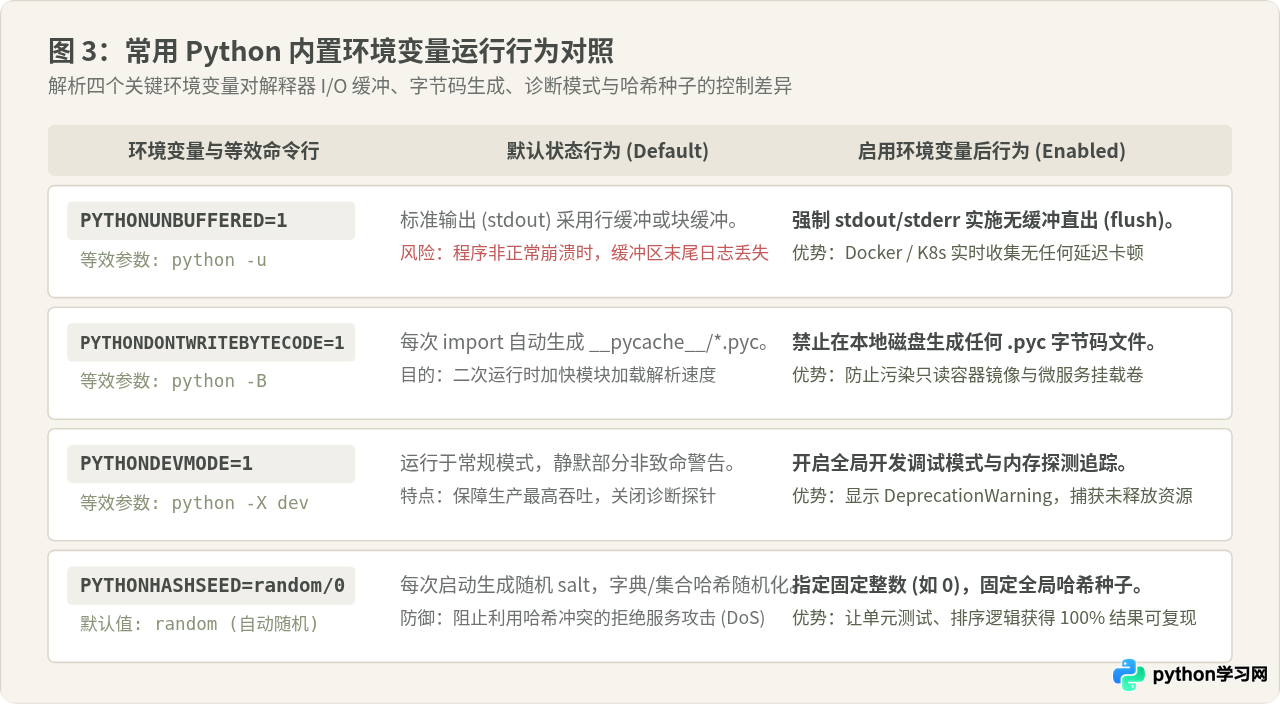
1. PYTHONUNBUFFERED=1:日志直出与容器排障的标配
默认情况下,Python 对标准输出(stdout)和标准错误(stderr)采用了 I/O 缓冲优化机制(根据终端是否为 TTY 自动选择行缓冲或 4KB/8KB 块缓冲)。这一机制在后台运行或重定向输出时,会导致 print() 输出的内容被暂存在内存缓冲区中,直到缓冲区填满或进程优雅退出时才真正落盘。
在 Docker、Kubernetes 或后台守护进程中,这会引发严重问题:如果服务因为 OOM(内存溢出)被内核直接 kill -9 杀死,或者发生未捕获的段错误,缓冲区内尚未写出的最后数十行日志就会彻底丢失,导致排查故障时看不到崩溃前的关键现场。
通过设置 PYTHONUNBUFFERED=1(等效于命令行启动参数 python -u),解释器会强制让 stdout 和 stderr 处于完全无缓冲状态,每一条输出均实时推向宿主容器日志收集管道(如 fluentd、logstash),确保崩溃现场清晰可查。
2. PYTHONDONTWRITEBYTECODE=1:保障只读文件系统与镜像轻量化
当 Python 导入模块时,解释器会自动在源码所在目录生成 __pycache__/*.pyc 文件,用于缓存预编译的字节码,加速下一次导入。但在很多现代工程场景中,这一机制反而会带来阻碍:
- 在云原生生产环境中,容器镜像往往遵循只读文件系统(Read-only Root Filesystem)的最佳安全规范。如果应用在运行时尝试在只读目录写入
.pyc文件,会直接抛出文件系统权限异常。 - 在多用户共享挂载卷或由外部代码挂载进容器的调试场景下,root 用户生成的
.pyc文件会导致本地宿主环境出现文件属主与权限混乱。
设置 PYTHONDONTWRITEBYTECODE=1(等效于 python -B),即可明确告知解释器只在内存中解析并执行字节码,绝不落盘任何缓存文件。
3. PYTHONDEVMODE=1:开发期全面开启诊断探针
在 Python 3.7 及以上版本中,设置 PYTHONDEVMODE=1(等效于 python -X dev)可以一键激活 Python 的“开发者模式”。该模式会在不改变代码逻辑的前提下,开启一系列严格的内置诊断检查:
- 默认开启
ResourceWarning,一旦代码中打开的文件句柄、网络 Socket 未显式调用close()就被垃圾回收,会立即在控制台打印告警并指明创建位置。 - 开启默认处于忽略状态的
DeprecationWarning,帮助团队提前捕获使用了即将弃用的旧 API 的调用。 - 激活
tracemalloc内存分配追溯模块,为内存泄漏排查提供支持。
4. PYTHONHASHSEED:保障测试与排错结果的确定性
Python 默认采用带有随机盐值的哈希算法对字符串和字节串进行散列(防止针对字典碰撞的 Hash-DoS 攻击)。这导致同一个字符串在不同次启动 Python 时,其 hash() 计算结果完全不同,字典和集合在内存中的遍历顺序也随之发生变动。
当你在编写单元测试,或者排查因迭代无序集合导致的边缘逻辑 Bug 时,这种随机性会造成“本地报错、CI 成功”或“有时过、有时不过”的偶发性难题。此时设置环境变量 PYTHONHASHSEED=0,可以让解释器固定哈希种子,使数据结构在内存中的散列与遍历顺序 100% 具备可重现性。
| 环境变量名 | 等效命令行参数 | 核心调控行为 | 典型适用场景 |
|---|---|---|---|
PYTHONPATH |
无直接单字母参数 | 向 sys.path 头部追加模块搜索路径 |
多包协同、单体代码库、本地脚本调试 |
PYTHONUNBUFFERED |
python -u |
禁用 stdout/stderr 块缓冲,实时直写 | Docker / K8s 容器交付、后台 Daemon 服务 |
PYTHONDONTWRITEBYTECODE |
python -B |
禁止写入 __pycache__ 目录与 .pyc |
只读容器、CI 镜像构建、挂载卷调试 |
PYTHONDEVMODE |
python -X dev |
开启内存追踪、未关闭句柄预警及废弃 API 警告 | 本地功能开发、联调测试阶段、自动化测试 |
PYTHONHASHSEED |
无 | 指定字符串哈希算法的随机化种子(默认 random) | 排查偶发单元测试失败、复现确定性散列顺序 |
PYTHONOPTIMIZE |
python -O |
剥离 assert 语句与 __debug__ 代码块 |
生产环境极端高频逻辑的微弱性能优化(需谨慎) |
四、应用程序层面的环境变量使用:业务配置解耦与避坑指南
现代云原生应用架构(如业界著名的 The Twelve-Factor App)明确主张:将应用的配置从代码中彻底解耦,统一存储于环境变量中。
1. 为什么配置不应写在代码中
如果将数据库连接字符串、Redis 密码或第三方的 API Token 硬编码在代码文件或随 Git 仓库提交的静态配置文件(如 config.py)中,会引发严重后果:
- 凭据泄露风险:代码一旦提交到公开仓库或跨团队共享,生产环境凭据将面临失窃风险。
- 环境切换困难:同一份镜像部署到开发(Dev)、测试(Staging)和生产(Prod)环境时,必须修改文件重新构建打包,违背“一份镜像、多处分发”的原则。
通过环境变量注入配置后,同一份镜像只需在启动时接收不同的环境变量,即可无缝切换目标数据源与服务模式。
2. 在 Python 中安全读取环境变量的规范写法
Python 标准库提供了 os.environ 字典与 os.getenv() 方法,但在使用时务必注意容错性设计:
import os

# 推荐写法 1:非敏感配置提供合理默认值
APP_PORT = int(os.getenv("APP_PORT", "8000"))

# 推荐写法 2:核心密钥必须强制存在,缺失时立即阻断启动
try:
    SECRET_KEY = os.environ["APP_SECRET_KEY"]
except KeyError:
    raise RuntimeError("关键环境变量 APP_SECRET_KEY 未配置,服务拒绝启动!")
由于操作系统的环境块只支持字符串格式,os.getenv() 返回的永远是 str(或未命中时的 None)。
很多初学者在配置布尔开关时,常犯以下致命错误:
# ❌ 错误示范:当外部设置 DEBUG="False" 或 DEBUG="0" 时
DEBUG = bool(os.getenv("DEBUG", "False"))
if DEBUG:
    # 这里的代码永远会被执行!因为非空字符串 "False" 在 Python 中 bool 判定为 True!
    enable_dangerous_debug_toolbar()
安全解析布尔值的标准方式:
# ✅ 正确示范:显式转换为小写后比对合法真值集合
raw_debug = os.getenv("DEBUG", "false").strip().lower()
DEBUG = raw_debug in ("true", "1", "yes", "on")
3. 辨析:环境变量 vs 命令行参数 vs 配置文件
在工程实践中,三种传参形式各自具备清晰的职责边界,不应相互替代:
- 环境变量:最适合存放跨环境变化的配置与敏感凭据(如数据库地址、密钥、环境模式
ENV=prod、底层解释器开关)。 - 命令行参数(CLI Args):最适合控制单次执行的行为细节与即时动作(如批处理脚本的数据文件路径
--input-file data.csv、运行模式--dry-run)。 - 配置文件(YAML / TOML / JSON):最适合存放结构复杂、嵌套层级深且不涉及敏感密钥的业务规则参数(如业务审批流策略、规则引擎判定阈值表等)。
五、配置生效周期与生命周期选择指南
选择在何处设置环境变量,决定了它的生效范围与生命周期。设置的范围越宽(如全局写入操作系统),对其他无关项目产生副作用的风险就越高。
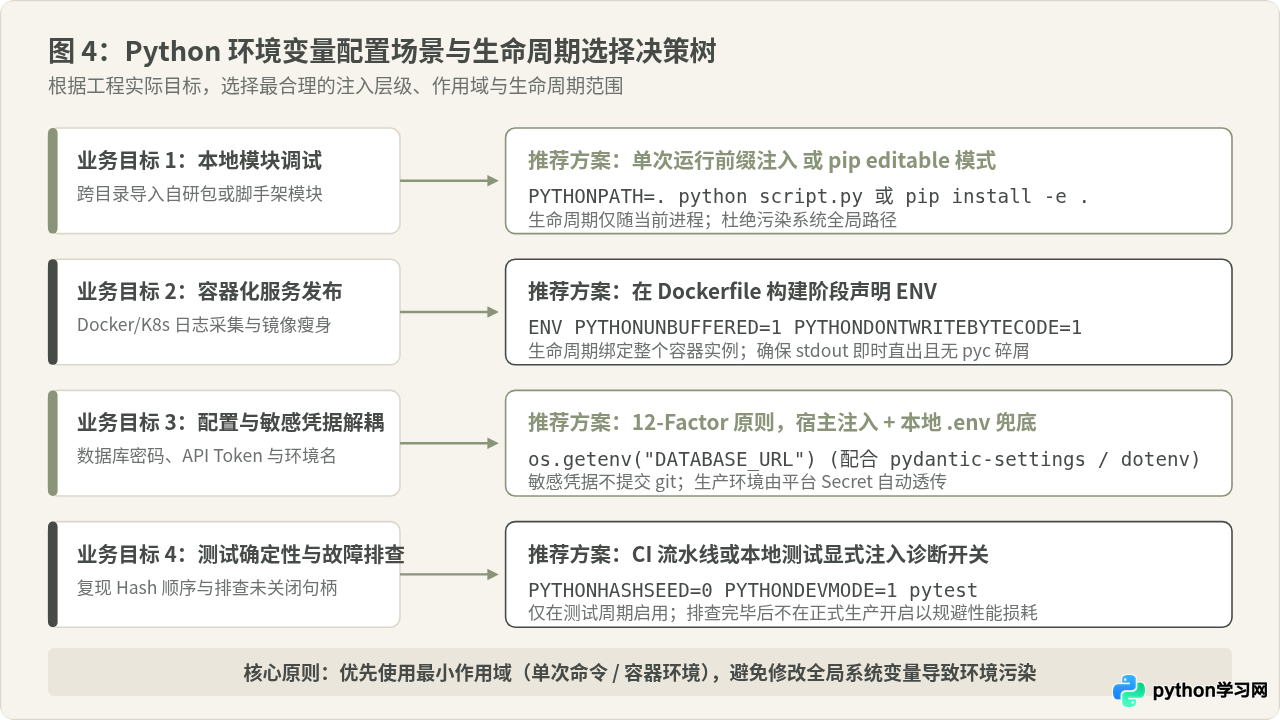
工程落地建议清单:
- 优先采用最小作用域:在本地调试自研包时,优先使用单次命令前缀
PYTHONPATH=. python script.py,或者利用pip install -e .安装为可编辑模式,切忌随意在系统级的~/.bashrc或 Windows 全局变量中追加硬编码目录。 - 容器化交付固化底层标志:在 Dockerfile 中标准配置
ENV PYTHONUNBUFFERED=1 PYTHONDONTWRITEBYTECODE=1,这是保障容器标准输出即时性与镜像干净度的黄金搭配。 - 开发环境搭配 .env 文件管理:在本地项目根目录放置
.env文件记录开发配置,通过python-dotenv或pydantic-settings库在应用启动时自动加载,同时务必将.env加入.gitignore,防止敏感凭据进入代码仓库。 - CI 流水线启用确定性参数:在持续集成流水线的测试环节显式声明
PYTHONHASHSEED=0 PYTHONDEVMODE=1,既能防止因哈希扰动导致单测偶尔飘红,又能及时暴露资源泄漏与废弃函数告警。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















