


怎么编写Python装饰器:不带参与带参写法的代码对比
深入对比Python不带参装饰器与带参装饰器的核心差异,详解两层闭包与三层工厂函数的嵌套逻辑、语法糖解包机制,并提供完整的可运行代码与避坑指南。
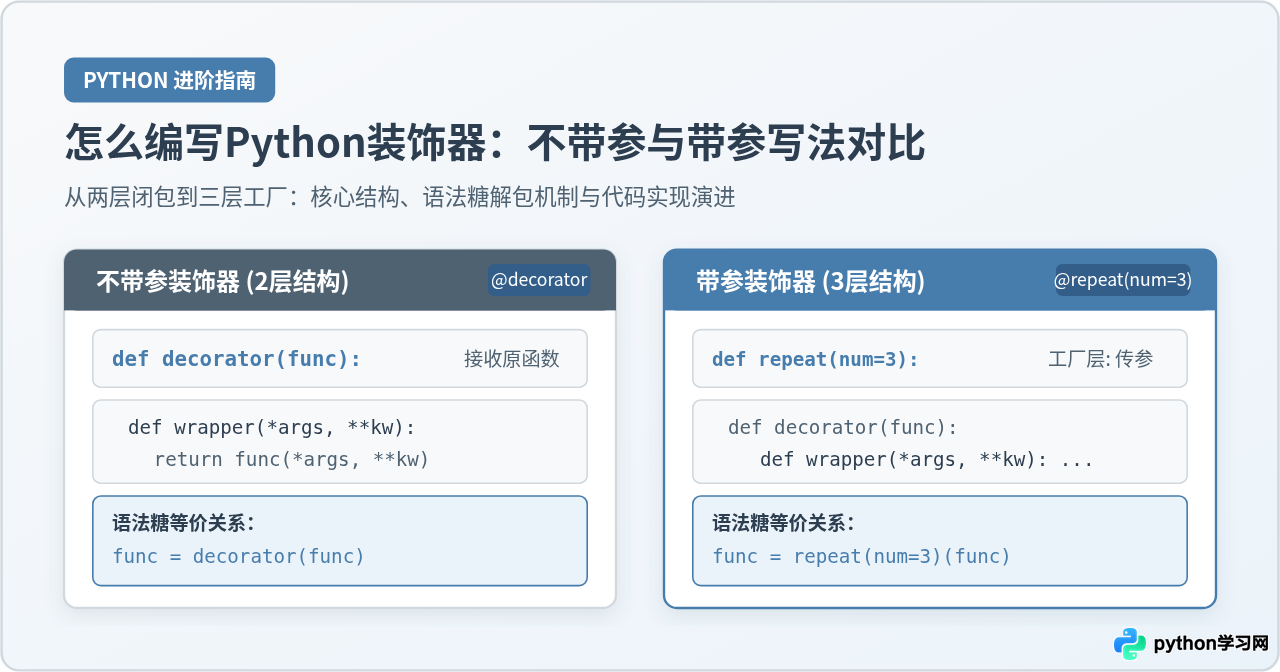
编写 Python 装饰器的核心,在于理解它是一个接收函数并返回新函数的高阶闭包。不带参装饰器只需要两层嵌套函数,最外层接收目标函数,内层负责包装拦截;而带参装饰器则需要三层嵌套函数,最外层作为配置工厂接收参数,中间层接收目标函数,内层再执行具体的包装逻辑。理清这两者的区别与编写套路,关键就在于掌握语法糖 @ 在不同调用形式下的解包执行时机。
不带参装饰器的标准写法与执行原理
不带参装饰器是最常见的装饰器形态,适用于逻辑固定、不需要在调用处动态调整参数的场景,例如统一计时、统一打印入参与异常捕获。
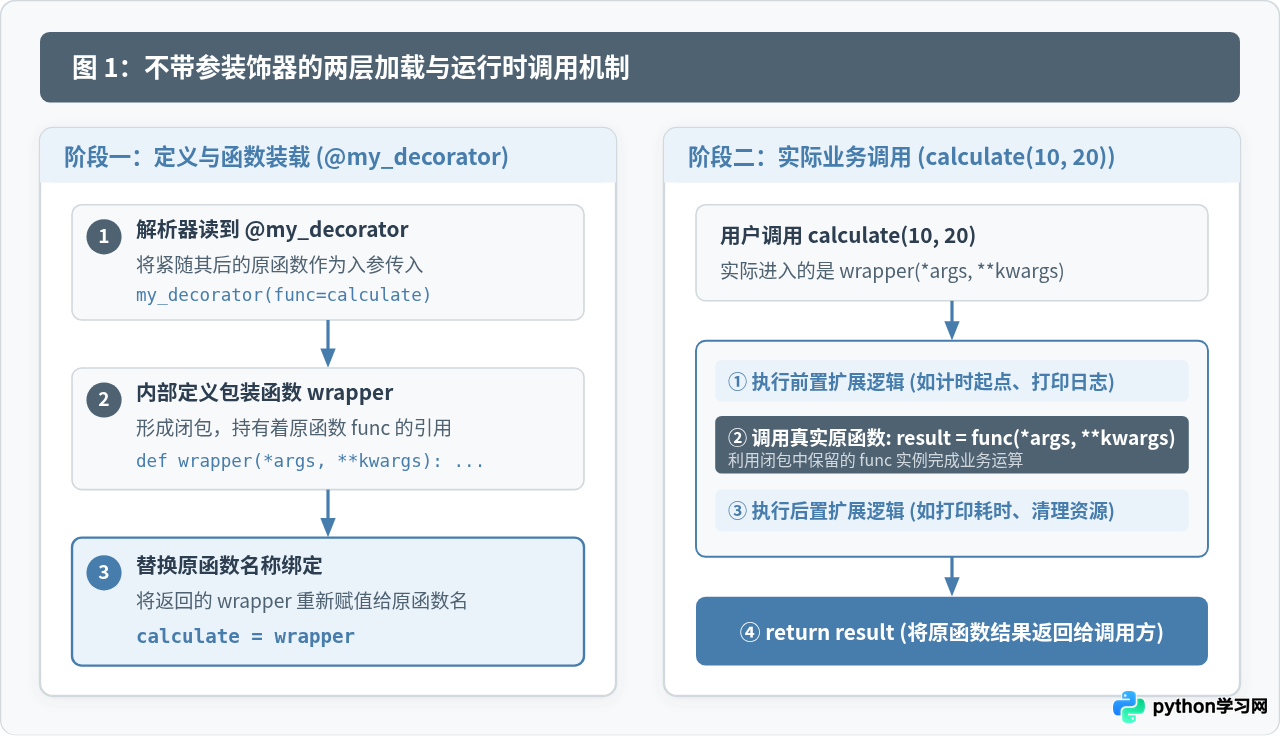
在编写时,函数结构严格分为两层:外层函数接收被修饰的函数对象 func,内层函数 wrapper 负责拦截并执行原函数前后追加的操作,最后外层函数将 wrapper 返回。
完整代码实现
import time
import functools

def timer(func):
    """不带参装饰器:用于统计函数执行耗时"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        # 执行被装饰的真实业务函数
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start_time
        print(f"[执行耗时] 函数 {func.__name__} 运行完成,耗时: {duration:.6f} 秒")
        # 务必返回原函数的计算结果
        return result
    return wrapper

@timer
def calculate_sum(n):
    return sum(i * i for i in range(n))

# 执行调用
total = calculate_sum(100000)
print(f"计算结果: {total}")计算结果: 333328333350000
语法糖 @timer 在代码导入或函数定义完成后立即执行。它等价于显式赋值语句:
calculate_sum = timer(calculate_sum)此时,变量名 calculate_sum 指向的已经不再是原函数,而是 timer 内部生成的 wrapper 闭包函数。每次执行 calculate_sum(...),实际触发的都是 wrapper。
带参装饰器的标准写法与三层嵌套拆解
当需要让装饰器的行为具备可配置性时(例如指定重试次数、设定日志级别、指定缓存超时时间),不带参的两层结构就无法满足需求了。因为 @decorator 默认只能接收被修饰的函数对象,无法直接接收外部传入的自定义配置。
带参装饰器的解决方法是在外面再包一层“工厂函数”,形成三层嵌套函数体系:
- 第一层(工厂函数):接收装饰器自身的配置参数(例如重试次数、前缀等),返回第二层装饰器。
- 第二层(标准装饰器):接收被修饰的目标函数
func,返回第三层包装函数。 - 第三层(包装函数 wrapper):捕获前两层作用域中的配置参数与
func引用,执行前置/后置逻辑并调用原函数。
完整代码实现
import functools
import time

def retry(max_attempts=3, delay_seconds=0.1):
    """带参装饰器工厂:失败自动重试机制"""
    def decorator(func):
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            last_exception = None
            for attempt in range(1, max_attempts + 1):
                try:
                    return func(*args, **kwargs)
                except Exception as e:
                    last_exception = e
                    print(f"[警告] 第 {attempt} 次调用 {func.__name__} 失败: {e}")
                    if attempt < max_attempts:
                        time.sleep(delay_seconds)
            print(f"[错误] 达到最大重试次数 {max_attempts},最终失败")
            raise last_exception
        return wrapper
    return decorator

# 模拟一个前两次失败、第三次成功的远程网络调用
attempt_counter = 0

@retry(max_attempts=3, delay_seconds=0.05)
def fetch_api_data(url):
    global attempt_counter
    attempt_counter += 1
    if attempt_counter < 3:
        raise ConnectionResetError("网络连接暂时中断")
    return {"status": 200, "url": url, "data": "响应成功"}

# 执行调用
response = fetch_api_data("https://api.example.com/v1/data")
print("接口返回数据:", response)[警告] 第 2 次调用 fetch_api_data 失败: 网络连接暂时中断
接口返回数据: {'status': 200, 'url': 'https://api.example.com/v1/data', 'data': '响应成功'}
语法糖 @retry(max_attempts=3, delay_seconds=0.05) 的执行经历了两次函数调用:
# 第一步:执行外部工厂函数,传入参数,返回第二层的真实装饰器 decorator
real_decorator = retry(max_attempts=3, delay_seconds=0.05)

# 第二步:将真实装饰器作用于目标函数,返回第三层的包装函数 wrapper
fetch_api_data = real_decorator(fetch_api_data)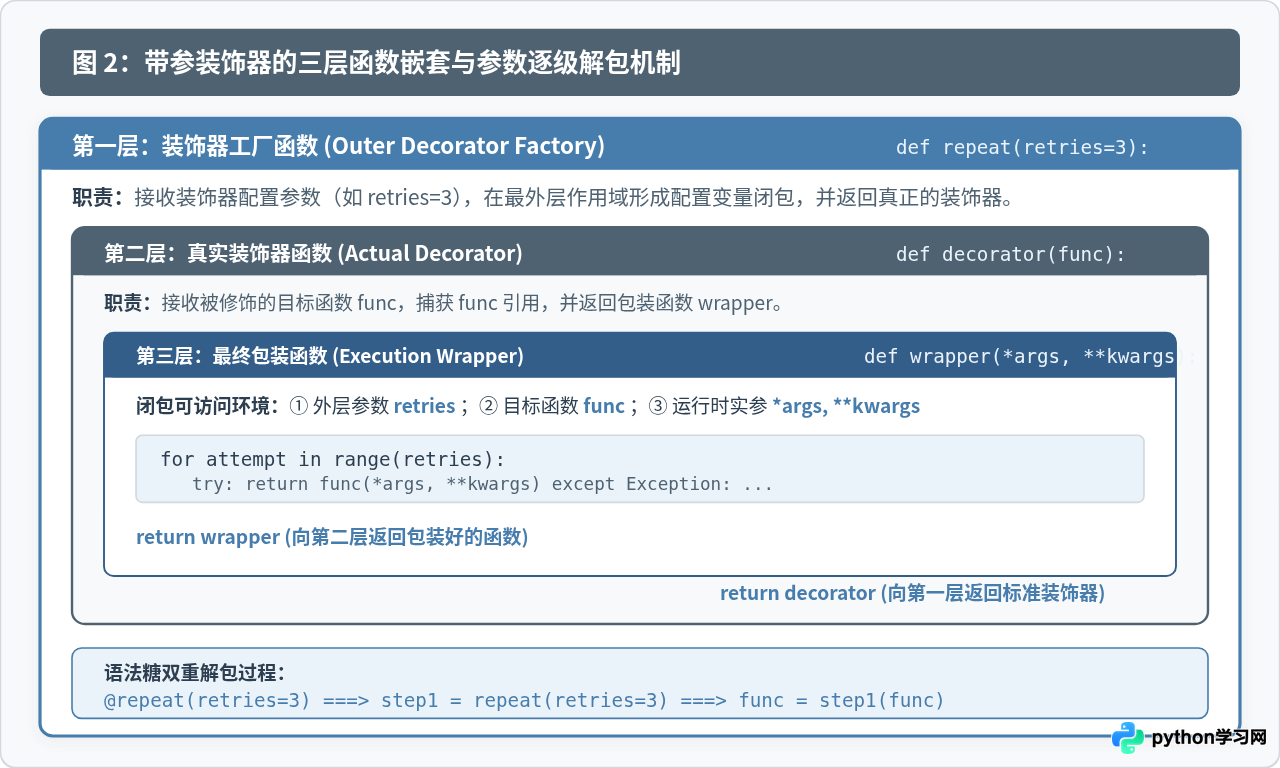
两种写法的核心代码对比与结构演进
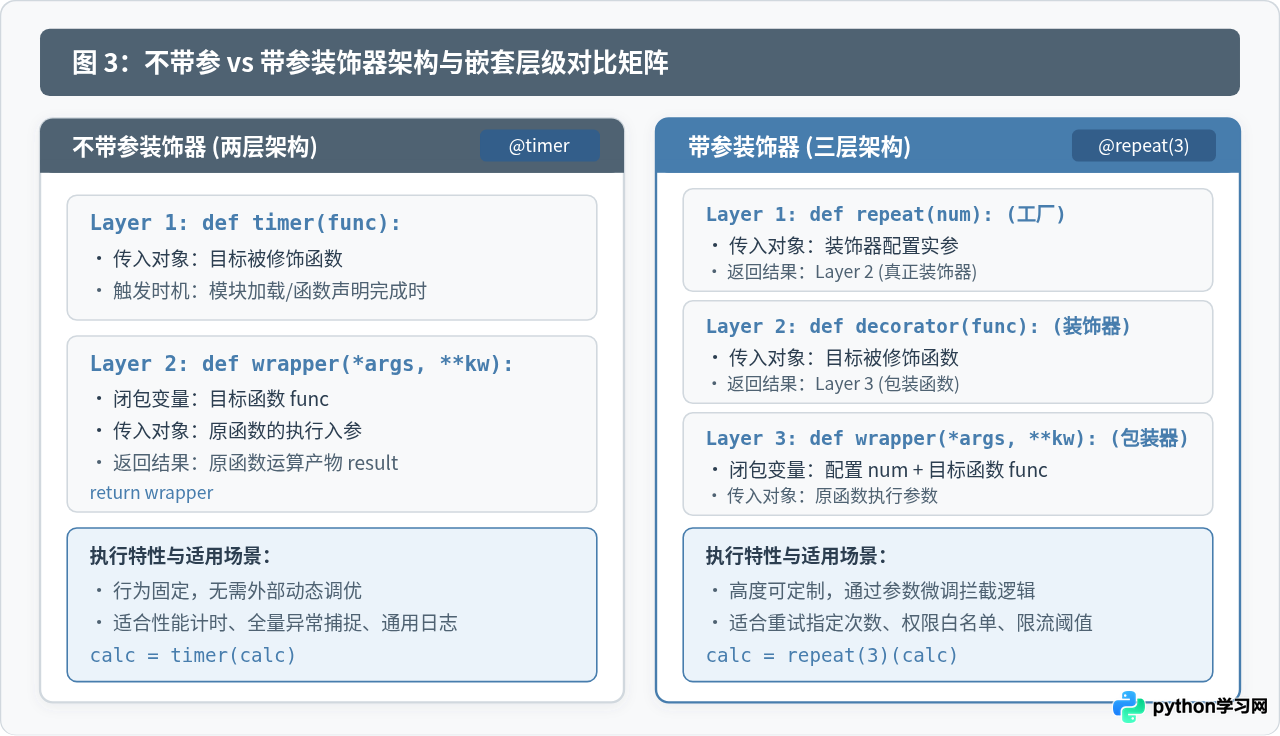
把两者的定义结构放在一起观察,可以发现两者的本质完全相同,带参写法仅仅是不带参写法在外部增加了一层返回装饰器的普通函数:
| 对比维度 | 不带参装饰器 | 带参装饰器 |
|---|---|---|
| 嵌套函数层数 | 2 层(decorator -> wrapper) |
3 层(factory -> decorator -> wrapper) |
| 语法糖使用形态 | @timer(不带小括号) |
@retry(max_attempts=3)(必须带小括号) |
| 最外层函数参数 | 接收被修饰的目标函数 func |
接收装饰器配置参数(如 retries, level) |
| 语法糖等价展开式 | func = timer(func) |
func = retry(3)(func) |
| 闭包捕获的内容 | 仅捕获 func |
同时捕获外部配置参数与 func |
| 典型适用场景 | 执行行为单一固定的通用拦截 | 根据不同业务函数需要灵活配置参数 |
编写装饰器的关键注意事项
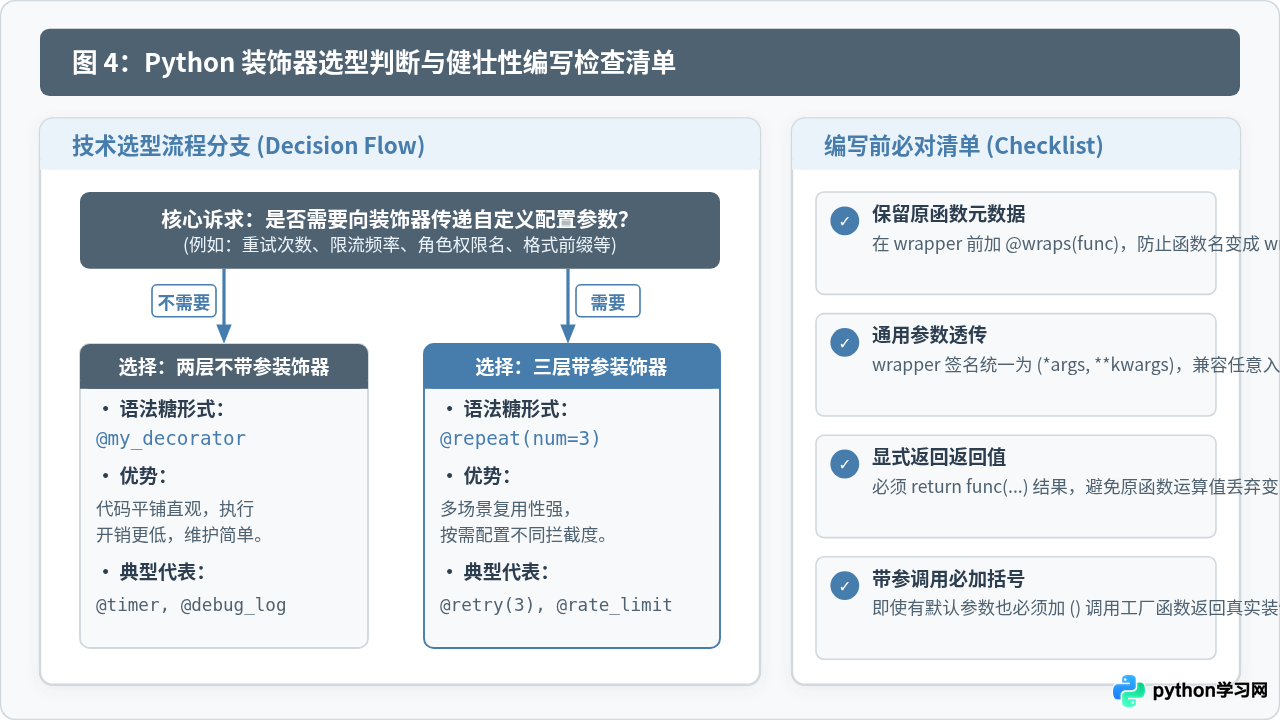
无论是编写两层还是三层装饰器,在实际工程代码中都需要遵守以下三条基本守则,避免产生隐蔽的生产环境缺陷:
1. 必须使用 @functools.wraps(func) 保留原函数元信息
在没有添加 @functools.wraps 时,原函数的 __name__ 会变成 "wrapper",函数文档 __doc__ 以及签名信息都会被内层函数覆盖。这会导致依赖反射、文档生成器(如 Sphinx)或单元测试框架识别函数名时产生严重混乱。只需在 wrapper 定义上方加上 @functools.wraps(func),就能自动将原函数的元属性复制到包装函数上。
2. 包装器参数与返回值的透传
内层 wrapper 签名必须声明为 (*args, **kwargs),并原封不动地传给 func(*args, **kwargs),以确保装饰器能够兼容无参、位置参数、关键字参数等任意签名的函数。此外,必须显式用变量接收 result = func(...) 并最终 return result。如果忘记 return,原函数的返回值在被装饰后将全部丢失并变成 None。
3. 带参装饰器“漏掉小括号”的经典报错
对于带参装饰器,哪怕工厂函数的所有参数都具有默认值,在使用语法糖时也必须带上小括号:
# 错误写法:如果 retry 定义了默认参数,但写成 @retry
@retry
def test():
    pass

# 正确写法:必须带括号触发工厂函数调用
@retry()
def test():
    pass
若漏写了括号,Python 会把 test 函数当成工厂函数的第一个参数 max_attempts 传入,随后在实际调用 test() 时抛出 TypeError: decorator() takes 1 positional argument but 0 were given 错误。
选型建议与总结
在实际开发中,先从简单的两层不带参装饰器开始编写。只有当出现多个业务函数需要共用类似逻辑,但个别阈值、开关或提示信息存在差异时,再在其外部包裹一层工厂函数,重构为带参装饰器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















