


Python argparse模块详解:怎么构建标准命令行解析器
深入详解 Python 标准库 argparse 模块,从解析流程、位置与选项参数、动作类型到多级子命令与工程架构,提供完整可落地的标准命令行解析器构建指南与避坑辨析。
在 Python 工具开发与工程脚本编写中,命令行接口(CLI)是程序与运维人员或自动化流水线交互的第一道桥梁。构建标准命令行解析器的核心路径,是借助 Python 内置的 argparse 模块,声明式地定义参数规格、数据类型、互斥约束与帮助说明,由解析器自动接管原始入参拆解、类型安全校验及退出码管控,最终交付结构化且类型完备的命名空间对象。
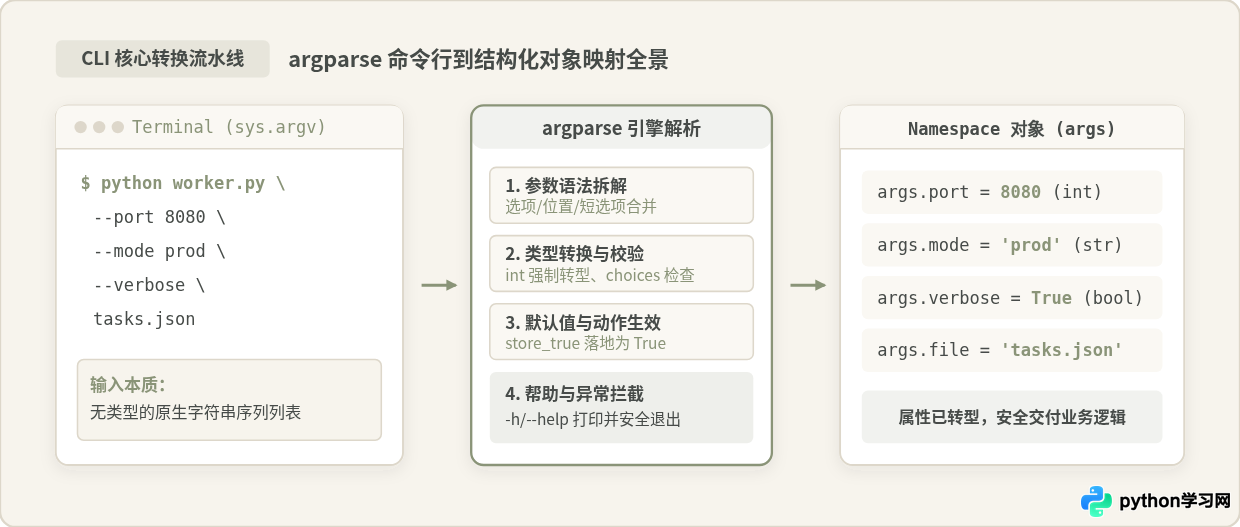
一、argparse 的核心解析流程与基础骨架
许多初学者编写脚本时习惯直接切片 sys.argv。这种做法在仅有一两个简单入参时看似轻巧,但一旦遇到选项无序传入、标志位合并、参数类型强制转换、缺少必填参数报错或生成 -h/--help 帮助手册等常见需求,手动编写字符串解析逻辑就会迅速失控,极易引发难以排查的越界和静默错误。
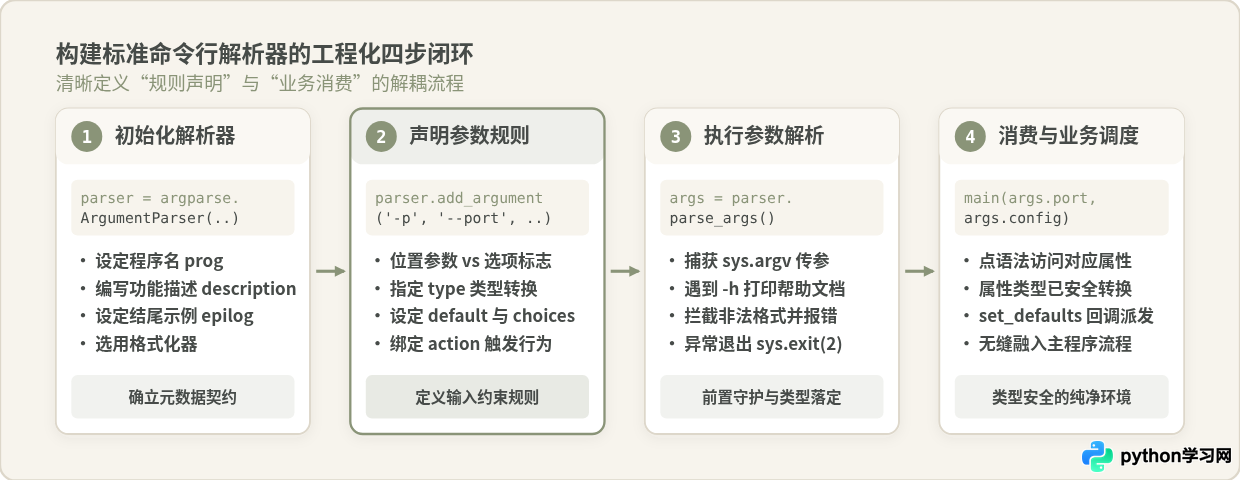
argparse 遵循典型的“声明-解析-派发”模式,构建一个标准的命令行工具通常固定由四个严谨步骤构成:
- 初始化解析器:实例化
argparse.ArgumentParser,注入命令名称、简要描述以及排版格式化类。 - 声明参数规格:通过
add_argument()显式指定参数名、长短选项、期望数据类型、默认回退值以及提示信息。 - 触发参数解析:调用
parser.parse_args()。此步骤内部自动读取sys.argv[1:],完成语义分析与类型校验。若遇到--help或非法入参,解析器会接管控制台输出并自动终止程序。 - 消费解析结果:以强类型属性形式直接访问
args.xxx,执行实际的业务逻辑分支。
以下为一个符合工业级标准的极简代码骨架。文件命名为 benchmark.py:
# benchmark.py
import argparse
import sys

def main():
    # 步骤 1:创建解析器并设定顶层元数据
    parser = argparse.ArgumentParser(
        prog="benchmark",
        description="用于服务性能压测与吞吐量评估的命令行工具",
        epilog="示例: python benchmark.py https://api.example.com -c 10 -n 1000 --verbose"
    )

    # 步骤 2:声明具体参数
    parser.add_argument("target_url", type=str, help="必填:待测试的目标服务 URL 地址")
    parser.add_argument("-c", "--concurrency", type=int, default=1, help="并发客户端数量 (默认: 1)")
    parser.add_argument("-n", "--requests", type=int, default=100, help="总请求数 (默认: 100)")
    parser.add_argument("-v", "--verbose", action="store_true", help="启用详细日志输出")

    # 步骤 3:执行解析
    args = parser.parse_args()

    # 步骤 4:消费结构化参数
    print(f"[执行任务] 目标: {args.target_url}")
    print(f"[参数配置] 并发: {args.concurrency}, 总量: {args.requests}, 调试: {args.verbose}")

if __name__ == "__main__":
    main()
我们在终端中分别执行查看帮助与正常调用的命令:
usage: benchmark [-h] [-c CONCURRENCY] [-n REQUESTS] [-v] target_url
用于服务性能压测与吞吐量评估的命令行工具
positional arguments:
target_url 必填:待测试的目标服务 URL 地址
options:
-h, --help show this help message and exit
-c, --concurrency 并发客户端数量 (默认: 1)
-n, --requests 总请求数 (默认: 100)
-v, --verbose 启用详细日志输出
示例: python benchmark.py https://api.example.com -c 10 -n 1000 --verbose
[执行任务] 目标: https://api.internal/health
[参数配置] 并发: 5, 总量: 500, 调试: True
二、参数类型与行为机制:从位置参数到开关标志
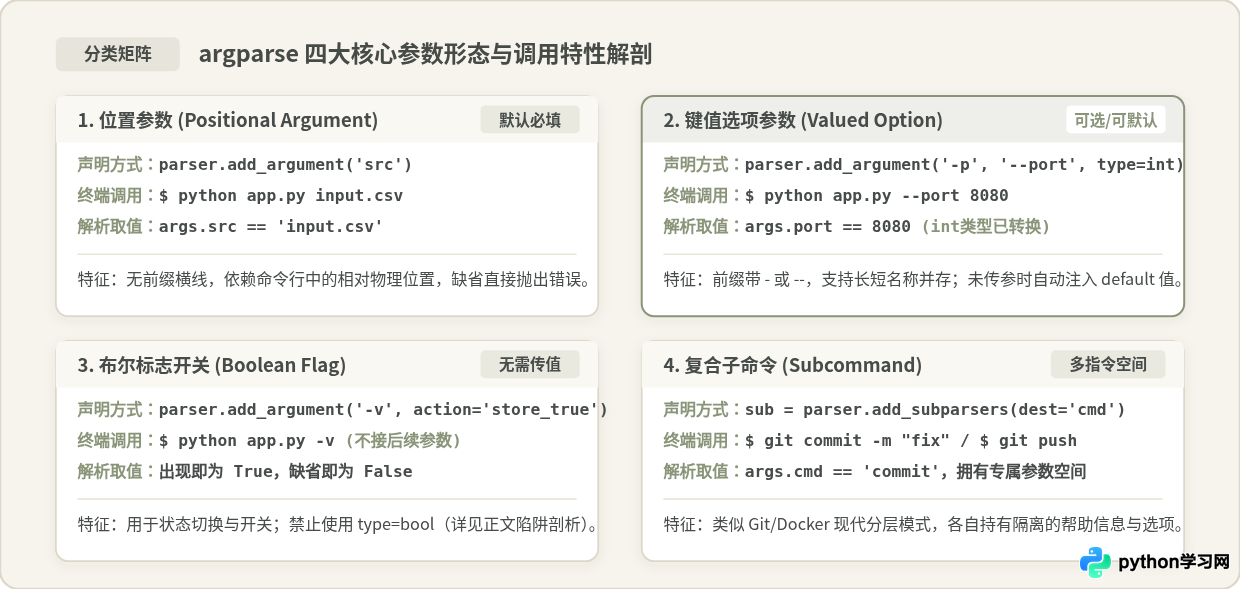
在设计 CLI 时,区分位置参数与选项参数是保证人机交互符合 POSIX 标准规范的前提。argparse 依据参数名称前缀是否有短横线(- 或 --)自动辨识其根本性质:
- 位置参数(Positional Argument):参数名称不以破折号开头(如
filename)。它们在命令行中按照声明先后顺序严格排列,默认不可省略。适用于指令处理的核心标的物,例如被复制的文件名或目标网址。 - 键值型选项(Valued Option):声明时以单个破折号(短选项如
-p)或双破折号(长选项如--port)开头,后方需要紧跟具体的输入值。通常支持default缺省值回退。 - 布尔标志开关(Boolean Flag):不需要在终端后方输入具体数值,仅仅通过标志的“出现与否”表达开关状态。通过
action="store_true"或action="store_false"控制。 - 集合与子命令(Subcommand):将整个应用切分为若干具有独立参数集合的子模式,如
docker run、docker build。
2.1 action 动作配置的常用形态
action 决定了当命令行解析器遇到该参数时,应当在返回的命名空间中执行怎样的操作。最常见且实用的动作包括:
| action 取值 | 典型声明示例 | 命令行调用示例 | 解析后生成的属性值 |
|---|---|---|---|
store (默认) |
parser.add_argument('--user') |
--user admin |
args.user = 'admin' |
store_true |
parser.add_argument('-d', '--debug', action='store_true') |
-d |
args.debug = True(未传时为 False) |
store_false |
parser.add_argument('--no-cache', dest='cache', action='store_false') |
--no-cache |
args.cache = False(未传时为 True) |
append |
parser.add_argument('-H', '--header', action='append') |
-H "A: 1" -H "B: 2" |
args.header = ['A: 1', 'B: 2'] |
count |
parser.add_argument('-v', '--verbose', action='count', default=0) |
-vvv |
args.verbose = 3(便于设置日志级别) |
2.2 类型约束与多值捕获(nargs)
默认情况下,命令行传入的一切值都是原始 str 字符串。通过 type= 可以指定类型转换函数,例如 type=int、type=float 甚至自定义校验函数。若输入内容无法完成转换,argparse 会立即打印格式错误并中断,避免脏数据流入下游代码。
当一个参数需要接收多个值时,使用 nargs 参数控制匹配数量:
nargs=N:严格接收 N 个参数,以列表存储(如nargs=2)。nargs='?':接收 0 个或 1 个参数,常用于带默认值的可选位置参数。nargs='*':接收 0 个或任意多个参数,收集为 Python 列表。nargs='+':至少需要 1 个参数,缺少则报错,收集为列表。
三、容易混淆的认知偏差与技术陷阱辨析
在实际使用 argparse 过程中,有几条流传广泛但存在隐患的写法。深入理解它们的局限性与成立条件,是编写高可靠 CLI 工具的关键环节。
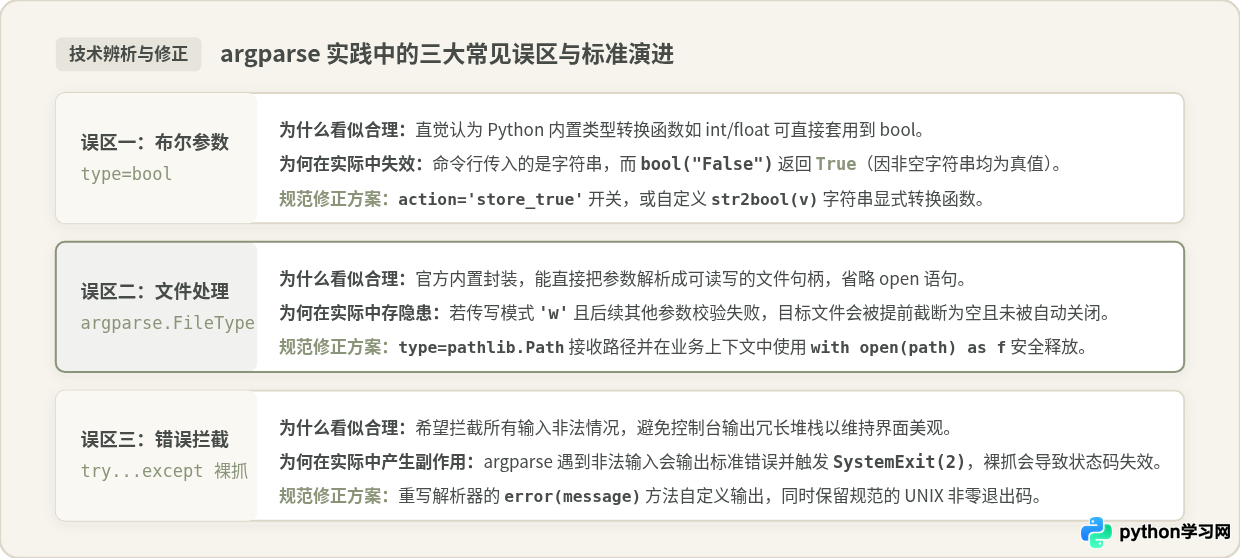
3.1 陷阱一:“布尔参数传 type=bool 就能解析真假”
表面直觉:既然 type=int 能把 "123" 转成整型 123,那么 parser.add_argument('--active', type=bool) 就应该能把 --active False 转换为 False。
在 Python 中,传入 type= 的对象本质是一个单参数转换函数。当用户在命令行执行 --active False 时,解析器实际执行的是内置函数 bool("False")。根据 Python 的语法语义,任何非空字符串经 bool() 转换后结果全部为 True!只有空字符串 bool("") 才是 False。因此无论用户传入 False 还是 0,都会被误判为 True。
工程规范修正:
- 如果属于二选一的开关状态,应当使用
action="store_true"。 - 如果必须明确显式传入
yes/no、true/false等字面量,应提供自定义类型转换函数:
def str2bool(value: str) -> bool:
    if isinstance(value, bool):
        return value
    val = value.lower().strip()
    if val in ("yes", "true", "t", "y", "1"):
        return True
    elif val in ("no", "false", "f", "n", "0"):
        return False
    else:
        raise argparse.ArgumentTypeError(f"无法识别的布尔值: '{value}',有效选项为 true/false")

# 正确声明显式布尔转换参数
parser.add_argument("--notify", type=str2bool, default=False, help="是否开启通知 (true/false)")
3.2 陷阱二:“直接使用 argparse.FileType 打开文件最便捷”
表面直觉:argparse.FileType('w') 可以在解析阶段直接返回已打开的文件对象,省去了脚本中手动 open() 的重复代码。
缺陷剖析:FileType('w') 会在参数解析刚完成时立即在文件系统创建或清空对应文件。如果命令行中后续的其他参数校验失败(例如同时传入了非法的整数端口号),解析器会直接报错退出,但此时目标文件已经被无辜清空,且该文件句柄在没有进入 with 语境的情况下无法得到保证关闭。
工程规范修正:推荐使用 pathlib.Path 校验并持有路径对象,在业务执行阶段通过上下文管理器显式打开:
from pathlib import Path

# 解析器仅负责路径封装与格式捕获
parser.add_argument("-o", "--output", type=Path, default=Path("result.txt"), help="输出文件路径")

args = parser.parse_args()

# 业务上下文安全管理资源
with open(args.output, "w", encoding="utf-8") as f:
    f.write("输出处理结果
")
3.3 陷阱三:“解析失败时用 try...except 裸抓 Exception”
许多开发者希望拦截所有的输入错误,在最外层包装 try: args = parser.parse_args() except Exception: ...。实际上,argparse 遇到非法参数时调用的是 sys.exit(2),抛出的是 SystemExit 异常而非派生自 Exception 的运行时错误。若用宽泛的 except BaseException 拦截并返回 0,会导致调用方脚本(如 CI/CD 流水线或 Makefile)误认为命令成功完成。
若需要自定义错误格式,正确做法是继承 ArgumentParser 并重写 error(self, message) 方法,在定制化打印的同时,严格保证退出状态码为 2。
四、进阶实战:构建生产级多级 CLI 架构
在大型工程或微服务管理工具中,单一命令往往无法满足需求。类似 git(具有 clone、commit、push)或 docker 的复合多级子命令架构才是行业标准。借助 argparse 的互斥组(Mutually Exclusive Group)与子解析器(Subparsers),可以清晰优雅地组织复杂系统的命令行交互。
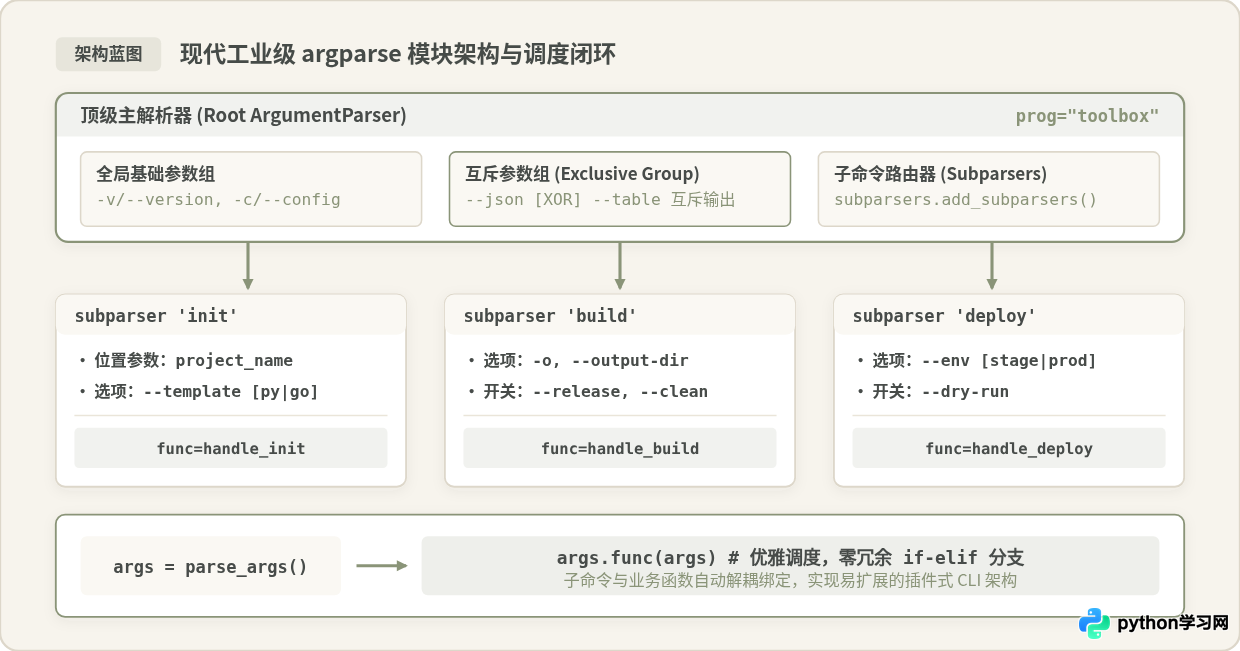
4.1 互斥参数组的设置
当两个参数在逻辑上无法同时存在(例如 --json 与 --table 互斥输出格式,或 --quiet 与 --verbose 互斥日志输出)时,使用 add_mutually_exclusive_group() 能够在参数解析阶段进行强约束:
group = parser.add_mutually_exclusive_group()
group.add_argument("--json", action="store_true", help="以 JSON 格式输出结果")
group.add_argument("--table", action="store_true", help="以美化表格形式输出结果")
4.2 子命令与基于 set_defaults 的无分发路由
很多实现子命令的脚本在解析后写满了又长又臭的 if args.command == 'init': ... elif args.command == 'build': ...。这种强耦合模式违背了开闭原则。业内推荐的优雅模式是使用 set_defaults(func=...),让每个子命令绑定各自的处理函数,解析完成后只需一行 args.func(args) 即可完成解耦派发。
下面是一个完整的、工业级多功能工程脚手架实战范例(toolkit.py):
# toolkit.py
import argparse
from pathlib import Path
import sys

def handle_create(args):
    """处理项目初始化业务"""
    print(f"[项目创建] 名称: {args.name}, 模板: {args.template}")
    target_dir = Path(args.name)
    if target_dir.exists():
        print(f"错误: 目录 {target_dir} 已存在", file=sys.stderr)
        return 1
    print(f"正在依据模板 [{args.template}] 创建项目结构...")
    return 0

def handle_deploy(args):
    """处理部署业务"""
    print(f"[服务部署] 环境: {args.env}, 镜像版本: {args.tag}, 演练模式: {args.dry_run}")
    if args.dry_run:
        print("[预检演练] 校验配置成功,未下发真实生产变更。")
    else:
        print(f"[实际操作] 正在向 {args.env} 环境推送版本 {args.tag}...")
    return 0

def build_parser() -> argparse.ArgumentParser:
    """构建并组装完整的命令行解析树"""
    # 顶级解析器
    parser = argparse.ArgumentParser(
        prog="toolkit",
        description="企业级微服务自动化运维管理套件",
        formatter_class=argparse.ArgumentDefaultsHelpFormatter
    )

    # 全局参数(所有子命令共享或顶级生效)
    parser.add_argument("-V", "--version", action="version", version="%(prog)s 2.4.0")
    parser.add_argument("-v", "--verbose", action="store_true", help="打印详细调试信息")

    # 创建子命令容器
    subparsers = parser.add_subparsers(
        title="可用子命令列表",
        dest="subcommand",
        metavar="<command>",
        required=True
    )

    # ---------------- 1. 子命令:create ----------------
    parser_create = subparsers.add_parser(
        "create",
        help="初始化一个新服务工程代码仓库",
        description="快速拉取标准工程脚手架并配置基础依赖"
    )
    parser_create.add_argument("name", type=str, help="新工程的目录名称")
    parser_create.add_argument(
        "-t", "--template",
        choices=["fastapi", "flask", "grpc"],
        default="fastapi",
        help="选择工程预设模板"
    )
    # 绑定回调函数
    parser_create.set_defaults(func=handle_create)

    # ---------------- 2. 子命令:deploy ----------------
    parser_deploy = subparsers.add_parser(
        "deploy",
        help="将构建产物部署到目标集群",
        description="向生产或测试环境集群发布版本镜像"
    )
    parser_deploy.add_argument(
        "-e", "--env",
        choices=["dev", "staging", "prod"],
        default="staging",
        help="发布的目标集群环境"
    )
    parser_deploy.add_argument(
        "--tag",
        type=str,
        required=True,
        help="需要部署的镜像版本标签 (必填)"
    )
    parser_deploy.add_argument(
        "--dry-run",
        action="store_true",
        help="仅演练预检,不触发真实发布"
    )
    # 绑定回调函数
    parser_deploy.set_defaults(func=handle_deploy)

    return parser

def main():
    parser = build_parser()
    args = parser.parse_args()

    # 一行代码优雅调度,无需冗长的 if-elif 链条
    exit_code = args.func(args)
    sys.exit(exit_code)

if __name__ == "__main__":
    main()
验证该生产级脚本的子命令帮助输出与调度表现:
usage: toolkit [-h] [-V] [-v] <command> ...
企业级微服务自动化运维管理套件
options:
-h, --help show this help message and exit
-V, --version show program's version number and exit
-v, --verbose 打印详细调试信息 (default: False)
可用子命令列表:
<command>
create 初始化一个新服务工程代码仓库
deploy 将构建产物部署到目标集群
[服务部署] 环境: prod, 镜像版本: v1.8.2, 演练模式: True
[预检演练] 校验配置成功,未下发真实生产变更。
五、自动化测试与工程最佳实践建议
为 CLI 工具编写单元测试是保障长期维护质量的核心环节。很多开发者误以为必须在单测中 mock sys.argv,这会增加测试夹具的复杂性。argparse 的设计本身就支持对参数列表进行直接测试:
# test_toolkit.py
import pytest
from toolkit import build_parser

def test_deploy_command_parsing():
    parser = build_parser()

    # 直接向 parse_args 传递列表,无需篡改全局 sys.argv
    args = parser.parse_args(["deploy", "--env", "prod", "--tag", "v2.0.0", "--dry-run"])

    assert args.subcommand == "deploy"
    assert args.env == "prod"
    assert args.tag == "v2.0.0"
    assert args.dry_run is True

def test_missing_required_tag():
    parser = build_parser()

    # 缺少必填参数 --tag 应触发 SystemExit(2)
    with pytest.raises(SystemExit) as exc_info:
        parser.parse_args(["deploy", "--env", "prod"])

    assert exc_info.value.code == 2
在交付命令行工具至生产环境时,遵循以下工程设计准则可显著提升使用体验:
- 保留标准帮助标志:切勿移除默认的
-h/--help,确保用户随时能查看当前指令树的正确用法。 - 长短选项协同:常用参数提供简短字母选项(如
-p),同时务必保留具备自我解释性的长选项(如--port),便于在 Shell 脚本中保持可读性。 - 严格遵守 UNIX 退出码惯例:命令成功执行完毕返回
0;参数解析失败由argparse规范返回2;业务内部执行逻辑异常时返回非零状态码(如1)。 - 语义化 formatters:当帮助文档中包含代码样例或预设换行排版时,指定
formatter_class=argparse.RawDescriptionHelpFormatter,避免原生解析器将多行示例压缩为单行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















