


Python开发中何时选择元组而非列表或命名元组
深入解析在Python开发中何时选择元组(tuple)而非列表(list)或命名元组(namedtuple)。从语义定位、内存机制、哈希特性到实际工程场景,提供清晰的选型标准与决策流程。
一、核心定位与三者的本质差异
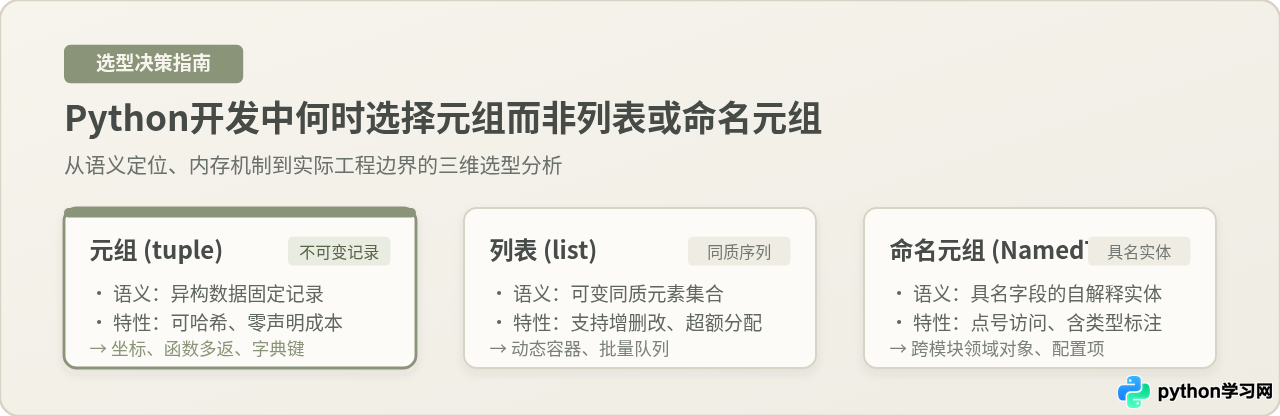
Python初学者常听到一种简化说法:“元组就是不能修改的列表”。这种说法虽然直观指出了两者在可变性上的表层差异,却掩盖了Python标准库对三种容器类型的顶层语义设计。在编写高质量、易维护的Python代码时,选型的第一步是识别数据本身的领域概念:
- 列表 (list):同质序列 (Homogeneous Sequence)。设计用于容纳数量不固定、概念相同的元素集合。例如一组用户ID
[101, 102, 103]或待处理的任务队列。列表中的元素顺序通常代表处理先后或排序结果,且支持原地的增加、删除、排序等动态变更。 - 标准元组 (tuple):定长异构记录 (Heterogeneous Record)。设计用于封装一组字段各异、结构固定的数据项。例如一个二维平面坐标
(x, y)、网络监听地址("127.0.0.1", 8080)或数据库单行结果。元组的每一位位置索引对应一个具体的属性含义,其长度在创建后完全锁定。 - 命名元组 (NamedTuple):具备自解释属性的轻量实体 (Named Entity)。当记录内部的字段数量增多(通常大于等于3项),位置索引容易引发记忆混淆,且该数据需要跨越函数或模块进行远距离传递时,命名元组通过赋予每个槽位显式的名称,兼顾了元组的内存紧凑性与面向对象属性访问的可读性。
二、元组 vs 列表:为什么不仅是“不可变”的区别?
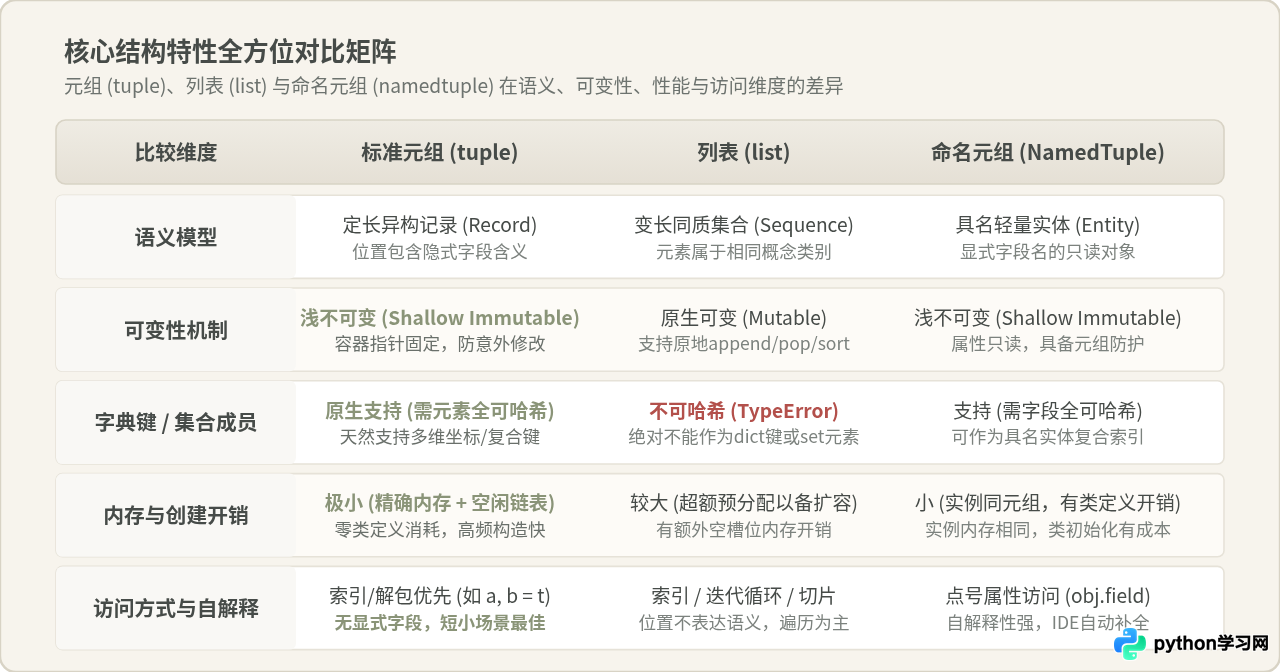
很多开发者容易混淆元组与列表的适用边界。当不需要修改数据时,是否随意使用哪一个都可以?答案是否定的。除了语义上的“记录”与“集合”差异外,语言底层在哈希支持、内存布局和生命周期管理上存在决定性的区别。
1. 可哈希性与字典键/集合元素
Python中的字典(dict)和集合(set)依赖哈希表实现 \(O(1)\) 的键查找。为了保证哈希表的数据一致性,凡是作为键的对象必须实现稳定的 __hash__() 并在生命周期内保持哈希值恒定。
因为列表是可变容器,其内容随时可能通过 append() 或原地修改而改变,若允许其作为键,将直接破坏哈希表的槽位映射,因此列表没有实现哈希协议。尝试对列表求哈希会直接抛出运行时异常:
# 列表无法作为字典键或集合元素
point_list = [10, 20]
try:
    grid = {point_list: "target"}
except TypeError as e:
    print("错误提示:", e)  # 输出: unhashable type: 'list'

# 元组天生支持作为复合键
point_tuple = (10, 20)
grid = {point_tuple: "target"}
print(grid[(10, 20)])  # 输出: target
在实现多维网格索引、缓存多参数函数的返回值(如 functools.lru_cache 内部的调用参数封装)、或表示符合联合主键的数据映射时,标准元组是唯一且天然合法的内置容器选择。
2. 辨析与修正:“元组就是不可变的列表”?
看似合理的直觉:既然元组不支持 t[0] = 99 也不支持 append,那么它就是一个绝对安全的不可变列表。
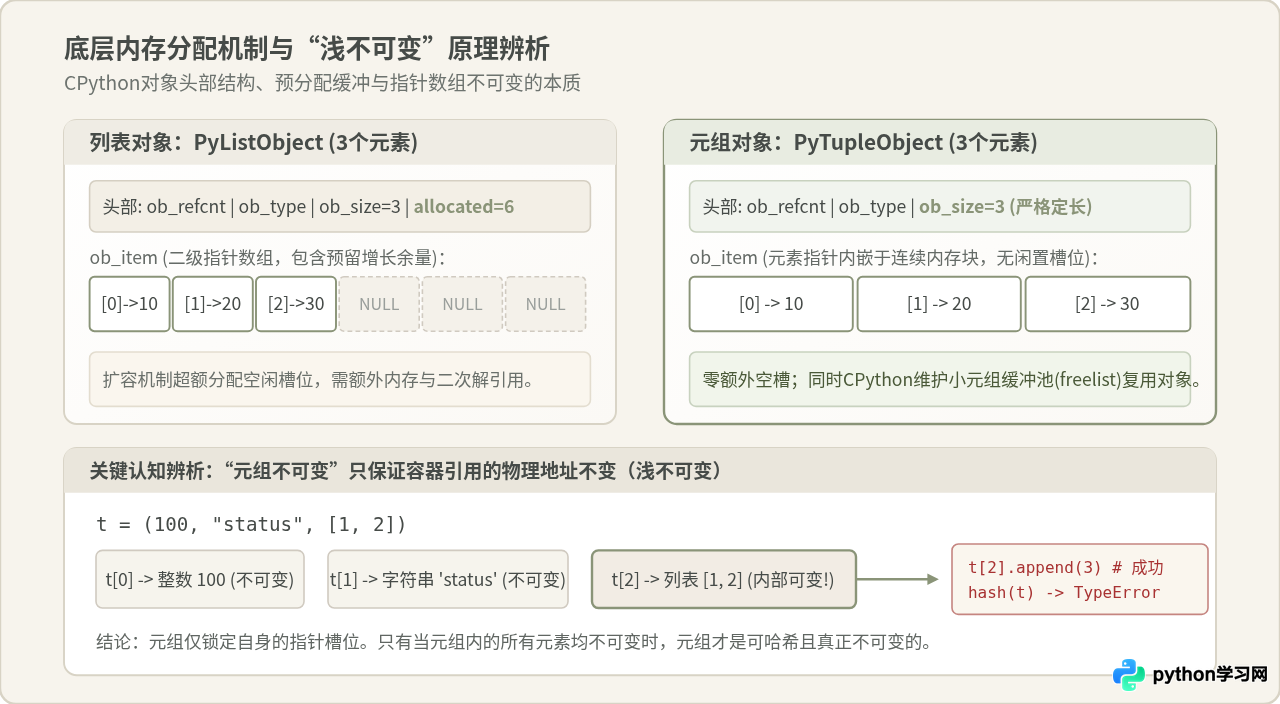
需要修正的边界:元组的“不可变”属于浅不可变(Shallow Immutability)。元组本身所维护的仅仅是一个指向各元素对象的指针数组。元组的不可变性保证了这组指针的内存地址不可替换,但并不阻止指针所指向的对象发生内部变更。
当元组内部包含了可变对象(例如列表、字典或集合)时,元组的状态同样可能发生变化,并且该元组将失去可哈希性:
# 元组包含可变对象时的行为演示
item = (1, "ok", [10, 20])

# 尝试直接修改元组槽位引用:报错
try:
    item[2] = [30, 40]
except TypeError as e:
    print("无法修改槽位指针:", e)

# 修改槽位指向的列表内部状态:完全合法
item[2].append(30)
print("修改后的元组:", item)  # 输出: (1, 'ok', [10, 20, 30])

# 此时尝试对该元组求哈希:报错
try:
    hash(item)
except TypeError as e:
    print("浅不可变导致哈希失效:", e)  # 输出: unhashable type: 'list'
因此,在选择元组作为不可变记录或字典键时,必须确保其包含的每一项元素自身也是不可变的(如数字、字符串、布尔值或纯净的嵌套元组)。
3. 底层内存分配与对象缓冲优化
从CPython虚拟机实现角度来看,列表与元组的内存开销与构造机制有很大差异:
- 列表的超额预分配(Over-allocation):为了避免每次
append()都触发昂贵的系统内存重新分配与内存拷贝,CPython的PyListObject会预留额外的空闲槽位(allocated容量大于当前实际size)。即使是已知包含固定数量元素的列表,也会占用更多的堆内存空间。 - 元组的紧凑分配:元组长度在创建时已经固定,CPython在为其分配
PyTupleObject结构体时,根据元素数量精确分配内存,不存在闲置指针槽位。 - 空闲对象链表(Freelists):为了加速小对象的回收与重复创建,CPython为长度在 1 到 20 之间的元组维护了全局缓冲池(free lists)。当短小元组被销毁时,其所占用的内存块不会立即归还给系统堆,而是缓存在链表中,下次创建同等长度的元组时可直接复用,从而大幅度降低了高频场景下的GC与内存分配开销。
三、元组 vs 命名元组:何时无需引入字段名?
在明确不需要使用列表之后,开发者常面临第二个抉择:既然标准库 collections.namedtuple 和 typing.NamedTuple 提供了可以通过点号访问属性(如 user.name)的优势,为什么不全面淘汰普通元组?
答案在于:字段名并非完全免费的抽象,它带来了类定义的认知成本、代码体积和运行期微小开销。在很多典型开发环节中,标准元组反而更加轻盈、直接且契合Python惯用法。
1. 函数的多值返回与就地解包
Python最优雅的特性之一就是函数可以返回逗号分隔的多个值,其底层正是自动打包成标准元组。如果返回值的数量很少(2至3个),且调用的上下文能够立即通过解包进行消费,引入命名元组是过度设计的:
# 推荐:返回简单元组并立即解包
def get_min_max(numbers: list[float]) -> tuple[float, float]:
    return min(numbers), max(numbers)

# 调用方就地解包,语法清晰自然,零额外声明成本
low, high = get_min_max([3.2, 1.5, 7.8, 4.0])
对于像标准库中的 divmod(a, b) 返回 (商, 余数),或字典迭代 for key, val in mapping.items(),使用位置明确的2元组是整个Python生态公认的标准范式。如果为每一个短小函数都专门使用 NamedTuple 声明一个返回类型类,不仅会污染模块命名空间,还会迫使读者在阅读业务逻辑前先阅读大量的样板结构定义。
2. 瞬时内部数据传递与零定义负担
在函数内部进行聚合计算、中间结果临时打包或排序时,标准元组具备即用即走的优势。例如利用元组的默认字典序进行复杂字段的多键排序:
# 依据 (优先级降序, 时间升序) 对任务进行排序
tasks = [
    {"id": 101, "priority": 2, "timestamp": 1600000},
    {"id": 102, "priority": 1, "timestamp": 1500000},
    {"id": 103, "priority": 2, "timestamp": 1400000},
]

# 在 key 函数中就地生成元组作为复合比较键
tasks.sort(key=lambda t: (-t["priority"], t["timestamp"]))
在此类即时排序或局部筛选中,生成一个临时元组 (-t["priority"], t["timestamp"]) 极为迅捷。若为了这个局部辅助计算去定义一个 SortKey 命名元组,不仅代码冗长,还会破坏代码的紧凑度。
3. 底层协议与驱动参数绑定的标准接口
在与底层系统调用、C扩展或数据库API(Python DB-API 2.0,如 sqlite3, psycopg2)交互时,标准元组是官方指定的参数容器类型。数据库驱动依靠严格的位置参数绑定占位符:
import sqlite3

conn = sqlite3.connect(":memory:")
cursor = conn.cursor()
cursor.execute("CREATE TABLE users (id INT, name TEXT)")

# DB-API 严格约定传入标准元组用于参数化查询(防SQL注入)
user_data = (1, "Alice")
cursor.execute("INSERT INTO users VALUES (?, ?)", user_data)

# 单参数时同样必须传递包含尾随逗号的单元素元组
cursor.execute("SELECT name FROM users WHERE id = ?", (1,))
在此场景下,传入 NamedTuple 虽然在技术上因其继承自 tuple 通常也能执行,但由于驱动完全不依赖也不解析任何字段名称,额外的字段映射毫无意义。
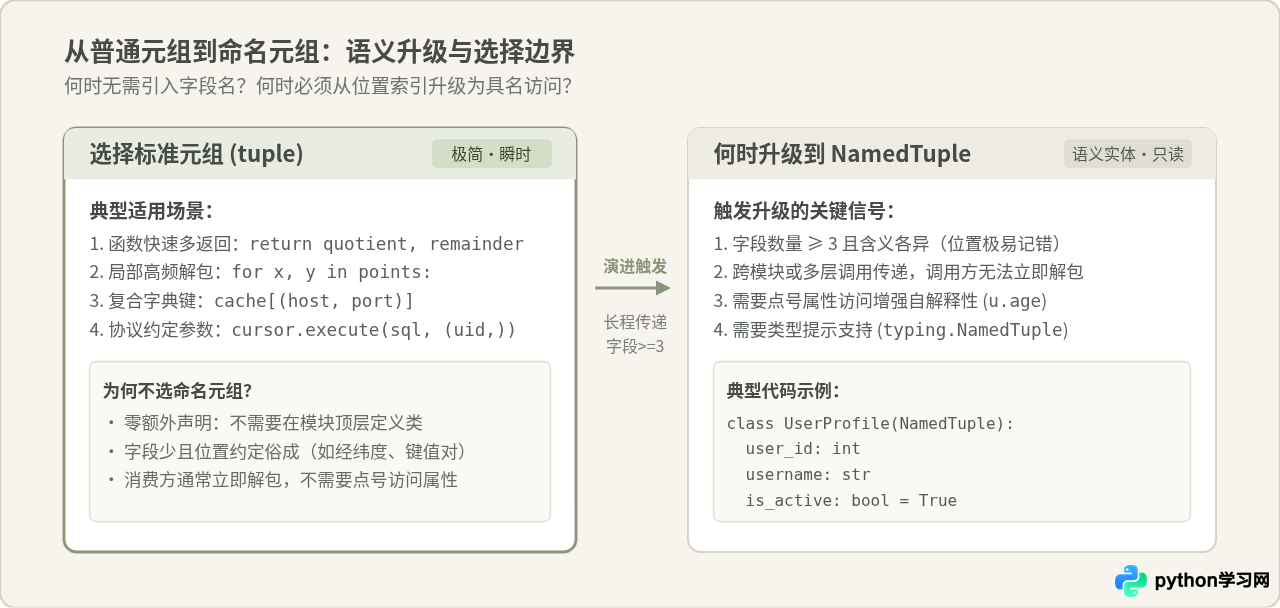
四、开发实战:何时坚决选择元组,何时坚决放弃?
为了在实际工程中做出毫不犹豫的决策,我们可以将常见开发场景归纳为正向选择范式与反向警告信号:
1. 正向推荐:坚决选择标准元组的典型场景
- 多维坐标与离散几何位置:如
coord = (x, y)或rgb = (255, 128, 0)。此类数据结构维度极小(2~3项),各分量含义在几何或图像学中高度标准化,位置对应关系深入人心。 - 复合缓存键与状态快照:在使用内存缓存机制时,需要将多个入参序列化为键:
cache_key = (tenant_id, user_role, permission_code)。由于必须满足可哈希性且仅在内部匹配使用,元组是标准解法。 - 防御性只读配置参数:当向第三方模块或多线程环境暴露一组全局配置选项(如
ALLOWED_EXTENSIONS = ('.jpg', '.png', '.gif'))时,使用元组能从语法层防御调用方误调用append()导致意外篡改全局状态。
2. 反向警告:何时坚决不应使用标准元组?
一旦元组的元素超过3项,且需要跨越多个函数或跨模块长距离传递,代码中便会出现大量神秘的数字索引:result[3]、user_info[5]。这种写法极度脆弱,只要上游稍作修改增加了一个中间字段,所有下游调用的数字下标全部发生错位,导致极其隐蔽的数据错误。
# 反模式:跨模块传递包含过多字段的普通元组
# 外部调用者必须猜测每个索引代表什么,极易出错
def fetch_employee_record(emp_id: int) -> tuple:
    return (emp_id, "Bob", 32, "Engineering", "Senior Dev", 95000.0)

record = fetch_employee_record(1024)
# 脆弱的消费代码:很难看出 record[4] 和 record[5] 分别代表岗位还是薪资
bonus = record[5] * 0.1

# 正确重构:升级为 typing.NamedTuple
from typing import NamedTuple

class EmployeeRecord(NamedTuple):
    emp_id: int
    name: str
    age: int
    department: str
    role: str
    salary: float

def fetch_employee_record_typed(emp_id: int) -> EmployeeRecord:
    return EmployeeRecord(emp_id, "Bob", 32, "Engineering", "Senior Dev", 95000.0)

emp = fetch_employee_record_typed(1024)
# 具备极高自解释性,且享受IDE代码补全与mypy静态检查
bonus = emp.salary * 0.1
五、选型决策路径与速查指南
面对具体业务场景中的数据容器选择,可以按照以下递进步骤进行判断:
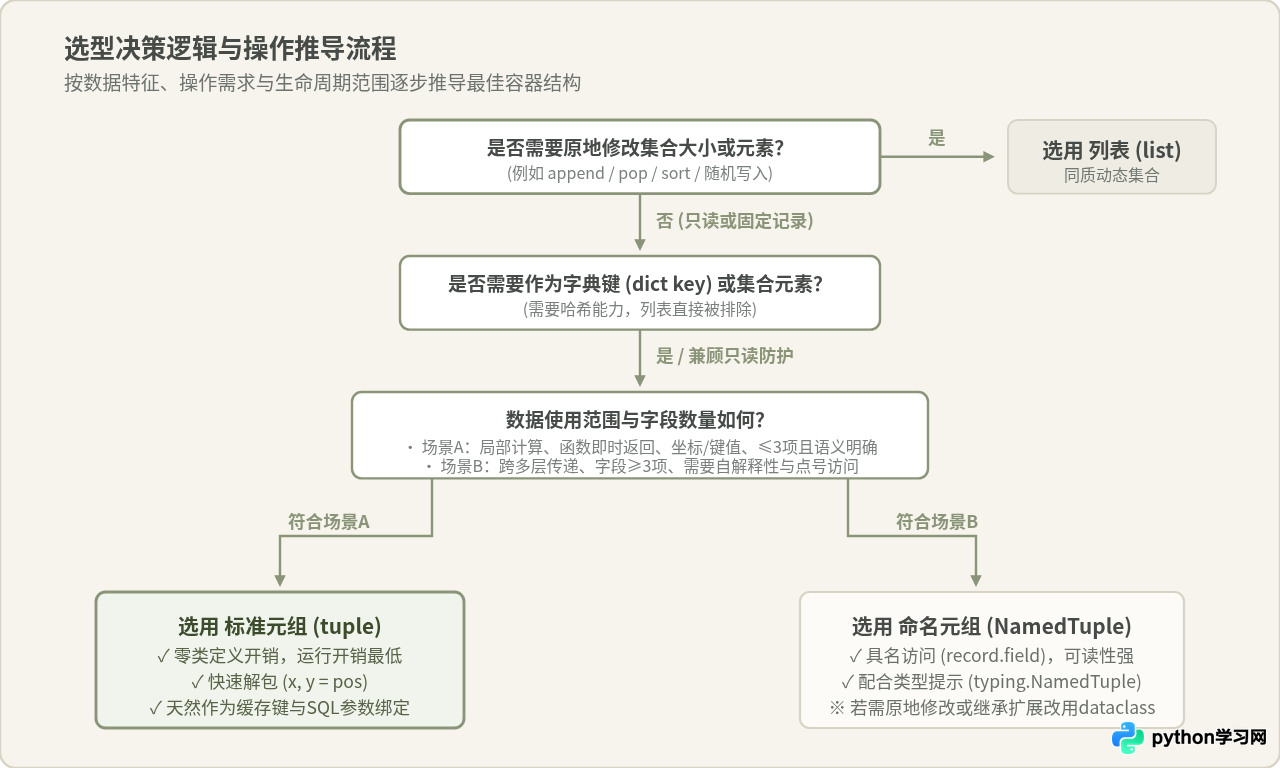
| 决策判断问题 | 回答为“是” | 回答为“否” |
|---|---|---|
| 数据元素集合是否需要在运行期动态增删改查或重排序? | 选择 列表 (list) | 进入下一项判断 |
容器是否必须作为 dict 的键或 set 的元素? |
坚决排除列表,必须使用元组(或字段全不可变的命名元组) | 继续评估数据可读性需求 |
| 数据项是否超过3个,或者需要在跨模块长链路中多次被不同方法读取? | 选择 命名元组 (NamedTuple)(若需复杂行为可考虑 dataclass) |
进入下一项判断 |
| 数据是否属于坐标、函数多返值、键值对、即时排序键或DBAPI参数? | 坚决选择 标准元组 (tuple):享受零样板代码与最低开销 | 视业务实体化需求决定 |
六、总结
Python标准库提供的每一种数据结构都有其深思熟虑的定位。在Python开发中,何时选择元组而非列表或命名元组,可以概括为三条原则:
- 同质动态用列表:面对一批同一类型的实体集合,随时需要追加、剔除或改变顺序时,列表是不二之选;
- 异构短小用元组:面对字段少(≤3项)、位置语义明确、多用于立即解包或作为复合哈希键的瞬时记录,标准元组能以零定义负担提供最高的执行效率与浅不可变安全防护;
- 复杂跨层上命名元组:一旦记录演化为具有4个以上属性的领域实体,或者需要作为公共API向外暴露时,果断从标准元组演进至
NamedTuple,以代码自解释性换取更强的可维护性。
遵循这套选型逻辑,不仅能让你的Python代码结构更符合Pythonic风格,也能在内存占用、运行速度与代码可读性之间取得最佳平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















