


怎么用Python提高图片文字识别准确率?图像预处理与PaddleOCR调优技巧
针对图片文字识别中的漏检、粘连、误识与模糊问题,本文详细解析如何结合OpenCV图像预处理与PaddleOCR核心检测/识别参数调优,构建高准确率的Python文字识别方案。
一、文字识别的端到端质量闭环
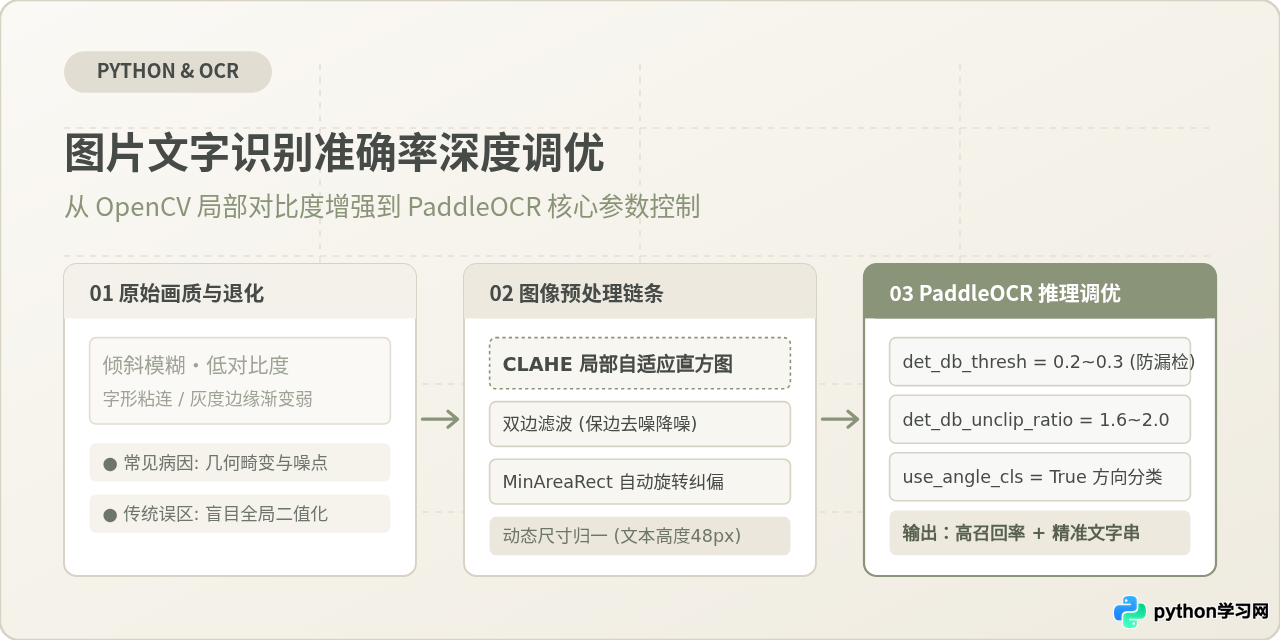
常规的 OCR 流程由两个相互依赖的神经网络级联而成:负责定位文字区域的文本检测器(Detection,如 DBNet),以及负责将裁剪出的文本条切片并转录为字符序列的文本识别器(Recognition,如 SVTR 或 CRNN)。识别器对检测器的切框边界高度敏感:一旦检测框切掉了字符的首尾笔画,或者将上下两行紧凑的文字合并为一个单框,识别阶段必然产生不可逆的语义错乱。
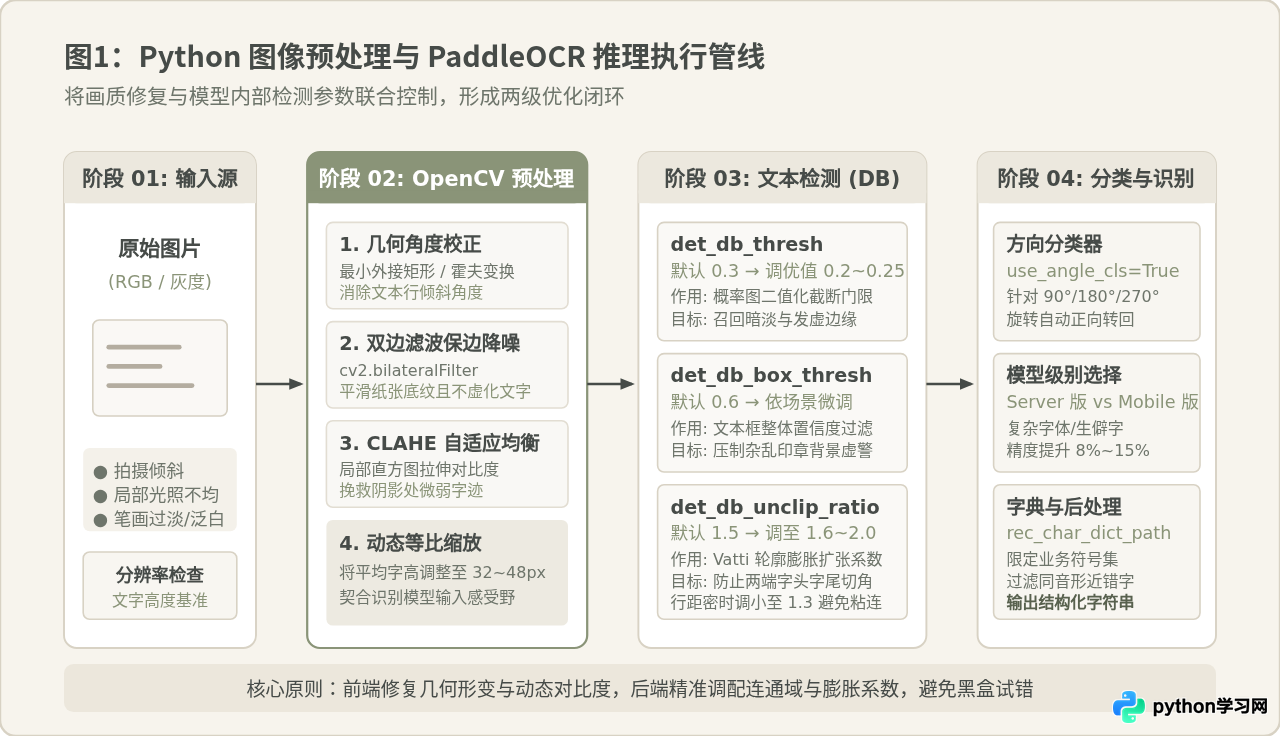
因此,提高准确率的工作必须遵循统一的处理链路:先在输入端纠正几何倾斜、平衡局部动态对比度,再通过调整检测参数使预测出的多边形精准贴合文字边缘,最后根据业务词汇特点约束输出字符集。
二、图像预处理的针对性手段与常见认知误区
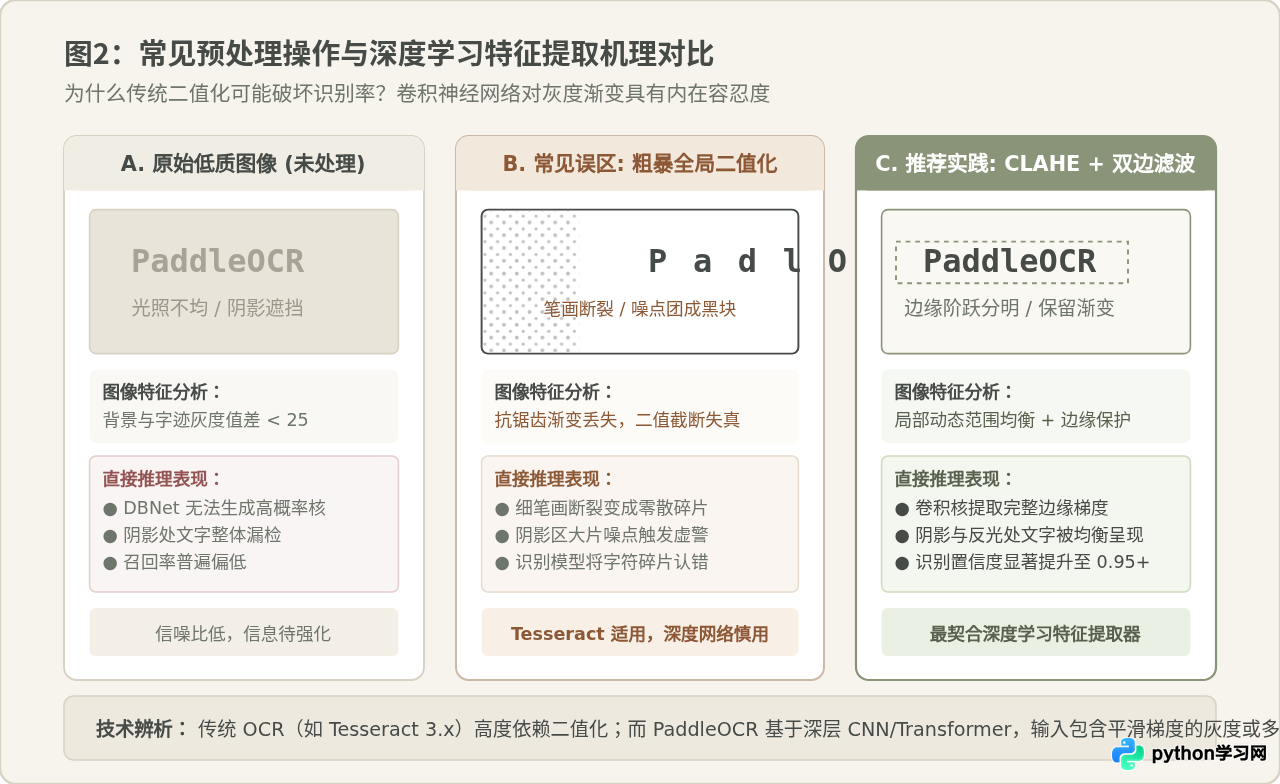
在传统基于 Tesseract 等规则模板匹配的 OCR 时代,全局二值化(如固定阈值或全局 Otsu 算法)被视为标准前置动作。然而,现代基于深度卷积与注意力机制的 OCR 算法对图像灰度的渐变信息有着天然的特征提取能力。
全局二值化假设整张图片具有明确的双峰直方图分布。但在拍照采集中,常伴随阴影遮挡、纸张反光与油墨渗透。强制二值化会将连续的边缘灰度抗锯齿信息全部抹去,导致较细的汉字笔画断开成孤立像素点,阴影区域则因被判定为黑块而产生大面积椒盐噪声。对于 PaddleOCR,保留边缘渐变的灰度图或高对比度图像,其识别表现远好于粗暴的二值黑白图。
有效的图像预处理应聚焦在以下四个具有明确数学物理意义的步骤上:
1. 尺度归一与双三次插值重采样
PaddleOCR 识别模型的标准输入高度一般为 48 像素(如 PP-OCRv4 文本行识别默认尺寸为 3, 48, 320)。如果原始图片中的字符高度低于 15 像素,文本特征在卷积下采样后将退化为无序响应;反之,若原图为几千万像素的超高分辨率扫描件,不仅单图推理耗时大幅增加,检测模型也会因为局部字号过大而超出感受野范畴,把单个大字拆散为多个部首框。将待测图缩放至文字平均高度处于 32~48 像素 是最具性价比的基准尺度。
2. CLAHE 限制对比度自适应直方图均衡
对于发票、票据、暗光照片,文字常与灰黄色底纹混杂在一起。常规的全局直方图均衡化会过度放大背景噪点,而 CLAHE(Contrast Limited Adaptive Histogram Equalization)将图像拆分为若干互不重叠的小网格(如 8×8),在各网格内部进行直方图均衡,并通过设置对比度裁剪阈值(Clip Limit)防止背景微弱噪声被无限制抬高。
3. 双边滤波保边降噪
标准的高斯滤波虽然能抹除纸张粗糙纹理,但同时也会模糊汉字笔画的边缘阶跃。双边滤波(cv2.bilateralFilter)在计算空间距离权重的同时,引入了像素灰度差值权重,只有灰度相近的相邻像素才参与加权平滑。这使得纸张底纹被抚平的同时,字符边缘的高频跃变依然得到完整保留。
4. 倾斜纠偏(Deskewing)
虽然 PaddleOCR 支持倾斜文本检测,但文本行的水平状态最符合其识别模型在训练时的主分布。如果整张文档具有普遍倾斜,通过轮廓最小外接矩形或霍夫变换测定主偏角,并执行旋转仿射变换,能够显著减轻检测器拟合任意旋转四边形的负担。
# -*- coding: utf-8 -*-
import cv2
import numpy as np

def preprocess_image_for_ocr(image_path: str, target_char_height: int = 40) -> np.ndarray:
    """
    为深度学习 OCR 管道打造的保边自适应预处理函数
    """
    # 1. 规范读取与通道处理
    src = cv2.imread(image_path)
    if src is None:
        raise FileNotFoundError(f"无法读取图片文件: {image_path}")

    gray = cv2.cvtColor(src, cv2.COLOR_BGR2GRAY)

    # 2. 估计主倾斜角度并进行几何纠偏
    coords = np.column_stack(np.where(gray < 200))
    if len(coords) > 100:
        rect = cv2.minAreaRect(coords)
        angle = rect[-1]
        # 规整化角度至 [-45, 45] 度区间
        if angle < -45:
            angle = -(90 + angle)
        else:
            angle = -angle

        # 仅对微倾斜(1~30度)执行仿射校正,过大角度交由 angle_cls 模型
        if 1.0 < abs(angle) < 30.0:
            h, w = gray.shape[:2]
            center = (w // 2, h // 2)
            M = cv2.getRotationMatrix2D(center, angle, 1.0)
            gray = cv2.warpAffine(gray, M, (w, h), flags=cv2.INTER_CUBIC, borderMode=cv2.BORDER_REPLICATE)

    # 3. 双边滤波消除微弱底纹噪点并保护字形边缘
    denoised = cv2.bilateralFilter(gray, d=7, sigmaColor=50, sigmaSpace=50)

    # 4. CLAHE 局部动态对比度增强
    clahe = cv2.createCLAHE(clipLimit=2.5, tileGridSize=(8, 8))
    enhanced = clahe.apply(denoised)

    # 5. 适度轻量锐化(使用反锐化掩膜提升笔画轮廓)
    gaussian_blur = cv2.GaussianBlur(enhanced, (0, 0), sigmaX=2.0)
    sharpened = cv2.addWeighted(enhanced, 1.3, gaussian_blur, -0.3, 0)

    return sharpened
三、PaddleOCR 核心检测与识别参数深度调优
图像送入 PaddleOCR 后,其核心检测模型 DBNet(Differentiable Binarization)通过预测概率图、阈值图,再利用微分二值化提取连通域多边形。默认参数是为了在通用自然场景(包含招牌、海报、复杂背景)中取得平衡,而在票据、合同扫描、代码截屏等特定工业场景下,直接套用默认参数往往导致不必要的失误。
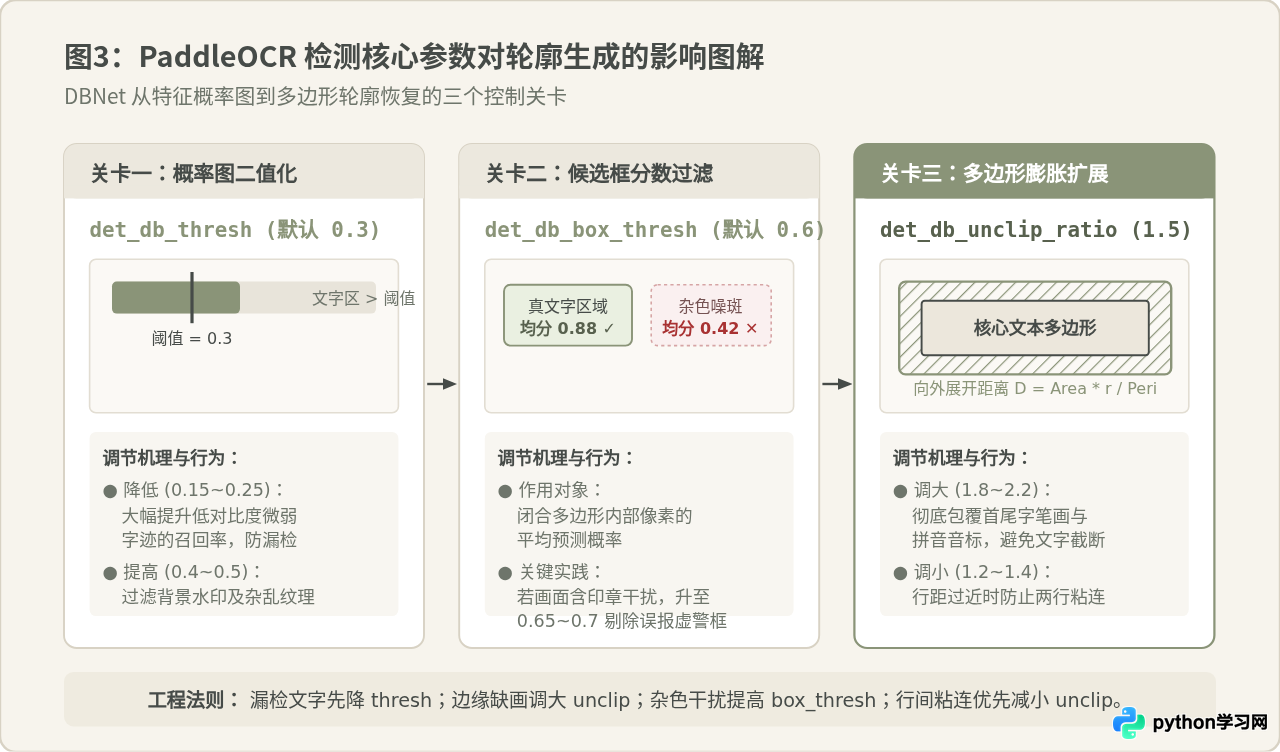
1. det_db_thresh:概率图门限(默认 0.3)
DBNet 会输出一个与原图同比例的浮点概率图(数值在 0~1 之间),代表每个像素属于文字核心区域的概率。det_db_thresh 决定了多大数值的像素可以被划入“文字核候选区域”。
- 调小(0.15 ~ 0.25):如果你的票据打印较淡、热敏纸受热褪色,文字中心概率往往无法达到 0.3。调小该值可以召回暗淡微弱的字迹。
- 调大(0.4 ~ 0.5):如果底纹有复杂的装饰花纹、水印或公章底色,容易被误检为文字,调大该阈值可大幅压制背景误检。
2. det_db_box_thresh:候选框平均分阈值(默认 0.6)
即使像素通过了 det_db_thresh 聚类成闭合轮廓,PaddleOCR 还会计算该轮廓内部所有像素概率值的算术平均分。如果平均分低于 det_db_box_thresh,整个框会被视作偶发噪点直接丢弃。
对于文字密集清晰但背景偶有斑点的图像,将此参数提升至 0.65~0.7,可以干净利落地剔除大部分小块噪点框,避免下游识别无意义的标点乱码。
3. det_db_unclip_ratio:轮廓外扩膨胀比率(默认 1.5)
DBNet 在训练时为了将紧贴在一起的不同文本行分开,监督标签是有意“缩水”的核心多边形。在推理得到收缩多边形后,必须通过 Vatti 轮廓算法将其向外等比例膨胀。膨胀距离与面积成正比、与周长成反比,系数即为 det_db_unclip_ratio。
- 文字首尾经常缺字、字头缺少点横时:说明膨胀不足,将该参数调大至 1.8 ~ 2.2,确保汉字左右两端部首完整落入框内。
- 上下两行文字距离很近、经常被合并成一个大框时:说明过度膨胀导致外边界重叠,应调小至 1.2 ~ 1.4。
4. 识别阶段的关键参数与大模型选择
use_angle_cls=True与cls_thresh:在文档倒置或单行竖排时必须启用方向分类器。分类阈值cls_thresh默认 0.9,若旋转判断过于保守导致漏翻转,可微调为 0.8。- 模型级别切换(Server 模型):PaddleOCR 默认加载体积仅十几兆的移动端模型(Mobile)。如果在服务器端运行,推荐通过
ocr_version="PP-OCRv4"搭配structure_version或指定 Server 级权重,其注意力骨干网络(如 SVTR_LCNet)在形近字、生僻字上的识别容错率明显优于轻量化版本。 - 自定义字符字典(
rec_char_dict_path):如果业务仅涉及车牌、身份证、资产编码或金额,加载仅包含数字和大写字母的精简字典,可以从根本上杜绝把数字0认成汉字〇、字母O的混淆问题。
四、工程集成:端到端调优完整实现
将前端自适应预处理与调整后的推理引擎封装为可复用的 Python 类,能够在统一的执行上下文中完成画质增强与精准推断:
# -*- coding: utf-8 -*-
from paddleocr import PaddleOCR
import cv2
import numpy as np

class OptimizedOCRRunner:
    def __init__(self, use_gpu: bool = False, custom_dict_path: str = None):
        """
        初始化经过检测参数定制的 PaddleOCR 实例
        """
        ocr_kwargs = {
            "use_angle_cls": True,           # 启用 0/180 度方向分类器
            "cls_thresh": 0.82,              # 方向分类置信度判定阈值
            "det_db_thresh": 0.22,           # 调低概率门限,召回淡色与细小文字
            "det_db_box_thresh": 0.62,       # 略微提高框均分过滤,屏蔽轻微噪斑
            "det_db_unclip_ratio": 1.85,     # 扩大外扩系数,杜绝首尾汉字笔画被切
            "det_limit_side_len": 1280,      # 检测最长边上限,避免大图严重下采样
            "det_limit_type": "max",
            "use_gpu": use_gpu,
            "show_log": False
        }

        if custom_dict_path:
            ocr_kwargs["rec_char_dict_path"] = custom_dict_path

        self.engine = PaddleOCR(**ocr_kwargs)

    def run(self, image_path: str) -> list:
        # 1. 执行保边增强预处理
        processed_mat = preprocess_image_for_ocr(image_path)

        # 2. 将单通道灰度图转为 3 通道满足识别网络结构
        input_mat = cv2.cvtColor(processed_mat, cv2.COLOR_GRAY2BGR)

        # 3. 执行检测与识别
        raw_result = self.engine.ocr(input_mat, cls=True)

        parsed_items = []
        if raw_result and raw_result[0]:
            for line in raw_result[0]:
                box_points = line[0]        # 4个顶点的坐标 [[x1,y1], [x2,y2], ...]
                text_content = line[1][0]   # 识别文本字符串
                confidence = float(line[1][1]) # 置信度得分
                parsed_items.append({
                    "box": box_points,
                    "text": text_content,
                    "confidence": round(confidence, 4)
                })

        return parsed_items

# 示例调用
if __name__ == "__main__":
    runner = OptimizedOCRRunner(use_gpu=False)
    # results = runner.run("sample_receipt.jpg")
    # for item in results:
    #     print(f"[{item['confidence']:.2f}] {item['text']}")
五、常见识别缺陷排查与调优决策矩阵
在实际项目中遇到特定测试样本识别率偏低时,不要随意改动全部参数。下表列出了典型缺陷现象的对应根因及解决优先级:
| 不良现象 | 首要排查根因 | 预处理调整手段 | PaddleOCR 参数对策 |
|---|---|---|---|
| 边缘笔画截断(如“十”变“一”) | 多边形外扩半径不足,边缘字头字尾切角 | 四周添加 10px 的白色边界填充(Padding) | 提高 det_db_unclip_ratio 至 1.8~2.1 |
| 上下两行粘连(合并为一个框) | 行距过小或膨胀系数过大导致轮廓交叠 | 适当缩小图片高度或保持原图分辨率 | 降低 det_db_unclip_ratio 至 1.2~1.4 |
| 淡色字/小字漏检(整行丢失) | 对比度过低未激活 DBNet 概率核 | 使用 CLAHE (clipLimit=3.0) 增强局部反差 | 调小 det_db_thresh 至 0.15~0.20 |
| 表格线/印章误报(出现乱码符号) | 连续线条被检测器当作连笔文字 | 利用形态学开运算去除水平/垂直纯直线 | 提高 det_db_box_thresh 至 0.68~0.75 |
| 形近字误识(如 0/O、日/曰) | 识别网络容量受限,或未限定字符范围 | 双边滤波去噪 + 适度锐化突出笔画结构 | 切换 Server 模型;配置自定义字符白名单字典 |
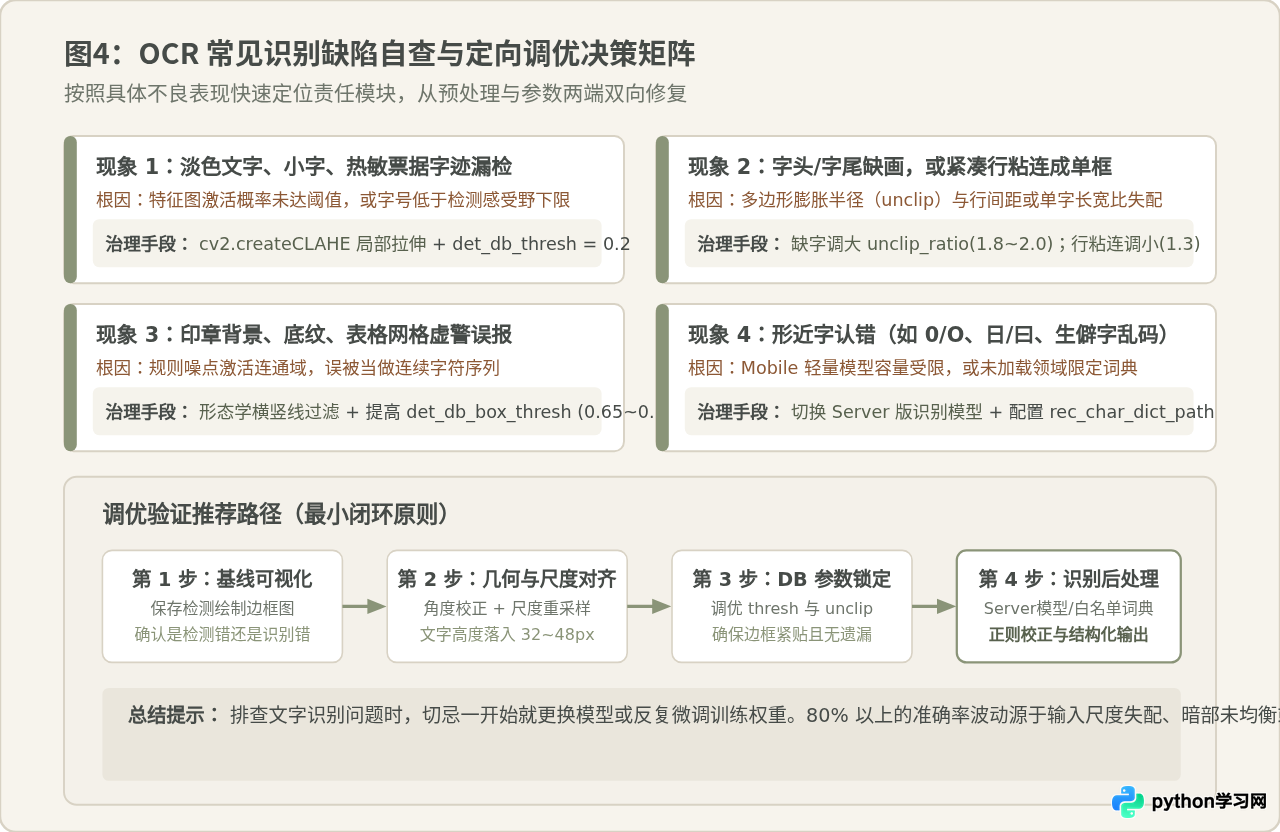
面对文字识别质量瓶颈,切忌在一开始就进行重新微调(Fine-tuning)训练。绝大多数工业与办公场景中的识别失误,都可以通过前端双边滤波与 CLAHE 增强稳固图像梯度,辅以后端的 det_db_thresh、det_db_unclip_ratio 阈值收口予以解决。遵循“检查中间切框图、校准输入字号尺度、精准定向调参”的标准步骤,能用最小的计算代价换取最稳定的文字提取质量。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















