


Python在线运行网站安全吗?代码隐私与执行限制须知
全面解析Python在线运行网站的安全性、代码流经链路与隐私泄露风险,并深入剖析平台在CPU耗时、内存配额、网络出站与系统调用上的底层执行限制及应对策略。
一、你在网页中运行的代码,究竟去了哪里?
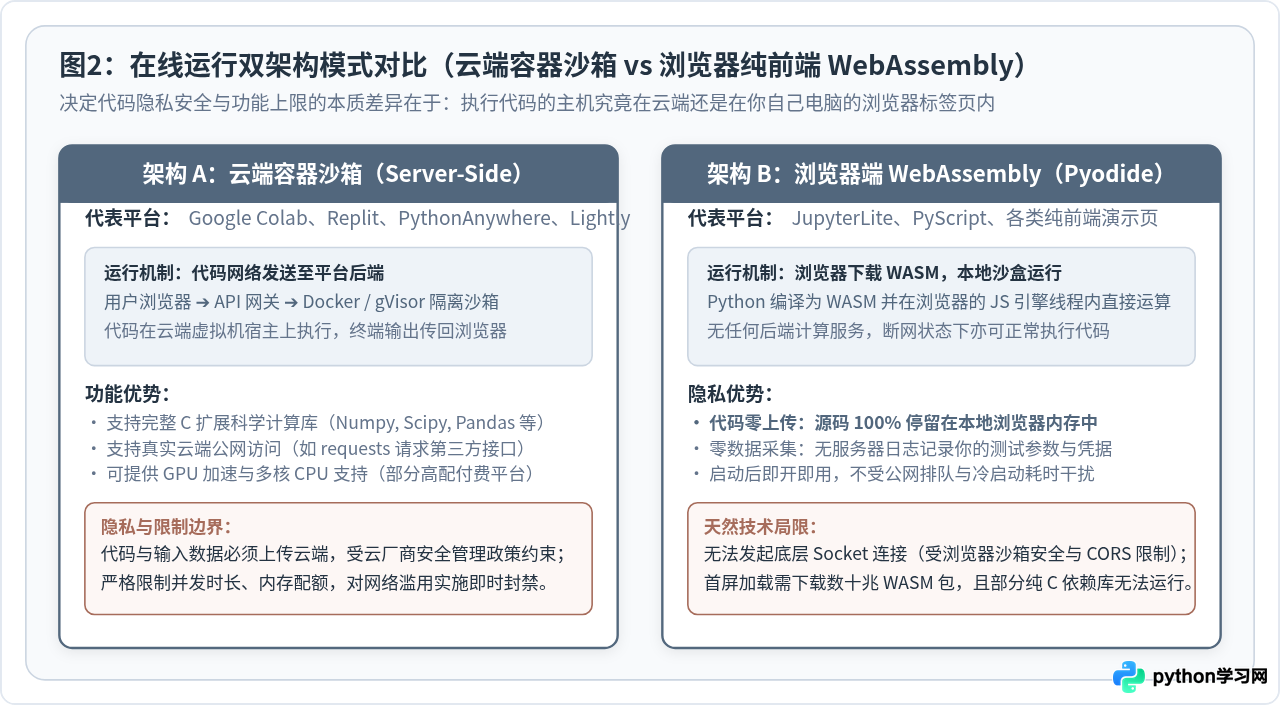
许多初学者往往把在线代码编辑器当成类似本地记事本的纯前端工具,认为“在自己浏览器里打字就只会留在本地”。但实际上,目前市面上的 Python 在线运行网站基于两种底层逻辑截然不同的架构设计,这直接决定了你的代码资产究竟掌握在谁手里。
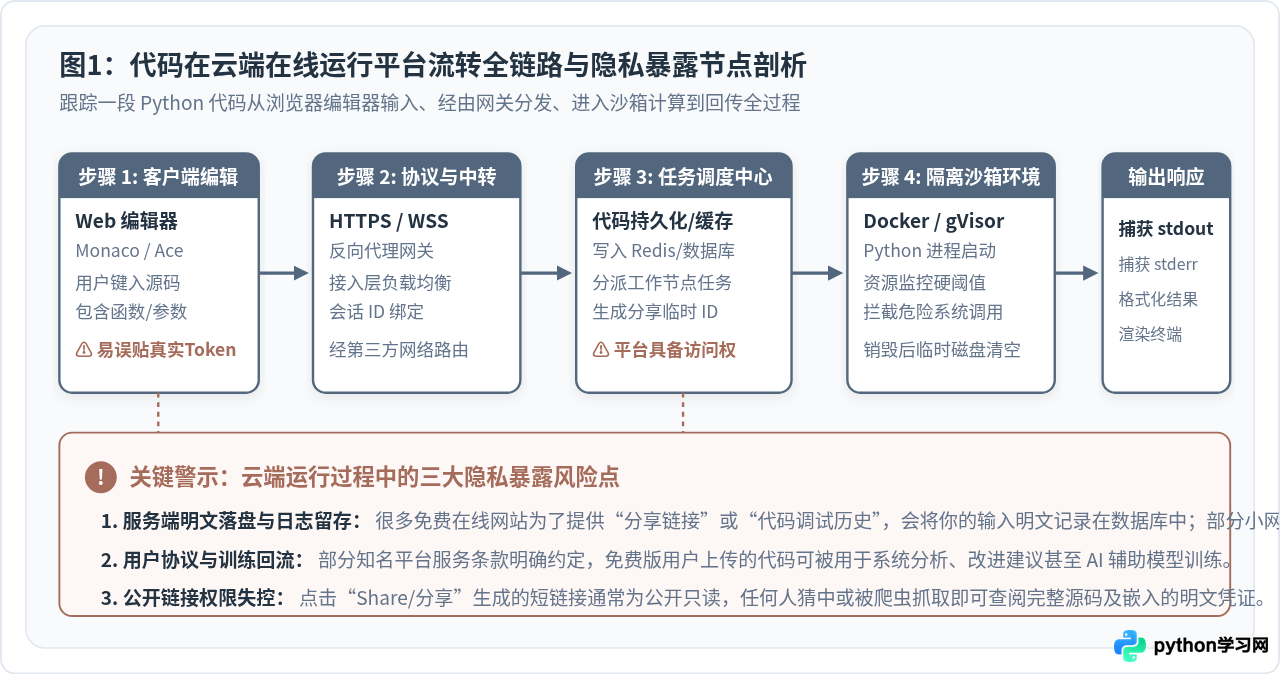
第一种也是最主流的方式是云端容器沙箱模式(Server-Side Sandbox),常见于 Google Colab、Replit、PythonAnywhere 以及大部分菜鸟教程风格的轻量在线工具。当你点击“Run”或“运行”按钮时,浏览器会通过 HTTPS POST 请求或 WebSocket 全双工通道,将整段代码作为文本打包发往远程服务器。服务端的 API 网关会分配一个轻量级容器(如 Docker、gVisor 沙箱或微虚拟机),在宿主机隔离环境中启动真实 Python 解释器执行代码,并实时将控制台的输出流(stdout/stderr)抓取后回传给你的浏览器窗口。
这意味着:你的源代码、传入的参数变量、甚至因报错生成的详细堆栈信息,都完整流经了第三方的网络网关、调度队列并在云端主机的内存和临时虚拟磁盘中留存。
第二种新兴方案则是浏览器端纯前端 WebAssembly 架构(以 Pyodide、JupyterLite 为代表)。该方案将标准 CPython 解释器完整编译成了 WebAssembly(WASM)二进制文件。打开网页时,浏览器会把几十兆的解释器引擎加载到你的浏览器标签页内存中,所有的代码运算完全在浏览器底层的 V8 / JavaScript 引擎虚拟机内部完成,全程不需要后端执行服务器,也不向外传输任何源码。
如何快速辨别你当前使用的在线网站是哪种架构?方法非常直观:按键盘 F12 打开浏览器开发者工具,切换到 “网络 (Network)” 面板并清空现有请求,随后在网页编辑器中点击运行。如果网络面板立即弹出一个通向远程域名的 POST 请求或持续活跃的 WebSocket 帧(负载中包含你刚才输入的代码字符串),则属于云端容器架构;如果网络面板完全没有任何数据传输,代码依然瞬间输出了结果,或者在首屏加载时下载了以 .wasm 结尾的大文件,则说明是纯本地运行的 WebAssembly 架构。
二、代码隐私的三大核心隐患与规避措施
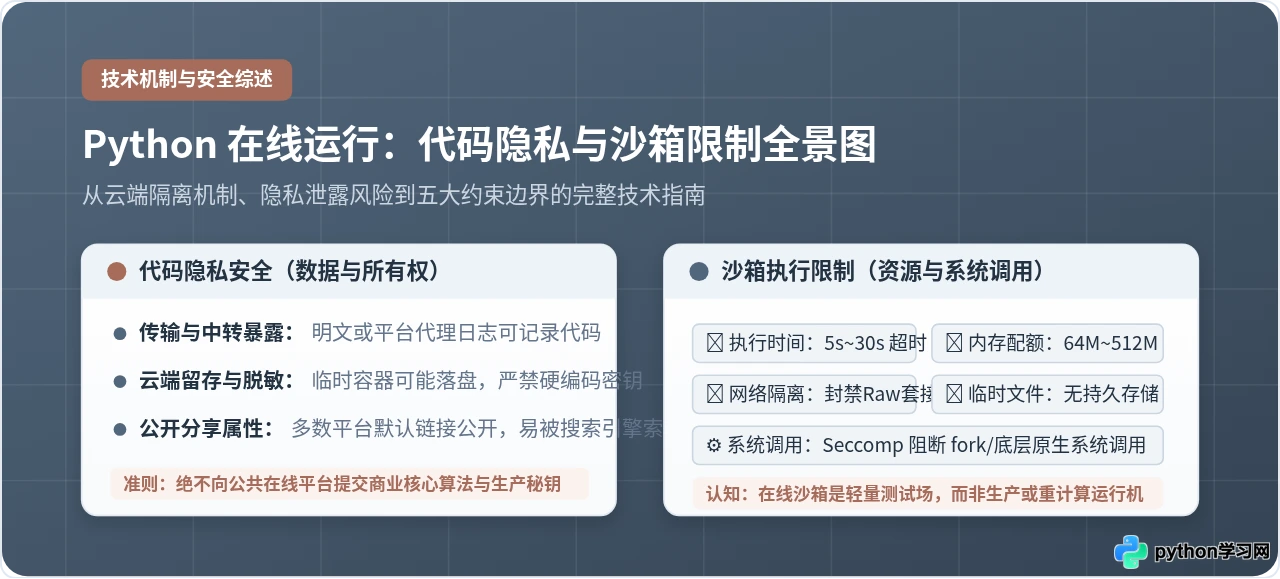
了解了数据流向后,代码隐私方面的具体隐患就变得非常清晰。在实际使用中,常见的泄露事故通常并不是因为平台遭遇了黑客攻击,而是源于使用方式与安全边界的不匹配。
1. 误贴生产密钥与硬编码凭据
在本地调试时,有些开发者图省事习惯将数据库连接串、第三方云服务的 AccessKey 或大模型 API_KEY 直接硬编码在变量中。当这类代码被随手贴入在线云端沙箱时,凭据就脱离了安全受控区。即使平台承诺“运行完毕即销毁容器”,反向代理网关的访问日志(Access Log)、崩溃排查监控(Tracing)以及中转缓存仍可能以明文形式记录请求 Payload。
2. 公开链接权限与搜索引擎索引
许多在线平台为了方便教学分享,提供了类似“一键生成分享链接”或“Fork 项目”的功能。但许多网站的默认策略是将生成的代码片段设为 Public(公开)。这些链接通常没有访问密码,不仅任何知晓 URL 的人都能随意浏览,各类网络爬虫和搜索引擎还会定期抓取这些页面。一旦代码中夹带了内部接口域名或未公开算法,就会在不知不觉中被公网检索到。
3. 平台隐私条款中的“代码回流”授权
免费服务通常伴随着隐性成本。仔细翻阅部分免费在线运行网站的服务条款(Terms of Service),往往会发现类似条款:“用户同意平台及其关联方有权出于改善服务、系统诊断或训练智能化模型之目的,收集并分析用户在平台提交的内容”。如果代码属于公司职务作品或具有商业专利价值,上传此类平台即可能构成违规泄密。
实操建议:代码脱敏与 Mock 占位方案
如果确实需要借助在线网站验证一段复杂逻辑,应严格采用“结构保留、数据虚拟”的脱敏策略。下面的代码对比展示了规范的改写方式:
危险写法(禁止在在线平台运行):# ❌ 错误做法:直接硬编码生产真实参数
import requests
PROD_API_KEY = "sk-live-9a8f7c6e5d4c3b2a1" # 严重隐患:泄露核心私钥
DB_CONN = "postgresql://admin:SecretPass123@10.0.1.25:5432/core_db"
def query_user_account():
headers = {"Authorization": f"Bearer {PROD_API_KEY}"}
# 此处可能还会发起真实的敏感网络调用...# ✅ 正确做法:使用纯逻辑占位符与本地虚拟 Mock 字典
def parse_account_data(raw_response):
"""仅验证纯解析逻辑,剥离网络与鉴权"""
if not raw_response.get("status") == "success":
return None
return [item["id"] for item in raw_response.get("data", [])]
# 使用虚构的测试输入验证函数行为
mock_test_input = {
"status": "success",
"data": [{"id": "user_001"}, {"id": "user_002"}]
}
result = parse_account_data(mock_test_input)
print("验证结果:", result)验证结果: ['user_001', 'user_002']三、为什么代码在本地正常,网页端却报错?五大执行限制
不少读者会遇到这种困惑:一段 Python 代码在本地 VS Code 或终端中跑得顺顺当当,复制到在线网站却弹出 TimeoutError、MemoryError 或者干脆直接白屏崩溃。这并不是 Python 语法出了问题,而是平台的沙箱资源防御系统在起作用。公共在线运行器必须为成千上万并发用户提供服务,为了防止整机被恶意挖矿程序、死循环或黑客攻击击垮,平台在操作系统层面施加了极其严苛的物理限制。
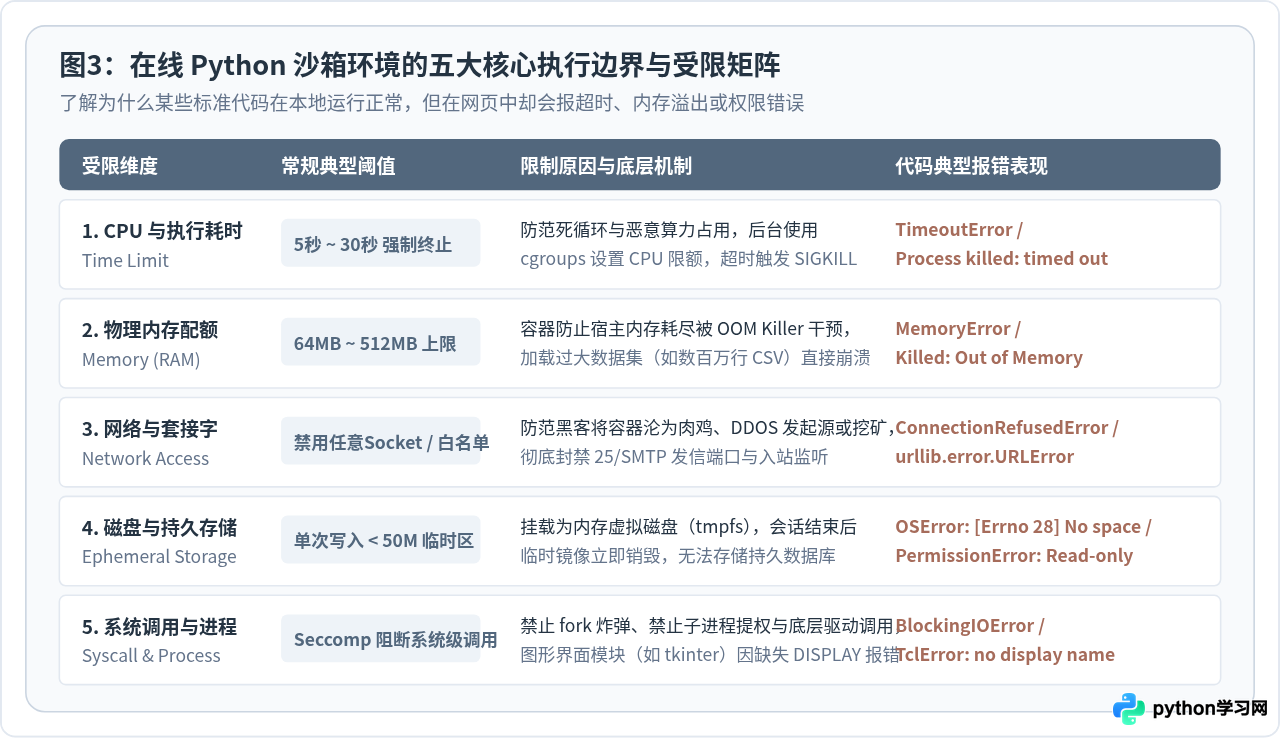
1. CPU 耗时硬中断(Time Limit)
在 Linux 容器底层,平台通常通过内核 cgroups 限制 CPU 核心配额,并配合守护进程(Watchdog)设置 Wall-clock 执行时限。通常轻量工具的执行上限仅为 5秒至30秒。
如果代码中包含了未加跳出条件的递归、复杂度过高的三重循环,或者试图进行本地大模型推理,一旦达到时间阈值,监控守护进程会立即向 Python 进程发送 SIGKILL 信号。由于 SIGKILL 无法被 Python 的 try...except 捕获,脚本会被操作系统瞬间掐断,直接报出 timed out 或无响应终止。
2. 物理内存阈值与 OOM Killer(Memory Limit)
本地电脑通常拥有 8GB 至 32GB 内存,而分配给单个在线网页沙箱的 RAM 配额通常被压缩在 64MB 到 512MB 之间。一旦你尝试加载一个数百兆的文本数据集、使用 Pandas 创建多份冗余副本,容器内存消耗触及警戒线,Linux 内核的 Out-of-Memory (OOM) Killer 就会毫不犹豫地终止主进程,抛出 Killed: Out of Memory 或 MemoryError。
3. 网络连接封禁与套接字隔离(Network Restrictions)
网络是在线运行器限制最密集的领域。由于曾有黑客利用在线编程网站建立肉鸡网络、发动 DDOS 攻击或进行端口探测,绝大多数正规平台实施以下策略:
- 禁用底层原始套接字(Raw Socket):禁止构造自定义 TCP/UDP 报文;
- 封禁敏感通信端口:如 25 端口(SMTP 发信防垃圾邮件)、445 端口(SMB 攻击防范)等;
- 严禁监听入站端口:你无法在线启动一个标准的 Flask/FastAPI 网站并期望公网直接通过 IP 访问(除非是 Replit 这类专有且绑定了 Web 代理的服务);
- WebAssembly 运行器的跨域封锁:在 Pyodide 等前端运行时中,网络请求走的是浏览器的
fetch接口,直接受制于浏览器的 同源策略(CORS)。这意味着如果目标 API 未声明Access-Control-Allow-Origin: *,代码中的requests就会因浏览器安全阻断而失败。
4. 临时文件系统与存储配额(Ephemeral Storage)
在线容器中的文件读写绝大部分是挂载在 tmpfs(内存临时文件系统)上的。除了单次写入文件大小通常被限制在 10MB~50MB 以内,一旦执行完成或刷新页面,整个容器镜像就会被回收,所有 open("data.txt", "w") 写入的内容都会灰飞烟灭。如果你的代码逻辑强依赖本地持久化保存或数据库事务落盘,在线运行器将无法胜任。
5. 系统调用拦截与图形窗口缺失(Syscall & GUI)
平台通过 Linux 的 seccomp(安全计算模式)和 AppArmor 策略,过滤掉了大量底层系统调用:禁止创建子进程组(防止 fork 炸弹)、禁止挂载驱动设备、禁止底层进程调试。此外,在线容器通常运行在无头(Headless)无桌面环境的 Linux 服务器中,没有 X11 或 Wayland 服务。如果代码中直接调用 import tkinter; root = tkinter.Tk(),Python 会直接报出 _tkinter.TclError: no display name and no $DISPLAY environment variable。在网页端进行数据可视化,只能使用能将图表输出为 HTML/SVG 或文件形式的库(如 Matplotlib 保存为静态图片流),无法弹出交互式原生 GUI 窗口。
四、安全使用在线运行器的自查流程与操作规范
为了既能享受在线运行的即时性,又确保不踩中泄密与异常报错的深坑,在每次将代码粘贴进网页前,建议遵循下述结构化的自查决策流程:
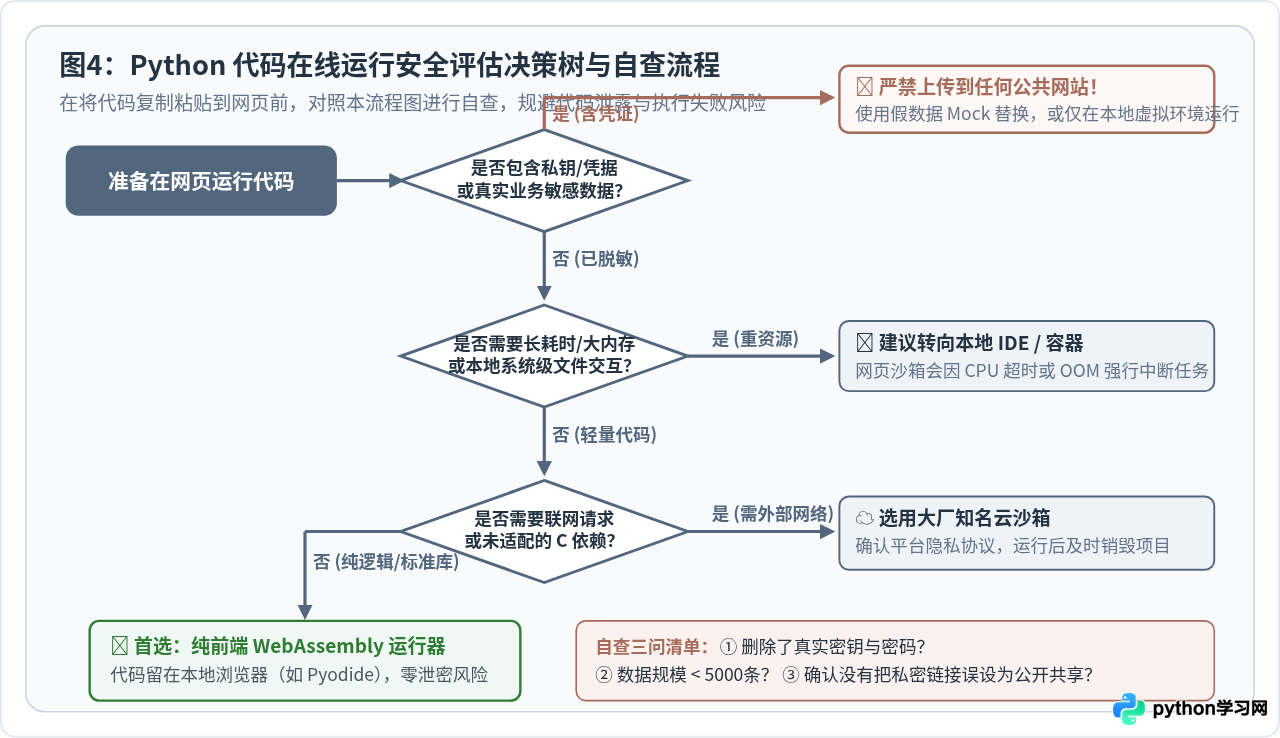
操作清单:三步走规范
第一步:源码预检与敏感词搜索
在复制之前,在本地编辑器使用全局搜索功能排查 key、secret、token、password、192.168.、10.、corp 等敏感前缀。确认所有凭证已转为虚构字符串,业务逻辑已抽离为纯粹的输入输出算法。
第二步:选择合适的运行架构
如果只是测试简单的数学计算、字符串正则、算法题解,优先选用基于 WebAssembly/Pyodide 的纯本地运行器,代码无需上云,安全性最高;如果依赖大型科学计算库或需要合法调用公网开放接口,选用知名信誉良好的云端沙箱平台。
第三步:测试完毕立即清理现场
运行完毕并确认结果后,及时刷新页面、关闭对应会话。如果平台支持登录并保存了历史项目,在获取所需结果后,手动点击删除该脚本或项目,避免遗留未关闭的公共访问入口。
五、总结:在线运行器的能力边界与适用场景
在线 Python 运行网站本质上是为轻量验证、教育演示与快速共享而设计的“代码沙盒”,而非用于生产部署或承载机密业务的计算中枢。
| 场景类别 | 是否适宜在线运行 | 原因与建议 |
|---|---|---|
| 语法练习 / LeetCode 算法验证 | 极度适宜 | 无需依赖外部资源,纯 CPU 逻辑运算,秒级响应,开箱即用。 |
| 教学示例 / 技术文档嵌入 | 极度适宜 | 读者无需繁琐配置本地环境,借助在线平台能直观感受执行输出。 |
| 公网 API 对接初步联调 | 有条件适宜 | 必须使用受限的测试环境 Token,杜绝写入具备扣费或写权限的生产主凭证。 |
| 包含真实客户数据的分析清洗 | 严格禁止 | 数据离开本地管控即存在审计与泄密风险;海量数据还会直接引发 OOM 崩溃。 |
| 长时间爬虫 / 定时自动化任务 | 严格禁止 | 沙箱具备严格的执行超时与端口防护,连接将被直接截断或拉黑。 |
只要树立明确的边界意识:将“生产数据与机密代码留在本地/内网私有容器,将通用函数验证与轻量教学探索放在在线沙箱”,开发者便能在充分享受在线工具便捷性的同时,彻底规避代码泄露与环境限制带来的风险。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















