


Python字符串截取报错IndexError和ValueError怎么处理
系统剖析Python在字符串截取与切片操作中触发IndexError和ValueError的深层机制,针对单索引越界、步长为零、子串未查见与解包失败提供四步标准化排查法和高容错重构方案。
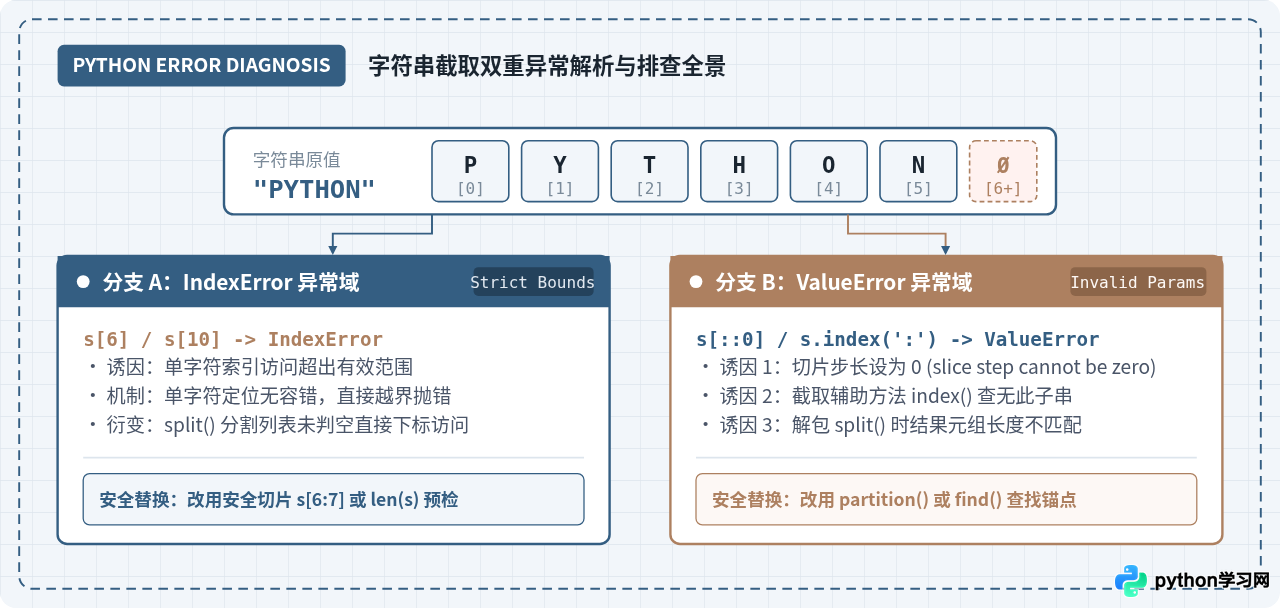
s[i])与范围切片操作(s[start:end])混为一谈。事实上,Python 原生的字符串范围切片具有强韧的自动截断容错机制,即便索引严重超出长度,切片语法也不会抛出 IndexError;该异常几乎全部源于单字符索引越界,或在对 split() 拆分后的列表提取元素时产生的下标溢出。而 ValueError 则发生在切片参数不合法(如步长为 0)或定位子串的辅助函数(如 str.index())查找失败。掌握底层机制差异与安全重构模式,能彻底杜绝此类线上异常。
一、快速定位:IndexError 与 ValueError 的报错现场与底层机制
排查问题的首要动作是审阅 Python 解释器给出的 Traceback(调用回溯堆栈)。截取场景下常见的两类异常具有截然不同的特征表现:
Traceback (most recent call last):
  File "data_parser.py", line 18, in extract_field
    first_char = text[10]
IndexError: string index out of range

# 或者另一种常见的辅助调用异常:
Traceback (most recent call last):
  File "data_parser.py", line 24, in parse_token
    sep_pos = text.index(":")
ValueError: substring not found
为了从根本上消除困惑,我们需要理清 Python 解释器在 C 语言层面(Objects/sliceobject.c)对“单个字符查找”与“切片截取”的处理分支:
- 单索引访问
s[i]的刚性校验:Python 对单一索引执行严格的数学边界检查,必须满足-len(s) <= i < len(s)。哪怕只超出一位(例如长度为 5 的字符串访问s[5]),解释器也会立即抛出IndexError: string index out of range。 - 范围切片
s[start:stop]的弹性容错:在执行范围切片时,内部通过PySlice_GetIndicesEx规范化边界。无论你传入多大的数字(如"abc"[10:100]),解释器都会自动把范围截断并限制在[0, len(s)]之间。当起始点大于字符串长度时,它静默返回空字符串"",永远不会因为范围过大而报IndexError。
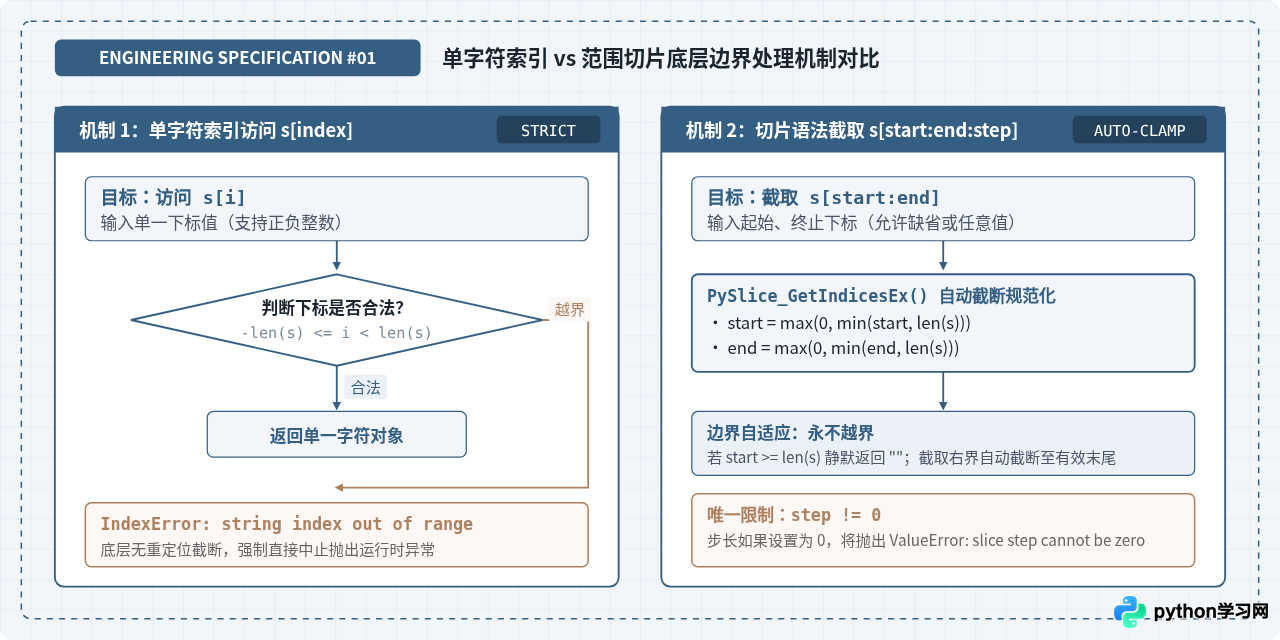
IndexError: string index out of range,请立即检查报错行——你一定写了诸如 s[i] 的单下标提取、动态拼接了非法下标,或者是在对 s.split() 返回的列表取值,而不是普通的 s[start:end] 切片。
二、IndexError: string index out of range 的成因与处理方案
场景 1:误将单字符截取当成容错切片
日常开发中经常需要获取字符串的第一个字符或固定偏移处的标记位。初学者常直接书写 char = s[index]。当外部输入为空字符串 "" 或长度不满足预期时,程序立刻崩溃。
# 脆弱写法:对空串或短字符串报错
def get_flag(s):
    return s[3]  # 若 s="ok",触发 IndexError: string index out of range

# 修复方案 A:利用单字符切片窗口代替单索引(推荐)
def get_flag_safe(s):
    # s[3:4] 在越界时自动返回 "",配合 or 可以极简设置回退默认值
    return s[3:4] or "DEFAULT"

# 修复方案 B:明确的长度守卫
def get_flag_guard(s):
    if len(s) > 3:
        return s[3]
    return "DEFAULT"
核心技巧:在 Python 中,s[i:i+1] 是对 s[i] 绝佳的安全替代。即使 i 是 99999,s[i:i+1] 也只会返回 "",完全免除了写繁琐 if-else 边界判定的开销。
场景 2:基于 split() 截取结果解包或索引越界
很多截取逻辑由分隔符分割驱动,例如获取文件名后缀或提取 URL 路径参数。若源字符串不包含期望的分隔符,split() 得到的列表长度就会少于预期,后续通过下标 parts[1] 读取第二项时就会报 IndexError: list index out of range。
# 脆弱写法:
filename = "README"
ext = filename.split(".")[1]  # 触发 IndexError: list index out of range

# 修复方案:优先使用标准库,或使用 partition() / rsplit() 进行边界防护
# 方案 1:使用标准库专职工具(以路径和扩展名为例)
import os
name, ext = os.path.splitext(filename)

# 方案 2:切片配合列表解包容错
parts = filename.split(".", 1)
ext = parts[1] if len(parts) > 1 else ""
三、ValueError 的常见触发场景与处理方案
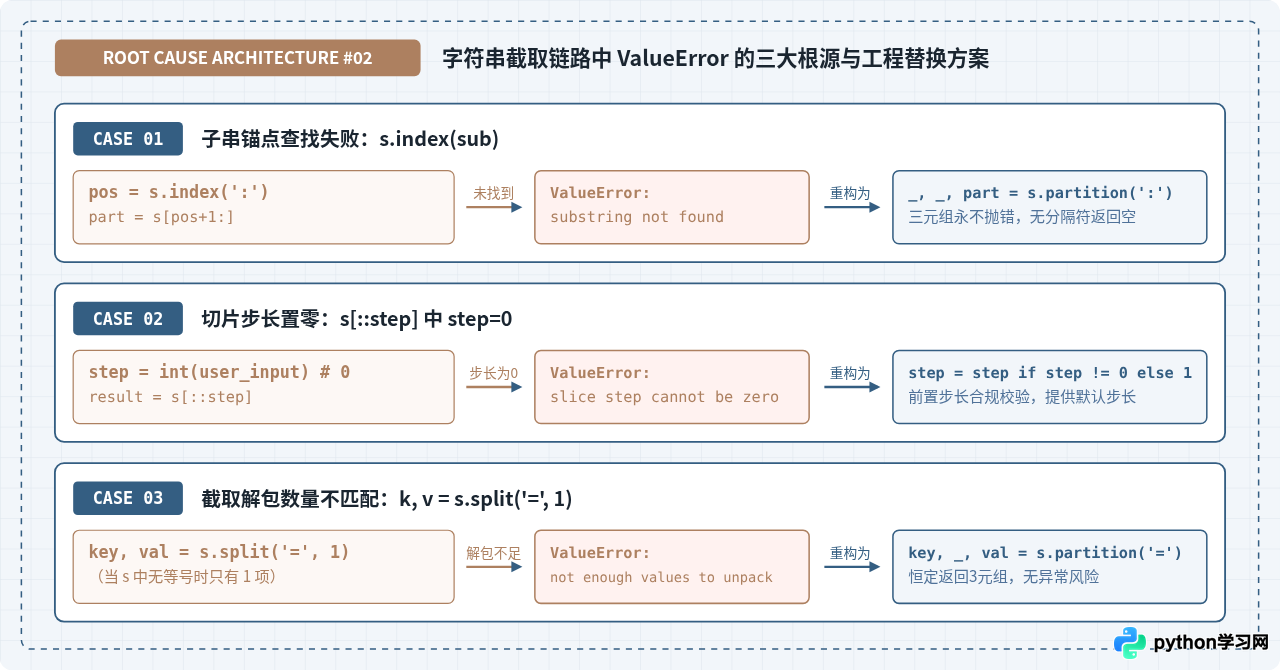
在字符串截取流程中,ValueError 并不是切片自身的取范围报错,而是由于截取参数非法或截取辅助函数调用失效导致的。主要集中在以下三大核心场景:
场景 1:使用 str.index() 寻找截取锚点但子串不存在
很多业务需要截取指定分隔符之后的内容。常见的直觉写法是先调用 s.index(':') 拿到位置,然后切片 s[pos+1:]。但是如果文本中没有冒号,str.index() 会硬性抛出 ValueError: substring not found。
raw_header = "Authorization Bearer_Token_ABC"

# 脆弱写法:
# sep_idx = raw_header.index(":")  # 报错:ValueError: substring not found
# val = raw_header[sep_idx + 1:]

# 稳健替代 A:改用 str.find() 并进行 -1 判断
sep_idx = raw_header.find(":")
if sep_idx != -1:
    val = raw_header[sep_idx + 1:].strip()
else:
    val = ""  # 或处理缺省值

# 稳健替代 B:最现代的解法 —— 使用 str.partition()(强烈推荐)
# partition 永远返回包含 3 个元素的元组:(分隔符左侧, 分隔符自身, 分隔符右侧)
# 如果分隔符未找到,返回 (原串, "", ""),绝不抛出任何异常!
_, sep, val = raw_header.partition(":")
if sep:
    val = val.strip()
else:
    val = ""
场景 2:动态切片步长被意外计算为 0
Python 切片语法允许第三个参数 step,形式为 s[start:stop:step]。切片步长代表每次前进或后退的跨度。数学上跨度为 0 意味着无限死循环,因此解释器严禁步长为 0。如果你的步长来自用户入参、自适应计算公式或未经校验的浮点数转整型,一旦结果为 0,就会触发 ValueError: slice step cannot be zero。
# 步长为 0 的典型错误:
# sample = "abcdef"[::0] # 报错:ValueError: slice step cannot be zero

def sample_string(text, stride=1):
    # 守卫:确保 stride 不为 0,若为 0 回退到默认 1
    safe_stride = 1 if stride == 0 else stride
    return text[::safe_stride]
场景 3:split() 分割截取解包时数量不匹配
形如 key, value = item.split("=", 1) 的写法意在截取键值对。当 item 是一行脏数据(例如纯字符串 "invalid_line")时,split() 只生成包含 1 个元素的列表,解包赋值到 2 个变量时即触发 ValueError: not enough values to unpack (expected 2, got 1)。
解决该问题的终极武器依然是 str.partition():它在结构上固定产出三元组,既避免了 ValueError,又免除了后续的长度判定。
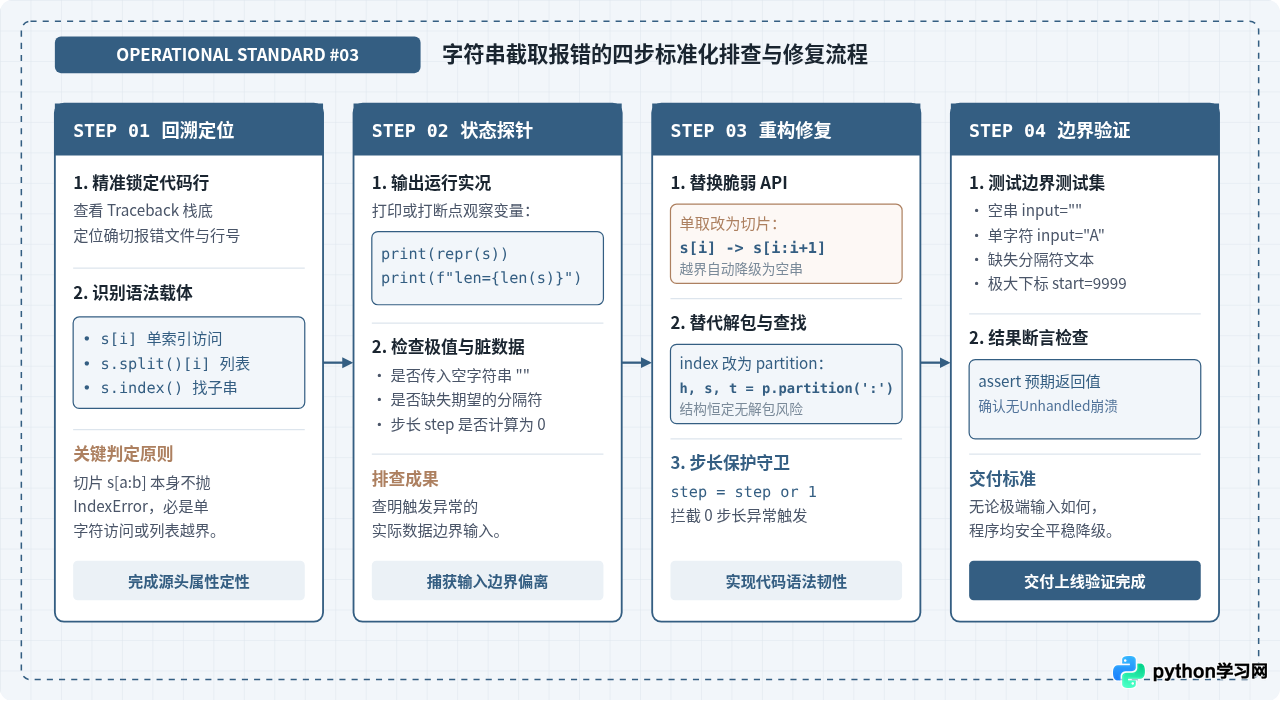
四、四步标准化排查与修复流程(操作指南)
当在生产环境日志或本地调试中捕获到字符串截取相关的异常时,遵循以下工程标准四步法,可以在数分钟内完成归因定位与彻底修复:
-
步骤 1:精确回溯定位报错行与语法结构
检查 Traceback 堆栈底部的真实代码行。明确判断抛错的是单字符中括号
s[i]、切片s[a:b:c],还是切片前置调用的index()、split()等辅助函数。 -
步骤 2:注入状态探针,捕获现场输入数据
在报错行前加入调试日志或断点:输出
repr(s)以及len(s)。重点观察是否有空字符串""、None误入、末尾换行符未剥离、或外部第三方接口返回了非结构化数据。 -
步骤 3:运用高容错语法重构脆弱代码
将单字符访问改为窗口切片
s[i:i+1];将str.index()替换为str.partition()或str.find();对动态步长添加非零校验(step = step or 1)。 -
步骤 4:构建极值边界测试用例集
不要只验证“正常长字符串”。必须覆盖:① 空字符串
"";② 单字符"a";③ 不含任何分隔符的异常文本;④ 远超长度的超大索引(如 99999);⑤ 负数索引。全部用例断言通过后方可合并代码。
五、防御式编程与工程最佳实践
对于需要高可靠运行的自动化脚本、Web 接口或后台数据 ETL 管道,编写防御性强的工具函数是避免线上意外崩溃的最佳策略。
def safe_substr(s: str, start: int = 0, length: int = None, default: str = "") -> str:
    """
    通用高容错子串安全截取函数
    :param s: 输入的原字符串(为 None 时自动归一化为空串)
    :param start: 起始偏移(支持正负数)
    :param length: 截取字符数(为 None 时截取到末尾)
    :param default: 截取结果为空时的备选默认值
    """
    if not isinstance(s, str):
        s = str(s) if s is not None else ""

    # 当 length 为 None 时,直接切片至末尾
    if length is None:
        res = s[start:]
    else:
        if length <= 0:
            return default
        res = s[start:start + length]

    return res if res else default


def safe_split_pair(s: str, sep: str, default_right: str = "") -> tuple[str, str]:
    """
    基于分隔符安全拆分左右两段,杜绝 ValueError 与 IndexError
    """
    if not isinstance(s, str):
        return ("", default_right)
    left, found, right = s.partition(sep)
    if not found:
        return (left, default_right)
    return (left, right)
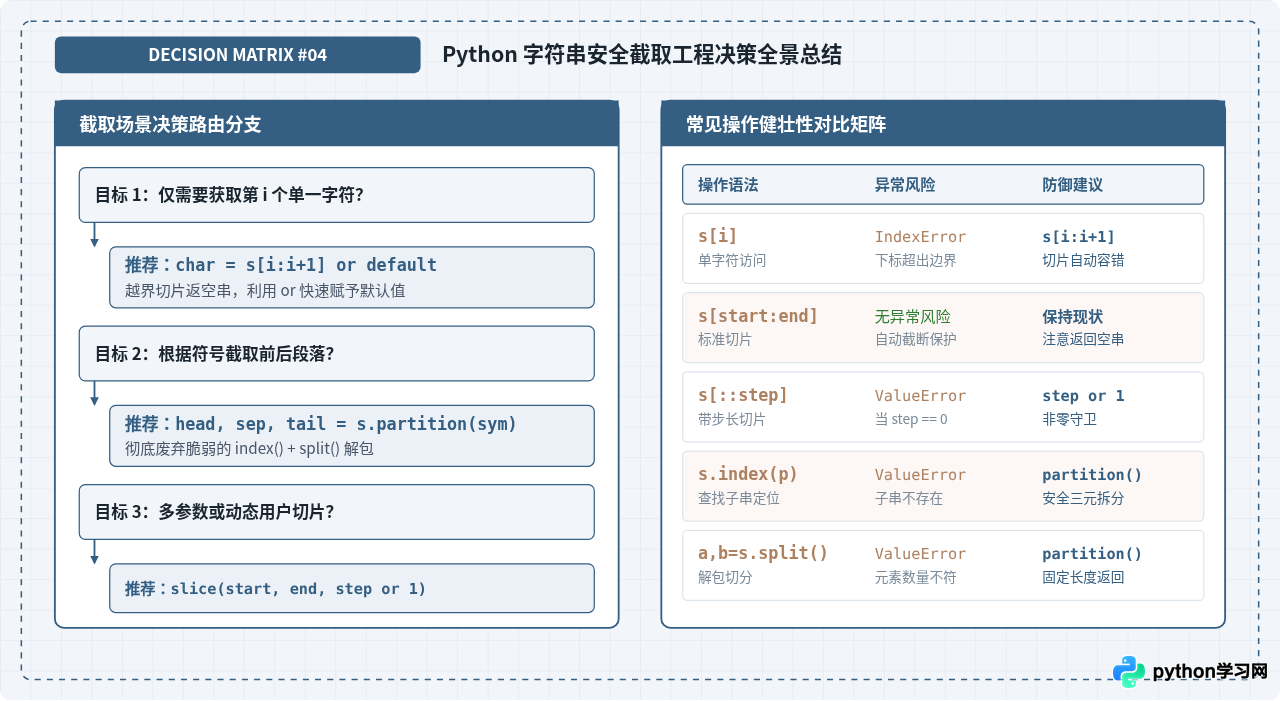
下面是常用字符串截取操作在应对异常时的策略对比表,供编写业务逻辑时快速查阅:
| 业务诉求 | 脆弱写法(易崩溃) | 潜在报错 | 工程推荐写法(防崩) |
|---|---|---|---|
| 截取第 N 个字符 | char = s[N] |
IndexError | char = s[N:N+1] or default |
| 截取前 N 个字符 | prefix = s[:N] |
无风险 | prefix = s[:N](原生安全,支持越界) |
| 按标记提取右半部分 | s[s.index(":") + 1:] |
ValueError | s.partition(":")[2] |
| 提取键值对两段 | k, v = s.split("=", 1) |
ValueError | k, _, v = s.partition("=") |
| 文件后缀提取 | s.split(".")[1] |
IndexError | os.path.splitext(s)[1] |
| 动态步长采样 | s[::calc_step()] |
ValueError | s[::calc_step() or 1] |
六、常见问题解答(FAQ)
问:为什么 s = "python"; print(s[10:20]) 不会报错,而 s[10] 会报错?
答:这是 Python 语言设计的有意权衡。单字符访问 s[10] 属于精确元素检索,当下标超出容器范围时,必须用 IndexError 明确警告程序员下标失控;而 s[10:20] 属于集合区间截取,切片哲学遵循“尽可能多地返回区间内现存的内容”。如果区间与字符串全无交集,返回空串是完全自洽且符合直觉的处理方式。
问:为什么 s[::-1] 可以正确逆序,但 s[::-0] 会报错?
答:在计算机数字运算中,整数 0 没有正负符号之分,-0 == 0。因此 [::-0] 实际上就是 step = 0。切片步长为零代表指针无法移动,如果不报错就会产生无限递归死循环,因此 Python 专门在此处设立了 ValueError: slice step cannot be zero 的异常屏障。
问:在需要严谨处理日志和大文本的场景下,性能最高、容错最好的模式是什么?
答:推荐首选 str.partition() 和原生无步长切片 s[start:end]。str.partition() 不仅具备百分之百的异常免疫力,而且由于在底层 C 实现中只遍历一次且仅创建 3 个对象,其性能往往比 find() + 切片 或带正则匹配的解法更快、内存开销更小。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















