


Python多进程报错PicklingError怎么解决:序列化陷阱与规避
深入解析Python多进程编程中PicklingError报错的底层成因,梳理局部函数、闭包、类实例系统资源绑定等典型序列化陷阱,并提供系统化排查步骤与工程规避方案。
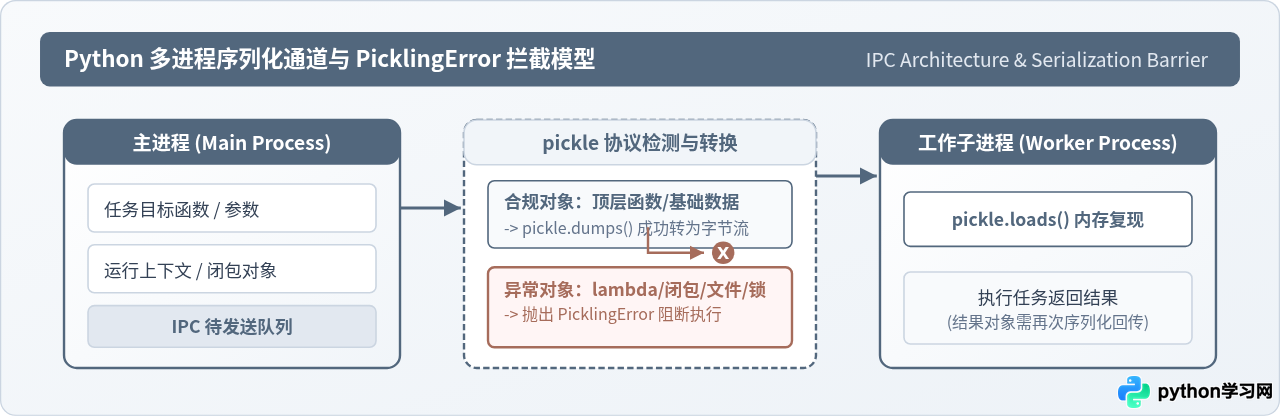
在使用 Python multiprocessing 模块或 concurrent.futures.ProcessPoolExecutor 编写多进程程序时,开发者经常遇到 _pickle.PicklingError: Can't pickle local object 或 cannot pickle 'thread.lock' object 报错。该报错的根本原因在于:Python 多进程依赖操作系统管道与套接字进行进程间通信(IPC),派发任务函数、传输入参和回传执行结果时,必须通过标准库 pickle 协议将内存对象打散为连续字节流;一旦任务携带了无法在子进程寻址或无法归档系统句柄的对象,序列化通道便会立即被阻断。解决此问题的核心路径在于明确序列化边界,通过将任务函数提升为模块顶层、将系统连接与锁资源移至子进程就地初始化(initializer 模式)、或在特定场景引入增强型序列化库,即可彻底规避这一报错。
一、报错表现与多进程序列化底层机制
许多开发者感到疑惑:同样的函数和对象,如果放在单线程或 threading.Thread 中运行毫无问题,但只要放入 multiprocessing.Pool 或 ProcessPoolExecutor,就会立即抛出刺眼的调用栈:
Traceback (most recent call last):
  File "multiprocessing/queues.py", line 245, in _feed
    obj = _ForkingPickler.dumps(obj)
  File "multiprocessing/reduction.py", line 51, in dumps
    cls(buf, protocol).dump(obj)
_pickle.PicklingError: Can't pickle local object 'main.<locals>.worker_task'
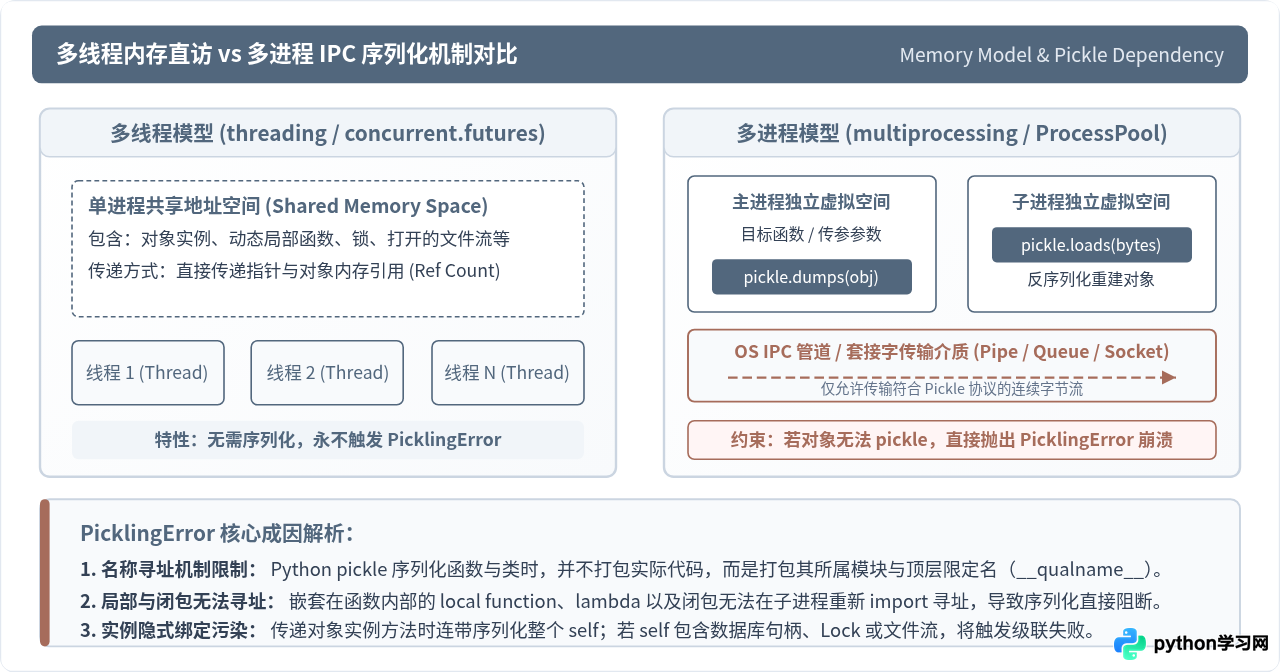
这一现象背后的本质是多线程与多进程在内存模型上的分野。在多线程环境中,所有线程驻留在同一个操作系统的虚拟地址空间中,互相传递数据只需要传递 64 位的内存指针或对象引用计数,根本不需要任何数据格式转换;而多进程为了规避 Python 的全局解释器锁(GIL)并充分利用多核 CPU,操作系统为每个进程分配了彻底隔离的虚拟地址空间。主进程中的变量地址在子进程中毫无意义。
为了实现进程间任务分发,Python 多进程内部使用基于操作系统管道(Pipe)的 ForkingPickler。主进程在派发执行体时,必须依次对目标任务函数、位置参数元组以及关键字参数字典调用 pickle.dumps(),将它们转化为二进制字节流写入管道;子进程从管道读取流后,再调用 pickle.loads() 重建对象。只要这个链条中任意一个属性不支持 pickle,操作就会在序列化阶段中止。
二、四类高发序列化陷阱与代码复现
理解了多进程序列化管道的存在后,我们来逐一审视生产环境中最容易踩中的四个序列化陷阱。
陷阱 1:使用嵌套函数、局部函数或 lambda 表达式
Python 的 pickle 序列化函数时并不打包函数的字节码内容,而是采取“按限定名寻址(Qualified Name)”的策略。pickle 只记录了函数所在的模块全名(__module__)和函数名(__qualname__)。反序列化端必须能够在子进程里根据这个名字,通过顶层 import 重新导入并查找到对应的函数对象。
局部函数(在另一个函数体内通过 def 定义的内层函数)和 lambda 匿名函数的限定名通常包含 <locals>(例如 main.<locals>.task)。这种名称在模块顶层作用域中是不存在的,子进程无法动态寻址,因此标准库直接判定其不可序列化并抛出 Can't pickle local object。
from multiprocessing import Pool

def start_jobs():
    factor = 10
    # 局部嵌套函数,包含外部闭包变量 factor
    def compute(x):
        return x * factor

    with Pool(4) as p:
        # 报错:_pickle.PicklingError: Can't pickle local object 'start_jobs.<locals>.compute'
        results = p.map(compute, [1, 2, 3, 4])
    return results

if __name__ == '__main__':
    start_jobs()
陷阱 2:传递绑定了不可序列化系统资源的实例方法
在面向对象编程中,很多开发者习惯直接将类的成员方法传递给进程池,例如 pool.map(self.run_item, items)。但需要特别注意的是:在 Python 内部,self.run_item 是一个绑定方法(Bound Method),它持有着指向 self 实例的强引用。
序列化 self.run_item 会迫使 pickle 递归序列化整个 self 对象及其内部包含的所有成员属性。如果你的类在 __init__ 中初始化了数据库连接(如 PyMySQL 连接句柄)、打开的文件对象(file)、网络套接字(socket)、图形界面上下文、或者用于多线程同步的锁(threading.Lock),整个实例就会因为这个不可序列化的成员而导致任务派发崩溃。
import threading
from multiprocessing import Pool

class DataProcessor:
    def __init__(self, log_path):
        self.lock = threading.Lock() # Lock 无法跨进程序列化
        self.file_handle = open(log_path, "a") # 打开的 OS 文件描述符无法 pickle

    def process(self, x):
        # 即使 process 本身只做数学计算,但因为它是绑定方法,打包时会连同 self.lock 一起序列化
        return x * x

    def run_parallel(self, data):
        with Pool(4) as p:
            # 报错:TypeError: cannot pickle '_thread.lock' object
            return p.map(self.process, data)

if __name__ == '__main__':
    processor = DataProcessor("app.log")
    processor.run_parallel([1, 2, 3])
陷阱 3:生成器对象、协程或活动动态闭包
生成器函数返回的生成器对象(Generator Object)、异步协程(Coroutine)、以及动态迭代器等,其运行状态受 CPython 运行时的执行栈帧(Frame)控制。Python 标准 pickle 协议无法对当前函数的 CPU 寄存器与执行帧进行无损序列化,因此试图将生成器或协程作为多进程入参或返回值都会报错:
错误示例 3:向进程池传递生成器对象from multiprocessing import Pool
def square(val):
return val * val
def gen_numbers():
for i in range(10):
yield i
if __name__ == '__main__':
with Pool(4) as p:
# 生成器对象 gen_numbers() 作为任务单项传递将报错
# 报错:TypeError: cannot pickle 'generator' object
# 提示:应将生成器解构为参数序列或转为列表
data_gen = (x for x in range(10))
p.apply_async(square, args=(data_gen,)).get()陷阱 4:交互式环境(Jupyter / IPython)下的主入口寻址失败
在 macOS(Python 3.8+ 默认使用 spawn 启动方式)或 Windows 系统上,子进程启动时不会使用 fork 直接复制父进程内存,而是启动一个全新的 Python 解释器,并重新 import 启动脚本。在 Jupyter Notebook 中,单元格中动态定义的类与函数位于虚拟的 __main__ 命名空间中,并没有对应的物理磁盘 .py 文件。子进程在新解释器中导入 __main__ 时无法找到这些定义,同样会抛出 AttributeError: Can't get attribute 'xxx' on <module '__main__'> 或 PicklingError。
fork,子进程会复制父进程内存,有时会“掩盖”顶层导入和部分闭包的缺陷;但从 Python 3.8 开始,macOS 默认启动方式已经由 fork 改为了 spawn(与 Windows 保持一致)。在 Linux 运行正常的代码,迁移到 macOS 或 Windows 上出现 PicklingError,往往正是因为 spawn 模式下子进程必须通过全新导入来反序列化。
三、PicklingError 的标准排查与定位流程
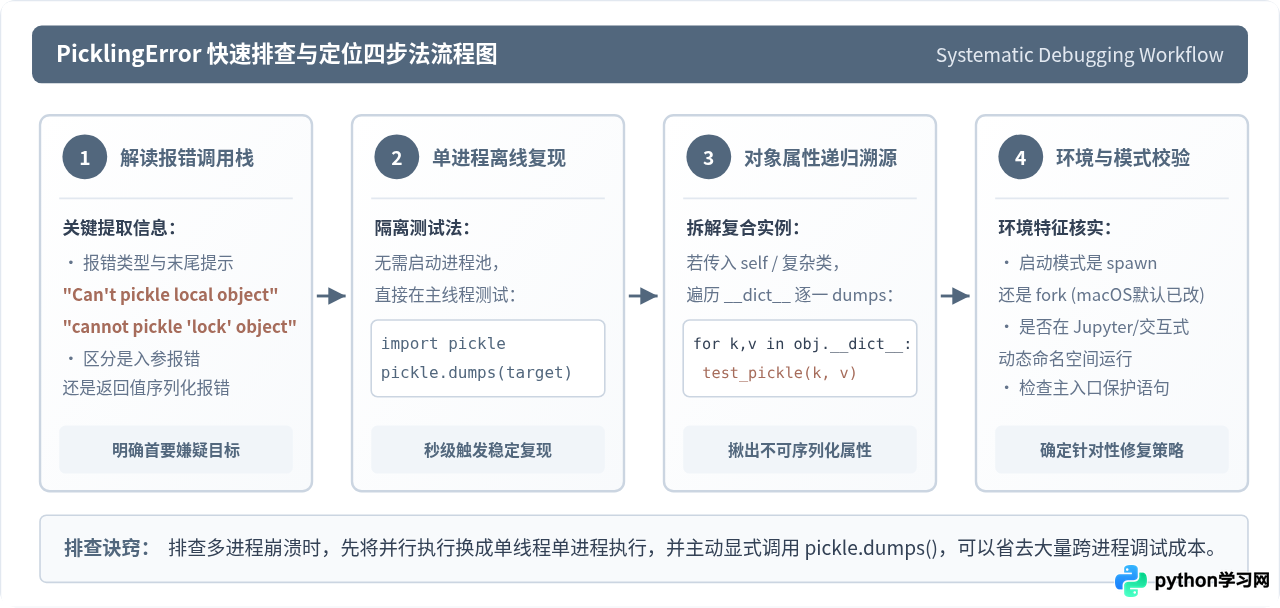
多进程抛出报错时,往往夹杂着进程间异常转发的大量内部追踪代码,令人眼花缭乱。按照下列四个步骤,可以在数分钟内精确定位不可序列化的罪魁祸首:
-
第一步:从 Traceback 末行提取靶标类型与名字。
查看报错最后一行。如果提示Can't pickle local object 'foo.<locals>.bar',直接去代码中定位名为bar的局部函数;如果提示cannot pickle '_thread.lock' object,说明是传递的对象内部夹带了线程锁。 -
第二步:脱离多进程环境,使用
pickle.dumps()编写最小复现沙箱。
不要在庞大的任务分发循环中盲目调试。在主线程中直接对目标函数、参数单独执行pickle.dumps(obj):import pickle # 测试目标函数与入参对象是否满足序列化契约 try: pickle.dumps(my_task_func) print("目标函数可序列化") pickle.dumps(my_payload) print("输入参数可序列化") except Exception as e: print(f"定位到失败目标: {e}") -
第三步:对复杂复合对象进行属性二分/递归排查。
如果传递的是类实例self或复杂的配置字典,使用下列小脚本遍历对象的__dict__,迅速揪出不可序列化的那个具体属性:import pickle def audit_object_picklable(obj): if not hasattr(obj, '__dict__'): return for key, value in obj.__dict__.items(): try: pickle.dumps(value) except Exception as err: print(f"[!] 不可序列化属性发现: 属性名 '{key}', 类型 '{type(value)}', 错误: {err}") # 调用排查 audit_object_picklable(my_processor_instance) -
第四步:确认启动模式与执行入口完整性。
确保主执行入口包裹在if __name__ == '__main__':保护块内。如果在交互式环境运行,检查是否需要将核心工作函数封装为独立的外部.py模块引入。
四、核心工程解决方案与代码重构
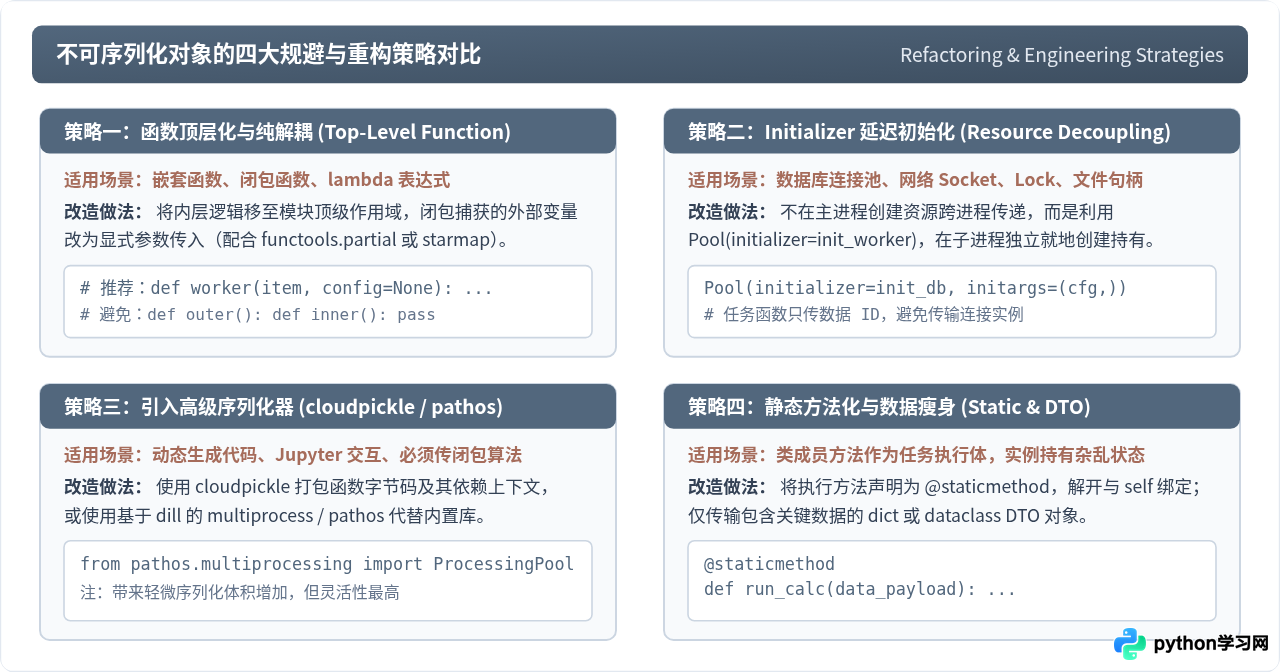
根据排查得出的具体原因,工程上有四种成熟、清晰且标准化的改造规避方案。
方案一:重构为模块顶层函数,使用 partial 或显式传参
对于局部嵌套函数和 lambda 表达式,最简单、最根本的解法是将函数移出到 Python 文件的顶层作用域,使其具有全局唯一、可直接导入的限定名。如果原本嵌套函数依赖外层环境的只读配置,改用 functools.partial 冻结参数,或者直接将配置作为元组打包传入。functools.partial 对象在 Python 3 中是完全支持 pickle 序列化的。
from multiprocessing import Pool
from functools import partial

# 1. 提升为模块顶层函数,具备唯一的限定名
def compute_task(factor, item):
    return item * factor

def run():
    factor = 10
    items = [1, 2, 3, 4]

    # 2. 使用 partial 绑定通用参数,partial 对象支持完整序列化
    bound_worker = partial(compute_task, factor)

    with Pool(4) as p:
        results = p.map(bound_worker, items)
    print("执行结果:", results)

if __name__ == '__main__':
    run()
方案二:采用 Pool initializer 模式实现系统资源延迟绑定
面对数据库连接(Database Connection)、网络会话(Session)、线程锁(Lock)以及大型本地资源,绝不能在主进程初始化后跨进程传输。正确的架构原则是:“跨进程只传参数标识,不传资源句柄”。
利用 multiprocessing.Pool 提供的 initializer 参数,我们可以在每个子进程刚刚诞生时,为其独立执行一次资源初始化函数,将连接保存在子进程的全局变量或单例中。任务函数只接收轻量的 ID 或查询条件,在子进程内部直接使用本地连接完成工作。
from multiprocessing import Pool

# 定义子进程局部全局对象
worker_db_conn = None

def init_worker(db_config):
    """每个子进程启动时只执行一次,在各自独立的内存空间建立连接"""
    global worker_db_conn
    # 在子进程本地创建不可序列化的真实连接
    print(f"子进程初始化资源连接: {db_config['host']}")
    worker_db_conn = f"DB_Connection_to_{db_config['host']}"

def execute_query(query_id):
    """任务函数只传递基础纯数据(query_id),无需传递连接对象"""
    global worker_db_conn
    # 直接使用子进程本地持有的资源句柄
    return f"任务 {query_id} 通过 {worker_db_conn} 完成查询"

def main():
    cfg = {"host": "192.168.1.100", "port": 3306}
    task_ids = [101, 102, 103, 104]

    # 通过 initializer 传递配置参数,由子进程就地创建连接
    with Pool(processes=2, initializer=init_worker, initargs=(cfg,)) as pool:
        outputs = pool.map(execute_query, task_ids)

    for item in outputs:
        print(item)

if __name__ == '__main__':
    main()
方案三:类方法静态化与 DTO 数据瘦身(避免传递绑定 self)
如果业务代码高度封装在面向对象类中,不能简单将方法全部挪到模块外,可以将目标方法声明为 @staticmethod 或独立类方法,切断其对整个 self 状态树的隐式绑定;同时入参改用轻量的字典、命名元组(namedtuple)或 dataclass 数据传输对象(DTO)。
import threading
from multiprocessing import Pool

class OrderPipeline:
    def __init__(self):
        # 不可序列化的本地资源
        self.notify_lock = threading.Lock()

    @staticmethod
    def calc_order_tax(order_dto):
        """静态方法:不隐式绑定 self,仅依赖入参纯数据"""
        order_id, amount = order_dto
        tax = amount * 0.08
        return {"order_id": order_id, "tax": tax}

    def run(self, order_list):
        # 仅打包轻量元组传入,彻底摆脱 self.notify_lock 的干扰
        with Pool(4) as p:
            return p.map(self.calc_order_tax, order_list)

if __name__ == '__main__':
    pipeline = OrderPipeline()
    orders = [(1, 100.0), (2, 250.0), (3, 80.0)]
    print(pipeline.run(orders))
方案四:引入增强型序列化库(cloudpickle / dill / pathos)
在某些特定场景下(例如编写科学计算工作流、机器学习特征流水线、或必须在 Jupyter Notebook 中执行动态生成的算法函数),强制将代码重构为静态顶层函数往往成本极高。此时,可以借助社区成熟的增强序列化工具:
-
cloudpickle:被 Apache Spark、Ray、Dask 等大型分布式计算系统采用。它能够抽取函数的 Python 字节码、底层变量上下文以及动态生成的类,将其序列化为二进制。 -
pathos/multiprocess:由加州理工团队维护,用dill替换了 Python 标准库底层的pickle,提供了与标准库接口完全兼容的ProcessingPool,开箱支持局部函数、lambda 和闭包。
# 依赖安装: pip install pathos
from pathos.multiprocessing import ProcessingPool

def run_dynamic_pipeline():
    multiplier = 5.5

    # 动态闭包函数在标准 multiprocessing 会报错,但在 pathos 下可顺利运行
    dynamic_func = lambda x: x * multiplier + 10

    data = [1, 2, 3, 4]
    with ProcessingPool(nodes=4) as pool:
        # pathos 内部使用 dill 序列化字节码,完美支持闭包传输
        results = pool.map(dynamic_func, data)

    print("Pathos 并行运算结果:", results)

if __name__ == '__main__':
    run_dynamic_pipeline()
五、各修复方案对比与选型原则
面对不同的业务约束与开发阶段,选择哪种方式解决 PicklingError 需要在代码侵入性、性能开销以及第三方依赖之间进行权衡。
| 方案 | 典型适用场景 | 核心优点 | 潜在代价 / 限制 |
|---|---|---|---|
| 顶层函数 + 显式传参 | 嵌套函数、lambda、内部闭包计算 | 标准库原生支持,零额外开销,结构最清晰规范 | 需要微调现有代码组织,不适合强动态代码 |
| Pool Initializer | 数据库、Redis连接、锁、大型本地模型 | 内存利用率极高,杜绝跨进程句柄失效风险 | 每个子进程持有独立连接,需注意连接池上限 |
| 静态方法 + DTO | 复杂业务类实例中的纯计算逻辑 | 保持面向对象组织,完全解除对 self 的污染 | 需要将方法解耦,入参与返回值须结构化 |
| cloudpickle / pathos | Jupyter交互分析、算法探索、动态生成函数 | 开发侵入性极低,直接支持 lambda 与闭包 | 引入第三方依赖,字节码序列化存在微量性能损耗 |
六、长期规避原则与工程决策总结
为了避免在项目后期反复陷入跨进程序列化排错的泥潭,在进行 Python 多进程架构设计时,建议遵循以下工程决策路径:
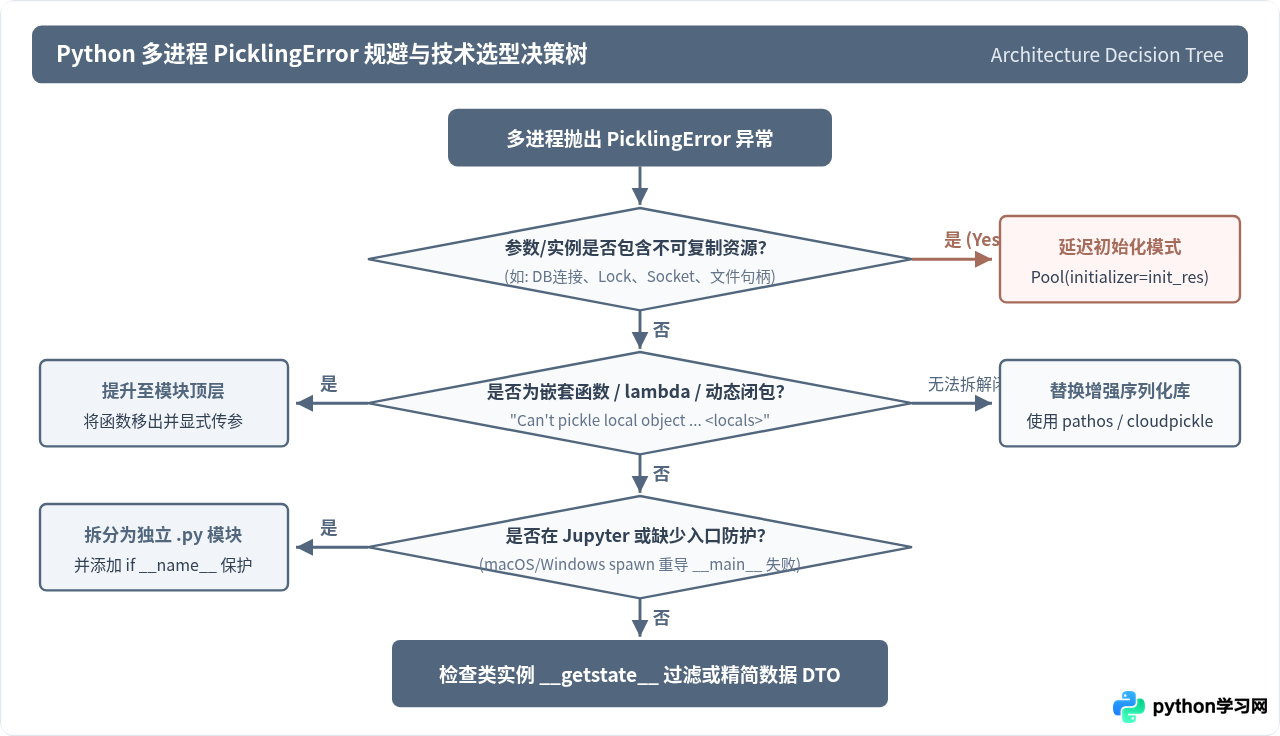
- 只传数据,不传句柄:跨进程 IPC 管道只用来传输结构简单的纯数据(字符串、数值、字典、列表、NumPy 数组等)。凡是涉及 I/O 连接、操作系统描述符、同步锁的操作,一律放在子进程的内部独立创建。
- 保持任务函数的“纯函数”特性:多进程的工作函数尽可能保持无副作用、与外部作用域解耦,并置于模块全局可见的顶层,绝不直接将绑定了复杂状态的
self.method送入进程池。 - 主入口永远配置守卫:必须严格遵守
if __name__ == '__main__':入口约束,避免在 Windows / macOS 的spawn环境下产生递归拉起或命名空间污染。
遵循上述规避准则,不仅能够彻底根除 PicklingError,而且能让并发模块的数据流动方向一目了然,从根本上提升多进程系统的稳定性与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















