


Python多进程中join()、get()与terminate()的执行顺序与区别

假设你正在使用 Python 的 multiprocessing 模块开发一个数据密集型批处理程序:主进程派生出若干子进程处理任务,并通过队列接收汇总数据。然而在执行过程中,程序经常神秘地永久停顿,或者子进程意外残留为僵尸进程,甚至在尝试强行停止后导致队列锁死。这类问题绝大多数源于对 join()、get() 和 terminate() 的职责定位不清与调用时序颠倒。本文将直接拆解三者的核心机制与本质差异,重点梳理它们在不同场景下的标准执行顺序,帮助你彻底避开死锁与资源泄漏陷阱。
一、三者职能定位与多进程生命周期
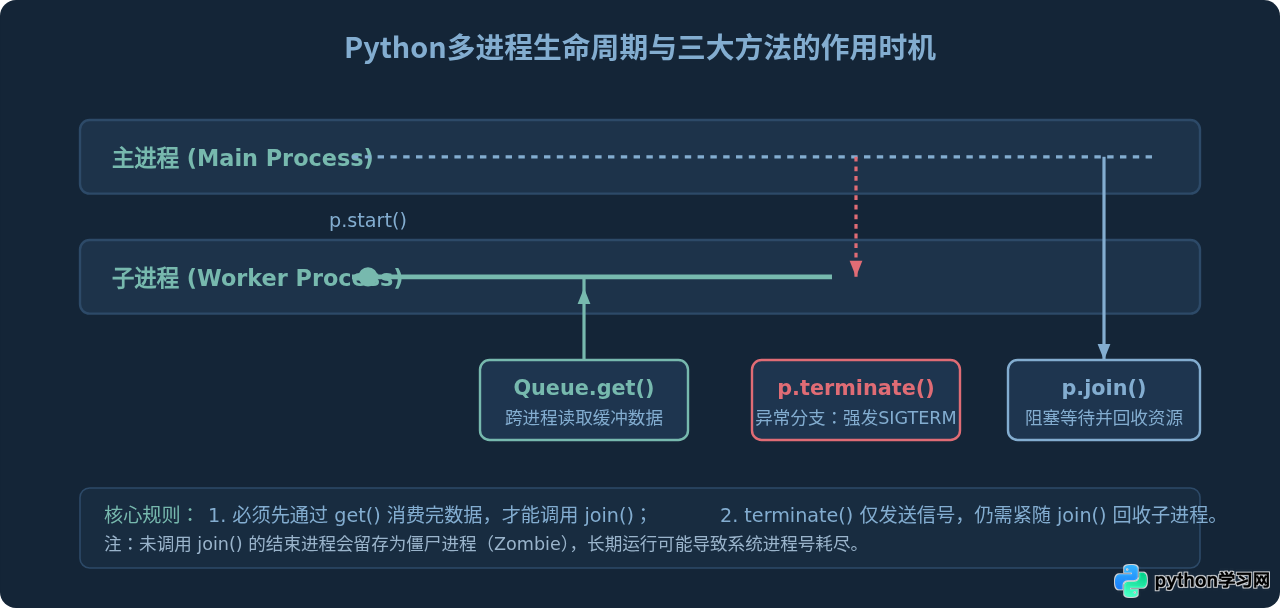
在 Python 多进程体系中,join()、get() 与 terminate() 分别属于生命周期管理、进程间通信(IPC)和控制干预三个不同的抽象层次:
- join():归属于进程生命周期管理。其核心作用是阻塞调用者(通常是主进程),直到目标子进程完全执行完毕并退出,同时完成子进程状态与系统资源的回收。
- get():归属于进程间通信或异步结果获取。主要用于
multiprocessing.Queue读取数据,或AsyncResult.get()获取异步任务的返回结果,本质上是数据流交互。 - terminate():归属于外部控制信号。它向子进程发送强制终止信号(类 Unix 平台发送 SIGTERM,Windows 平台调用 TerminateProcess),用于非正常结束子进程任务。
二、核心方法的作用与机制剖析
1. join():同步等待与资源终结者
当在主进程中调用 p.join() 时,主进程的当前线程会被阻塞,暂停向下执行,直到子进程 p 完成所有任务并自然退出。join() 支持传入 timeout 浮点型秒数参数。
为什么必须使用 join()?在类 Unix 操作系统中,子进程执行完毕退出后,进程内核描述符并未立即注销,而是保留了进程号(PID)、退出状态和资源使用统计。这一状态下的进程被称为“僵尸进程”(Zombie Process)。只有当父进程调用 waitpid()(在 Python 中被封装在 join() 中)读取退出状态后,操作系统才会真正释放这些结构。若程序长期运行且不断产生未回收的子进程,系统可用 PID 将被占满。
2. get():阻塞拉取与结果反序列化
get() 在多进程场景中主要出现在两种常见对象上:
- multiprocessing.Queue.get([block[, timeout]]):从跨进程队列中取出一个对象。默认情况下
block=True,若队列为空则阻塞等待,直到有子进程放入数据或超时抛出queue.Empty。 - multiprocessing.pool.AsyncResult.get([timeout]):用于进程池异步调用
apply_async()返回的结果对象。调用它会阻塞等待该具体子任务返回计算结果。若子任务抛出异常,get()会将异常重新抛出在主进程中。
3. terminate():非优雅强杀与状态破坏者
p.terminate() 用于立即强行终止目标进程。需要特别警惕的是:
terminate() 不会执行任何清理工作(例如不会触发 try...finally 块,也不会清空或刷新输出缓冲区)。如果子进程在被杀的瞬间正在持有 multiprocessing.Lock,或者正在向 multiprocessing.Queue 写入序列化数据,那么该锁将永远无法被释放,队列的底层管道也会彻底损坏,导致后续尝试访问该锁或队列的其它进程集体死锁。
此外,terminate() 本身是非阻塞的异步调用。它只负责向操作系统发出终止信号就立即返回,子进程并不会在微秒级瞬间消失。因此,在调用 terminate() 之后,依然必须紧接着调用 join(),以确保等待子进程完全终止并清理其进程表条目。
三、执行顺序陷阱与实战排错
1. 经典死锁陷阱:Queue.get() 与 Process.join() 的顺序错位
这是多进程初学者最常遭遇、且隐蔽性极高的一处错误。先观察下面这段反面示例:
# 错误示例:先 join() 后 get() 导致死锁
import multiprocessing
import time

def worker(q):
    # 子进程向队列写入大量数据
    for i in range(100000):
        q.put(f"data_payload_{i}")
    print("子进程写入完成")

if __name__ == '__main__':
    queue = multiprocessing.Queue()
    p = multiprocessing.Process(target=worker, args=(queue,))
    p.start()

    # 错误调用顺序:主进程先等待子进程结束
    p.join()  # <--- 程序在此永久卡死!

    # 主进程尝试拉取数据
    results = []
    while not queue.empty():
        results.append(queue.get())
死锁成因分析:multiprocessing.Queue 底层基于操作系统管道(OS Pipe)和一个后台守护线程(Feeder Thread)实现。管道的内核缓冲区大小是有限的(通常为 64KB)。当写入数据量超过缓冲区上限时,子进程的底层写入系统调用会被阻塞,等待管道读取端取走数据。此时,子进程在等待主进程 get() 清空管道,而主进程却在 join() 阻塞等待子进程退出。两者互不相让,形成死锁。
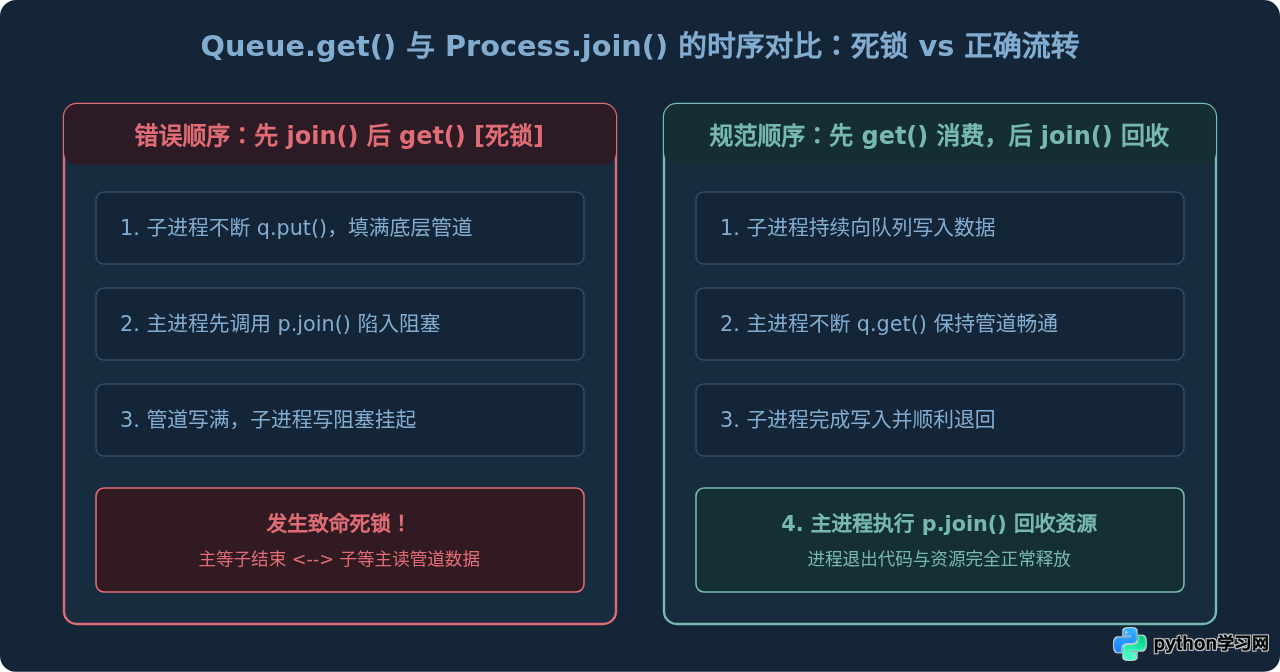
标准修正代码:先读取数据,再回收进程;或者借助毒丸(Poison Pill,如 None)作为结束标志:
# 正确规范:主进程先读取消费,再执行 join()
import multiprocessing

def worker(q):
    for i in range(100000):
        q.put(f"data_payload_{i}")
    q.put(None)  # 发送终止信号标记(毒丸)

if __name__ == '__main__':
    queue = multiprocessing.Queue()
    p = multiprocessing.Process(target=worker, args=(queue,))
    p.start()

    results = []
    # 步骤1:持续从队列获取数据,直到接收到结束标记
    while True:
        item = queue.get()
        if item is None:
            break
        results.append(item)

    # 步骤2:数据全部出队后,再安全阻塞等待子进程退出并回收资源
    p.join()
    print(f"成功安全回收,共获取数据项:{len(results)}")
2. 进程池(Pool)环境下的执行顺序准则
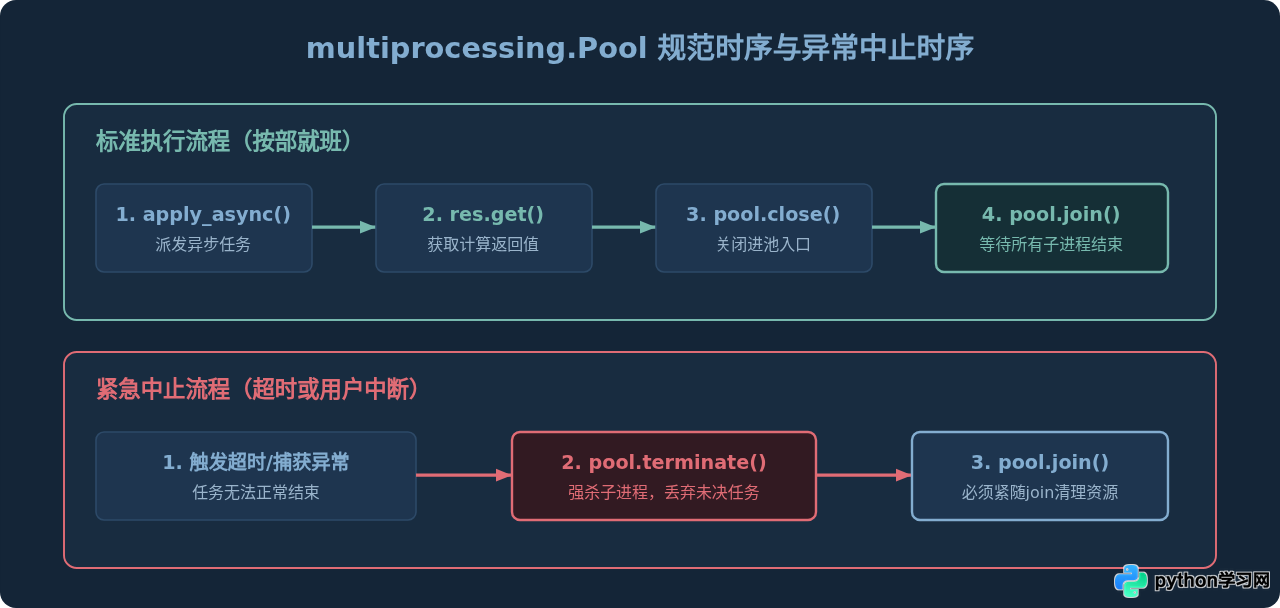
当使用 multiprocessing.Pool 时,这几个方法的调用对象与执行顺序有所不同:
close():阻止后续新的任务提交到进程池。必须在join()之前调用。terminate():立即终止进程池中的工作进程,放弃尚未开始的任务。join():等待进程池中的所有工作进程退出。注意:pool.join()必须严格在pool.close()或pool.terminate()之后调用,否则会直接引发ValueError: Pool is still running。
# 进程池典型规范示例
from multiprocessing import Pool
import time

def task(n):
    return n * n

if __name__ == '__main__':
    with Pool(processes=4) as pool:
        # 1. 异步提交任务
        async_results = [pool.apply_async(task, (i,)) for i in range(10)]

        # 2. 依次提取结果(可指定 timeout)
        outputs = [res.get(timeout=5) for res in async_results]
        print("计算结果:", outputs)

        # 3. 关闭新任务入口
        pool.close()

        # 4. 等待所有工作进程退出
        pool.join()
四、join()、get() 与 terminate() 的核心区别对比
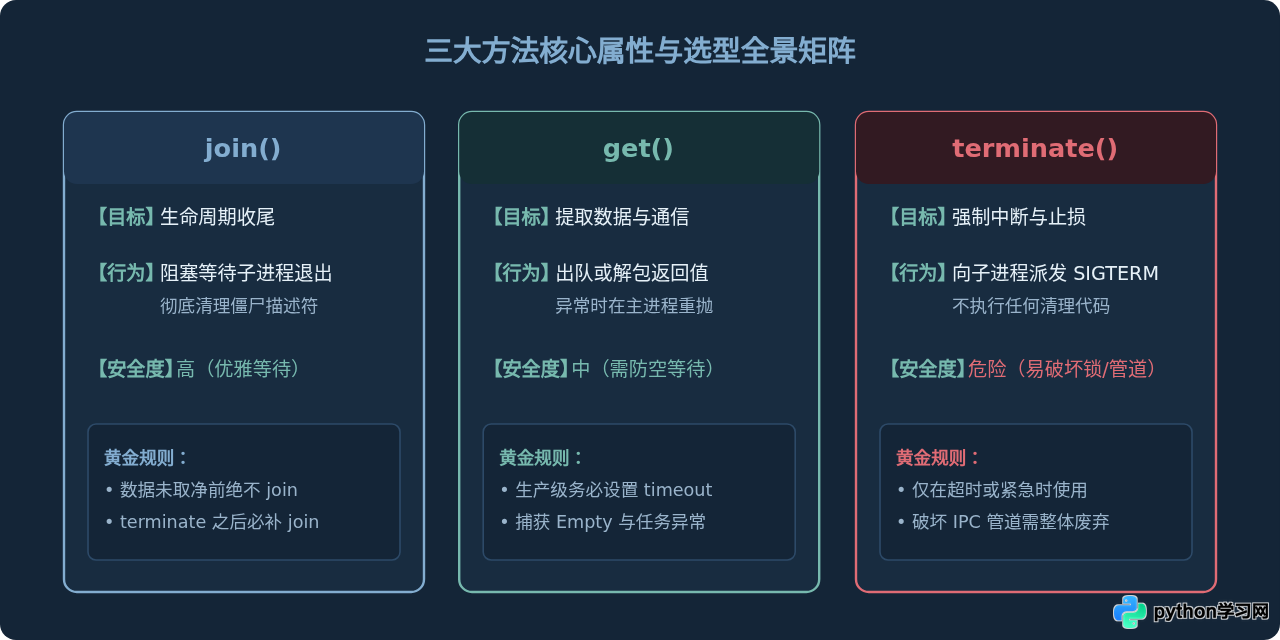
为了让读者一目了然地辨析这三者的差别,下表从调用主体、阻塞模式、副作用与典型使用条件进行了系统归纳:
| 对比维度 | join() | get() | terminate() |
|---|---|---|---|
| 归属对象 | Process 或 Pool |
Queue 或 AsyncResult |
Process 或 Pool |
| 核心职能 | 阻塞等待进程结束并回收系统资源 | 从通信管道或异步任务中取出数据/结果 | 发送操作系统信号强制终止子进程 |
| 阻塞特性 | 默认阻塞,支持设置 timeout |
默认阻塞,支持设置 timeout |
完全非阻塞,仅发出信号便返回 |
| 副作用与风险 | 若子进程死锁,主进程将永久挂起 | 若队列长期无数据且未设超时,将永久等待 | 可能破坏锁状态、损坏管道导致死锁 |
| 调用时机 | 任务末尾,必须在消费完队列数据后调用 | 任务运行中或完成后,在 join() 之前 |
任务异常超时、用户主动取消或紧急停机 |
| 后续必要操作 | 无(自身即为终结动作) | 全部数据提取完毕后执行 join() |
必须紧跟 join() 以回收僵尸状态 |
五、常见问题与工程最佳实践
1. terminate() 之后为什么在系统进程表中还能看到子进程?
因为 terminate() 发送信号之后便立即返回,子进程收到信号结束运行,但由于主进程尚未调用 join(),子进程便停留在僵尸状态(Zombie,进程状态标记为 Z 或 defunct)。此时操作系统依旧保留其 PID。只有在主进程执行 p.join() 之后,该条目才会彻底消失。
2. 使用上下文管理器 with Pool() as pool: 是否能省去 close() 和 join()?
在 Python 3.7+ 中,with Pool() as pool: 在退出 __exit__ 代码块时会自动执行 pool.terminate(),然后调用 pool.join()。这意味着如果在上下文末尾没有显式调用 pool.close() 和 pool.join(),离开 with 块时正在排队或执行的任务会被直接强杀(terminate)!因此:如果你希望所有提交的任务正常完整运行,依然必须在 with 内部显式编写 pool.close() 和 pool.join()。
3. 如何优雅停止子进程而不破坏管道或引发死锁?
工程实践中,推荐优先采用“事件标志位”(multiprocessing.Event)或“队列毒丸”(Poison Pill)机制通知子进程主动退出:
- 主进程设置
stop_event.set()或放入特殊对象queue.put(None)。 - 子进程在工作循环中检测到标志后,自行执行清理并
break退出。 - 主进程在
p.join(timeout=3)设定一个宽限期;如果子进程在宽限期内未能优雅退出,最后才降级使用p.terminate()强制收场。
数据通信先
get(),清空管道免窒息;资源释放必
join(),清理僵尸保长青;强杀慎用
terminate(),随手补 join() 防残留。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















