


python函数单一职责原则怎么写
本文详细讲解在Python中如何编写符合单一职责原则(SRP)的函数。从识别多职责函数的坏味道切入,提供清晰的四步拆分重构方法、前后对比代码以及避免过度设计的实用建议。
一、什么是函数的单一职责:从多重修改动因谈起
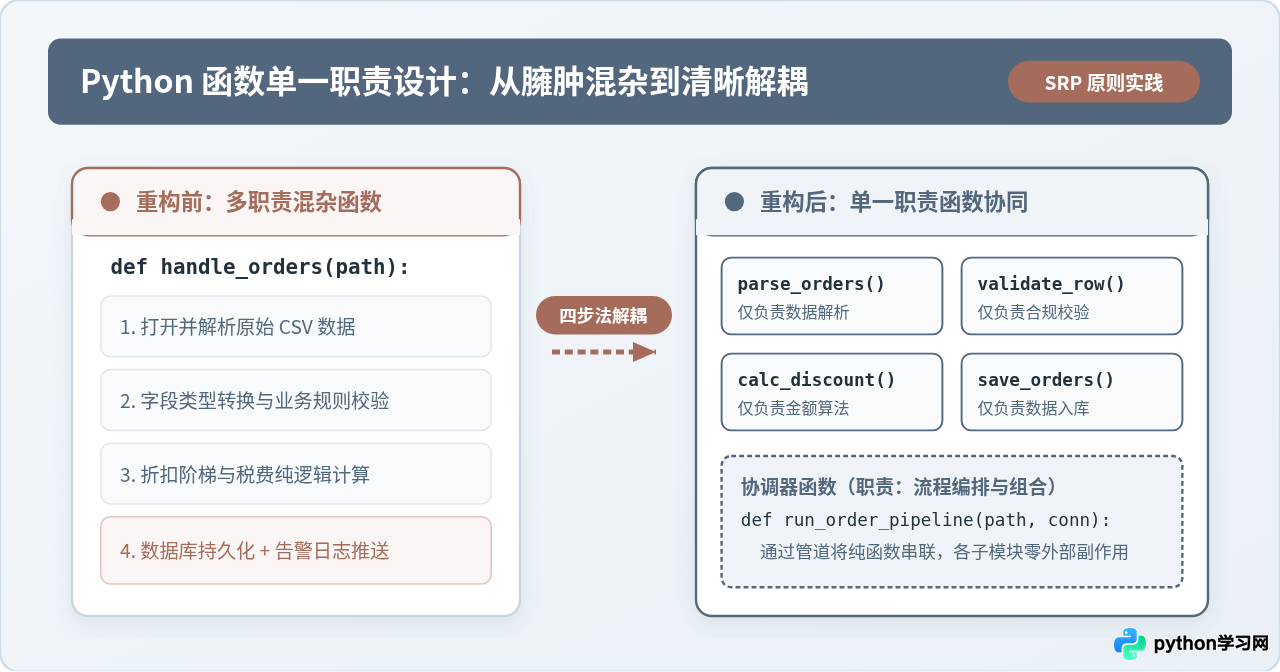
在许多日常 Python 项目中,我们经常能看到类似下面这样的函数定义:开发者为了“方便”,顺手把读取 CSV 文本、过滤异常字符、根据会员等级计算折扣金额、执行 SQL 更新数据库以及调用企业微信接口告警全部塞进一个名为 process_orders(file_path) 的长函数里。从功能上看,这个函数确实“完成了整个业务”;但在代码演进过程中,它立刻会变成整个模块最脆弱的瓶颈。
罗伯特·C·马丁(Uncle Bob)在定义单一职责原则时,给出了一个至关重要的判断基准:“一个模块应当仅对某一类参与者或系统变更负责,即只拥有一个改变的理由(Reason to Change)。”
当一个函数同时处理文件格式、业务算法和数据库操作时,任何一个外部环境的波动都会迫使你修改这个函数:
- 如果上游导出的 CSV 新增了字段或修改了编码,你需要修改它;
- 如果运营团队调整个别 VIP 用户类别的折算百分比,你需要修改它;
- 如果底层存储从本地 SQLite 迁移到远程 PostgreSQL,你还需要修改它;
- 如果飞书/钉钉告警接口的 Payload 格式升级,你依旧得修改它。
这意味着该函数承载了 4 种完全不同的修改理由。在敏捷迭代中,多人在同一个函数中提交不同维度的修改,极易引发代码冲突、隐式变量污染和连锁回归故障。
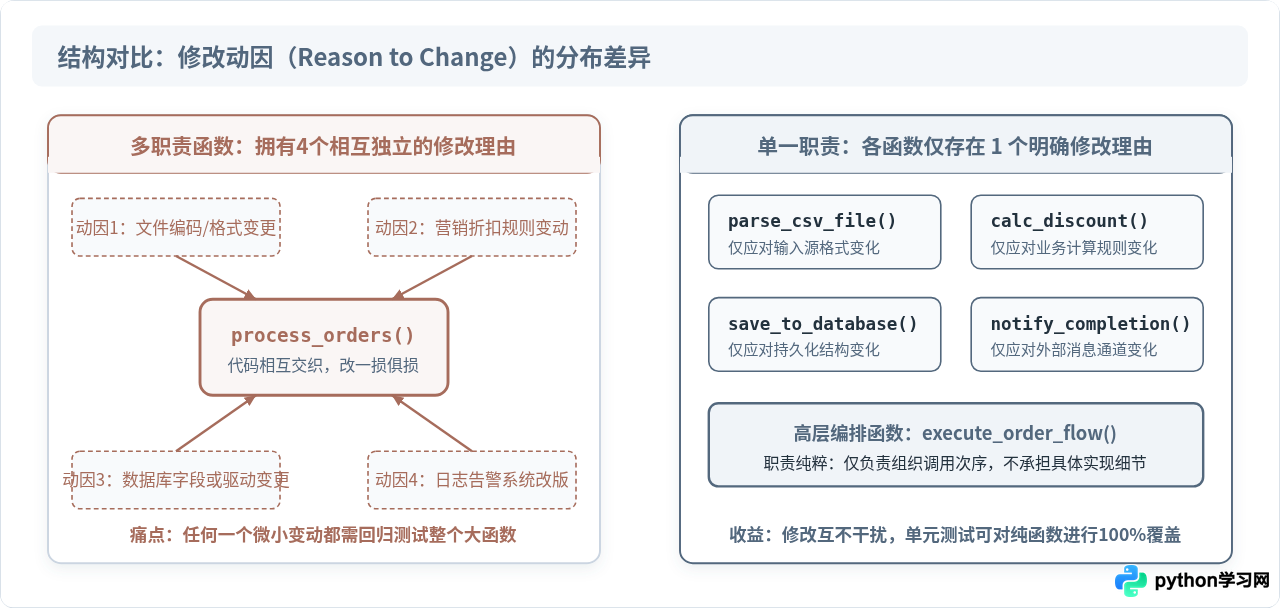
相反,右侧的单一职责结构将各个独立的关注点彻底分离开来:负责数据解析的函数只关心字符串和数据格式;负责计算折扣的函数只关心数学逻辑与领域实体;负责存储的函数只关心数据库连接与事务。高层仅通过一个协调函数进行串联,各环节边界分明。
二、识别“多职责”函数的 4 大典型坏味道
要在实际开发中落实单一职责,首先必须培养敏锐的代码坏味道识别能力。当你在 review 自己的代码或已有历史代码时,出现以下四个信号中的任意一个,通常意味着函数已经违反了 SRP 原则。
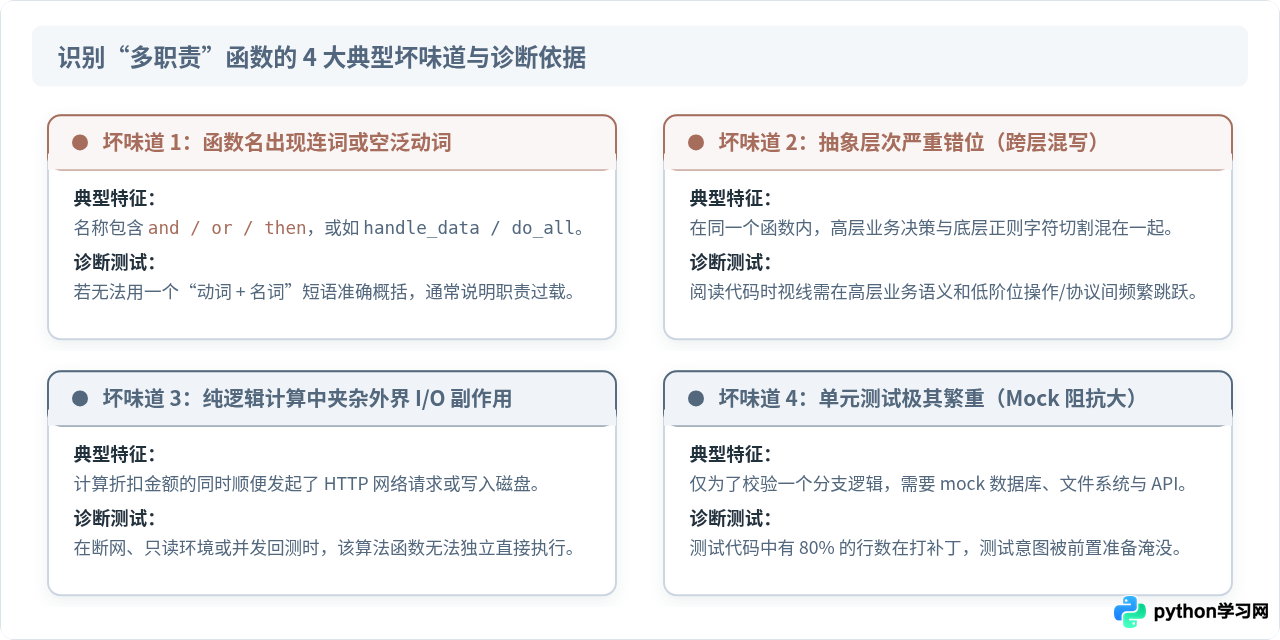
1. 函数名出现连词或语义泛化
如果函数的名称中出现了 and、or、then,例如 load_data_and_calculate_tax()、validate_then_save(),说明函数从命名阶段就已经承认自己在做两件以上的事情。另一种情况是使用过于宽泛的动词,例如 handle_all()、manage_request()、deal_with_records(),这种名字往往掩盖了其内部杂乱无章的责任链。
2. 抽象层次严重错位(高低层细节杂糅)
优秀函数的代码应当保持在单一抽象层次(Single Level of Abstraction Principle, SLAP)。如果在一个函数内部,前两行在进行高层抽象的业务决策(例如 if user.is_eligible_for_rebate:),紧接着下一行直接调用底层的低阶操作(例如用正则切分字符串 re.split(r'\s*[,|]\s*', line) 或操作二进制字节流),读者的注意力就会在宏观业务与微观语法之间被来回撕扯,这就是典型的职责过载。
3. 核心计算中夹带 I/O 副作用(Side Effects)
纯计算逻辑(如公式核算、数据结构转换)应当是无副作用的纯函数——给定相同输入,必然返回相同输出,不依赖也不改变外部世界状态。如果在计算循环内部突然出现了 requests.post()、file.write() 或修改了全局变量,该函数就同时承担了“算法逻辑”与“环境交互”双重责任,导致它在无网络或离线单元测试场景中完全无法独立运行。
4. 单元测试阻抗巨大(Mock 爆炸)
衡量函数职责是否单一的试金石就是编写单元测试的难易程度。如果你想测试“当商品满 200 元时是否正确扣减 20 元”,却必须在 pytest 中引入 5 个 unittest.mock.patch 来打桩数据库连接池、外部 HTTP 接口和临时磁盘文件,那么这个函数必定违反了单一职责原则。一个职责专一的计算函数,其测试应当只需要三行代码:构造简单输入数据、调用函数、断言返回值。
三、函数单一职责拆分四步法与实战重构
理解了判据之后,我们通过一套标准化的“四步重构法”来把多职责函数系统性地重塑为优雅、健壮的 Python 代码。
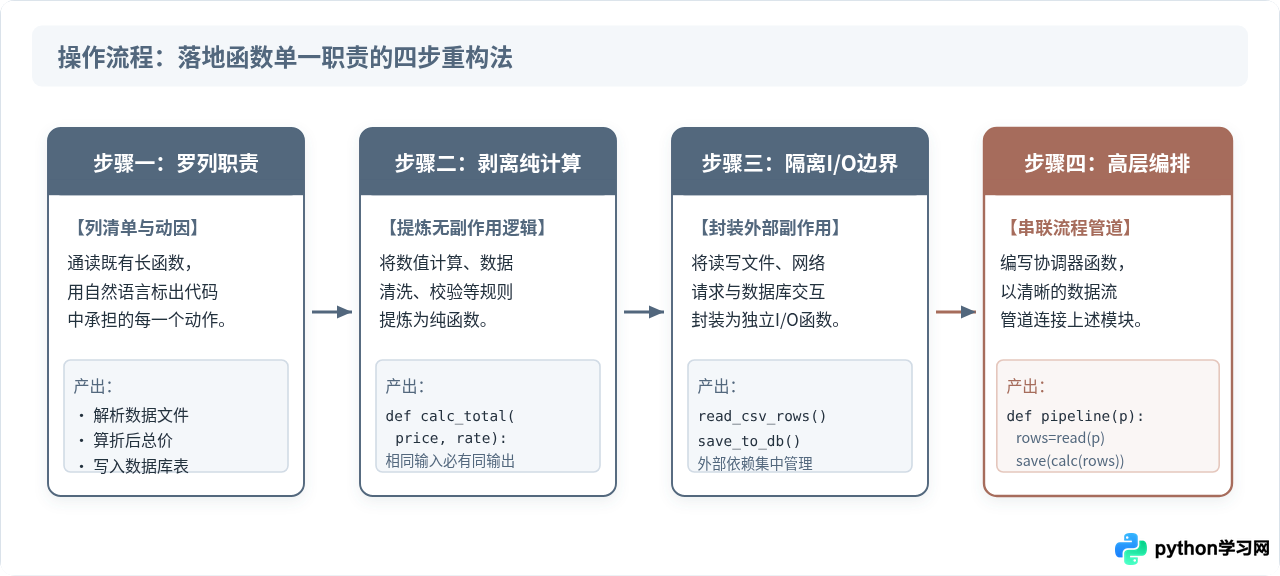
场景案例:待重构的多职责臃肿函数
假设我们有一个处理电商销售记录的函数 process_sales_file。它接收一个 CSV 文件路径,校验订单格式、计算VIP会员折扣并写入 SQLite 数据库:
# -------------------------------------------------------------------------
# 重构前:违反单一职责原则的单体臃肿函数
# -------------------------------------------------------------------------
import sqlite3

def process_sales_file(file_path: str, db_path: str) -> dict:
    # 职责 1:文件读取与原始字符串分割
    valid_records = []
    with open(file_path, "r", encoding="utf-8") as f:
        lines = f.readlines()

    header = lines[0].strip().split(",")
    for line in lines[1:]:
        parts = [p.strip() for p in line.strip().split(",")]
        if len(parts) != 4:
            continue
        order_id, user_level, raw_amount, quantity = parts

        # 职责 2:字段合规性校验与数据清洗
        try:
            amount = float(raw_amount)
            qty = int(quantity)
            if amount <= 0 or qty <= 0:
                continue
        except ValueError:
            continue

        # 职责 3:核心商业折扣与税率算法计算
        discount_rate = 1.0
        if user_level == "VIP":
            discount_rate = 0.85 if amount * qty >= 500 else 0.90
        elif user_level == "GOLD":
            discount_rate = 0.80

        final_price = round(amount * qty * discount_rate, 2)
        valid_records.append((order_id, user_level, final_price))

    # 职责 4:数据库连接管理与持久化写入
    conn = sqlite3.connect(db_path)
    cursor = conn.cursor()
    cursor.execute("""
        CREATE TABLE IF NOT EXISTS processed_orders
        (order_id TEXT PRIMARY KEY, user_level TEXT, final_price REAL)
    """)
    cursor.executemany(
        "INSERT OR REPLACE INTO processed_orders VALUES (?, ?, ?)",
        valid_records
    )
    conn.commit()
    conn.close()

    return {"total_processed": len(valid_records)}
重构步骤分解与落地
-
步骤一:圈定职责清单与抽取边界
用自然语言标注出上面代码的职责列表:1) 解析 CSV 文本;2) 校验单条记录并转换类型;3) 会员折扣金额计算;4) 数据库持久化存储;5) 上层组织调度。 -
步骤二:提炼无副作用的核心纯函数(Pure Functions)
将数据类型校验和商业折扣算法独立出来,定义强类型数据契约(例如借助 Python 3.7+ 的dataclasses)。这些函数没有任何外部依赖,执行迅速且测试极其简便。 -
步骤三:将副作用隔离在专门的 I/O 适配层
编写只负责读取 CSV 并返回结构化对象的读取器,以及只负责接收数据对象并写入数据库的写入器。 -
步骤四:编写高层管道编排函数(Coordinator)
由顶层函数把控业务流程。请注意:编排本身就是一种明确的职责。编排函数只负责把前一个函数的产物传给后一个函数,自己绝不掺杂具体业务计算逻辑。
重构后的完整 Python 代码
# =========================================================================
# 重构后:遵循单一职责原则的模块化设计
# =========================================================================
from dataclasses import dataclass
from typing import Optional, List, Iterable
import sqlite3

# ---------------------------------------------------------
# 1. 数据契约定义(明确输入与输出格式)
# ---------------------------------------------------------
@dataclass(frozen=True)
class RawOrderRow:
    order_id: str
    user_level: str
    amount: float
    quantity: int

@dataclass(frozen=True)
class ProcessedOrder:
    order_id: str
    user_level: str
    final_price: float

# ---------------------------------------------------------
# 2. 职责一:单条原始数据的解析与合规校验(纯函数)
# ---------------------------------------------------------
def parse_and_validate_row(raw_line: str) -> Optional[RawOrderRow]:
    """负责字符串清洗与类型验证,无效行返回 None"""
    parts = [p.strip() for p in raw_line.strip().split(",")]
    if len(parts) != 4:
        return None
    try:
        order_id, user_level, raw_amount, raw_qty = parts
        amount = float(raw_amount)
        qty = int(raw_qty)
        if amount <= 0 or qty <= 0:
            return None
        return RawOrderRow(order_id, user_level, amount, qty)
    except ValueError:
        return None

# ---------------------------------------------------------
# 3. 职责二:核心折扣金额商业逻辑计算(纯函数,无任何I/O)
# ---------------------------------------------------------
def calculate_order_pricing(order: RawOrderRow) -> ProcessedOrder:
    """根据用户会员等级与购买数量计算最终折后金额"""
    subtotal = order.amount * order.quantity

    if order.user_level == "VIP":
        discount = 0.85 if subtotal >= 500 else 0.90
    elif order.user_level == "GOLD":
        discount = 0.80
    else:
        discount = 1.0

    final_price = round(subtotal * discount, 2)
    return ProcessedOrder(
        order_id=order.order_id,
        user_level=order.user_level,
        final_price=final_price
    )

# ---------------------------------------------------------
# 4. 职责三:专门负责文件读取的 I/O 适配函数
# ---------------------------------------------------------
def load_order_rows_from_file(file_path: str) -> List[RawOrderRow]:
    """仅负责读取指定路径的文本,并转换为 RawOrderRow 列表"""
    valid_orders = []
    with open(file_path, "r", encoding="utf-8") as f:
        _header = f.readline()  # 跳过表头行
        for line in f:
            parsed = parse_and_validate_row(line)
            if parsed is not None:
                valid_orders.append(parsed)
    return valid_orders

# ---------------------------------------------------------
# 5. 职责四:专门负责数据库持久化的 I/O 适配函数
# ---------------------------------------------------------
def persist_orders_to_sqlite(
    orders: Iterable[ProcessedOrder],
    db_path: str
) -> int:
    """仅负责将已处理订单持久化至数据库,返回受影响记录数"""
    records = [(o.order_id, o.user_level, o.final_price) for o in orders]
    with sqlite3.connect(db_path) as conn:
        cursor = conn.cursor()
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS processed_orders
            (order_id TEXT PRIMARY KEY, user_level TEXT, final_price REAL)
        """)
        cursor.executemany(
            "INSERT OR REPLACE INTO processed_orders VALUES (?, ?, ?)",
            records
        )
        conn.commit()
    return len(records)

# ---------------------------------------------------------
# 6. 职责五:高层协调器函数(职责:流程编排与组合)
# ---------------------------------------------------------
def execute_sales_pipeline(source_file: str, target_db: str) -> dict:
    """顶层业务编排:组织数据流向,自身不包含底层计算细节"""
    # 数据流动路线一目了然:读取 -> 业务计算 -> 持久化保存
    raw_orders = load_order_rows_from_file(source_file)
    processed_orders = [calculate_order_pricing(order) for order in raw_orders]
    saved_count = persist_orders_to_sqlite(processed_orders, target_db)

    return {"total_processed": saved_count}
calculate_order_pricing 一个函数。测试该规则只需直接传递 RawOrderRow("ORD1", "VIP", 300.0, 2) 并断言结果,无需 mock 任何文件和数据库!
四、实践边界:避免“过度拆分”与反模式
推行单一职责原则时,最容易走入的另一个极端是碎片化过度设计(Over-engineering)。如果把职责粒度拆得过细,例如把两数相加单独拆成一个 def add(a, b): return a + b,或者每个只有两行代码的步骤都硬生生拆分为一个独立函数,会导致代码库中充斥着海量微型跳转,反而严重破坏了代码的整体可读性与连续性。
| 评估维度 | 合理的单一职责(推荐实践) | 过度拆分(反模式) |
|---|---|---|
| 拆分动机 | 存在独立的业务概念,或存在不同的外界变更源头(如格式解析 vs 算法)。 | 仅仅为了“行数不超过 5 行”的教条指标而机械式切割。 |
| 内聚性 | 函数内部代码紧密围绕一个明确的业务目标服务(高内聚)。 | 代码碎片散落各处,阅读一段简单逻辑需要在五六个函数间来回跳转。 |
| 编排成本 | 高层编排函数结构清晰、数据流向线性直观。 | 参数传递链极长,不得不层层透传四五个中间状态字典。 |
协调函数(Orchestrator)算不算违反单一职责?
这是初学者最常产生的疑问:“上面的 execute_sales_pipeline 既管读文件,又管算价格,还管存库,它难道不是多职责吗?”
答案是:没有违反。因为“编排与组织”本身就是一种职责。编排函数的抽象级别高于执行函数,它的唯一改变理由是“整体业务流转步骤的顺序发生变更”。只要它内部不出现具体的 SQL 语法、不出现具体的折扣公式、不出现具体的文件遍历细节,它就完全符合单一职责原则。
五、总结与日常自检清单
编写符合单一职责原则的 Python 函数,并不需要死记硬背教条,而是在每次敲下 def 关键字并完成编码后,运用这套判定流程做一次快速闭环审视:
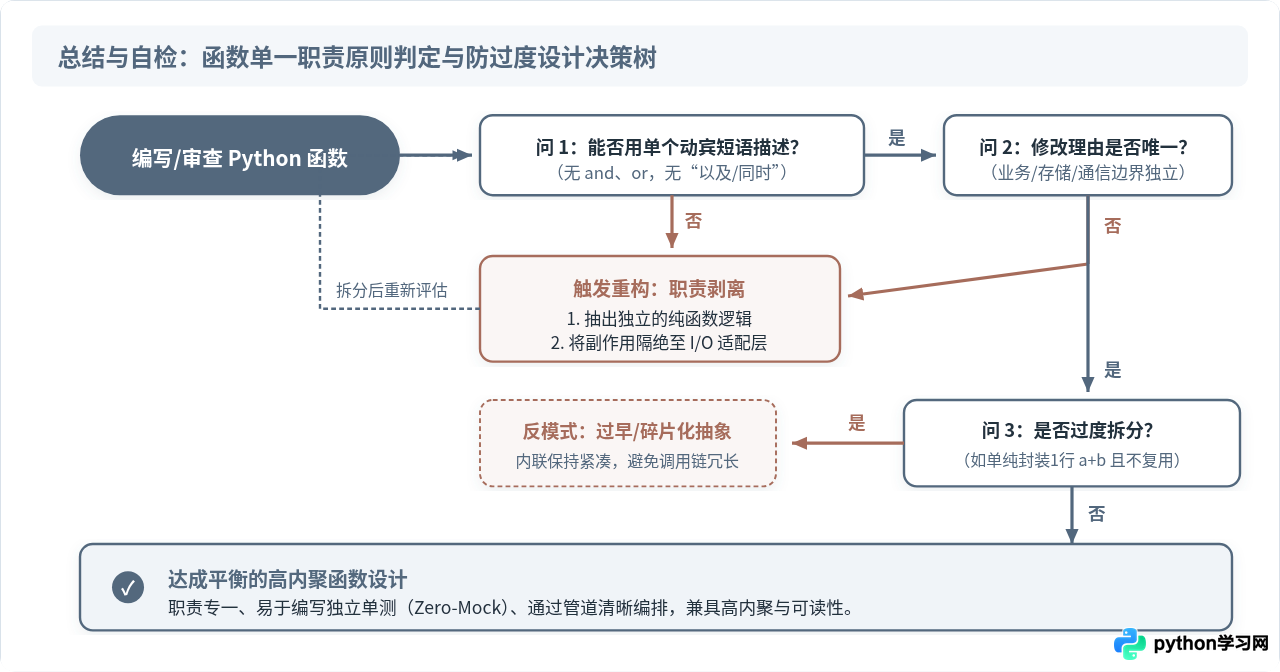
函数设计自检 4 步法则:
- 一句话法则:你能否用一个不含“并且、或者、然后”的动宾短语向同事说清这个函数的目标?如果不能,果断拆分。
- 纯函数优先法则:把任何能够脱离网络、数据库和磁盘文件独立计算的逻辑,全部抽离为无副作用的纯函数。
- 单测免 Mock 法则:测试这个函数的核心计算时,是否需要超过 1 个以上的
mock.patch?如果依赖过多,说明 I/O 副作用与业务逻辑未解耦。 - 参数契约化法则:拆分后如果函数间传递的零散参数过多(例如超过 4 个),使用
dataclass或NamedTuple封装为强类型领域对象,保持函数签名的简洁与可维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















