


Python进阶练习:怎么使用装饰器和生成器优化代码结构
深入讲解如何利用Python装饰器抽离横切非业务逻辑、使用生成器构建惰性流式处理管道,并通过二者协同彻底优化代码结构与内存性能。
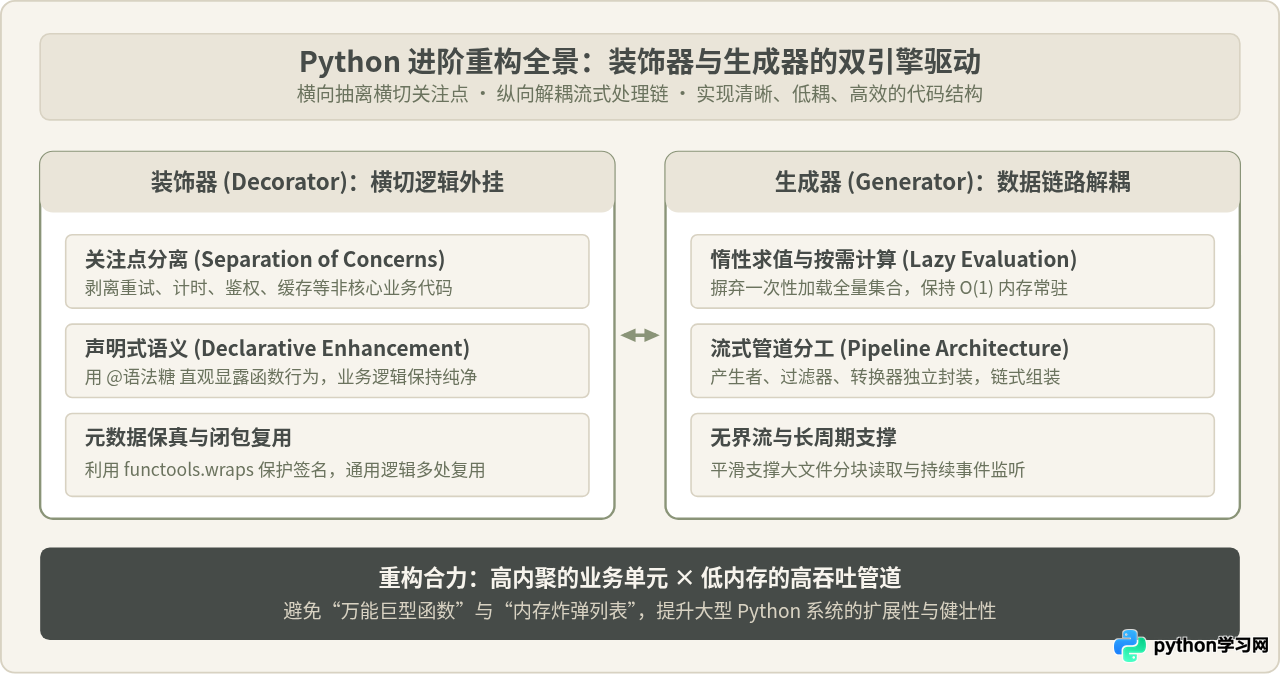
一、用装饰器剥离横切关注点:让核心业务函数回归纯粹
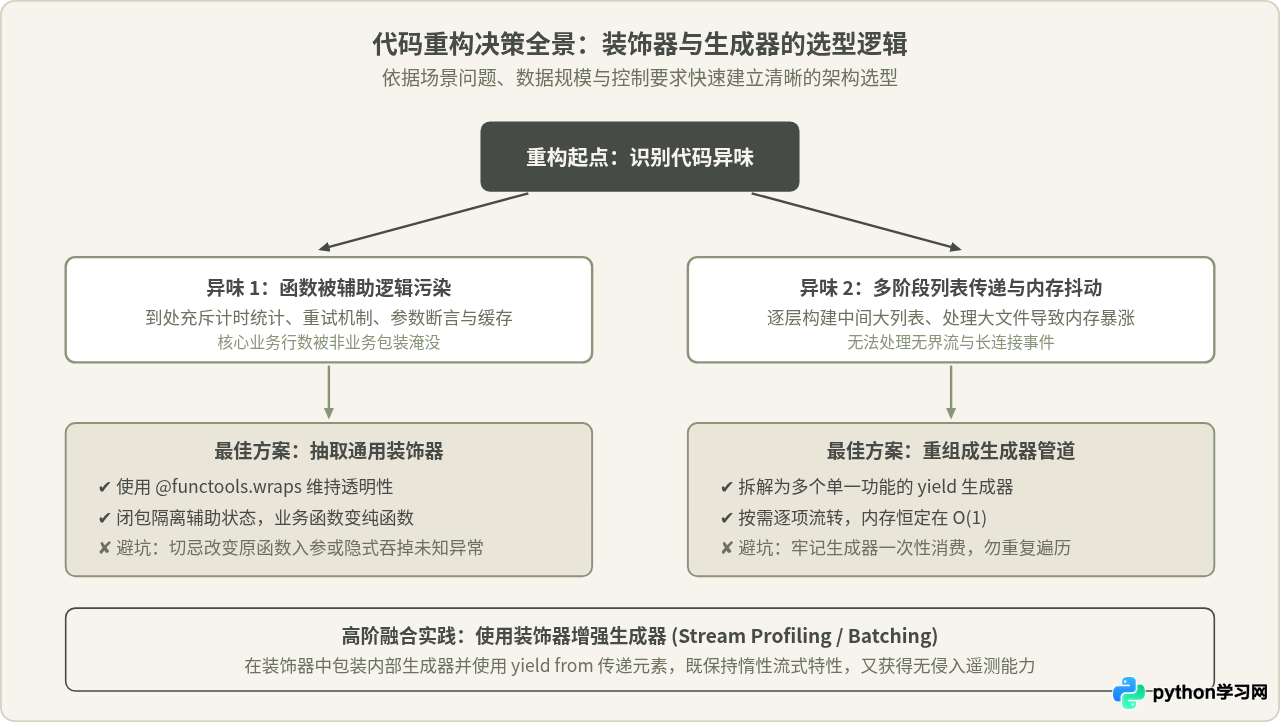
一个健康的函数应当只专注于做一件事并做好它。然而,在实际网络请求、数据库读写或外部接口交互中,往往必须加入防御性机制(如指数退避重试)与可观测性监控(如调用耗时打印)。如果把这些代码直接嵌入业务函数,核心逻辑的行数占比会迅速缩减至不到三分之一,阅读成本和维护难度成倍增加。
装饰器本质是一个接收函数作为输入并返回新可调用对象的闭包机制。借助 Python 的 @ 语法糖,我们可以将横切关注点声明式地“挂载”到业务函数上方,实现逻辑外挂。
【进阶练习 1】编写带可配置参数的重试与性能遥测装饰器
我们来看一个重构前后的对照练习。原始代码需要向第三方支付渠道同步对账单,包含异常重试与执行耗时记录:
# 重构前:业务逻辑被横切代码重重淹没
import time
import random

def sync_bill_record(bill_id: str, max_retries: int = 3):
    start_time = time.perf_counter()
    attempts = 0
    last_err = None
    while attempts < max_retries:
        attempts += 1
        try:
            # --- 核心业务只有这区区两行 ---
            if random.random() < 0.4:
                raise ConnectionResetError("对账网关抖动")
            result = f"Bill-{bill_id}-SUCCESS"
            # ----------------------------
            duration = time.perf_counter() - start_time
            print(f"[Metric] sync_bill_record 耗时: {duration:.4f}s, 重试次数: {attempts - 1}")
            return result
        except ConnectionResetError as exc:
            last_err = exc
            time.sleep(0.1 * (2 ** (attempts - 1)))
    duration = time.perf_counter() - start_time
    print(f"[Metric] sync_bill_record 最终失败耗时: {duration:.4f}s")
    raise RuntimeError(f"同步失败: {last_err}")
上述代码虽然能跑,但存在两个致命的结构问题:一是计时与重试逻辑与具体的账单对账强行绑死,其他 API 若想复用必须再复制粘贴一遍;二是单元测试时无法单独针对账单计算逻辑进行断言。
现在,我们使用装饰器对横切行为进行彻底抽象:
import functools
import time
import random
from typing import Callable, Any, Tuple, Type

def resilient_call(
    max_retries: int = 3,
    backoff_factor: float = 0.1,
    retry_exceptions: Tuple[Type[Exception], ...] = (ConnectionResetError, TimeoutError)
) -> Callable:
    """带指数退避与耗时追踪的通用健壮性装饰器"""
    def decorator(func: Callable) -> Callable:
        # 关键步骤:保留原函数的 __name__、__doc__ 以及类型注解签名
        @functools.wraps(func)
        def wrapper(*args: Any, **kwargs: Any) -> Any:
            start_time = time.perf_counter()
            attempts = 0
            while True:
                attempts += 1
                try:
                    result = func(*args, **kwargs)
                    duration = time.perf_counter() - start_time
                    print(f"[Metric] {func.__name__} 成功耗时: {duration:.4f}s (尝试 {attempts} 次)")
                    return result
                except retry_exceptions as exc:
                    if attempts >= max_retries:
                        duration = time.perf_counter() - start_time
                        print(f"[Metric] {func.__name__} 最终重试耗尽: {duration:.4f}s")
                        raise exc
                    sleep_time = backoff_factor * (2 ** (attempts - 1))
                    time.sleep(sleep_time)
        return wrapper
    return decorator

# 重构后:核心业务函数彻底净化,只表达领域意图
@resilient_call(max_retries=3, backoff_factor=0.05)
def sync_bill_record(bill_id: str) -> str:
    """核心账单同步操作"""
    if random.random() < 0.4:
        raise ConnectionResetError("对账网关抖动")
    return f"Bill-{bill_id}-SUCCESS"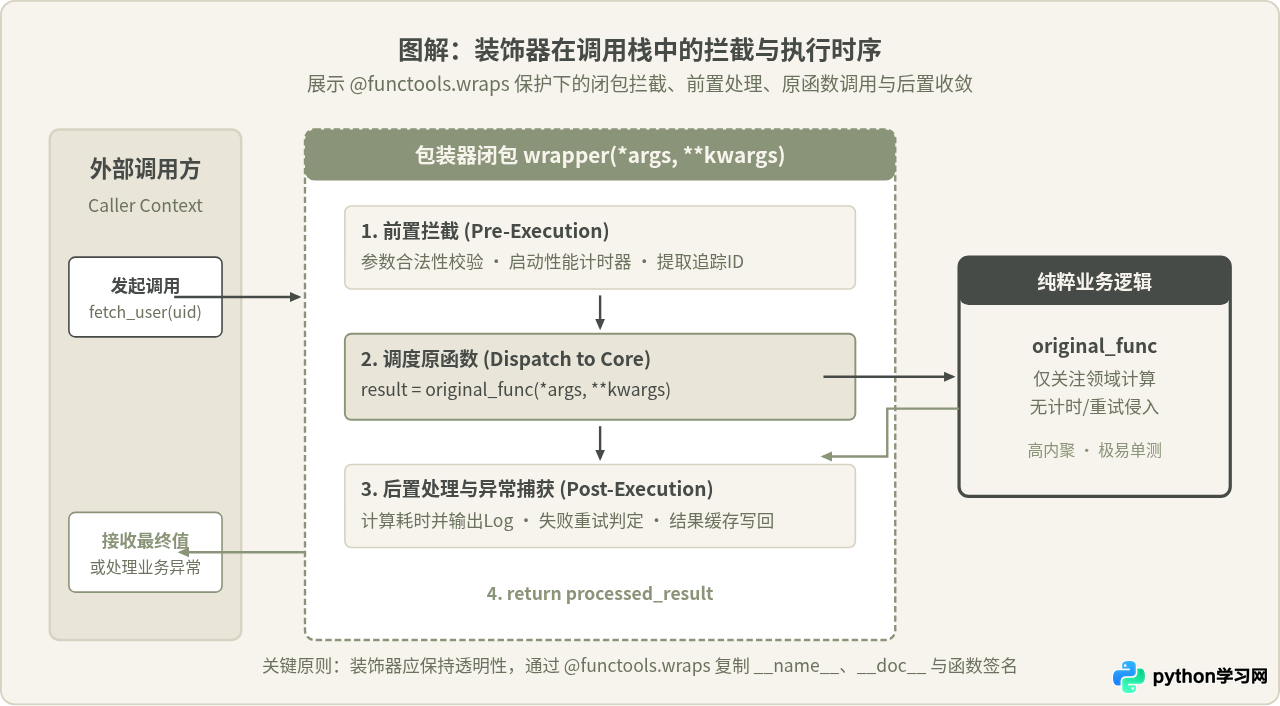
装饰器在运行时返回的是内部定义的 wrapper 函数。若不加 @functools.wraps(func),原函数的 __name__ 会变成 "wrapper",文档字符串 __doc__ 会丢失,函数签名 inspect 结果也会被覆盖。这不仅会导致自动生成的 API 文档错乱,还会破坏日志追踪、调试断点及依赖函数元数据的框架组件。
看似合理:“只要是公共逻辑,写成装饰器 @ 挂上去最省事,显得代码很高级。”
纠偏与边界:装饰器应该维持透明性原则(Transparent Wrapper)。如果一段逻辑会深度修改函数的返回值语义、篡改入参约定,或者在不同业务上下文中具有强耦合的状态依赖,强行使用装饰器会导致隐式副作用,后续维护者很难通过调用代码直观推断执行路径。对于涉及跨系统资源开闭的逻辑,优先使用上下文管理器(with 语句);只有纯粹的防御拦截、遥测追踪与透明缓存,才最适合装饰器。
二、用生成器解耦数据流:将批处理循环重构为流式管道
在数据处理、日志分析和报表计算中,我们经常遇到“多步链式转换”场景:从文件读取原始行 → 过滤非法与空行 → 解析 JSON 或提取字段 → 业务加权运算 → 最终输出。
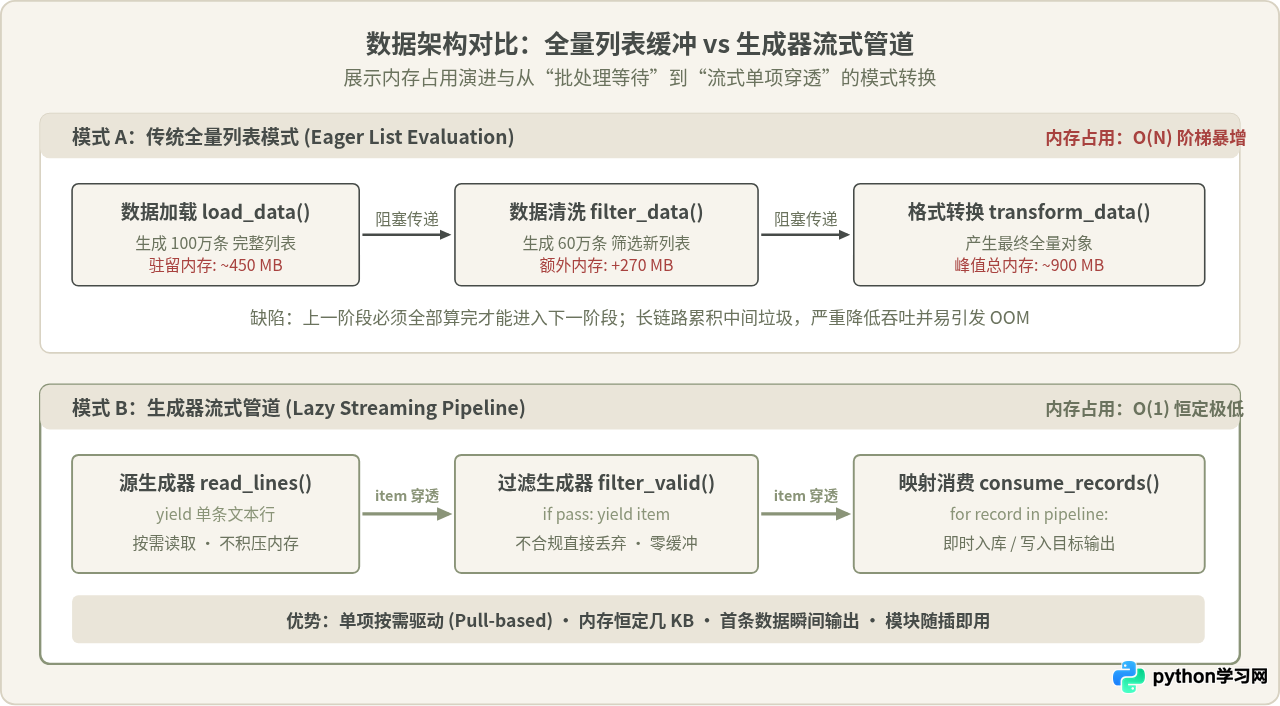
初学者最常见的结构性坏味道是:在每一个环节都用一个列表推导式把数据全部算出来,存储为中间大列表,再丢给下一步。这种做法直接导致:
- 内存暴涨与 GC 停顿:数百万条记录在内存中复制 3~4 次,中间产生的垃圾对象极易触发内存报警;
- 首包延迟极高:处理程序必须等第一步全部读完才能做第二步,无法实现首行即时吐出;
- 逻辑僵硬不可拆卸:各个清洗规则混在单个循环里,无法独立进行单元测试或按不同需求自由拼插。
【进阶练习 2】构建解耦的日志流式过滤与转换管道
生成器函数(使用 yield)并不立即计算全量集合,而是返回一个可迭代的生成器对象。只有当消费者调用 next() 或通过 for 循环按需拉取时,生成器才会执行到下一个 yield 处并挂起上下文。
我们通过管道思想(Pipeline Pattern),把各个环节拆分为单一职责的独立生成器:
import json
from typing import Iterator, Dict, Any, Iterable

# 阶段 1:数据源生成器(从大文件或数据流中按行吐出,内存只保留当前行)
def stream_log_lines(raw_lines: Iterable[str]) -> Iterator[str]:
    for line in raw_lines:
        line_clean = line.strip()
        if line_clean:
            yield line_clean

# 阶段 2:过滤生成器(仅放行符合协议的有效 JSON 记录,无用数据即刻被回收)
def filter_json_records(lines: Iterator[str]) -> Iterator[Dict[str, Any]]:
    for line in lines:
        try:
            record = json.loads(line)
            if "event" in record and "value" in record:
                yield record
        except json.JSONDecodeError:
            continue

# 阶段 3:转换生成器(实施业务映射与单位换算,职责纯粹单一)
def enrich_records(records: Iterator[Dict[str, Any]]) -> Iterator[Dict[str, Any]]:
    for item in records:
        # 模拟业务衍生字段计算
        enriched = {
            "event": item["event"].upper(),
            "amount_cents": int(item["value"] * 100),
            "is_critical": item["value"] >= 500.0
        }
        yield enriched

# 阶段 4:终端消费驱动器(Pull 驱动整个管道运转)
def run_pipeline(raw_source: Iterable[str], limit: int = 2) -> list:
    pipeline = enrich_records(
        filter_json_records(
            stream_log_lines(raw_source)
        )
    )
    results = []
    for record in pipeline:
        results.append(record)
        if len(results) >= limit:
            break
    return results
为什么这样的结构更健壮?
- 单组件可测试:
filter_json_records只接收一个生成器或迭代器,传入一个短列表即可单独对异常 JSON、缺失 key 进行严密的单元测试; - 即插即用:如果新需求要求增加“IP黑名单拦截”,只需写一个
filter_ip(records)插在中间即可,已有函数无需改动一行代码(符合开闭原则); - 短路能力:当设置
limit=2时,一旦拿到 2 条满足条件的数据,整个上游循环直接终止,后面的几百万行甚至压根不会被读取或解析。
看似合理:“生成器高级又省内存,所以它的执行速度肯定在任何时候都碾压普通列表。”
纠偏与边界:生成器换取的是空间复杂度的极限压缩(从 $O(N)$ 降到 $O(1)$)。每一次 yield 和 next() 都涉及函数栈帧的状态冻结与解冻,在纯 CPU 密集的小规模数据集(如一万次简单整数求和)下,由于无法享受 C 层面连续内存块的底层矢量优化,生成器的纯执行耗时可能比直接在内存中分配的列表推导式略微慢 10%~20%。但在真实工程环境中,生成器避免了巨型内存分配带来的页交换、系统抖动与频繁 GC 暂停,对于中大批次数据、I/O 绑定任务或无界事件流,生成器管道在吞吐量和稳定性上具有绝对优势。
三、高级协同:用装饰器无侵入增强生成器管道
当我们将数据处理拆分为生成器管道后,常常会产生新的横切需求:我们如何知道管道中每个阶段产出了多少条数据?如何监控流式传输的速度?如何在不改动各个生成器内部 yield 逻辑的前提下,实现批量缓冲区(Batching)或流式性能遥测?
这正是装饰器与生成器产生化学反应的时刻。如果直接用常规装饰器包装生成器函数,新手极容易踩到一个大坑:在装饰器里调用 list(func(*args)),导致原本的惰性流瞬间全量载入内存,让生成器的优势毁于一旦。
【进阶练习 3】编写透明的生成器流式指标遥测装饰器
要正确修饰生成器,包装器本身也必须是一个生成器函数,并通过 yield from(或逐项 yield)把内层生成器的产物透明穿透出去,同时在迭代过程中累加计数:
import functools
import time
from typing import Callable, Iterator, Any

def stream_telemetry(stage_name: str) -> Callable:
    """无侵入监控生成器吞吐量与耗时,保持惰性流式特性"""
    def decorator(gen_func: Callable[..., Iterator[Any]]) -> Callable[..., Iterator[Any]]:
        @functools.wraps(gen_func)
        def stream_wrapper(*args: Any, **kwargs: Any) -> Iterator[Any]:
            start_time = time.perf_counter()
            count = 0
            # 获取内层原始生成器,此时尚未开始实际遍历
            inner_gen = gen_func(*args, **kwargs)
            try:
                for item in inner_gen:
                    count += 1
                    yield item  # 逐项穿透,丝毫不影响下游的惰性消费
            finally:
                # 无论正常耗尽还是下游主动 break/抛出异常,均能保证统计输出
                duration = time.perf_counter() - start_time
                throughput = count / duration if duration > 0 else 0.0
                print(f"[StreamLog] 阶段【{stage_name}】流转结束: 产出 {count} 项, 耗时 {duration:.4f}s ({throughput:.1f} 项/秒)")
        return stream_wrapper
    return decorator

# 优雅增强已有生成器
@stream_telemetry(stage_name="数字清洗管道")
def generate_even_squares(limit: int) -> Iterator[int]:
    for n in range(limit):
        if n % 2 == 0:
            yield n * n

# 消费测试:验证惰性与统计闭环
if __name__ == "__main__":
    print("--- 开始消费前 3 个数字 ---")
    consumer = generate_even_squares(10)
    for index, val in enumerate(consumer):
        print(f"消费到: {val}")
        if index >= 2:
            break
通过这种写法,被装饰的函数对外依然完全符合迭代器协议。无论下游是只消费部分元素提前 break,还是全量遍历,finally 块都能准确捕捉到真实的生命周期结束时机,从而实现精准的性能遥测。
四、工程落地中的防坑准则与检查清单
为了让重构后的代码在长期演进中保持高内聚、低耦合,可以参照以下工程实践准则:
| 优化手段 | 推荐做法 (Best Practice) | 禁止/高危做法 (Anti-pattern) |
|---|---|---|
| 装饰器 |
1. 统一加上 @functools.wraps;2. 保持透明性,原样传递参数与返回值; 3. 聚焦于重试、计时、幂等、鉴权等纯横切逻辑。 |
1. 随意改变返回值类型或静默吞掉未知业务异常; 2. 叠加超过 4 层以上装饰器导致调用链路扑朔迷离; 3. 在装饰器导入期执行繁重外部网络或文件操作。 |
| 生成器 |
1. 拆分为单一职责的独立生成器函数; 2. 善用 yield from 扁平化嵌套迭代;3. 在外层消费处控制批次与短路退出。 |
1. 对同一生成器实例试图进行二次循环遍历; 2. 在管道中随意使用 len(gen) 或 gen[0](引发 TypeError 或提前消耗);3. 生成器内部打开文件未搭配 try...finally 导致句柄泄露。
|
| 二者协同 |
1. 装饰生成器时内部必须同样返回生成器; 2. 使用 try...finally 保护流式计数与资源释放。
|
1. 在装饰器内调用 list() 强转生成器(破坏惰性流式计算)。
|
五、总结
优化代码结构从来不是为了炫耀语法花样,而是为了降低认知负担与提升系统弹性。
当遇到“函数被大量与业务无关的防御、监控代码搅乱”时,请果断祭出装饰器,将横切代码收归模块化工具箱,让业务函数只负责业务;当遇到“数据流转中多层中间列表堆积、内存吃紧且环节耦合严重”时,请顺理成章地重构为生成器管道,以惰性求值实现 $O(1)$ 内存常驻与即时响应。熟练掌握这两种进阶工具的组合运用,将使你的 Python 模块具备极佳的扩展性、可测性与工业级稳健性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















