


Python列表推导式怎么替代传统for循环
深入讲解Python中如何用列表推导式替代传统for循环,涵盖基础语法对应关系、带条件的过滤与分支映射、底层执行效率对比、嵌套循环处理技巧及重构边界决策。
在 Python 日常开发中,构建新列表最常见的初学者写法是先声明一个空列表,通过 for 循环逐个遍历源数据,并在循环体内通过 list.append() 方法追加计算结果。这种方式逻辑直白,但在代码量和执行开销上都较为繁琐。使用列表推导式(List Comprehension)可以在保留清晰逻辑的前提下,将三到五行的传统循环模式精简为一行紧凑且符合声明式风格的代码,同时在解释器底层获得显著的性能提升。
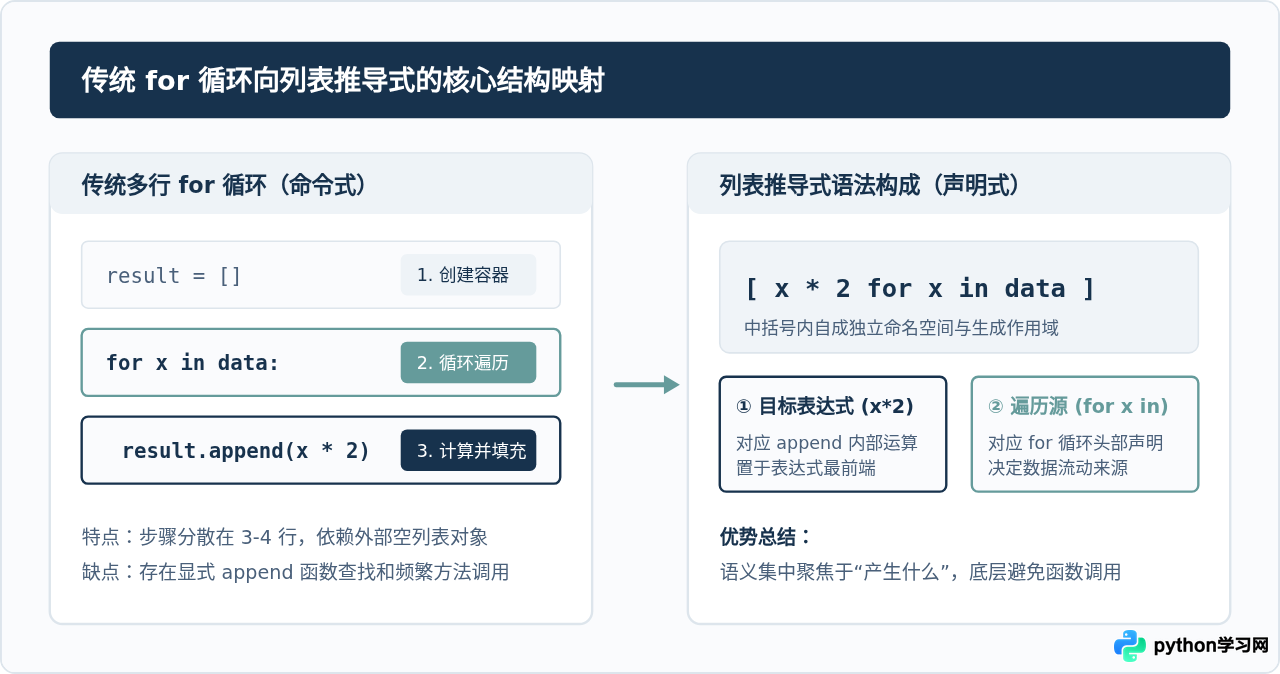
一、基础转换:从四行代码到单行推导
用列表推导式替代传统 for 循环,核心在于拆解传统代码中的三个基本要素:最终生成的元素表达式、迭代变量与遍历对象,以及可选的条件过滤逻辑。
我们来看最经典的场景:将一个整数列表中的每个数值进行平方计算,并保存到新列表中。传统的命令式写法通常如下:
# 传统 for 循环写法
numbers = [1, 2, 3, 4, 5]
squares = []
for n in numbers:
    squares.append(n ** 2)
# 输出: [1, 4, 9, 16, 25]
转换为列表推导式后,代码结构遵循 [目标表达式 for 迭代变量 in 可迭代对象] 的语法格式:
# 列表推导式替代写法
numbers = [1, 2, 3, 4, 5]
squares = [n ** 2 for n in numbers]
# 输出: [1, 4, 9, 16, 25]
可以看到,推导式将原本分散在多行的“容器初始化”、“循环遍历”和“追加写入”整合在了一个统一的中括号环境内,不仅省去了显式的 append 方法调用,而且直接表达了“用旧列表映射出新列表”的意图。
二、带条件的替代:过滤与分支赋值的区别
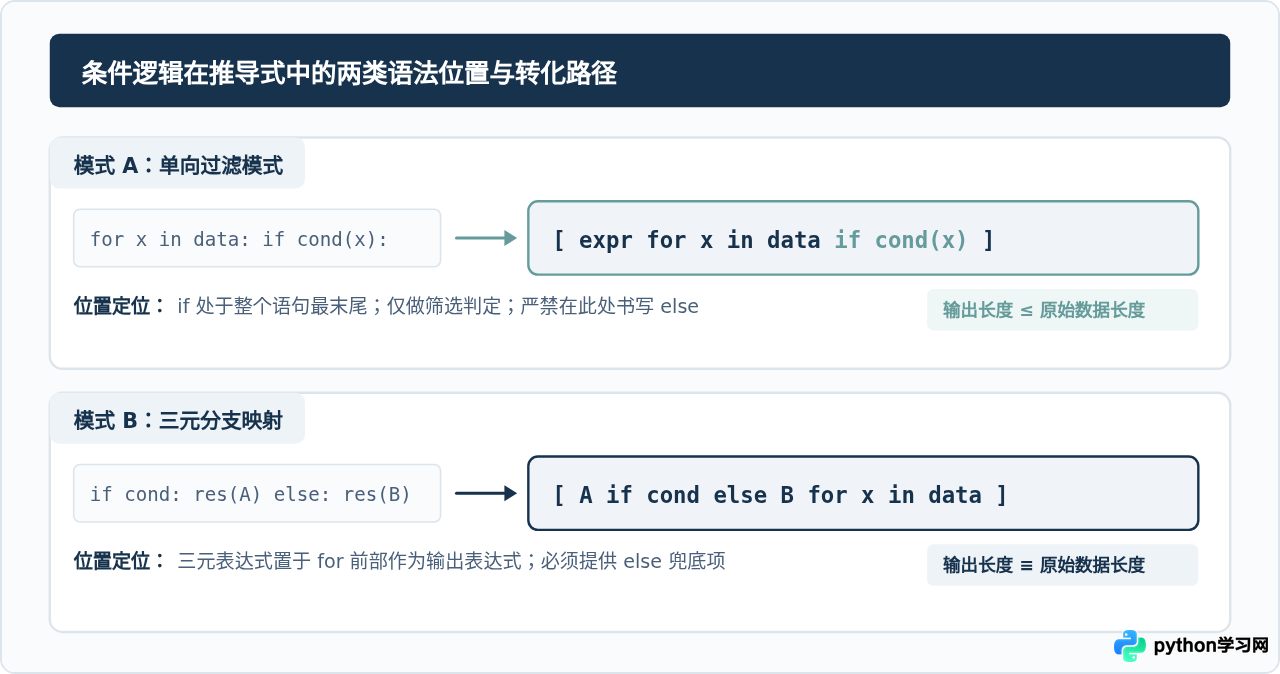
在实际编码中,循环内部往往包含条件判断语句。替换这类循环时,初学者最容易混淆 if 关键字应该写在推导式的最前面还是最后面。关键在于明确你的条件是用来筛选过滤数据,还是用来进行分支赋值。
1. 仅做数据过滤:if 放在末尾
当需要从原有数据中剔除不符合条件的元素(即“只收集满足条件的项”)时,传统代码通常在 for 循环体内部加一个单独的 if 条件语句:
# 传统过滤:只保留偶数
raw_data = [12, 17, 24, 35, 40, 53]
even_nums = []
for item in raw_data:
    if item % 2 == 0:
        even_nums.append(item)
# 输出: [12, 24, 40]
在列表推导式中,这种单向过滤条件的 if 必须写在循环体最后面,此时不需要也不能带 else 子句:
# 推导式过滤:if 位于末尾
even_nums = [item for item in raw_data if item % 2 == 0]
2. 双分支映射:if-else 三元表达式放在最前
如果需求不是过滤,而是对满足条件和不满足条件的项分别输出不同的结果(输入元素数量不变,内容变换),传统写法使用的是 if-else 结构:
# 传统分支映射:偶数保留,奇数置为 0
scores = [12, 17, 24, 35, 40]
normalized = []
for s in scores:
    if s % 2 == 0:
        normalized.append(s)
    else:
        normalized.append(0)
# 输出: [12, 0, 24, 0, 40]
这时需要将整个 Python 三元条件表达式 值A if 条件 else 值B 作为一个完整的目标表达式,放在 for 关键字的最前端:
# 推导式分支转换:三元表达式位于最前
normalized = [s if s % 2 == 0 else 0 for s in scores]• 末尾 if:起到“看门人”作用,满足才放行,不改变结构,不接
else。• 前面 if-else:是标准的三元赋值表达式,决定“放入什么”,必须成对出现
else。
三、底层机制:为什么列表推导式比传统 for 更高效
很多人以为列表推导式仅仅是一种让代码更短的“语法糖”,但实际上它在 Python 解释器底层的执行机制与传统的 for 循环存在根本性的优化差异。
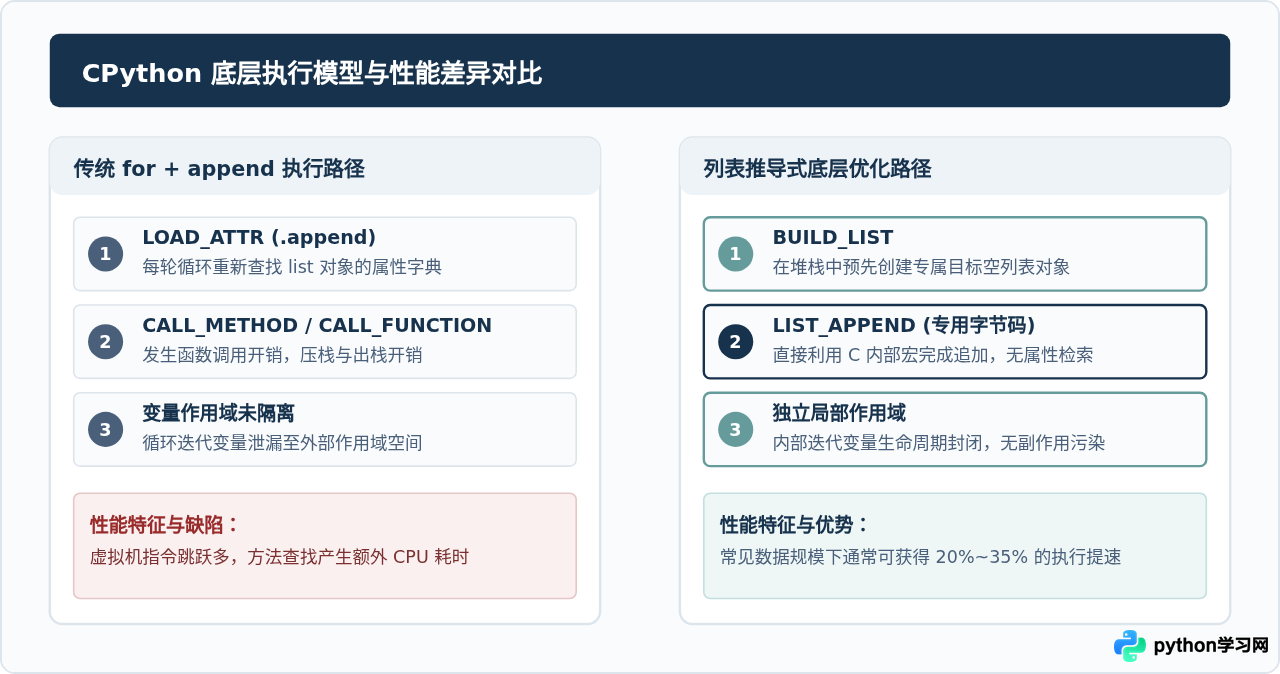
在 CPython 虚拟机层面分析字节码,传统 for 循环调用 append 的过程包含以下固定负担:
- 属性查找开销(LOAD_ATTR / LOAD_METHOD):每次循环迭代,解释器都需要在列表对象中重新查找名为
append的方法属性并将其推入栈中。 - 函数调用开销(CALL_METHOD / CALL_FUNCTION):每次追加数据都触发一次完整的 Python 函数调用帧入栈与出栈,带来参数解析与堆栈维护损耗。
而在列表推导式中,解释器在语法解析阶段就已经知晓这是一个直接构造列表的操作。它会在底层直接执行专用的 LIST_APPEND 虚拟机指令:
- 专有栈操作指令:
LIST_APPEND直接将栈顶元素写入正在构建的底层 C 结构体数组中,完全规避了 Python 层面的方法属性检索。 - 预分配与 C 级循环循环优化:列表内部容量增长机制在底层直接运作,减少了 Python 虚拟机指令周转次数。
- 变量隔离:在 Python 3 中,推导式内部拥有独立的局部作用域,避免了循环迭代变量泄露并污染外部函数或模块的全局命名空间。
四、嵌套循环替代:展平矩阵与笛卡尔积
当面临多层 for 循环时,列表推导式依然能够完成替代。例如二维列表的展平(Flatten)或组合笛卡尔积。但在嵌套场景下,很多开发者容易弄反循环的书写顺序。
记忆法则非常简单:在列表推导式中,多层 for 循环的书写顺序与传统多层循环的缩进顺序完全一致(从外层到内层)。
1. 二维矩阵扁平化示例
# 传统双层 for 循环:展平二维列表
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]
flattened = []
for row in matrix:          # 外层循环
    for item in row:        # 内层循环
        flattened.append(item)
# 输出: [1, 2, 3, 4, 5, 6, 7, 8, 9]
替代后的列表推导式如下。先写最终提取的 item,紧接着按原序排布外层和内层循环:
# 列表推导式替代:外层在前,内层在后
flattened = [item for row in matrix for item in row]
2. 笛卡尔积组合示例
需要组合两种属性时(如颜色与尺码的笛卡尔积):
colors = ['黑', '白']
sizes = ['S', 'M', 'L']

# 传统写法
products = []
for c in colors:
    for s in sizes:
        products.append(f"{c}_{s}")

# 列表推导式替代写法
products = [f"{c}_{s}" for c in colors for s in sizes]
# 输出: ['黑_S', '黑_M', '黑_L', '白_S', '白_M', '白_L']
五、适用边界与反模式:何时不该使用列表推导式
列表推导式虽然优雅高效,但并不意味着所有 for 循环都应该被盲目替代。Python 之禅强调“可读性优先(Readability counts)”。在以下常见场景中,坚持使用传统 for 循环才是更好的工程实践:
- 仅产生副作用,不需要返回值:如果循环的目的是为了打印日志、向数据库写入记录、发送网络请求或修改全局状态,而无需构造新列表,绝不要写
[print(x) for x in data]这种代码。这会凭空创建一个无用的常驻列表占用内存,此时普通的for循环最清晰自然。 - 逻辑分支与异常处理复杂:当循环体内包含
try-except异常捕获、深层elif级联,或者多步复杂的业务清洗逻辑时,强行压缩进推导式会严重破坏代码可读性,不利于团队排查问题。 - 嵌套超过两层:三层及以上的
for循环写在推导式中宛如“天书”,严重增加阅读认知负荷,应保持传统缩进或拆分成独立的生成器函数。 - 极大规模数据(内存敏感):如果源数据有数百万条,列表推导式会一次性在内存中分配并生成完整列表,可能导致内存溢出。此时应将中括号换为圆括号,改用生成器表达式(Generator Expression)进行惰性求值。
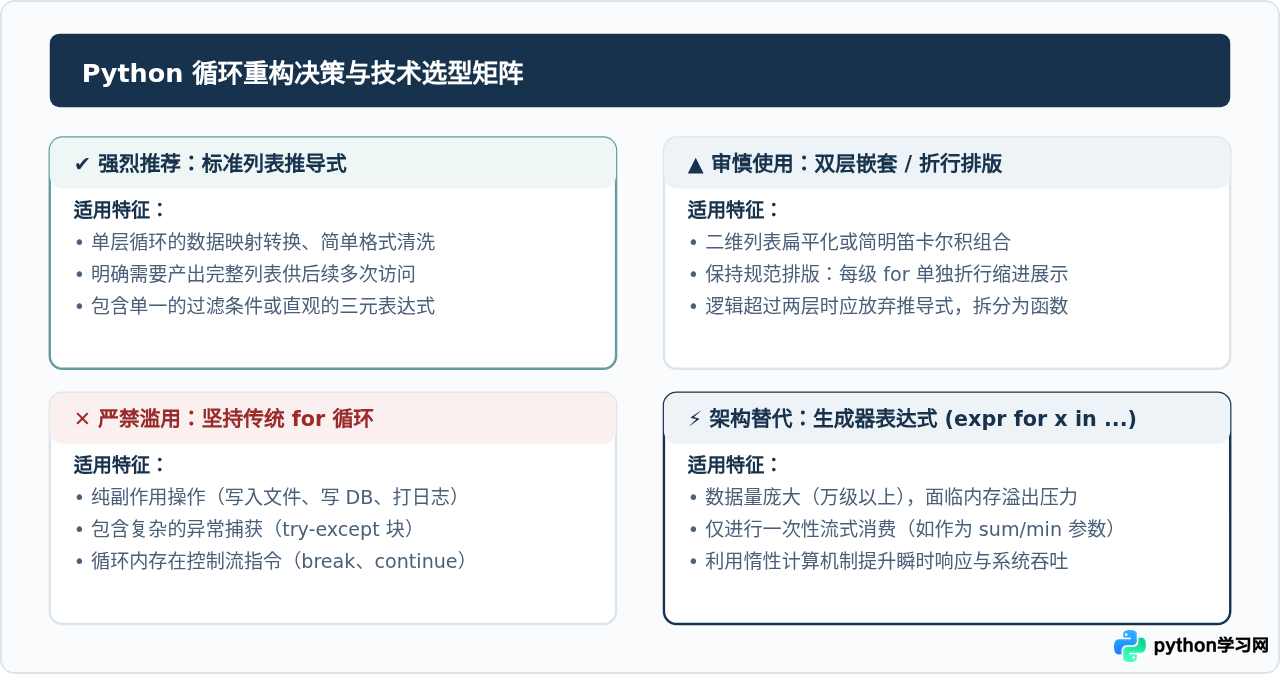
六、重构总结与速查对照
为了在实际编码中快速查阅与无错重构,以下整理了常见的传统 for 循环模式与对应推导式的写法速查表:
| 需求场景 | 传统 for 循环模式 | 列表推导式替代写法 |
|---|---|---|
| 基础全量映射 | res = [] |
[f(x) for x in seq] |
| 单向条件过滤 | res = [] |
[x for x in seq if cond(x)] |
| 双分支三元映射 | res = [] |
[A if c(x) else B for x in seq] |
| 嵌套二维展平 | res = [] |
[item for r in mat for item in r] |
掌握列表推导式的核心不是单纯追求行数的缩减,而是建立清晰的“声明式数据流”思维。通过明确区分目标表达式、数据源及过滤判定,在适度使用的前提下,可以让你的 Python 代码不仅行文优美紧凑,而且在底层执行上更胜一筹。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















