


Python调用百度翻译API实现稳定文本翻译
本文详解如何使用Python调用百度翻译开放平台通用文本翻译API,系统实现MD5签名生成、QPS流量整形、网络抖动退避重试、长文本智能分段与结构化异常处理,构建高可用的生产级文本翻译服务。
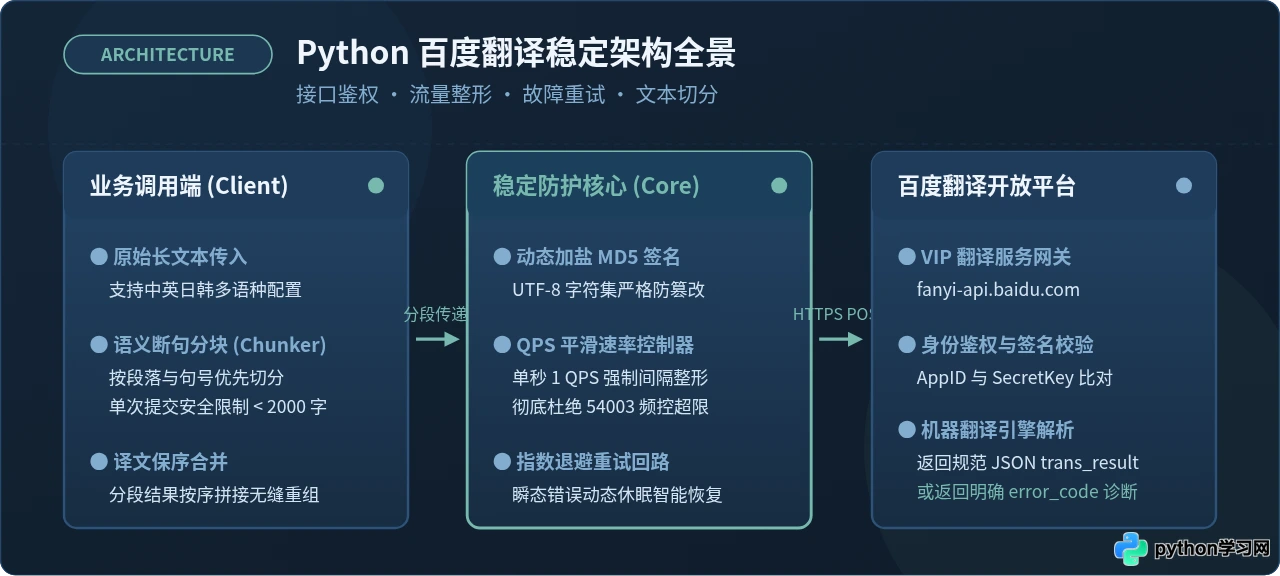
在开发多语言数据处理脚本、国际化应用或文本采集清洗管道时,直接调用公共机器翻译接口是最快捷的途径。百度翻译开放平台提供的通用文本翻译 API 具有响应速度快、语种支持全面的优势。然而,在真实批量调用场景下,如果仅用几行简短的 requests.get 发送请求,程序往往会在连续运行时频繁遭遇 54003(访问频控限制)、54001(签名错误)、网络偶发超时或长文本截断等故障。要实现工业级的“稳定文本翻译”,关键在于四点工程设计:规范准确的加盐 MD5 签名生成、基于 QPS 阈值的平滑速率控制、针对瞬态错误的指数退避重试,以及保持语义完整性的长文本分段机制。
一、准备工作与平台凭据获取
调用百度翻译接口前,需要先在官方平台开通服务并取得鉴权凭据。百度翻译 API 采用 AppID + 密钥 (Secret Key) 的身份认证模型,所有请求都需要在服务端通过密钥比对校验。
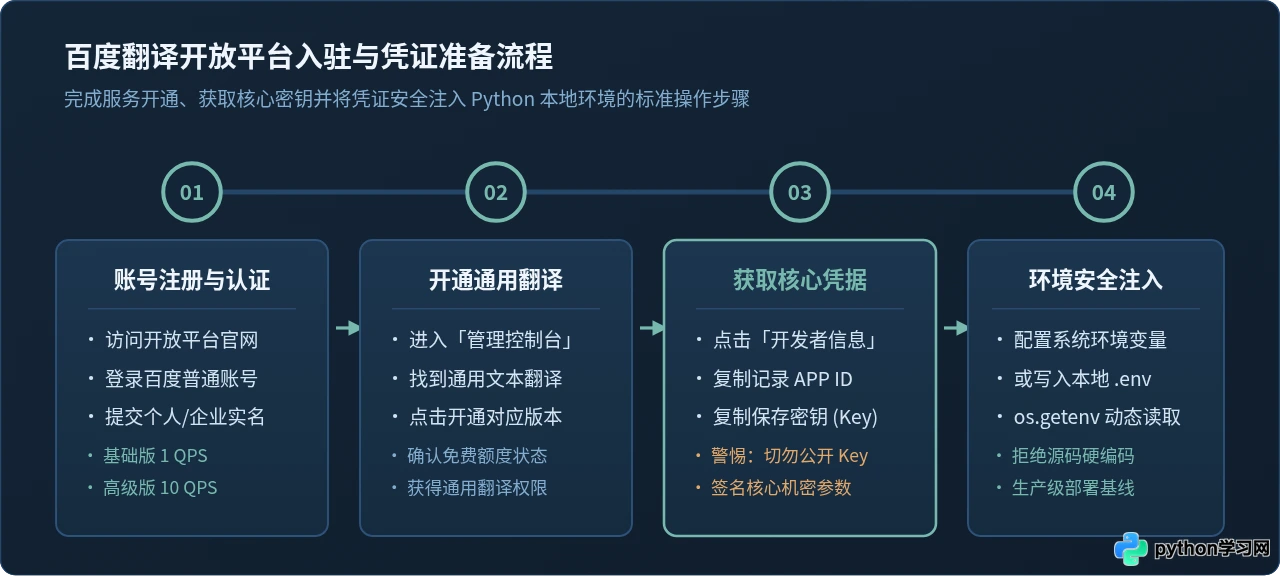
服务开通与配置的主要流程包含以下四个关键环节:
- 注册与认证:访问百度翻译开放平台(fanyi-api.baidu.com),使用百度账号登录,并根据使用主体完成个人或企业实名认证。实名认证不仅是合规要求,更是提升调用配额的前提。
- 开通通用文本翻译:在管理控制台的产品列表中,选择开通“通用文本翻译”服务。开通后系统会自动分配服务状态。
- 获取核心鉴权凭据:进入控制台的“开发者信息”页面,妥善复制本账号的
APP ID与密钥 (Secret Key)。密钥是签名的核心保密因子,切勿泄露到公共代码仓库中。 - 本地环境安全注入:在开发环境推荐将凭据注入系统环境变量(如
BAIDU_APP_ID和BAIDU_SECRET_KEY),或存放于项目根目录的.env文件中,通过代码动态读取,避免代码硬编码造成安全风险。
百度翻译开放平台对不同认证等级的用户设定了严格的并发请求限制(QPS,Queries Per Second):标准版(个人初级认证)默认限制为 1 QPS;高级版(个人实名或企业认证)可提升至 10 QPS 及以上。如果本地代码并发发送或在循环中未设间隔,极易直接触发 54003 频控拦截,因此代码设计必须适配对应的 QPS 限额。
二、接口核心协议与加盐签名机制解析
百度通用文本翻译官方 API 规范定义清晰,其标准请求端点如下:
接口地址:https://fanyi-api.baidu.com/api/trans/vip/translate
请求方法:POST(推荐)或 GET
数据格式:application/x-www-form-urlencoded
当待翻译文本包含长句、换行符或特殊字符时,强烈建议采用 POST 方法 发送表单数据,避免因 GET 请求 URL 字符过长被网关截断。请求中必须提交的核心参数包括:
q:待翻译的原始文本,必须为 UTF-8 编码。from:源语言代码,支持指定为auto(自动检测)或标准语言码(如zh、en、jp等)。to:目标语言代码,例如翻译为英文时指定为en。appid:开放平台申请的应用 ID。salt:随机整数或随机字符串,用于保证每次请求签名的唯一性,防止重放攻击。sign:MD5 签名串,计算公式为:MD5(appid + q + salt + 密钥),计算结果为 32 位全小写十六进制字符串。
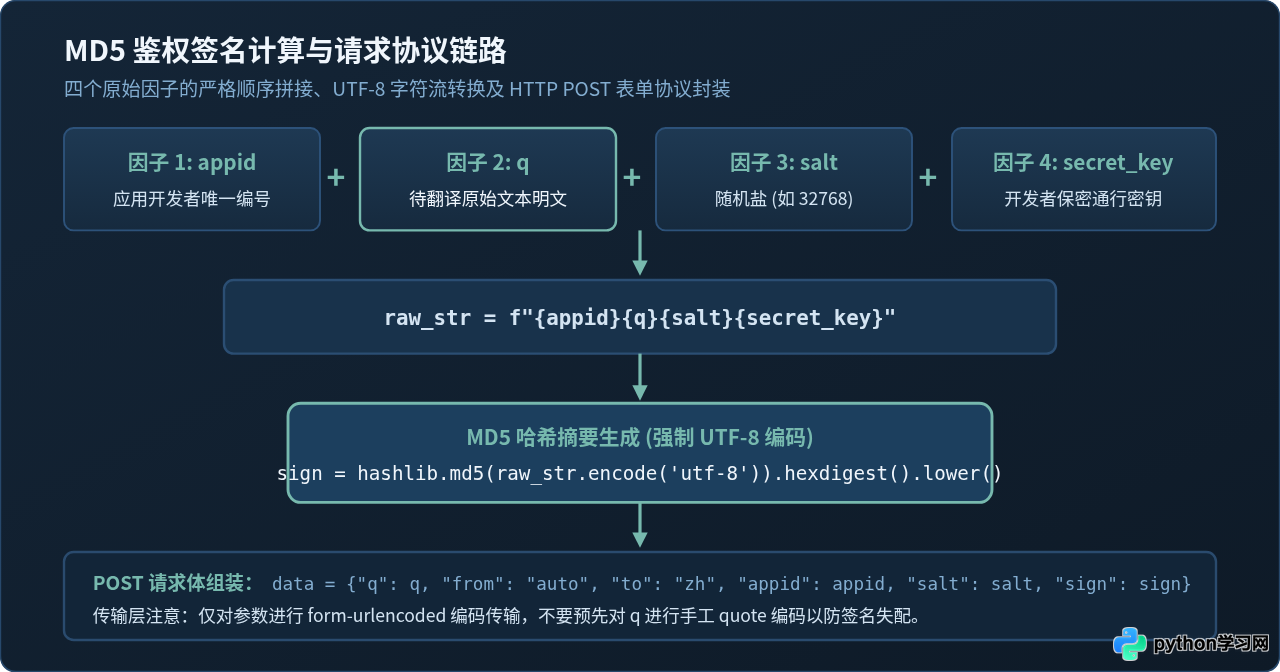
1. 字符编码顺序:在 Python 3 中,拼接后的完整字符串必须统一按 utf-8 编码为字节序列(raw_str.encode('utf-8'))后再送入 MD5 哈希计算;若明文中包含 Emoji 或特殊中文字符,未显式指定 UTF-8 编码会导致两端哈希不一致。
2. URL 编码与签名计算脱钩:必须使用“原始明文”参与拼接签名,而在通过 HTTP 发送表单参数时,由 requests 库自动处理 URL Form 编码。切勿手动对 q 进行 quote 后再去签名,否则必然导致 54001 签名错误。
3. 每次重试必须更新 salt:在请求遭遇网络超时或限频重试时,建议重新生成随机 salt 并重新计算 sign,确保请求标识鲜活有效。
三、构建高可用防护层:限流、重试与连接池
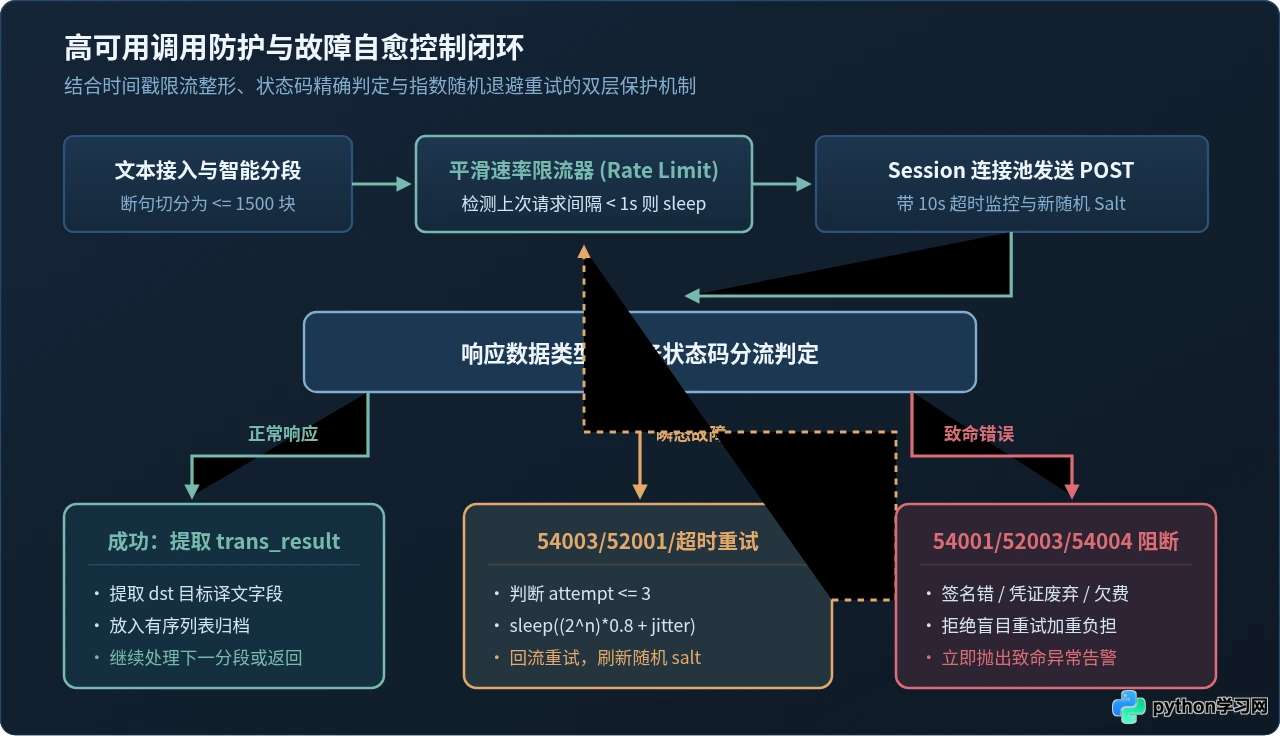
单次请求成功并不代表整个批处理过程稳定。在大批量处理或长期运行的脚本中,网络波动与云端频控不可避免。要保障文本翻译服务数小时甚至数天稳定运行,核心防护层必须落实以下三项工程措施:
1. 基于令牌桶或时间间隔的平滑速率控制
针对标准版账号 1 QPS 的硬性约束,如果业务代码在 for 循环中连续请求,第二条请求在几十毫秒内到达必触发 54003 错误。稳定客户端必须内置速率控制器(Rate Limiter),记录上一次请求完毕的时间戳。每次发送新请求前,计算距离上次请求的时间差,如果小于安全间隔(例如 1.05 秒),主动通过 time.sleep() 补齐等待时间,从根源上杜绝突发突刺流量。
2. 区分错误类型的指数退避重试(Exponential Backoff)
接口返回错误并非全都可以无脑重试,盲目重试会放大系统雪崩。必须对错误码进行精确分类:
- 可恢复瞬态错误:网络超时(
requests.exceptions.Timeout)、连接中断、平台偶发系统繁忙(52002)、访问频率偶发超限(54003)。这类错误应启动重试机制,每次重试等待时间按wait = base * (2 ** attempt) + random.uniform(0, 0.5)指数级递增,避开并发冲突期。 - 致命错误(不可重试):签名错误(
54001)、未授权或 AppID 错误(52003)、账户欠费(54004)、必填参数缺失(54000)。这类错误属于配置或逻辑缺陷,重试毫无意义,必须立即中断流程并抛出结构化异常,便于开发者快速排障。
3. 连接池复用与明确超时控制
高频频繁新建 TCP 连接会消耗本地文件描述符并增加 SSL 握手延迟。利用 requests.Session() 维护长连接池,并为每个请求设置严格的超时时间(如 timeout=10),能够有效防止因外部网络挂起导致整个 Python 进程永久阻塞。
四、长文本智能语义分段与保序重组
百度通用翻译 API 对单次请求的文本体积有明确上限(建议单次在 2000 字符以内,底层严格限制为 6000 字节)。若需翻译长篇文档、学术报告或整章节内容,直接发送会导致请求被拒或译文尾部严重丢失。
机械的“固定字数截断”会将一个完整的单词、专有名词或成对标点从中间硬生生切开,不仅导致当前分段翻译失真,还会破坏下一个分段的模型上下文。工程化的分段算法应遵循语义断句优先级:
- 一级切分符:优先按自然段落(换行符
- 二级切分符:若单个段落仍超过阈值(如 1500 字符),则进一步按句子终结符(中文句号
。、感叹号!、问号?或英文. ! ?)进行切分; - 贪心累加:遍历切分后的文本块,贪心合并至预设的安全阈值(如 1500~1800 字符)作为一个请求批次提交;
- 保序重组:记录每个批次的序号,按序逐个完成翻译并平滑合并译文,从而保证整篇文章连贯且格式不乱。
五、工程级 Python 完整实现代码
下面给出封装完善的 BaiduTranslator 类。该实现集成了 MD5 加盐签名、基于时间戳的 QPS 平滑限制、指数退避动态重试、智能分段以及自定义异常体系,开箱即用:
# -*- coding: utf-8 -*-
"""
模块名称:baidu_translator.py
功能说明:具备高可用保障的百度翻译API调用客户端,提供平滑限流、重试退避与长文本分段。
"""

import os
import time
import random
import hashlib
import requests
from typing import List, Dict, Any, Optional


class BaiduTranslateError(Exception):
    """百度翻译业务异常基类"""
    def __init__(self, error_code: str, error_msg: str):
        super().__init__(f"Baidu Translate API Error [{error_code}]: {error_msg}")
        self.error_code = error_code
        self.error_msg = error_msg


class FatalTranslateError(BaiduTranslateError):
    """致命错误:如签名错误、账号无效、欠费等,不可重试"""
    pass


class TransientTranslateError(BaiduTranslateError):
    """瞬态错误:如频控受限、超时、服务繁忙,允许重试"""
    pass


class BaiduTranslator:
    """百度翻译工业级封装客户端"""

    ENDPOINT = "https://fanyi-api.baidu.com/api/trans/vip/translate"

    # 错误分类规则表
    RETRYABLE_CODES = {"52001", "52002", "54003"}
    FATAL_CODES = {"52003", "54000", "54001", "54004", "58001"}

    def __init__(
        self,
        appid: Optional[str] = None,
        secret_key: Optional[str] = None,
        qps_limit: float = 1.0,
        max_retries: int = 3,
        timeout: float = 10.0
    ):
        """
        初始化客户端配置。
        :param appid: 百度开放平台 AppID(未传时从环境变量 BAIDU_APP_ID 读取)
        :param secret_key: 百度开放平台密钥(未传时从环境变量 BAIDU_SECRET_KEY 读取)
        :param qps_limit: 每秒允许的最大请求数(标准版建议 <= 1.0,高级版可设为 10.0)
        :param max_retries: 瞬态错误最大重试次数
        :param timeout: 单次请求超时时间(秒)
        """
        self.appid = appid or os.getenv("BAIDU_APP_ID", "").strip()
        self.secret_key = secret_key or os.getenv("BAIDU_SECRET_KEY", "").strip()

        if not self.appid or not self.secret_key:
            raise ValueError("必须提供有效的 appid 与 secret_key,或配置相应环境变量。")

        self.min_interval = 1.0 / max(qps_limit, 0.1)
        self.max_retries = max_retries
        self.timeout = timeout
        self.last_request_time = 0.0

        # 初始化会话连接池
        self.session = requests.Session()

    def _rate_limit_wait(self) -> None:
        """平滑速率控制:确保两次物理请求间隔不低于预设安全阈值"""
        elapsed = time.time() - self.last_request_time
        if elapsed < self.min_interval:
            sleep_duration = self.min_interval - elapsed
            time.sleep(sleep_duration)

    def _calculate_sign(self, query: str, salt: str) -> str:
        """
        严格计算 MD5 鉴权签名:MD5(appid + q + salt + secret_key)
        采用 UTF-8 编码避免多字节字符导致摘要不一致。
        """
        raw_string = f"{self.appid}{query}{salt}{self.secret_key}"
        return hashlib.md5(raw_string.encode("utf-8")).hexdigest().lower()

    def _send_single_request(self, query: str, from_lang: str, to_lang: str) -> str:
        """发送单次请求并内置退避重试逻辑"""
        attempt = 0

        while True:
            self._rate_limit_wait()

            salt = str(random.randint(32768, 65536))
            sign = self._calculate_sign(query, salt)

            payload = {
                "q": query,
                "from": from_lang,
                "to": to_lang,
                "appid": self.appid,
                "salt": salt,
                "sign": sign,
            }

            try:
                self.last_request_time = time.time()
                response = self.session.post(
                    self.ENDPOINT,
                    data=payload,
                    timeout=self.timeout
                )
                response.raise_for_status()
                data = response.json()

            except (requests.RequestException, ValueError) as net_err:
                attempt += 1
                if attempt > self.max_retries:
                    raise TransientTranslateError("NET_ERR", f"网络请求失败重试超限: {str(net_err)}")
                backoff_time = (2 ** attempt) * 0.5 + random.uniform(0.1, 0.4)
                time.sleep(backoff_time)
                continue

            # 业务错误判断
            if "error_code" in data:
                code = str(data["error_code"])
                msg = str(data.get("error_msg", "未知异常"))

                if code in self.FATAL_CODES:
                    raise FatalTranslateError(code, msg)

                if code in self.RETRYABLE_CODES:
                    attempt += 1
                    if attempt > self.max_retries:
                        raise TransientTranslateError(code, f"频控或服务瞬态错误,达到最大重试: {msg}")
                    # 指数退避加随机扰动
                    backoff_time = (2 ** attempt) * 0.8 + random.uniform(0.2, 0.6)
                    time.sleep(backoff_time)
                    continue

                # 其他未分类错误默认抛出
                raise BaiduTranslateError(code, msg)

            # 解析成功结果
            results = data.get("trans_result", [])
            translated_lines = [item.get("dst", "") for item in results]
            return "
".join(translated_lines)

    def _split_long_text(self, text: str, max_chunk_size: int = 1500) -> List[str]:
        """智能分段算法:优先按段落和标点符号切分长文本"""
        if len(text) <= max_chunk_size:
            return [text]

        paragraphs = text.split("
")
        chunks = []
        current_chunk = []
        current_len = 0

        for para in paragraphs:
            para_len = len(para) + 1
            if current_len + para_len <= max_chunk_size:
                current_chunk.append(para)
                current_len += para_len
            else:
                if current_chunk:
                    chunks.append("
".join(current_chunk))
                    current_chunk = []
                    current_len = 0

                # 若单个段落自身超长,则按标点进一步细分
                if len(para) > max_chunk_size:
                    sub_chunks = self._split_by_punctuation(para, max_chunk_size)
                    chunks.extend(sub_chunks)
                else:
                    current_chunk.append(para)
                    current_len = para_len

        if current_chunk:
            chunks.append("
".join(current_chunk))

        return chunks

    @staticmethod
    def _split_by_punctuation(para: str, max_size: int) -> List[str]:
        """按中英文句子终结符号二次断句"""
        delimiters = {"。", "!", "?", ".", "!", "?"}
        pieces = []
        start = 0

        for idx, char in enumerate(para):
            if char in delimiters or idx - start >= max_size:
                pieces.append(para[start:idx + 1])
                start = idx + 1

        if start < len(para):
            pieces.append(para[start:])

        # 合并小分句
        merged = []
        buf = ""
        for piece in pieces:
            if len(buf) + len(piece) <= max_size:
                buf += piece
            else:
                if buf:
                    merged.append(buf)
                buf = piece
        if buf:
            merged.append(buf)

        return merged

    def translate(
        self,
        text: str,
        from_lang: str = "auto",
        to_lang: str = "zh"
    ) -> str:
        """
        主入口函数:支持自动长文本分段与平滑翻译重组。
        :param text: 待翻译源文本
        :param from_lang: 源语言(默认 auto 自动检测)
        :param to_lang: 目标语言(默认 zh 中文)
        :return: 翻译完成的完整译文
        """
        clean_text = text.strip()
        if not clean_text:
            return ""

        chunks = self._split_long_text(clean_text, max_chunk_size=1500)
        translated_parts = []

        for chunk in chunks:
            translated_part = self._send_single_request(chunk, from_lang, to_lang)
            translated_parts.append(translated_part)

        return "
".join(translated_parts)
调用验证与执行示例
以下为在业务代码中实例化 BaiduTranslator 并执行中英双向翻译的完整示例:
if __name__ == "__main__":
    # 实例化翻译器(从环境变量自动读取 BAIDU_APP_ID 和 BAIDU_SECRET_KEY)
    # 针对个人初级认证账号,明确设定 qps_limit=1.0
    translator = BaiduTranslator(
        qps_limit=1.0,
        max_retries=3,
        timeout=8.0
    )

    sample_text = (
        "Distributed consensus algorithms like Raft and Paxos ensure data consistency "
        "across nodes even in the presence of network partitions and machine failures.
"
        "Modern cloud infrastructure relies heavily on these protocols to build resilient state machines."
    )

    print(">>> 正在发起稳定翻译任务...")
    translated_output = translator.translate(sample_text, from_lang="en", to_lang="zh")
    print(">>> 翻译结果:")
    print(translated_output)
程序控制台示例输出(注明为预期执行示例):
>>> 正在发起稳定翻译任务...
>>> 翻译结果:
像Raft和Paxos这样的分布式共识算法即使在存在网络分区和机器故障的情况下也能确保跨节点的数据一致性。
现代云基础设施高度依赖这些协议来构建弹性状态机。
六、常见错误代码速查与排障对照
在长期运行与维护过程中,若遇到接口调用返回非预期结果,可对照下表快速定位根因并采取对应措施:
| 错误代码 | 含义描述 | 排查与产生原因 | 推荐处理方案 |
|---|---|---|---|
52000 |
成功 (SUCCESS) | 请求正常,结果正确返回 | 解析 trans_result 提取译文 |
52001 |
请求超时 | 网络抖动或服务端处理延时 | 启动指数退避重试,检查本地网络通畅度 |
52002 |
系统错误 | 百度云端服务器临时繁忙或计算异常 | 休眠 1~2 秒后自动重试 |
52003 |
未授权用户 | AppID 填写错误,或服务未成功开通 | 核对控制台开发者信息中的 AppID,确认开通通用翻译 |
54000 |
必填参数为空 | q、appid、salt、sign 出现缺失 |
检查传参字典,过滤掉空白字符串请求 |
54001 |
签名错误 | 拼装顺序错误、密钥不匹配或未做 UTF-8 编码 | 确认公式为 appid+q+salt+key,检查是否二次 URL 编码 |
54003 |
访问频率受限 | 发送频率超过了账号设定的 QPS 上限 | 强制引入速率限制器,限制每秒最多发送 1 次请求 |
54004 |
账户余额不足 | 免费额度耗尽且未充值或账户被冻结 | 进入费用中心充值或检查免费月度额度 |
58001 |
不支持的语言类型 | 语种代码填写错误(如非标准简称) | 查阅官方文档核对源语言和目标语言代码缩写 |
七、总结与生产环境部署建议
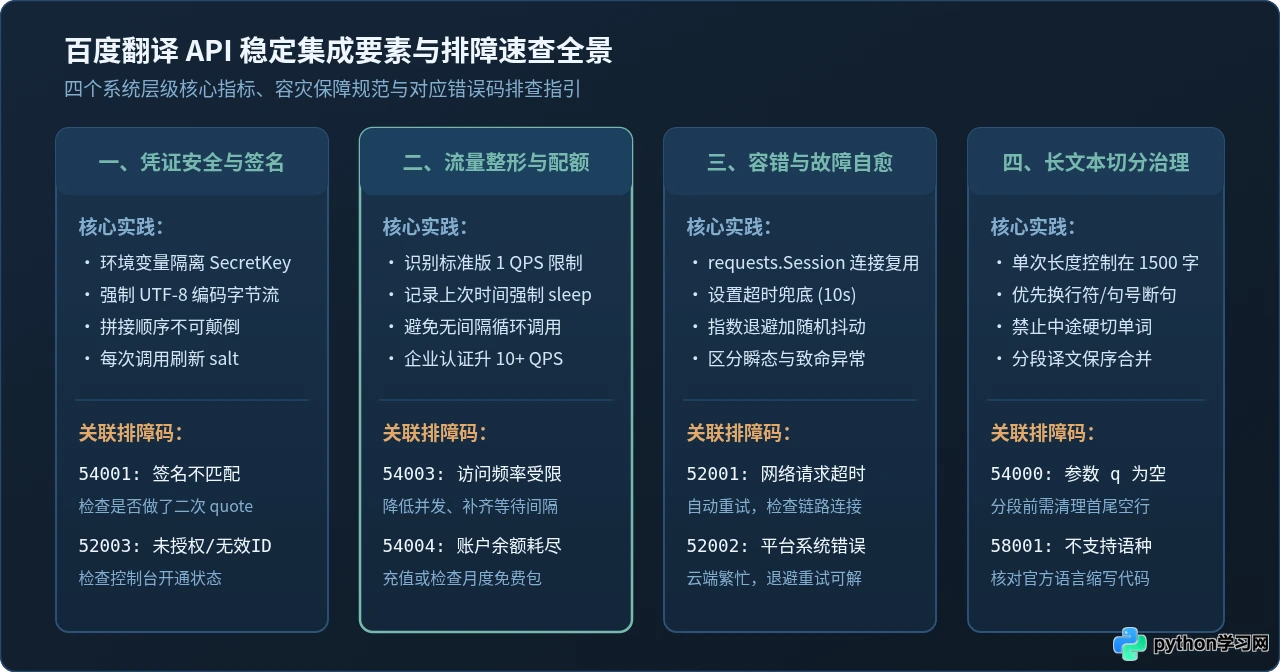
通过 Python 调用百度翻译 API 实现真正稳定的文本翻译,并不是简单拼装 URL,而是一项涵盖安全、协议、流控与容错的工程化任务:
- 鉴权安全:必须将
Secret Key置于受控环境变量或配置中心,严格遵循 UTF-8 编码规范生成 32 位小写 MD5 签名; - 速率整形:认清账号当前的 QPS 配额(标准版 1 QPS、高级版 10 QPS),在客户端本地实现平滑的时间戳流控,严禁暴力突发并发;
- 智能重试:精准划分致命错误与瞬态错误,对网络波动和 54003 限频采用“指数退避 + 随机扰动”的安全重试策略;
- 语义保真:面对超长文本,坚持按段落和句子标点进行智能切分,并在完成后按序组装,避免机械截断造成的语义割裂。
将上述机制组合落实后,编写的翻译程序即可在爬虫入库、自动化内容出海、日志多语言转译等生产级任务中保持全天候高可用与平稳运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















