


Python元组解包怎么用?函数多值返回与变量赋值技巧
深入解析Python元组解包的底层机制与实用操作,详解多变量赋值、无临时变量互换、函数多值返回接收规范、星号*扩展解包切分及常见ValueError排查指南。
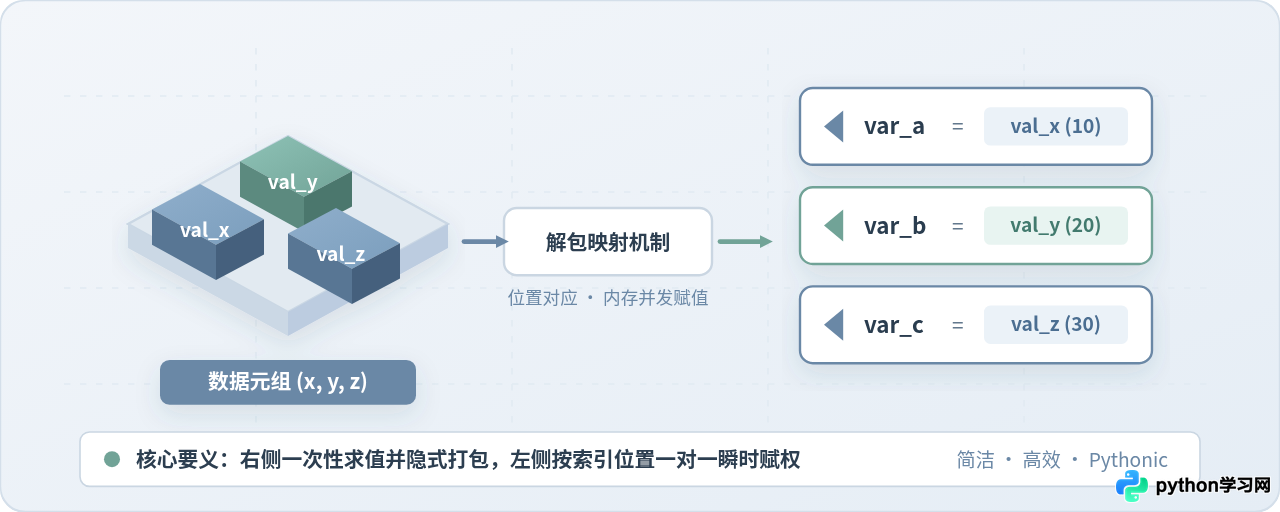
*)扩展表达式、变量免中间量互换以及下划线占位符,可以大幅简化数据提取流程并保持代码的极简与健壮。
一、什么是元组解包?基础语法与底层原理
在日常编程中,如果需要将一个包含多个字段的数据集分别存入不同变量,初学者常常会依赖索引下标逐一提取,例如通过 val[0]、val[1] 依次赋值。这种写法不仅繁琐冗长,还容易因下标越界或看错位置而产生人为疏漏。
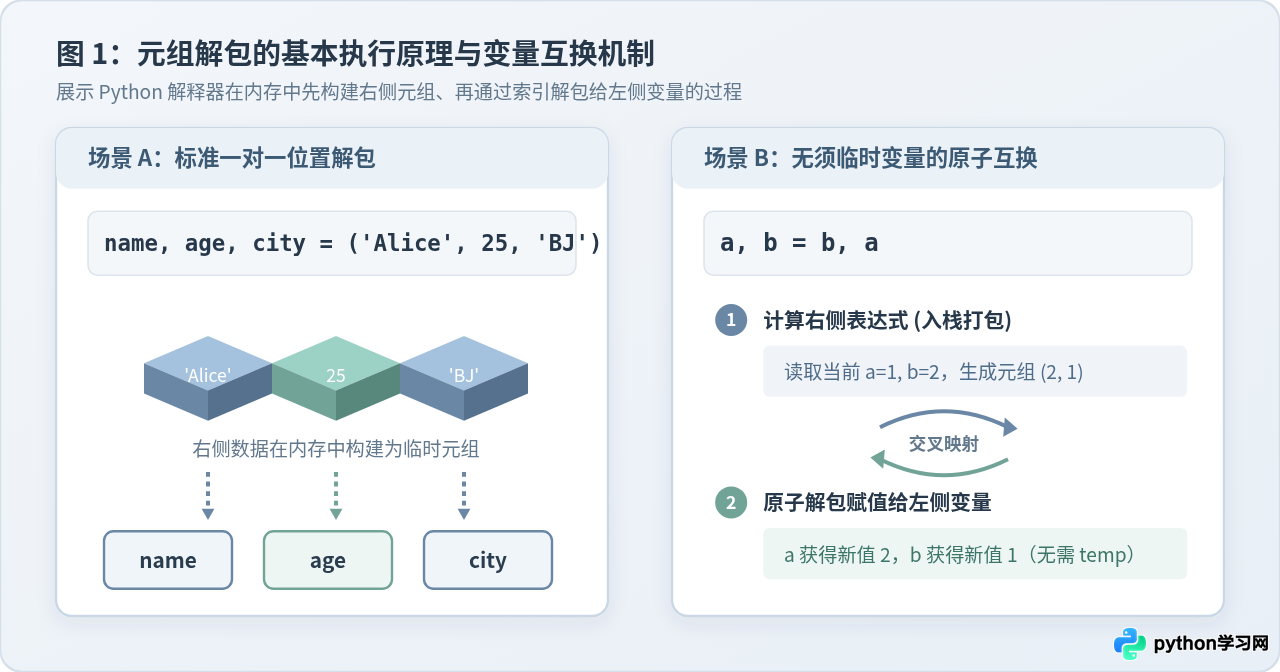
Python 提供了原生的序列解包(Sequence Unpacking)能力。当赋值运算符 = 右侧是一个元组(或列表等可迭代对象),左侧是由逗号分隔的多个变量标识符时,Python 解释器会自动把右侧容器内的元素按其物理排列顺序依次绑定到左侧对应的变量上。
# 基础 1:1 解包示例
point = (10, 20)
x, y = point

print("x =", x)
print("y =", y)y = 20
圆括号可以省略吗?“逗号才是元组的灵魂”
许多初学者认为元组的标志是一对圆括号 (),但实际上在 Python 中,构建元组的核心语法符号是逗号 ,。因此,无论是右侧的容器构建还是左侧的变量解包,两端的圆括号均可按需省略:
# 左右两侧均省略括号,语法完全合法且更加清爽
a, b, c = 1, 2, 3

# 即使右侧是列表,也可以直接解包给左侧变量
first, second = ["apple", "banana"]
经典应用:无需临时变量的原子互换
在许多传统编程语言中,交换两个变量的值必须引入一个临时中间变量 temp。而在 Python 中,仅需一行 a, b = b, a 即可完成。这是因为 Python 解释器在执行赋值语句时,严格按照“先求右侧值,再赋左侧值”的原则:右侧表达式 b, a 先在求值栈上被打包成一个匿名的二元临时元组,随后该元组被解包并同时赋值给左侧的 a 与 b,整个过程安全原子,完全避免了覆盖冲突。
二、函数多值返回的本质与解包接收规范
很多初学者在编写函数时会产生一个疑问:Python 的函数为什么能够“同时返回多个值”?官方规范与底层机制到底是如何支撑这种特性的?
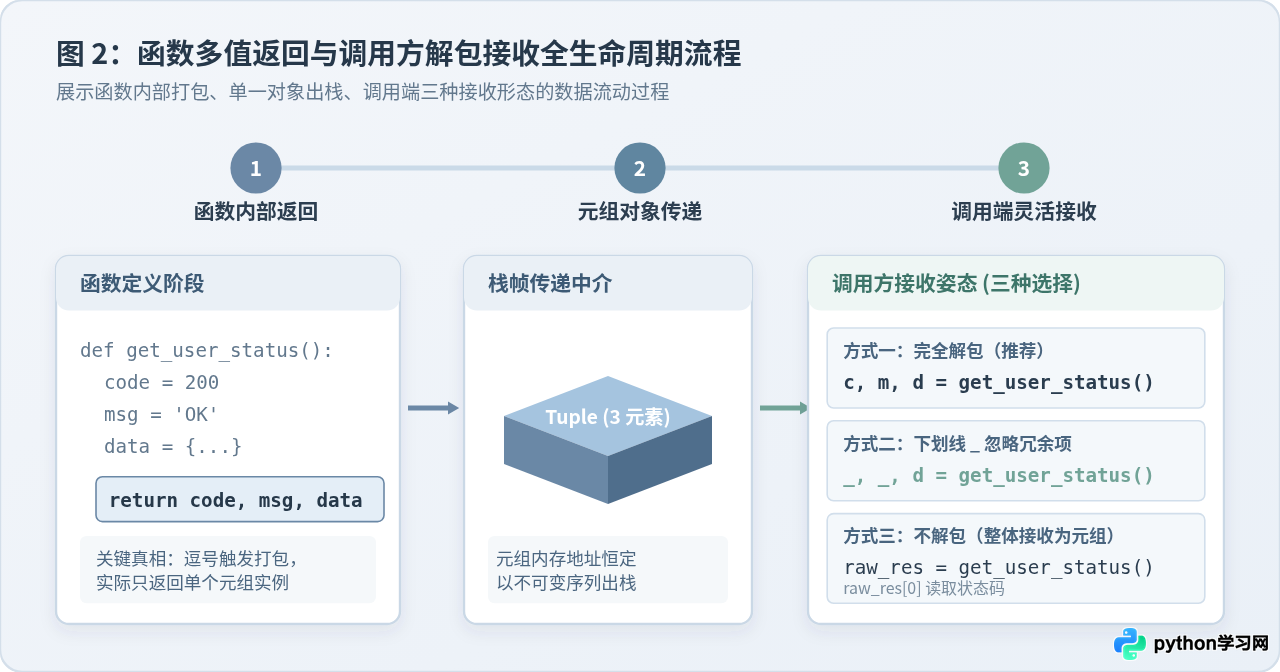
答案是:在 Python 底层,一个函数永远只能返回单个对象。当我们在 return 语句后写出多个用逗号隔开的表达式时,Python 会自动执行隐式元组打包(Tuple Packing),将这多个值整合装入一个单一的元组对象中返回给调用栈。
def get_network_metrics():
    status_code = 200
    latency_ms = 45.2
    server_ip = "192.168.1.108"
    # 逗号分隔:Python 隐式打包成 (200, 45.2, "192.168.1.108")
    return status_code, latency_ms, server_ip

# 观察函数返回值的实际类型
result = get_network_metrics()
print("返回对象类型:", type(result))
print("返回对象内容:", result)返回对象内容: (200, 45.2, '192.168.1.108')
调用端的实用接收模式
正因为函数返回的是标准元组,调用方可以自由选择接收模式:
- 直接解包赋值给多个变量:最推荐的标准用法,各变量名语义清晰,彻底告别
result[0]、result[1]这类魔法数字。code, latency, ip = get_network_metrics() print(f"服务器 {ip} 响应状态: {code},耗时: {latency}ms") - 使用单下划线
_忽略不关心的返回值:如果当前业务逻辑只关注部分结果,可以使用 Python 惯用的占位符_丢弃冗余字段,表明该变量刻意不使用,提升代码可读性并消除 IDE 的未引用警告。# 仅需要 ip,忽略状态码和延迟 _, _, target_ip = get_network_metrics()
三、星号表达式(*)的高级扩展解包技巧
基础解包要求左侧变量数量与右侧元素数量严格精确相等。但在真实工程场景中,序列的长度往往是动态不确定的(例如解析日志行、提取命令行参数、拆分变长流水线数据)。如果元素个数不匹配,程序就会直接崩溃。
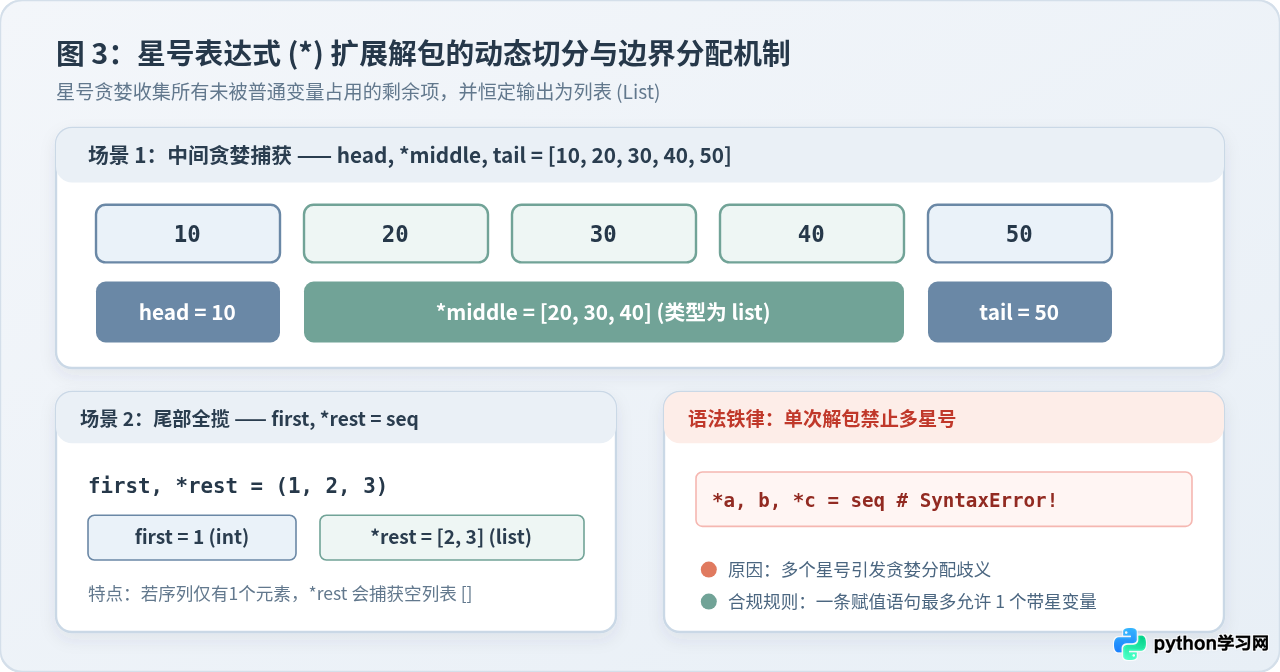
自 Python 3.0 起引入的 PEP 3132 提供了扩展可迭代对象解包(Extended Iterable Unpacking),即在变量名前添加星号 *。带星号的变量扮演“贪婪收集器”的角色,能够自动抓取所有未被普通变量占用的剩余项,并统一封装为一个列表(List)。
常见切分模式示范
带星号的变量可以放置在头部、中间或尾部,根据其相对位置自动执行区间切分:
scores = [98, 85, 92, 78, 90, 88]

# 1. 抓取首个元素,剩余归为列表
highest, *others = scores
print("最高分:", highest)
print("其余成绩:", others)

# 2. 抓取首尾元素,中间动态聚拢
first, *middle, last = scores
print("首项:", first, "| 中间项:", middle, "| 末项:", last)

# 3. 抓取末尾元素,前面全部合并
*history, current = scores
print("历史数据:", history, "| 最新数据:", current)其余成绩: [85, 92, 78, 90, 88]
首项: 98 | 中间项: [85, 92, 78, 90] | 末项: 88
历史数据: [98, 85, 92, 78, 90] | 最新数据: 88
- 无论原始输入是元组、字符串还是集合,被
*捕获的变量类型永远是标准的list。 - 当元素数量刚好满足非星号变量时,星号变量会自动安全地被赋值为一个空列表
[],而绝不会抛出异常。 - 在单次赋值语句中,最多只能出现一个带星号的变量;若出现多个
*,解释器无法推断各个区间的边界长度,会直接抛出SyntaxError: two starred expressions in assignment。
四、进阶赋值场景:嵌套解包与循环遍历
掌握了基础解包与星号扩展后,解包机制还可以与 Python 的复合数据结构和控制流深度结合,展现出极高表达力。
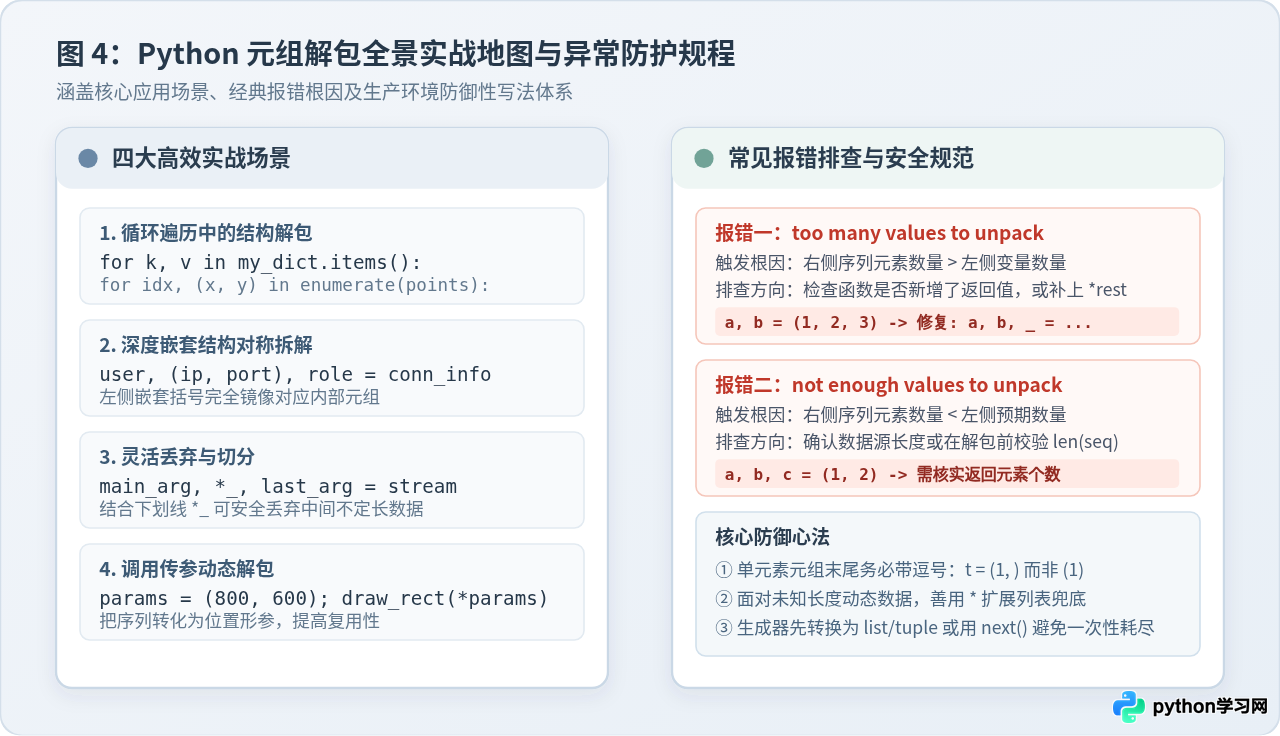
1. 深度嵌套结构的镜像拆解
当处理复杂嵌套元组或接口数据时,左侧变量模式只需精确镜像右侧的括号层级,即可单步完成深层数据的穿透解构:
# 嵌套结构:学生姓名、(出生年, 月, 日)、专业
student_info = ("张三", (2002, 5, 18), "计算机科学")

# 左侧结构与右侧对称匹配
name, (birth_year, birth_month, birth_day), major = student_info

print(f"姓名: {name}, 出生年份: {birth_year}, 专业: {major}")2. for 循环遍历中的结构解包
在循环语句中,for 关键字后实质上也是一个隐式的解包赋值点:
- 字典键值遍历:通过
dict.items()获取(key, value)元组并就地拆分:user_roles = {"alice": "admin", "bob": "editor", "claire": "guest"} for username, role in user_roles.items(): print(f"用户 [{username}] 具备权限: {role}") - 枚举带索引计数:
enumerate()生成(index, item)元组:tasks = ["需求确认", "核心开发", "单元测试"] for step_num, task_name in enumerate(tasks, start=1): print(f"步骤 {step_num}: {task_name}")
五、常见错误排查与防御性编码指南
元组解包虽然直观,但在处理不可控的外部数据(如网络响应、数据库查询、用户输入)时,若稍不注意就会触发异常。以下是开发中最常见的两类报错及对应的修复方案。
根因:右侧序列提供的元素总数超过了左侧预留的变量数量。
常见场景:接口升级新增了返回字段,而旧调用端仍按旧版本参数个数接收。
修复策略:核查函数定义补齐变量;或者在末尾使用
*_ 丢弃未来可能扩展的多余数据。
根因:右侧提供的元素少于左侧要求的变量数。
常见场景:调用切分字符串
line.split(":") 时,某行格式缺失导致返回列表长度不足。修复策略:在解包前对序列长度进行
len() 校验,或先整体接收为列表,判定后再行赋值。
单元素元组的极易混淆陷阱
如果希望解包一个只有一个元素的元组,必须注意单元素元组的书写规范:在元素后面必须添加逗号。若写成 t = (42),Python 会将其判定为带括号的普通整数 int,进而导致 TypeError: cannot unpack non-iterable int object。正确的写法是 t = (42,)。
六、知识速查对照表与实践总结
为了帮助大家在日常开发中准确选用最适宜的赋值技巧,下表对各类解包场景的语法范式与应用要点进行了系统归纳:
| 技巧范式 | 标准代码范例 | 适用场景与核心注意事项 |
|---|---|---|
| 标准 1:1 解包 | x, y, z = (10, 20, 30) |
已知固定长度容器提取;左侧变量数必须与元素数严格一致。 |
| 原子变量互换 | a, b = b, a |
无需第三方中间变量,内存先求右值后赋左值,安全规避覆盖。 |
| 函数多值返回接收 | code, msg, data = fetch_api() |
替代索引下标;若有冗余字段可用 code, _, data 显式忽略。 |
| 星号扩展切分 | head, *middle, tail = seq |
处理未知长度动态序列;单语句仅允许 1 个星号,星号捕获物必为 list。 |
| 结构镜像嵌套解包 | a, (b, c), d = record |
深层复合元组拆解;左侧括号层级必须与数据物理嵌套完全对齐。 |
| 迭代器循环解包 | for k, v in data.items(): |
遍历键值对或枚举序列,就地分配循环作用域变量,语义更清晰。 |
总结而言,Python 的元组解包绝非仅仅是语法糖,它贯穿于数据传递、函数签名、流程控制等方方面面。遵循“数量严格对称用常规解包,动态不定长用星号兜底,无用元素用下划线明确忽略”的编码规范,能够写出既地道优雅(Pythonic)又坚固耐用的高质量代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















