


Python异步爬虫开发:使用aiohttp提升大规模数据采集效率
本文深入讲解如何基于 Python 的 asyncio 与 aiohttp 框架构建高性能异步爬虫,全面解析事件循环非阻塞机制、ClientSession 连接池复用、Semaphore 并发限流、Queue 生产者-消费者解耦架构及网络异常重试优化。
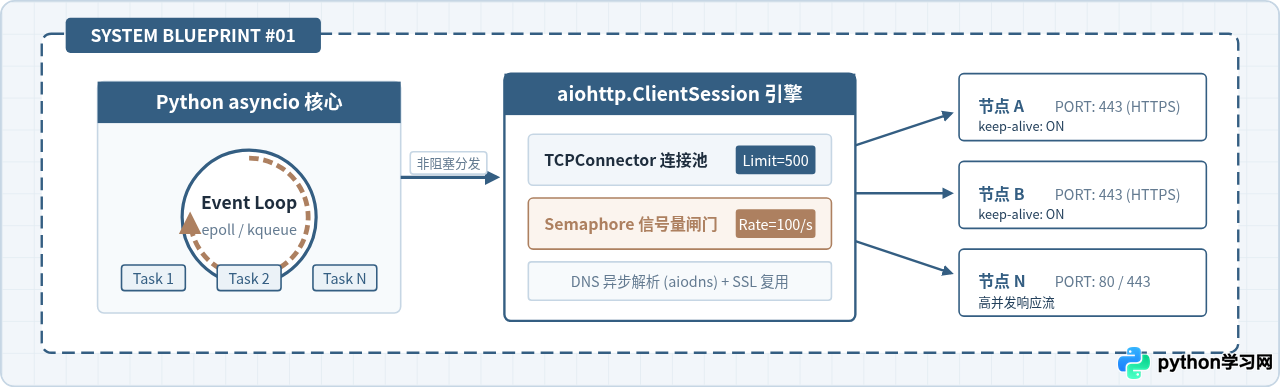
asyncio 搭配异步 HTTP 客户端 aiohttp,详细讲解非阻塞单线程事件循环原理、连接池持久复用、信号量并发控制、生产者-消费者队列解耦架构以及精细化网络超时与重试调优,让爬虫在合规与稳定的前提下实现吞吐效率的成倍跨越。
一、为什么是 aiohttp:同步阻塞与异步非阻塞的本质差异
在理解 aiohttp 带来的性能优势之前,必须先理清网络请求在操作系统底层所经历的具体过程。一个典型的 HTTP 请求包含:DNS 解析、TCP 三次握手、TLS 密钥协商、发送请求报文、服务端处理等待(TTFB)、以及接收响应数据包。在整个耗时链路中,本地 CPU 实际参与计算的时间通常不足 1 毫秒,其余 99% 的时间都在等待网卡和远程服务器的应答。
使用 requests 等同步库时,代码执行到 requests.get() 会让当前线程陷入不可中断的阻塞状态,操作系统将该线程置入休眠队列,直到套接字缓冲区收到响应。如果为了提高吞吐而创建上千个系统线程,会导致巨大的内存消耗(每个线程默认占用约 8MB 栈空间),同时操作系统在成千上万个线程间进行上下文切换的 CPU 开销,会迅速拖垮爬虫进程。
aiohttp 建立在 asyncio 的事件循环(Event Loop)之上。在 Linux 系统下,事件循环借助 epoll(macOS/BSD 为 kqueue)多路复用机制。当协程发起 HTTP 请求后,由于套接字处于非阻塞(O_NONBLOCK)模式,该协程会立即交出 CPU 控制权并挂起(await),由事件循环在单线程内继续处理其他就绪任务。当远程服务器的数据包送达系统网卡并填充至内核缓冲区时,内核会主动通知事件循环,唤醒挂起的协程提取并解析数据。这种单线程调度成千上万非阻塞 Socket 的模式,消除了线程上下文切换与栈内存消耗。
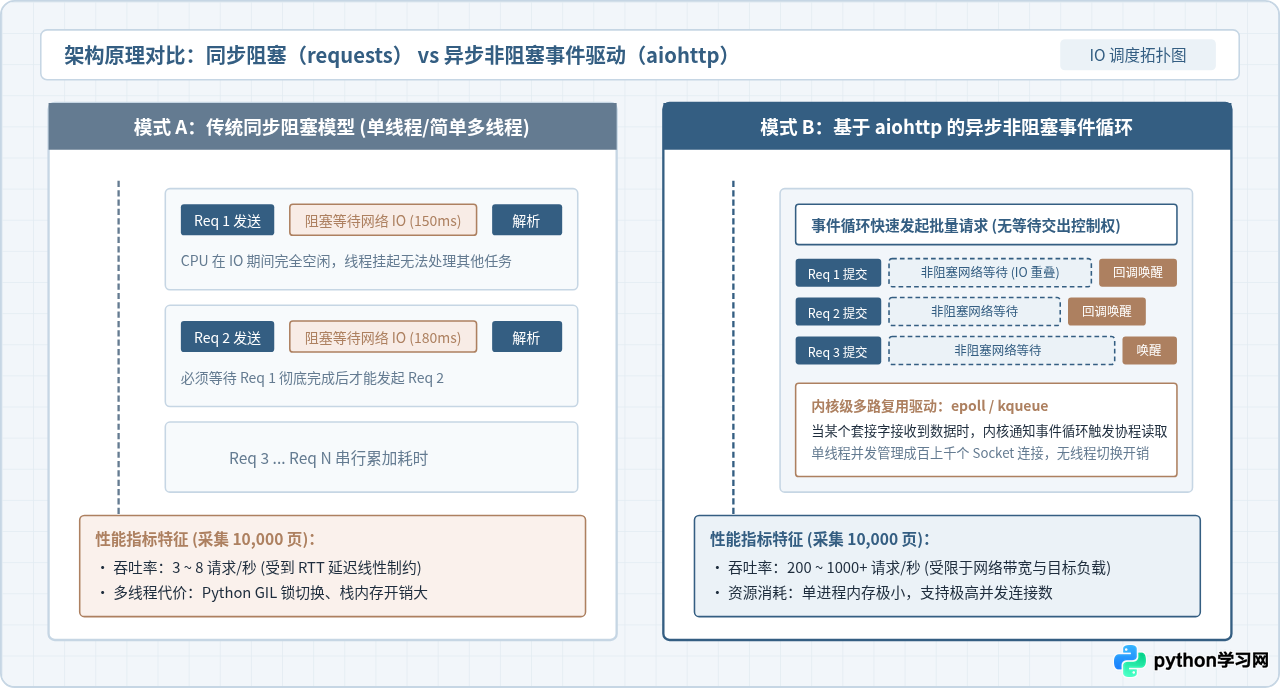
从图 1 可以直观看出:同步模型在网络 RTT 期间 CPU 完全处于闲置饥饿状态,请求总耗时是每个请求耗时的绝对累加;而在 aiohttp 的异步驱动下,所有请求的 I/O 等待期在时间轴上高度重叠,单机网络吞吐量完全由带宽上限与目标站点的承载能力决定,而不是被本地线程数锁死。
二、基础环境与 ClientSession 正确使用范式
在开始编写代码前,确保安装了正确的运行环境。大规模并发采集推荐使用 Python 3.8 及以上版本,并额外安装异步 DNS 解析库 aiodns,以避免默认的阻塞式 DNS 解析成为并发瓶颈。
# 推荐在独立虚拟环境中执行依赖安装
pip install aiohttp aiodns cchardet
在 aiohttp 中,所有 HTTP 操作的核心载体是 aiohttp.ClientSession。初学者最容易犯的一个典型错误,就是在每个下载函数内部创建并销毁 Session。ClientSession 内部维护了完整的 TCP 连接池(Connection Pool)和 DNS 解析缓存,频繁创建 Session 会导致连接池彻底失效,导致每一个请求都被迫重新经历 TCP 三次握手和 TLS 协商,同时产生大量的 TIME_WAIT 套接字,最终耗尽操作系统本地端口。
正确的标准范式是:在整个采集任务的生命周期中,仅创建一个全局 ClientSession,并通过参数传递给所有工作协程复用。以下为标准的基础请求示例:
import asyncio
import aiohttp

async def fetch_page(session: aiohttp.ClientSession, url: str) -> str:
    """使用共享会话发起异步 GET 请求并获取页面文本"""
    headers = {
        "User-Agent": "Mozilla/5.0 (compatible; AsyncCrawlerEngine/1.0)"
    }
    try:
        async with session.get(url, headers=headers) as response:
            # 必须在 async with 上下文内部读取响应体
            if response.status == 200:
                # await response.text() 为非阻塞式读取响应体
                return await response.text()
            else:
                print(f"[HTTP {response.status}] 请求失败: {url}")
                return ""
    except aiohttp.ClientError as err:
        print(f"[网络异常] {url}: {err}")
        return ""

async def main():
    target_urls = [
        "https://httpbin.org/get",
        "https://httpbin.org/delay/1",
        "https://httpbin.org/ip"
    ]

    # 严格保持 ClientSession 全局单一生命周期
    async with aiohttp.ClientSession() as session:
        tasks = [fetch_page(session, url) for url in target_urls]
        # 并发执行所有请求并等待全部完成
        results = await asyncio.gather(*tasks)
        print(f"成功获取页面数: {len([r for r in results if r])}")

if __name__ == "__main__":
asyncio.run(main())await response.text() 或 await response.json())在 async with session.get(...) 的作用域内部完成。若脱离了该上下文,底层的连接会过早归还给连接池或直接关闭,从而触发 ClientPayloadError 或连接重置异常。
三、控制并发吞吐:使用 asyncio.Semaphore 避免过载
许多开发者在初次尝试 asyncio.gather(*tasks) 时,习惯性将成千上万个任务一次性全部解包传入。这种“无节制并发”在小规模测试时看似速度飞快,但在生产环境下会迅速引发严重故障:
- 本地操作系统句柄耗尽:同时打开数千个套接字,直接抛出
OSError: [Errno 24] Too many open files。 - 目标服务触发反爬与风控:毫秒级倾泻数千个请求,目标站点的 WAF 或反爬网关会判定为 DDoS 攻击,立即返回
429 Too Many Requests或直接将采集 IP 封禁。 - 本地内存急剧膨胀:海量协程同时处于就绪状态,响应内容并发解压至内存,极易导致内存溢出崩溃。
解决此问题的工业级标准方案,是引入信号量 asyncio.Semaphore。信号量本质上是一个基于原子计数器的异步并发门禁:初始化时指定许可数量(如 50),每个协程在发起真实网络请求前必须先通过 async with semaphore 申请许可,请求完毕退出代码块时自动归还许可。未获取到许可的协程会被安全挂起,从而将并发在途的请求严格限制在安全阈值之内。
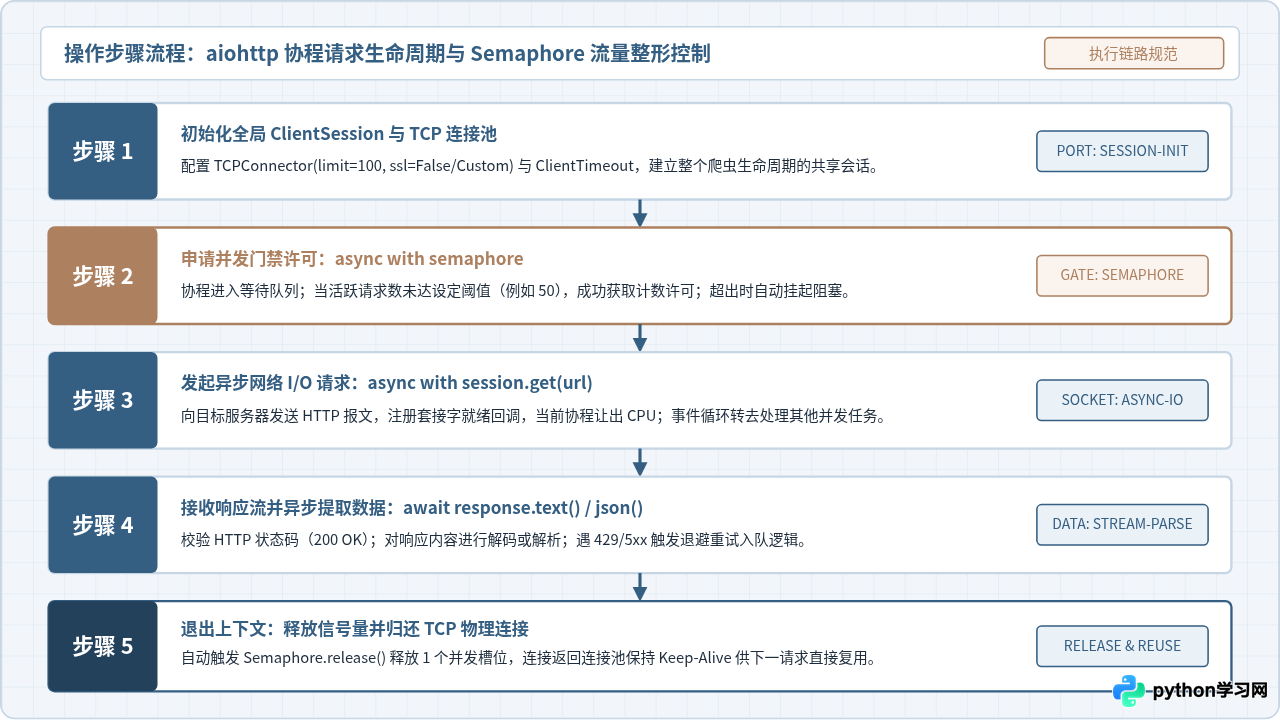
图 2 完整呈现了从 Session 初始化到释放连接的五个标准操作阶段。利用信号量包装后的请求代码如下:
import asyncio
import aiohttp

async def bounded_fetch(sem: asyncio.Semaphore, session: aiohttp.ClientSession, url: str) -> dict:
    # 步骤 2: 申请并发门禁许可
    async with sem:
        try:
            # 步骤 3: 非阻塞建立请求
            async with session.get(url) as response:
                # 步骤 4: 异步读取并提取数据
                if response.status == 200:
                    data = await response.json()
                    return data
                elif response.status == 429:
                    print(f"[限流告警] 触发 429 Too Many Requests: {url}")
                    return {}
        except asyncio.TimeoutError:
            print(f"[超时] 请求目标耗时超出阈值: {url}")
            return {}
        except aiohttp.ClientError as err:
            print(f"[网络错误] {url}: {err}")
            return {}
        # 步骤 5: 退出 async with sem 时自动释放信号量
四、大规模采集架构:基于 asyncio.Queue 的生产者-消费者模型
当待采集的目标 URL 达到数十万甚至数百万级别时,直接将所有 URL 实例化为 Task 列表仍然会在内存中堆积海量协程对象。此时,必须采用生产者-消费者(Producer-Consumer)解耦架构。
在该架构中,由一个或多个轻量生产者协程负责从数据库或种子文件中流式产生 URL,压入具有容量上限的 asyncio.Queue;同时启动固定数量(例如 30 到 100 个)的 Worker 消费者协程,从队列中循环提取 URL、执行抓取并解析。当队列已满时,生产者自动暂停生成,形成自然的背压(Backpressure)机制,彻底保证爬虫内存占用的恒定与平稳。
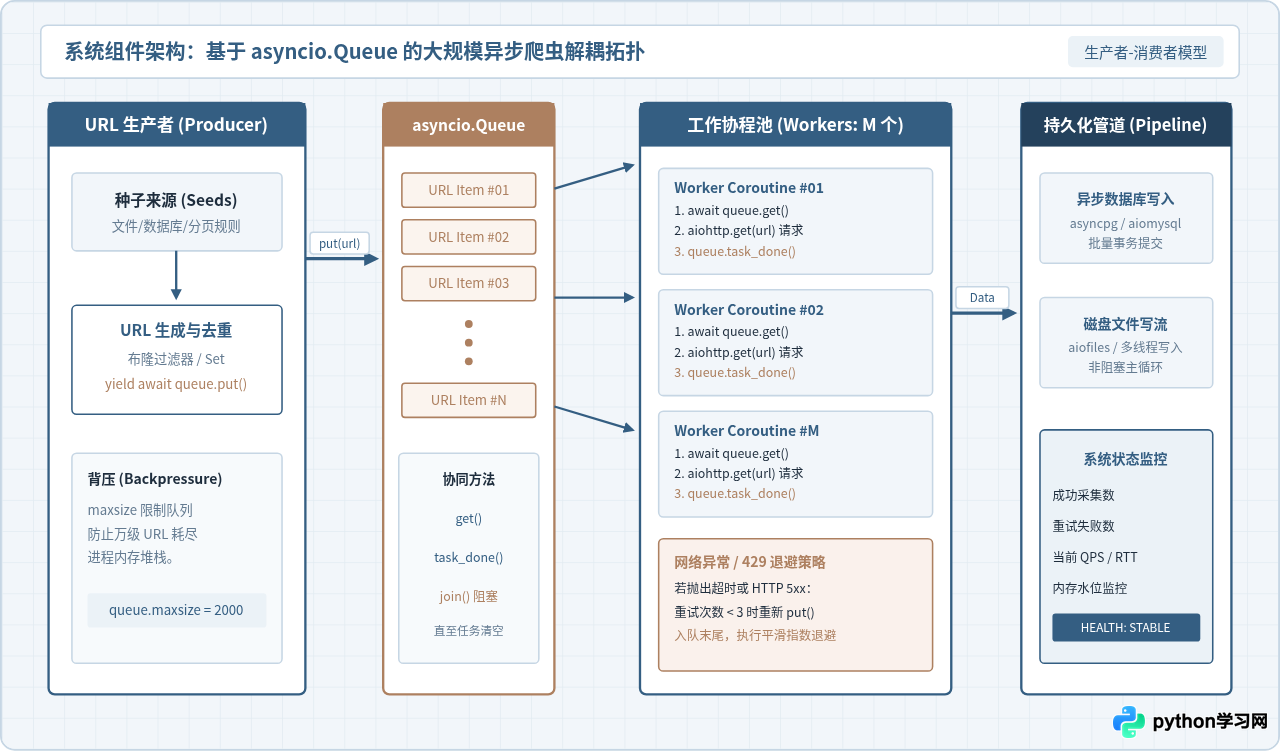
以下为工业级生产环境中可直接运行的完整架构示例,包含任务入队、Worker 消费、异常保护以及 queue.join() 优雅退出的完整生命周期管理:
import asyncio
import aiohttp
from typing import List

# 1. 生产者:流式向队列分发任务
async def producer(queue: asyncio.Queue, urls: List[str]):
    print(f"[Producer] 开始向队列分发 {len(urls)} 个任务...")
    for url in urls:
        # 当队列达到 maxsize 时,put 会非阻塞等待,实现背压机制
        await queue.put(url)
    print("[Producer] 所有任务分发完毕。")

# 2. 消费者 Worker:持续从队列消费并处理
async def worker(worker_id: int, queue: asyncio.Queue, session: aiohttp.ClientSession, sem: asyncio.Semaphore):
    while True:
        # 从队列异步提取待抓取 URL
        url = await queue.get()
        try:
            async with sem:
                # 发起异步抓取
                async with session.get(url) as resp:
                    if resp.status == 200:
                        content = await resp.text()
                        # 此处可对接数据提取或异步持久化
                        # print(f"[Worker {worker_id}] 成功抓取: {url} (大小: {len(content)} bytes)")
                    else:
                        print(f"[Worker {worker_id}] 状态异常 HTTP {resp.status}: {url}")
        except Exception as e:
            print(f"[Worker {worker_id}] 抓取失败 {url}: {e}")
        finally:
            # 核心步骤:每处理完一个任务,必须向队列汇报 task_done
            queue.task_done()

# 3. 调度总控与生命周期维护
async def run_crawler_pipeline():
    total_tasks = 200
    test_urls = [f"https://httpbin.org/get?item_id={i}" for i in range(total_tasks)]

    # 限制队列容量为 50,防止内存堆积
    queue = asyncio.Queue(maxsize=50)

    # 限制并发在途请求数为 20
    semaphore = asyncio.Semaphore(20)

    # 全局会话与专用网络连接池配置
    connector = aiohttp.TCPConnector(limit=50, limit_per_host=10, ssl=False)
    timeout = aiohttp.ClientTimeout(total=15, connect=5, sock_read=8)

    async with aiohttp.ClientSession(connector=connector, timeout=timeout) as session:
        # 启动固定数量的消费者工作协程 (例如 10 个)
        workers = [
            asyncio.create_task(worker(i, queue, session, semaphore))
            for i in range(10)
        ]

        # 启动生产者
        producer_task = asyncio.create_task(producer(queue, test_urls))

        # 等待生产者把所有种子放入队列
        await producer_task

        # 等待队列中所有的任务被消费完毕且汇报 task_done
        print("[Master] 等待所有消费者完成队列处理...")
        await queue.join()
        print("[Master] 队列处理完毕,准备优雅停止 Worker 协程。")

        # 取消保持常驻的 Worker 协程
        for w in workers:
            w.cancel()

        # 等待 Worker 确认取消
        await asyncio.gather(*workers, return_exceptions=True)
        print("[Master] 采集系统安全退出。")

if __name__ == "__main__":
    asyncio.run(run_crawler_pipeline())
五、稳定性调优:TCPConnector 连接池与超时生命周期
在规模化采集场景中,网络延迟抖动、目标站响应缓慢或套接字断连是常态。为了让爬虫能够在复杂网络环境下长时间稳定运行,必须深入配置底层连接器 TCPConnector 与超时控制器 ClientTimeout。
1. TCPConnector 深度优化
默认情况下,aiohttp.ClientSession() 会初始化一个通用的 TCP 连接器。但在生产级别的大规模爬虫中,应当显式配置以下参数:
| 参数名 | 推荐设置 | 工程意义与适用场景 |
|---|---|---|
limit |
100 ~ 500 | 连接池总物理连接上限。防止突发大量请求耗尽系统文件描述符(Socket 句柄)。 |
limit_per_host |
10 ~ 30 | 针对单一 Host 域名的并发上限。防止对同一源站形成冲击,降低封禁风险。 |
ttl_dns_cache |
300 (秒) | 异步 DNS 缓存有效期。默认 10 秒过短,设置为 300 秒可极大减少重复 DNS 解析开销。 |
ssl |
False / ssl_context | 对公开数据抓取若无需严格校验证书,可设置 ssl=False 降低 TLS 握手 CPU 消耗。 |
enable_cleanup_closed |
True | 启用对底层已经断开套接字的清理机制,避免在 macOS/Linux 上偶发 Unclosed connection 警告。 |
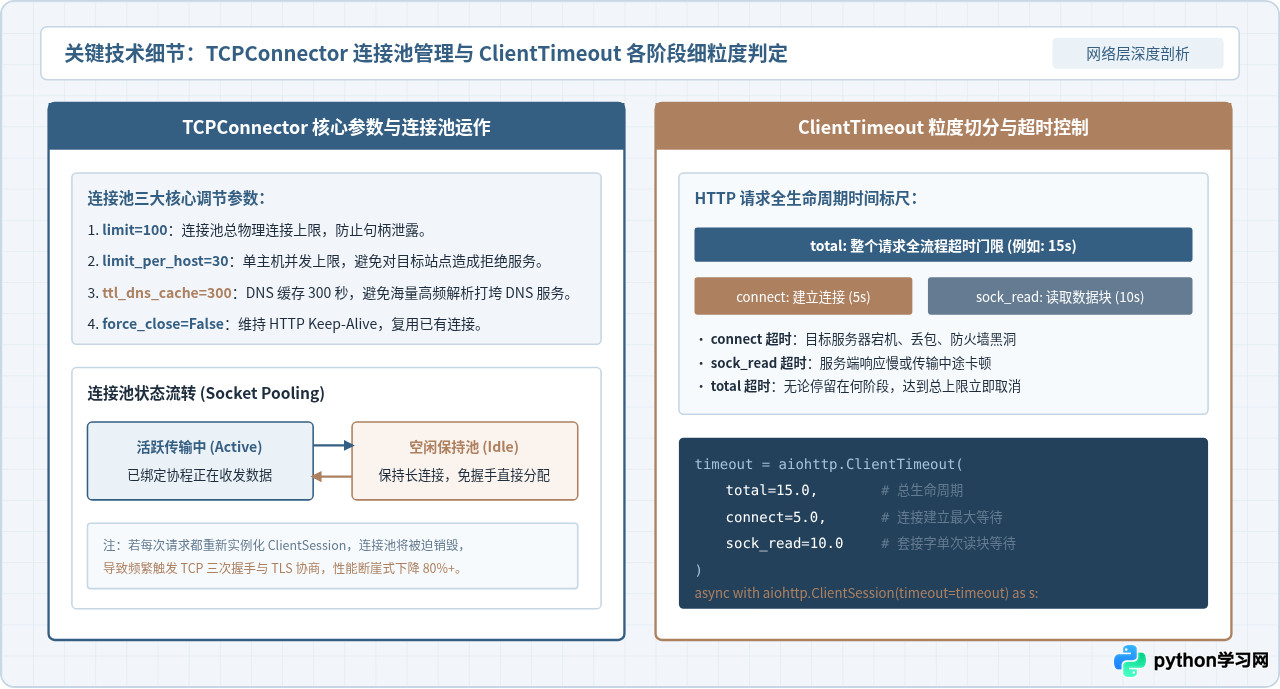
2. ClientTimeout 细粒度控制
默认的 total=300(5分钟)对于爬虫而言过长,一旦遇到死连接会导致大量协程被长期挂起占用槽位。如图 4 所示,合理的超时配置应当覆盖各个独立阶段:
custom_timeout = aiohttp.ClientTimeout(
    total=15.0,       # 整个请求从发起至完成的总耗时上限
    connect=5.0,      # 从开始解析 DNS 到 TCP/TLS 握手完成的上限
    sock_connect=4.0, # 纯 TCP 套接字握手耗时
    sock_read=8.0     # 两个数据块到达之间的最大等待耗时
)
这种细粒度超时切分的作用非常显著:当目标服务器负载过高无法建立连接时,5 秒内即可触发 ServerTimeoutError 快速放弃或重试;如果连接建立成功但传输中断,超过 8 秒未接收到任何数据块则触发 SocketTimeoutError,保障连接池能够迅速回收并服务后续任务。
六、工程落地避坑指南与总结
在实际工程开发中,异步编程由于其特殊的协同调度机制,如果混入了传统的同步代码,往往会产生隐蔽但致命的性能倒退。以下总结四项核心检查规范:
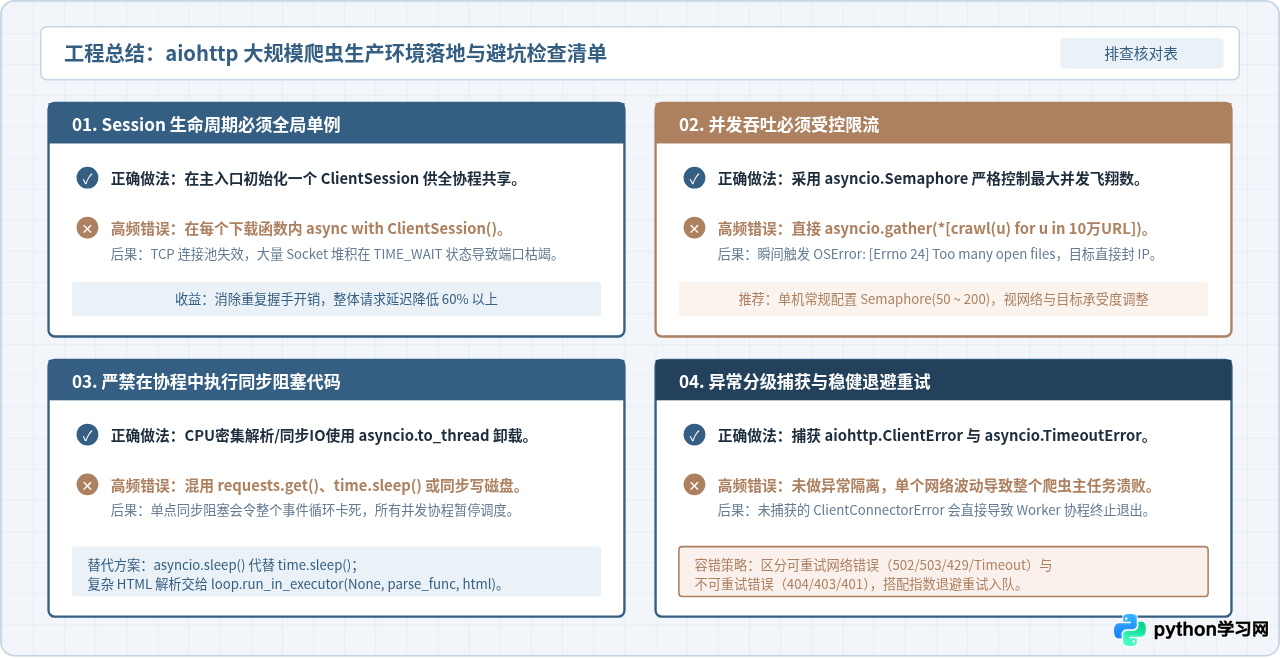
1. 绝对避免在协程中调用同步阻塞函数
事件循环在任意时刻只有一个任务占用 CPU 核心。如果在某个异步函数内部调用了 time.sleep(2)、requests.get() 或是同步数据库写入(如 pymysql),整个事件循环将被硬性卡死整整 2 秒。在此期间,成千上万个并发连接全部被冻结,甚至可能导致已建立连接因心跳超时而被服务端强行掐断。
解决办法:需要休眠时严格使用 await asyncio.sleep(t);需要执行同步文件写盘或复杂的 BeautifulSoup / XPath 提取等 CPU 密集型任务时,使用 asyncio.to_thread(Python 3.9+)或 loop.run_in_executor() 卸载到内部线程池中执行,确保主事件循环永不被阻塞。
2. 规范分级异常捕获
网络采集必然伴随偶发性网络故障。在协程中必须做好分级捕获,切忌任由异常向上抛出中断 Worker:
aiohttp.ClientConnectorError:DNS 失败、拒绝连接或网络不可达;建议入队重试。asyncio.TimeoutError:握手或响应超时;判断重试次数后决定是否丢弃。aiohttp.ClientPayloadError:响应在传输中途断开;需重新请求。aiohttp.ClientResponseError:如遇 403/404 应记录日志并放弃,遇到 429/503 应执行指数退避后再入队。
ulimit -n 65535 提升当前 Shell 的最大打开文件句柄数限制,并适当调大系统级内核参数 net.ipv4.tcp_max_syn_backlog 和 net.ipv4.ip_local_port_range,为高并发 I/O 提供充足的操作系统底层支撑。
总结而言,利用 aiohttp 开发高吞吐爬虫不仅是简单地给函数加上 async 和 await,更需要从底层的 I/O 调度视角理解系统的运作逻辑:保持单一 ClientSession 维持长连接复用、通过 asyncio.Semaphore 设定合理的物理防线、利用 asyncio.Queue 构建具备背压能力的弹性管道,并在网络抖动时依靠细粒度的 ClientTimeout 与指数退避重试实现自动修复。遵循这一套严谨的工程架构,便能以极低的计算资源消耗,平稳支持千万级的大规模网络数据采集业务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















