


Python pandas怎么根据日期范围筛选DataFrame数据
详细讲解在Python pandas中根据日期范围筛选DataFrame数据的四种核心方法:布尔索引、Series.between()、DataFrame.query()以及DatetimeIndex切片,并剖析时间戳时分秒截断与边界开闭区间等易错陷阱。
一、核心前置步骤:确保日期列为 datetime64 类型
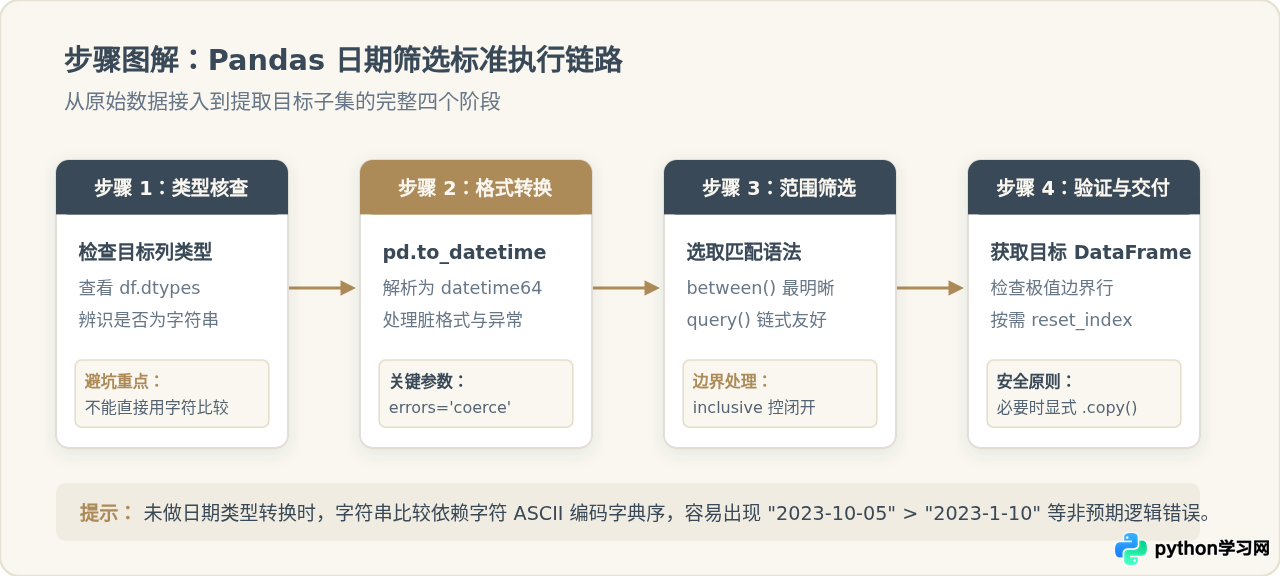
很多初学者在根据日期筛选数据时遇到的首个问题是:执行了筛选语句,但返回的数据不全或直接为空。其最主要的原因在于目标日期列在加载时被识别为普通文本(object 或 string 类型)。
在普通字符串状态下,比较操作符依据的是字符的 ASCII 字典序。例如字符串 "2023-1-10" 在字典序上会排在 "2023-02-01" 之后,一旦混用非标准化格式就会引发不可预期的逻辑错漏。因此,所有筛选工作的第一步,都必须通过 pd.to_datetime() 完成类型标准化。
我们先构建一个包含不同订单日期的基础 DataFrame,作为全文各方法演示的数据基准:
import pandas as pd

# 构建模拟订单销售数据
raw_data = {
    'order_id': ['ORD-101', 'ORD-102', 'ORD-103', 'ORD-104', 'ORD-105', 'ORD-106'],
    'order_date': [
        '2023-10-01',
        '2023-10-15',
        '2023-10-31',
        '2023-11-05',
        '2023-11-20',
        '2023-12-01'
    ],
    'amount': [1200.5, 450.0, 890.0, 3100.2, 760.0, 2150.0]
}

df = pd.DataFrame(raw_data)

# 关键步骤:转换为 datetime64 类型
df['order_date'] = pd.to_datetime(df['order_date'])

# 检查转换后的类型
print(df.dtypes)
print(df)确认 order_date 列的 dtype 为 datetime64[ns] 后,即可放心地运用以下四种方法提取任意时间区间的数据。
二、方法一:布尔索引组合(& 运算符)
布尔索引是 Pandas 中最基础也是最通用的过滤机制。通过使用大于等于(>=)和小于等于(<=)两个布尔向量,配合逻辑与(&)运算符,即可圈定目标时间窗口。
# 设定日期边界(字符串格式会自动隐式转换为 Timestamp 比对)
start_date = '2023-10-15'
end_date = '2023-11-05'

# 执行布尔切片(注意:每个比较条件必须用圆括号括起来)
filtered_df = df[(df['order_date'] >= start_date) & (df['order_date'] <= end_date)]

print(filtered_df)& 的执行优先级高于比较运算符 >= 和 <=。如果写成 df[df['order_date'] >= start_date & df['order_date'] <= end_date],Python 会优先计算 start_date & df['order_date'],从而抛出 TypeError: cannot compare a dtyped [datetime64[ns]] array with a scalar of type [bool] 错误。
三、方法二:使用 Series.between() 方法(推荐首选)
针对单一列的连续闭区间或半开区间筛选,pandas 提供了语义更加精炼的内置方法 Series.between(left, right, inclusive='both')。该方法避免了重复书写两次列名,同时自带边界开闭配置。
# 使用 between 方法提取 2023-10-15 至 2023-11-05 区间(双闭区间)
result_between = df[df['order_date'].between('2023-10-15', '2023-11-05', inclusive='both')]

print(result_between)在默认情况下,inclusive='both' 会同时包含起始日期与截止日期。如果业务场景需要排除端点,可以指定不同的参数取值:
inclusive='both':两端皆闭[left, right](默认值);inclusive='neither':两端皆开(left, right),不含两端日期;inclusive='left':左闭右开[left, right);inclusive='right':左开右闭(left, right]。
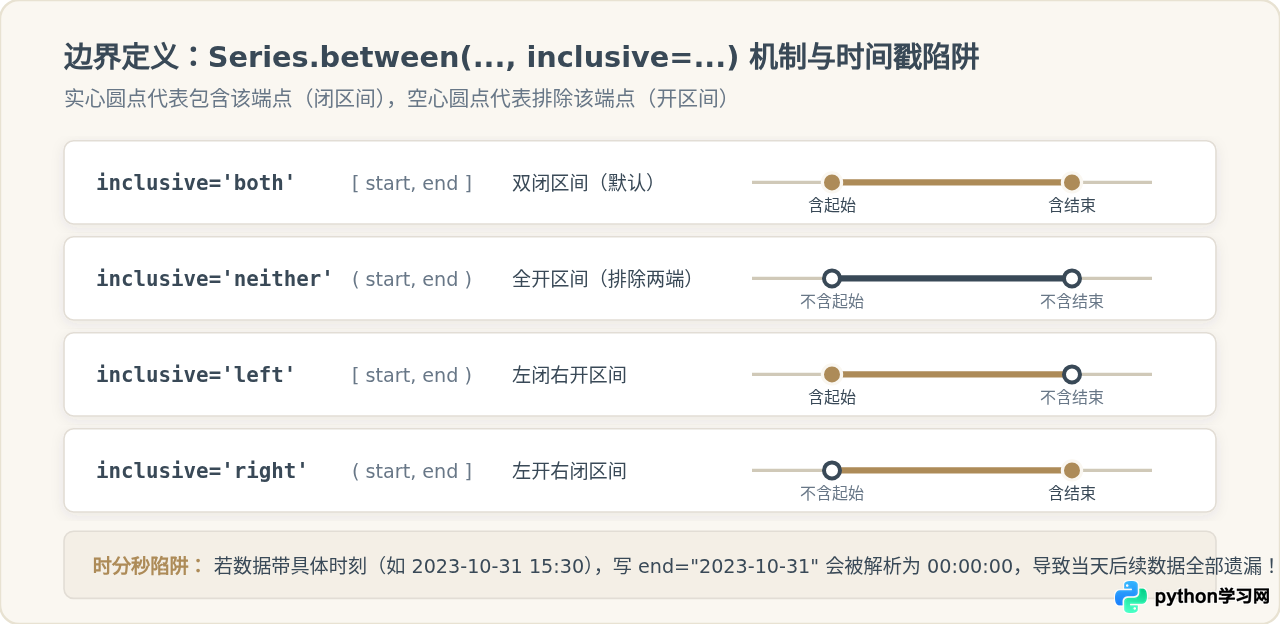
例如,若只需筛选 10 月 15 日之后、但不含 11 月 5 日当天的数据,只需指定 inclusive='left':
left_only = df[df['order_date'].between('2023-10-15', '2023-11-05', inclusive='left')]
print(left_only[['order_id', 'order_date']])四、方法三:使用 DataFrame.query() 表达式筛选
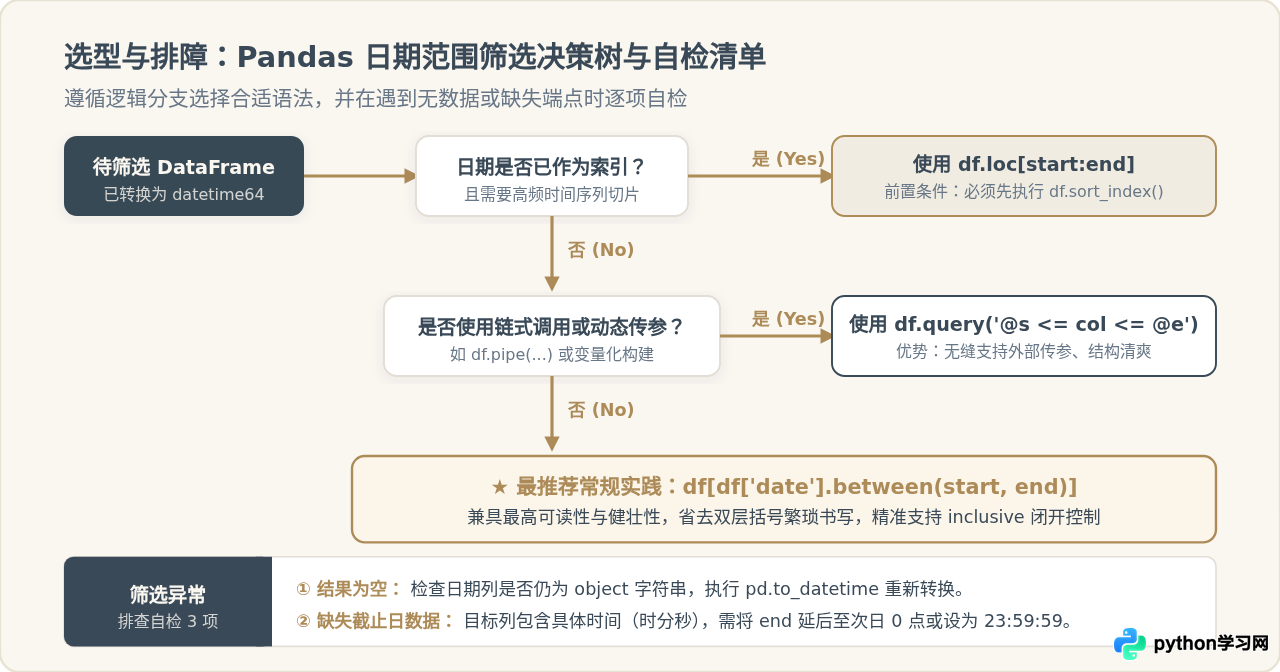
DataFrame.query() 允许使用类似 SQL WHERE 子句的字符串表达式来进行条件过滤。对于日期范围判断,query() 原生支持如同数学表达式一般的连续比较运算符,如 @start <= date <= @end。
start_val = '2023-10-15'
end_val = '2023-11-05'

# 在 query 字符串中,前缀 '@' 符号代表引用当前 Python 环境中的局部或全局变量
query_df = df.query('@start_val <= order_date <= @end_val')

print(query_df)query() 的显著优势在于:当需要进行多步链式处理(Method Chaining)或由外部函数动态组装查询参数时,代码十分整洁直观,避免在长链式语句中嵌套多次 df[...] 引用。
五、方法四:设置 DatetimeIndex 并使用 .loc 切片
当处理专门的时间序列数据(如股票行情、服务器监控指标、传感器日志)时,将日期时间列提升为 DataFrame 的索引(DatetimeIndex)是业界标准范式。通过 .loc[start:end],不仅能够实现闭区间连续切片,还能享受 pandas 强大的时间解析加速与部分字符串匹配功能。
# 1. 复制一份数据并将 order_date 设置为索引
ts_df = df.set_index('order_date')

# 2. 关键前提:按时间顺序排序索引(未排序的切片可能导致报错或低效)
ts_df = ts_df.sort_index()

# 3. 使用 .loc 语法切片(日期字符串两端均包含)
sliced_df = ts_df.loc['2023-10-15':'2023-11-05']
print(sliced_df)

# 4. 支持更高级的部分匹配:直接截取 2023 年 10 月整月
october_df = ts_df.loc['2023-10']
print("\n-- 2023年10月份整月数据 --")
print(october_df)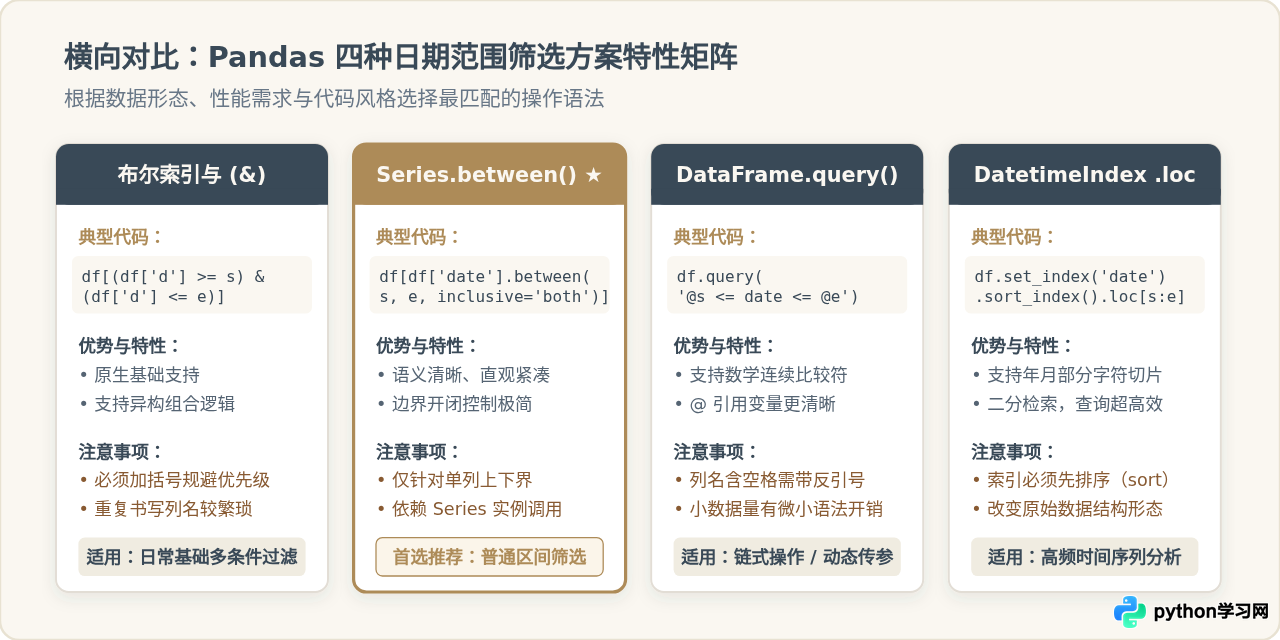
| 筛选方法 | 基本语法 | 边界开闭控制 | 适用场景与建议 |
|---|---|---|---|
| 布尔索引组合 | df[(df['d'] >= s) & (df['d'] <= e)] |
由 >= / > 自行掌控 |
需要与其他非日期条件自由组合时使用 |
| Series.between() | df[df['d'].between(s, e)] |
通过 inclusive 参数调节 |
常规场景首选,语法最紧凑、不易漏写括号 |
| DataFrame.query() | df.query('@s <= d <= @e') |
支持 <= 与 < |
链式流水线数据清洗、外部动态传参 |
| DatetimeIndex .loc | df.sort_index().loc[s:e] |
切片默认为双闭区间 | 高频时间序列分析、支持按年/按月模糊切片 |
六、实际开发中的三大易错点与解决方案
1. 时分秒截断问题(最常见的静默逻辑错误)
如果数据中的时间列带有具体的时分秒(如来自业务系统的打卡时间或支付流水:2023-10-31 16:45:00),直接使用 end_date = '2023-10-31' 作为截止点进行比对,会出现数据丢失。
因为纯日期字符串 '2023-10-31' 在转换为时间戳时,默认时刻为当天的零点 00:00:00。因此,任何发生在 10 月 31 日白天或晚上的记录都会因为大于零点而被过滤掉。
解决方式有以下两种:
- 方式 A(明确截止时分秒):将结束参数明确设定为当天最后一刻
end_date = '2023-10-31 23:59:59.999999',或将判断上限改为次日零点配合小于号order_date < '2023-11-01'。 - 方式 B(抹平时分秒):利用
df['order_date'].dt.normalize()将所有时间统一规整到当天的00:00:00,再进行日期比对。
2. 时区不匹配错误(Cannot compare tz-naive and tz-aware timestamps)
如果 DataFrame 的日期列包含时区信息(如通过 API 获取的 UTC 时间,dtype 为 datetime64[ns, UTC]),而用来筛选的变量是无时区的字符串或 Timestamp,执行比较时 pandas 会抛出时区异常。
解决方案:对比较变量补充时区声明,如使用 pd.Timestamp('2023-10-15', tz='UTC'),或者先用 df['order_date'].dt.tz_localize(None) 移除数据列中的时区约束,使其处于相同的时区维度。
3. 缺失值(NaT)的自动忽略与显式排查
当日期列中包含 NaT(Not a Time,时间缺失值)时,无论是 between() 还是布尔比较,NaT 与任何日期的比较结果都会判定为 False,即自动被过滤排除。如果业务上需要额外审计含有缺失时间的行,应通过 df[df['order_date'].isna()] 单独检查,切勿遗漏。
七、可直接复用的综合实战代码模板
在日常脚本或工程代码中,推荐将上述清洗、类型转换与范围筛选封装为鲁棒性良好的通用函数:
import pandas as pd
from typing import Optional

def filter_by_date_range(
    df: pd.DataFrame,
    date_col: str,
    start_date: Optional[str] = None,
    end_date: Optional[str] = None,
    include_end_day: bool = True
) -> pd.DataFrame:
    """
    安全地按日期范围筛选 DataFrame 数据
    """
    # 浅拷贝避免 SettingWithCopyWarning
    res = df.copy()

    # 1. 确保目标列为 datetime 类型
    if not pd.api.types.is_datetime64_any_dtype(res[date_col]):
        res[date_col] = pd.to_datetime(res[date_col], errors='coerce')

    # 2. 起始边界处理
    if start_date is not None:
        t_start = pd.to_datetime(start_date)
        res = res[res[date_col] >= t_start]

    # 3. 结束边界处理(支持覆盖全天)
    if end_date is not None:
        t_end = pd.to_datetime(end_date)
        if include_end_day and t_end.hour == 0 and t_end.minute == 0 and t_end.second == 0:
            # 自动延展至当天 23:59:59.999999
            t_end = t_end + pd.Timedelta(days=1, microseconds=-1)
        res = res[res[date_col] <= t_end]

    return res

# 示例调用
cleaned_df = filter_by_date_range(df, date_col='order_date', start_date='2023-10-01', end_date='2023-10-31')
print(cleaned_df)本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















